6 / 19
线性神经网络
在介绍深度神经网络之前,我们需要了解神经网络训练的基础知识。
本章我们将介绍神经网络的整个训练过程,
包括:定义简单的神经网络架构、数据处理、指定损失函数和如何训练模型。
为了更容易学习,我们将从经典算法————线性神经网络开始,介绍神经网络的基础知识。
经典统计学习技术中的线性回归和softmax回归可以视为线性神经网络,
这些知识将为本书其他部分中更复杂的技术奠定基础。
:maxdepth: 2

linear-regression
linear-regression-scratch
linear-regression-concise
softmax-regression
image-classification-dataset
softmax-regression-scratch
softmax-regression-concise
线性回归
回归(regression)是能为一个或多个自变量与因变量之间关系建模的一类方法。
在自然科学和社会科学领域,回归经常用来表示输入和输出之间的关系。
在机器学习领域中的大多数任务通常都与预测(prediction)有关。
当我们想预测一个数值时,就会涉及到回归问题。
常见的例子包括:预测价格(房屋、股票等)、预测住院时间(针对住院病人等)、
预测需求(零售销量等)。
但不是所有的预测都是回归问题。
在后面的章节中,我们将介绍分类问题。分类问题的目标是预测数据属于一组类别中的哪一个。
线性回归的基本元素
线性回归(linear regression)可以追溯到19世纪初,
它在回归的各种标准工具中最简单而且最流行。
线性回归基于几个简单的假设:
首先,假设自变量和因变量之间的关系是线性的,
即可以表示为中元素的加权和,这里通常允许包含观测值的一些噪声;
其次,我们假设任何噪声都比较正常,如噪声遵循正态分布。
为了解释线性回归,我们举一个实际的例子:
我们希望根据房屋的面积(平方英尺)和房龄(年)来估算房屋价格(美元)。
为了开发一个能预测房价的模型,我们需要收集一个真实的数据集。
这个数据集包括了房屋的销售价格、面积和房龄。
在机器学习的术语中,该数据集称为训练数据集(training data set)
或训练集(training set)。
每行数据(比如一次房屋交易相对应的数据)称为样本(sample),
也可以称为数据点(data point)或数据样本(data instance)。
我们把试图预测的目标(比如预测房屋价格)称为标签(label)或目标(target)。
预测所依据的自变量(面积和房龄)称为特征(feature)或协变量(covariate)。
通常,我们使用来表示数据集中的样本数。
对索引为的样本,其输入表示为,
其对应的标签是。
线性模型
线性假设是指目标(房屋价格)可以表示为特征(面积和房龄)的加权和,如下面的式子:
:eqref:eq_price-area中的和
称为权重(weight),权重决定了每个特征对我们预测值的影响。
称为偏置(bias)、偏移量(offset)或截距(intercept)。
偏置是指当所有特征都取值为0时,预测值应该为多少。
即使现实中不会有任何房子的面积是0或房龄正好是0年,我们仍然需要偏置项。
如果没有偏置项,我们模型的表达能力将受到限制。
严格来说, :eqref:eq_price-area是输入特征的一个
仿射变换(affine transformation)。
仿射变换的特点是通过加权和对特征进行线性变换(linear transformation),
并通过偏置项来进行平移(translation)。
给定一个数据集,我们的目标是寻找模型的权重和偏置,
使得根据模型做出的预测大体符合数据里的真实价格。
输出的预测值由输入特征通过线性模型的仿射变换决定,仿射变换由所选权重和偏置确定。
而在机器学习领域,我们通常使用的是高维数据集,建模时采用线性代数表示法会比较方便。
当我们的输入包含个特征时,我们将预测结果
(通常使用“尖角”符号表示的估计值)表示为:
将所有特征放到向量中,
并将所有权重放到向量中,
我们可以用点积形式来简洁地表达模型:
在 :eqref:eq_linreg-y中,
向量对应于单个数据样本的特征。
用符号表示的矩阵
可以很方便地引用我们整个数据集的个样本。
其中,的每一行是一个样本,每一列是一种特征。
对于特征集合,预测值
可以通过矩阵-向量乘法表示为:
这个过程中的求和将使用广播机制
(广播机制在 :numref:subsec_broadcasting中有详细介绍)。
给定训练数据特征和对应的已知标签,
线性回归的目标是找到一组权重向量和偏置:
当给定从的同分布中取样的新样本特征时,
这组权重向量和偏置能够使得新样本预测标签的误差尽可能小。
虽然我们相信给定预测的最佳模型会是线性的,
但我们很难找到一个有个样本的真实数据集,其中对于所有的,完全等于。
无论我们使用什么手段来观察特征和标签,
都可能会出现少量的观测误差。
因此,即使确信特征与标签的潜在关系是线性的,
我们也会加入一个噪声项来考虑观测误差带来的影响。
在开始寻找最好的模型参数(model parameters)和之前,
我们还需要两个东西:
(1)一种模型质量的度量方式;
(2)一种能够更新模型以提高模型预测质量的方法。
损失函数
在我们开始考虑如何用模型拟合(fit)数据之前,我们需要确定一个拟合程度的度量。
损失函数(loss function)能够量化目标的实际值与预测值之间的差距。
通常我们会选择非负数作为损失,且数值越小表示损失越小,完美预测时的损失为0。
回归问题中最常用的损失函数是平方误差函数。
当样本的预测值为,其相应的真实标签为时,
平方误差可以定义为以下公式:
常数不会带来本质的差别,但这样在形式上稍微简单一些
(因为当我们对损失函数求导后常数系数为1)。
由于训练数据集并不受我们控制,所以经验误差只是关于模型参数的函数。
为了进一步说明,来看下面的例子。
我们为一维情况下的回归问题绘制图像,如 :numref:fig_fit_linreg所示。
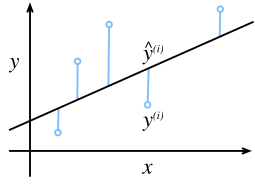
由于平方误差函数中的二次方项,
估计值和观测值之间较大的差异将导致更大的损失。
为了度量模型在整个数据集上的质量,我们需计算在训练集个样本上的损失均值(也等价于求和)。
在训练模型时,我们希望寻找一组参数(),
这组参数能最小化在所有训练样本上的总损失。如下式:
解析解
线性回归刚好是一个很简单的优化问题。
与我们将在本书中所讲到的其他大部分模型不同,线性回归的解可以用一个公式简单地表达出来,
这类解叫作解析解(analytical solution)。
首先,我们将偏置合并到参数中,合并方法是在包含所有参数的矩阵中附加一列。
我们的预测问题是最小化。
这在损失平面上只有一个临界点,这个临界点对应于整个区域的损失极小点。
将损失关于的导数设为0,得到解析解:
像线性回归这样的简单问题存在解析解,但并不是所有的问题都存在解析解。
解析解可以进行很好的数学分析,但解析解对问题的限制很严格,导致它无法广泛应用在深度学习里。
随机梯度下降
即使在我们无法得到解析解的情况下,我们仍然可以有效地训练模型。
在许多任务上,那些难以优化的模型效果要更好。
因此,弄清楚如何训练这些难以优化的模型是非常重要的。
本书中我们用到一种名为梯度下降(gradient descent)的方法,
这种方法几乎可以优化所有深度学习模型。
它通过不断地在损失函数递减的方向上更新参数来降低误差。
梯度下降最简单的用法是计算损失函数(数据集中所有样本的损失均值)
关于模型参数的导数(在这里也可以称为梯度)。
但实际中的执行可能会非常慢:因为在每一次更新参数之前,我们必须遍历整个数据集。
因此,我们通常会在每次需要计算更新的时候随机抽取一小批样本,
这种变体叫做小批量随机梯度下降(minibatch stochastic gradient descent)。
在每次迭代中,我们首先随机抽样一个小批量,
它是由固定数量的训练样本组成的。
然后,我们计算小批量的平均损失关于模型参数的导数(也可以称为梯度)。
最后,我们将梯度乘以一个预先确定的正数,并从当前参数的值中减掉。
我们用下面的数学公式来表示这一更新过程(表示偏导数):
总结一下,算法的步骤如下:
(1)初始化模型参数的值,如随机初始化;
(2)从数据集中随机抽取小批量样本且在负梯度的方向上更新参数,并不断迭代这一步骤。
对于平方损失和仿射变换,我们可以明确地写成如下形式:
公式 :eqref:eq_linreg_batch_update中的和都是向量。
在这里,更优雅的向量表示法比系数表示法(如)更具可读性。
表示每个小批量中的样本数,这也称为批量大小(batch size)。
表示学习率(learning rate)。
批量大小和学习率的值通常是手动预先指定,而不是通过模型训练得到的。
这些可以调整但不在训练过程中更新的参数称为超参数(hyperparameter)。
调参(hyperparameter tuning)是选择超参数的过程。
超参数通常是我们根据训练迭代结果来调整的,
而训练迭代结果是在独立的验证数据集(validation dataset)上评估得到的。
在训练了预先确定的若干迭代次数后(或者直到满足某些其他停止条件后),
我们记录下模型参数的估计值,表示为。
但是,即使我们的函数确实是线性的且无噪声,这些估计值也不会使损失函数真正地达到最小值。
因为算法会使得损失向最小值缓慢收敛,但却不能在有限的步数内非常精确地达到最小值。
线性回归恰好是一个在整个域中只有一个最小值的学习问题。
但是对像深度神经网络这样复杂的模型来说,损失平面上通常包含多个最小值。
深度学习实践者很少会去花费大力气寻找这样一组参数,使得在训练集上的损失达到最小。
事实上,更难做到的是找到一组参数,这组参数能够在我们从未见过的数据上实现较低的损失,
这一挑战被称为泛化(generalization)。
用模型进行预测
给定“已学习”的线性回归模型,
现在我们可以通过房屋面积和房龄来估计一个(未包含在训练数据中的)新房屋价格。
给定特征估计目标的过程通常称为预测(prediction)或推断(inference)。
本书将尝试坚持使用预测这个词。
虽然推断这个词已经成为深度学习的标准术语,但其实推断这个词有些用词不当。
在统计学中,推断更多地表示基于数据集估计参数。
当深度学习从业者与统计学家交谈时,术语的误用经常导致一些误解。
矢量化加速
在训练我们的模型时,我们经常希望能够同时处理整个小批量的样本。
为了实现这一点,需要(我们对计算进行矢量化,
从而利用线性代数库,而不是在Python中编写开销高昂的for循环)。
%matplotlib inline
from d2l import torch as d2l
import math
import torch
import numpy as np
import time为了说明矢量化为什么如此重要,我们考虑(对向量相加的两种方法)。
我们实例化两个全为1的10000维向量。
在一种方法中,我们将使用Python的for循环遍历向量;
在另一种方法中,我们将依赖对+的调用。
由于在本书中我们将频繁地进行运行时间的基准测试,所以[我们定义一个计时器]:
现在我们可以对工作负载进行基准测试。
首先,[我们使用for循环,每次执行一位的加法]。
(或者,我们使用重载的+运算符来计算按元素的和)。
结果很明显,第二种方法比第一种方法快得多。
矢量化代码通常会带来数量级的加速。
另外,我们将更多的数学运算放到库中,而无须自己编写那么多的计算,从而减少了出错的可能性。
正态分布与平方损失
接下来,我们通过对噪声分布的假设来解读平方损失目标函数。
正态分布和线性回归之间的关系很密切。
正态分布(normal distribution),也称为高斯分布(Gaussian distribution),
最早由德国数学家高斯(Gauss)应用于天文学研究。
简单的说,若随机变量具有均值和方差(标准差),其正态分布概率密度函数如下:
下面[我们定义一个Python函数来计算正态分布]。
我们现在(可视化正态分布)。
, tensorflow, paddle
# 再次使用numpy进行可视化
x = np.arange(-7, 7, 0.01)

# 均值和标准差对
params = [(0, 1), (0, 2), (3, 1)]
d2l.plot(x, [normal(x, mu, sigma) for mu, sigma in params], xlabel='x',
         ylabel='p(x)', figsize=(4.5, 2.5),
legend=[f'mean {mu}, std {sigma}' for mu, sigma in params])就像我们所看到的,改变均值会产生沿轴的偏移,增加方差将会分散分布、降低其峰值。
均方误差损失函数(简称均方损失)可以用于线性回归的一个原因是:
我们假设了观测中包含噪声,其中噪声服从正态分布。
噪声正态分布如下式:
其中,。
因此,我们现在可以写出通过给定的观测到特定的似然(likelihood):
现在,根据极大似然估计法,参数和的最优值是使整个数据集的似然最大的值:
根据极大似然估计法选择的估计量称为极大似然估计量。
虽然使许多指数函数的乘积最大化看起来很困难,
但是我们可以在不改变目标的前提下,通过最大化似然对数来简化。
由于历史原因,优化通常是说最小化而不是最大化。
我们可以改为最小化负对数似然。
由此可以得到的数学公式是:
现在我们只需要假设是某个固定常数就可以忽略第一项,
因为第一项不依赖于和。
现在第二项除了常数外,其余部分和前面介绍的均方误差是一样的。
幸运的是,上面式子的解并不依赖于。
因此,在高斯噪声的假设下,最小化均方误差等价于对线性模型的极大似然估计。
从线性回归到深度网络
到目前为止,我们只谈论了线性模型。
尽管神经网络涵盖了更多更为丰富的模型,我们依然可以用描述神经网络的方式来描述线性模型,
从而把线性模型看作一个神经网络。
首先,我们用“层”符号来重写这个模型。
神经网络图
深度学习从业者喜欢绘制图表来可视化模型中正在发生的事情。
在 :numref:fig_single_neuron中,我们将线性回归模型描述为一个神经网络。
需要注意的是,该图只显示连接模式,即只显示每个输入如何连接到输出,隐去了权重和偏置的值。
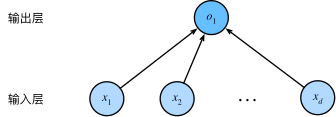
在 :numref:fig_single_neuron所示的神经网络中,输入为,
因此输入层中的输入数(或称为特征维度,feature dimensionality)为。
网络的输出为,因此输出层中的输出数是1。
需要注意的是,输入值都是已经给定的,并且只有一个计算神经元。
由于模型重点在发生计算的地方,所以通常我们在计算层数时不考虑输入层。
也就是说, :numref:fig_single_neuron中神经网络的层数为1。
我们可以将线性回归模型视为仅由单个人工神经元组成的神经网络,或称为单层神经网络。
对于线性回归,每个输入都与每个输出(在本例中只有一个输出)相连,
我们将这种变换( :numref:fig_single_neuron中的输出层)
称为全连接层(fully-connected layer)或称为稠密层(dense layer)。
下一章将详细讨论由这些层组成的网络。
生物学
线性回归发明的时间(1795年)早于计算神经科学,所以将线性回归描述为神经网络似乎不合适。
当控制学家、神经生物学家沃伦·麦库洛奇和沃尔特·皮茨开始开发人工神经元模型时,
他们为什么将线性模型作为一个起点呢?
我们来看一张图片 :numref:fig_Neuron:
这是一张由树突(dendrites,输入终端)、
细胞核(nucleus,CPU)组成的生物神经元图片。
轴突(axon,输出线)和轴突端子(axon terminal,输出端子)
通过突触(synapse)与其他神经元连接。
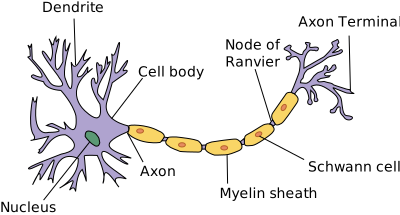
树突中接收到来自其他神经元(或视网膜等环境传感器)的信息。
该信息通过突触权重来加权,以确定输入的影响(即,通过相乘来激活或抑制)。
来自多个源的加权输入以加权和的形式汇聚在细胞核中,
然后将这些信息发送到轴突中进一步处理,通常会通过进行一些非线性处理。
之后,它要么到达目的地(例如肌肉),要么通过树突进入另一个神经元。
当然,许多这样的单元可以通过正确连接和正确的学习算法拼凑在一起,
从而产生的行为会比单独一个神经元所产生的行为更有趣、更复杂,
这种想法归功于我们对真实生物神经系统的研究。
当今大多数深度学习的研究几乎没有直接从神经科学中获得灵感。
我们援引斯图尔特·罗素和彼得·诺维格在他们的经典人工智能教科书
Artificial Intelligence:A Modern Approach (Russell.Norvig.2016)
中所说的:虽然飞机可能受到鸟类的启发,但几个世纪以来,鸟类学并不是航空创新的主要驱动力。
同样地,如今在深度学习中的灵感同样或更多地来自数学、统计学和计算机科学。
小结
- 机器学习模型中的关键要素是训练数据、损失函数、优化算法,还有模型本身。
- 矢量化使数学表达上更简洁,同时运行的更快。
- 最小化目标函数和执行极大似然估计等价。
- 线性回归模型也是一个简单的神经网络。
练习
- 假设我们有一些数据。我们的目标是找到一个常数,使得最小化。
- 找到最优值的解析解。
- 这个问题及其解与正态分布有什么关系?
- 推导出使用平方误差的线性回归优化问题的解析解。为了简化问题,可以忽略偏置(我们可以通过向添加所有值为1的一列来做到这一点)。
- 用矩阵和向量表示法写出优化问题(将所有数据视为单个矩阵,将所有目标值视为单个向量)。
- 计算损失对的梯度。
- 通过将梯度设为0、求解矩阵方程来找到解析解。
- 什么时候可能比使用随机梯度下降更好?这种方法何时会失效?
- 假定控制附加噪声的噪声模型是指数分布。也就是说,
- 写出模型下数据的负对数似然。
- 请试着写出解析解。
- 提出一种随机梯度下降算法来解决这个问题。哪里可能出错?(提示:当我们不断更新参数时,在驻点附近会发生什么情况)请尝试解决这个问题。
线性回归的从零开始实现
在了解线性回归的关键思想之后,我们可以开始通过代码来动手实现线性回归了。
在这一节中,(我们将从零开始实现整个方法,
包括数据流水线、模型、损失函数和小批量随机梯度下降优化器)。
虽然现代的深度学习框架几乎可以自动化地进行所有这些工作,但从零开始实现可以确保我们真正知道自己在做什么。
同时,了解更细致的工作原理将方便我们自定义模型、自定义层或自定义损失函数。
在这一节中,我们将只使用张量和自动求导。
在之后的章节中,我们会充分利用深度学习框架的优势,介绍更简洁的实现方式。
%matplotlib inline
from d2l import torch as d2l
import torch
import random
生成数据集
为了简单起见,我们将[根据带有噪声的线性模型构造一个人造数据集。]
我们的任务是使用这个有限样本的数据集来恢复这个模型的参数。
我们将使用低维数据,这样可以很容易地将其可视化。
在下面的代码中,我们生成一个包含1000个样本的数据集,
每个样本包含从标准正态分布中采样的2个特征。
我们的合成数据集是一个矩阵。
(**我们使用线性模型参数、
和噪声项生成数据集及其标签:
**)
可以视为模型预测和标签时的潜在观测误差。
在这里我们认为标准假设成立,即服从均值为0的正态分布。
为了简化问题,我们将标准差设为0.01。
下面的代码生成合成数据集。
注意,[features中的每一行都包含一个二维数据样本,
labels中的每一行都包含一维标签值(一个标量)]。
通过生成第二个特征features[:, 1]和labels的散点图,
可以直观观察到两者之间的线性关系。
读取数据集
回想一下,训练模型时要对数据集进行遍历,每次抽取一小批量样本,并使用它们来更新我们的模型。
由于这个过程是训练机器学习算法的基础,所以有必要定义一个函数,
该函数能打乱数据集中的样本并以小批量方式获取数据。
在下面的代码中,我们[定义一个data_iter函数,
该函数接收批量大小、特征矩阵和标签向量作为输入,生成大小为batch_size的小批量]。
每个小批量包含一组特征和标签。
通常,我们利用GPU并行运算的优势,处理合理大小的“小批量”。
每个样本都可以并行地进行模型计算,且每个样本损失函数的梯度也可以被并行计算。
GPU可以在处理几百个样本时,所花费的时间不比处理一个样本时多太多。
我们直观感受一下小批量运算:读取第一个小批量数据样本并打印。
每个批量的特征维度显示批量大小和输入特征数。
同样的,批量的标签形状与batch_size相等。
当我们运行迭代时,我们会连续地获得不同的小批量,直至遍历完整个数据集。
上面实现的迭代对教学来说很好,但它的执行效率很低,可能会在实际问题上陷入麻烦。
例如,它要求我们将所有数据加载到内存中,并执行大量的随机内存访问。
在深度学习框架中实现的内置迭代器效率要高得多,
它可以处理存储在文件中的数据和数据流提供的数据。
初始化模型参数
[在我们开始用小批量随机梯度下降优化我们的模型参数之前],
(我们需要先有一些参数)。
在下面的代码中,我们通过从均值为0、标准差为0.01的正态分布中采样随机数来初始化权重,
并将偏置初始化为0。
w = torch.normal(0, 0.01, size=(2,1), requires_grad=True)
b = torch.zeros(1, requires_grad=True)
在初始化参数之后,我们的任务是更新这些参数,直到这些参数足够拟合我们的数据。
每次更新都需要计算损失函数关于模型参数的梯度。
有了这个梯度,我们就可以向减小损失的方向更新每个参数。
因为手动计算梯度很枯燥而且容易出错,所以没有人会手动计算梯度。
我们使用 :numref:sec_autograd中引入的自动微分来计算梯度。
定义模型
接下来,我们必须[定义模型,将模型的输入和参数同模型的输出关联起来。]
回想一下,要计算线性模型的输出,
我们只需计算输入特征和模型权重的矩阵-向量乘法后加上偏置。
注意,上面的是一个向量,而是一个标量。
回想一下 :numref:subsec_broadcasting中描述的广播机制:
当我们用一个向量加一个标量时,标量会被加到向量的每个分量上。
[定义损失函数]
因为需要计算损失函数的梯度,所以我们应该先定义损失函数。
这里我们使用 :numref:sec_linear_regression中描述的平方损失函数。
在实现中,我们需要将真实值y的形状转换为和预测值y_hat的形状相同。
(定义优化算法)
正如我们在 :numref:sec_linear_regression中讨论的,线性回归有解析解。
尽管线性回归有解析解,但本书中的其他模型却没有。
这里我们介绍小批量随机梯度下降。
在每一步中,使用从数据集中随机抽取的一个小批量,然后根据参数计算损失的梯度。
接下来,朝着减少损失的方向更新我们的参数。
下面的函数实现小批量随机梯度下降更新。
该函数接受模型参数集合、学习速率和批量大小作为输入。每
一步更新的大小由学习速率lr决定。
因为我们计算的损失是一个批量样本的总和,所以我们用批量大小(batch_size)
来规范化步长,这样步长大小就不会取决于我们对批量大小的选择。
def sgd(params, lr, batch_size):  #@save
    """小批量随机梯度下降"""
    with torch.no_grad():
        for param in params:
            param -= lr * param.grad / batch_size
            param.grad.zero_()
训练
现在我们已经准备好了模型训练所有需要的要素,可以实现主要的[训练过程]部分了。
理解这段代码至关重要,因为从事深度学习后,
相同的训练过程几乎一遍又一遍地出现。
在每次迭代中,我们读取一小批量训练样本,并通过我们的模型来获得一组预测。
计算完损失后,我们开始反向传播,存储每个参数的梯度。
最后,我们调用优化算法sgd来更新模型参数。
概括一下,我们将执行以下循环:
- 初始化参数
- 重复以下训练,直到完成
- 计算梯度
- 更新参数
在每个迭代周期(epoch)中,我们使用data_iter函数遍历整个数据集,
并将训练数据集中所有样本都使用一次(假设样本数能够被批量大小整除)。
这里的迭代周期个数num_epochs和学习率lr都是超参数,分别设为3和0.03。
设置超参数很棘手,需要通过反复试验进行调整。
我们现在忽略这些细节,以后会在 :numref:chap_optimization中详细介绍。
for epoch in range(num_epochs):
    for X, y in data_iter(batch_size, features, labels):
        l = loss(net(X, w, b), y)  # X和y的小批量损失
        # 因为l形状是(batch_size,1),而不是一个标量。l中的所有元素被加到一起,
        # 并以此计算关于[w,b]的梯度
        l.sum().backward()
        sgd([w, b], lr, batch_size)  # 使用参数的梯度更新参数
    with torch.no_grad():
        train_l = loss(net(features, w, b), labels)
        print(f'epoch {epoch + 1}, loss {float(train_l.mean()):f}')
因为我们使用的是自己合成的数据集,所以我们知道真正的参数是什么。
因此,我们可以通过[比较真实参数和通过训练学到的参数来评估训练的成功程度]。
事实上,真实参数和通过训练学到的参数确实非常接近。
注意,我们不应该想当然地认为我们能够完美地求解参数。
在机器学习中,我们通常不太关心恢复真正的参数,而更关心如何高度准确预测参数。
幸运的是,即使是在复杂的优化问题上,随机梯度下降通常也能找到非常好的解。
其中一个原因是,在深度网络中存在许多参数组合能够实现高度精确的预测。
小结
- 我们学习了深度网络是如何实现和优化的。在这一过程中只使用张量和自动微分,不需要定义层或复杂的优化器。
- 这一节只触及到了表面知识。在下面的部分中,我们将基于刚刚介绍的概念描述其他模型,并学习如何更简洁地实现其他模型。
练习
- 如果我们将权重初始化为零,会发生什么。算法仍然有效吗?
- 假设试图为电压和电流的关系建立一个模型。自动微分可以用来学习模型的参数吗?
- 能基于普朗克定律使用光谱能量密度来确定物体的温度吗?
- 计算二阶导数时可能会遇到什么问题?这些问题可以如何解决?
- 为什么在
squared_loss函数中需要使用reshape函数? - 尝试使用不同的学习率,观察损失函数值下降的快慢。
- 如果样本个数不能被批量大小整除,
data_iter函数的行为会有什么变化?
线性回归的简洁实现
在过去的几年里,出于对深度学习强烈的兴趣,
许多公司、学者和业余爱好者开发了各种成熟的开源框架。
这些框架可以自动化基于梯度的学习算法中重复性的工作。
在 :numref:sec_linear_scratch中,我们只运用了:
(1)通过张量来进行数据存储和线性代数;
(2)通过自动微分来计算梯度。
实际上,由于数据迭代器、损失函数、优化器和神经网络层很常用,
现代深度学习库也为我们实现了这些组件。
本节将介绍如何(通过使用深度学习框架来简洁地实现)
:numref:sec_linear_scratch中的(线性回归模型)。
生成数据集
与 :numref:sec_linear_scratch中类似,我们首先[生成数据集]。
from d2l import torch as d2l
import numpy as np
import torch
from torch.utils import data
读取数据集
我们可以[调用框架中现有的API来读取数据]。
我们将features和labels作为API的参数传递,并通过数据迭代器指定batch_size。
此外,布尔值is_train表示是否希望数据迭代器对象在每个迭代周期内打乱数据。
def load_array(data_arrays, batch_size, is_train=True):  #@save
    """构造一个PyTorch数据迭代器"""
    dataset = data.TensorDataset(*data_arrays)
return data.DataLoader(dataset, batch_size, shuffle=is_train)使用data_iter的方式与我们在 :numref:sec_linear_scratch中使用data_iter函数的方式相同。为了验证是否正常工作,让我们读取并打印第一个小批量样本。
与 :numref:sec_linear_scratch不同,这里我们使用iter构造Python迭代器,并使用next从迭代器中获取第一项。
定义模型
当我们在 :numref:sec_linear_scratch中实现线性回归时,
我们明确定义了模型参数变量,并编写了计算的代码,这样通过基本的线性代数运算得到输出。
但是,如果模型变得更加复杂,且当我们几乎每天都需要实现模型时,自然会想简化这个过程。
这种情况类似于为自己的博客从零开始编写网页。
做一两次是有益的,但如果每个新博客就需要工程师花一个月的时间重新开始编写网页,那并不高效。
对于标准深度学习模型,我们可以[使用框架的预定义好的层]。这使我们只需关注使用哪些层来构造模型,而不必关注层的实现细节。
我们首先定义一个模型变量net,它是一个Sequential类的实例。
Sequential类将多个层串联在一起。
当给定输入数据时,Sequential实例将数据传入到第一层,
然后将第一层的输出作为第二层的输入,以此类推。
在下面的例子中,我们的模型只包含一个层,因此实际上不需要Sequential。
但是由于以后几乎所有的模型都是多层的,在这里使用Sequential会让你熟悉“标准的流水线”。
回顾 :numref:fig_single_neuron中的单层网络架构,
这一单层被称为全连接层(fully-connected layer),
因为它的每一个输入都通过矩阵-向量乘法得到它的每个输出。
在PyTorch中,全连接层在Linear类中定义。
值得注意的是,我们将两个参数传递到nn.Linear中。
第一个指定输入特征形状,即2,第二个指定输出特征形状,输出特征形状为单个标量,因此为1。
# nn是神经网络的缩写
from torch import nn
net = nn.Sequential(nn.Linear(2, 1))(初始化模型参数)
在使用net之前,我们需要初始化模型参数。
如在线性回归模型中的权重和偏置。
深度学习框架通常有预定义的方法来初始化参数。
在这里,我们指定每个权重参数应该从均值为0、标准差为0.01的正态分布中随机采样,
偏置参数将初始化为零。
正如我们在构造nn.Linear时指定输入和输出尺寸一样,
现在我们能直接访问参数以设定它们的初始值。
我们通过net[0]选择网络中的第一个图层,
然后使用weight.data和bias.data方法访问参数。
我们还可以使用替换方法normal_和fill_来重写参数值。
net[0].weight.data.normal_(0, 0.01)
net[0].bias.data.fill_(0)
定义损失函数
[计算均方误差使用的是MSELoss类,也称为平方范数]。
默认情况下,它返回所有样本损失的平均值。
loss = nn.MSELoss()定义优化算法
小批量随机梯度下降算法是一种优化神经网络的标准工具,
PyTorch在optim模块中实现了该算法的许多变种。
当我们(实例化一个SGD实例)时,我们要指定优化的参数
(可通过net.parameters()从我们的模型中获得)以及优化算法所需的超参数字典。
小批量随机梯度下降只需要设置lr值,这里设置为0.03。
trainer = torch.optim.SGD(net.parameters(), lr=0.03)训练
通过深度学习框架的高级API来实现我们的模型只需要相对较少的代码。
我们不必单独分配参数、不必定义我们的损失函数,也不必手动实现小批量随机梯度下降。
当我们需要更复杂的模型时,高级API的优势将大大增加。
当我们有了所有的基本组件,[训练过程代码与我们从零开始实现时所做的非常相似]。
回顾一下:在每个迭代周期里,我们将完整遍历一次数据集(train_data),
不停地从中获取一个小批量的输入和相应的标签。
对于每一个小批量,我们会进行以下步骤:
- 通过调用
net(X)生成预测并计算损失l(前向传播)。 - 通过进行反向传播来计算梯度。
- 通过调用优化器来更新模型参数。
为了更好的衡量训练效果,我们计算每个迭代周期后的损失,并打印它来监控训练过程。
num_epochs = 3
for epoch in range(num_epochs):
    for X, y in data_iter:
        l = loss(net(X) ,y)
        trainer.zero_grad()
        l.backward()
        trainer.step()
    l = loss(net(features), labels)
print(f'epoch {epoch + 1}, loss {l:f}')下面我们[比较生成数据集的真实参数和通过有限数据训练获得的模型参数]。
要访问参数,我们首先从net访问所需的层,然后读取该层的权重和偏置。
正如在从零开始实现中一样,我们估计得到的参数与生成数据的真实参数非常接近。
w = net[0].weight.data
print('w的估计误差:', true_w - d2l.reshape(w, true_w.shape))
b = net[0].bias.data
print('b的估计误差:', true_b - b)
小结
- 我们可以使用PyTorch的高级API更简洁地实现模型。
- 在PyTorch中,
data模块提供了数据处理工具,nn模块定义了大量的神经网络层和常见损失函数。 - 我们可以通过
_结尾的方法将参数替换,从而初始化参数。
练习
- 如果将小批量的总损失替换为小批量损失的平均值,需要如何更改学习率?
- 查看深度学习框架文档,它们提供了哪些损失函数和初始化方法?用Huber损失代替原损失,即
- 如何访问线性回归的梯度?
softmax回归
在 :numref:sec_linear_regression中我们介绍了线性回归。
随后,在 :numref:sec_linear_scratch中我们从头实现线性回归。
然后,在 :numref:sec_linear_concise中我们使用深度学习框架的高级API简洁实现线性回归。
回归可以用于预测多少的问题。
比如预测房屋被售出价格,或者棒球队可能获得的胜场数,又或者患者住院的天数。
事实上,我们也对分类问题感兴趣:不是问“多少”,而是问“哪一个”:
- 某个电子邮件是否属于垃圾邮件文件夹?
- 某个用户可能注册或不注册订阅服务?
- 某个图像描绘的是驴、狗、猫、还是鸡?
- 某人接下来最有可能看哪部电影?
通常,机器学习实践者用分类这个词来描述两个有微妙差别的问题:
- 我们只对样本的“硬性”类别感兴趣,即属于哪个类别;
- 我们希望得到“软性”类别,即得到属于每个类别的概率。
这两者的界限往往很模糊。其中的一个原因是:即使我们只关心硬类别,我们仍然使用软类别的模型。
分类问题
我们从一个图像分类问题开始。
假设每次输入是一个的灰度图像。
我们可以用一个标量表示每个像素值,每个图像对应四个特征。
此外,假设每个图像属于类别“猫”“鸡”和“狗”中的一个。
接下来,我们要选择如何表示标签。
我们有两个明显的选择:最直接的想法是选择,
其中整数分别代表。
这是在计算机上存储此类信息的有效方法。
如果类别间有一些自然顺序,
比如说我们试图预测,
那么将这个问题转变为回归问题,并且保留这种格式是有意义的。
但是一般的分类问题并不与类别之间的自然顺序有关。
幸运的是,统计学家很早以前就发明了一种表示分类数据的简单方法:独热编码(one-hot encoding)。
独热编码是一个向量,它的分量和类别一样多。
类别对应的分量设置为1,其他所有分量设置为0。
在我们的例子中,标签将是一个三维向量,
其中对应于“猫”、对应于“鸡”、对应于“狗”:
网络架构
为了估计所有可能类别的条件概率,我们需要一个有多个输出的模型,每个类别对应一个输出。
为了解决线性模型的分类问题,我们需要和输出一样多的仿射函数(affine function)。
每个输出对应于它自己的仿射函数。
在我们的例子中,由于我们有4个特征和3个可能的输出类别,
我们将需要12个标量来表示权重(带下标的),
3个标量来表示偏置(带下标的)。
下面我们为每个输入计算三个未规范化的预测(logit):、和。
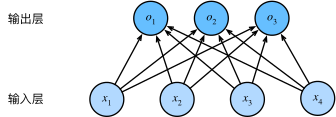
我们可以用神经网络图 :numref:fig_softmaxreg来描述这个计算过程。
与线性回归一样,softmax回归也是一个单层神经网络。
由于计算每个输出、和取决于
所有输入、、和,
所以softmax回归的输出层也是全连接层。
为了更简洁地表达模型,我们仍然使用线性代数符号。
通过向量形式表达为,
这是一种更适合数学和编写代码的形式。
由此,我们已经将所有权重放到一个矩阵中。
对于给定数据样本的特征,
我们的输出是由权重与输入特征进行矩阵-向量乘法再加上偏置得到的。
全连接层的参数开销
正如我们将在后续章节中看到的,在深度学习中,全连接层无处不在。
然而,顾名思义,全连接层是“完全”连接的,可能有很多可学习的参数。
具体来说,对于任何具有个输入和个输出的全连接层,
参数开销为,这个数字在实践中可能高得令人望而却步。
幸运的是,将个输入转换为个输出的成本可以减少到,
其中超参数可以由我们灵活指定,以在实际应用中平衡参数节约和模型有效性
(Zhang.Tay.Zhang.ea.2021)。
softmax运算
现在我们将优化参数以最大化观测数据的概率。
为了得到预测结果,我们将设置一个阈值,如选择具有最大概率的标签。
我们希望模型的输出可以视为属于类的概率,
然后选择具有最大输出值的类别作为我们的预测。
例如,如果、和分别为0.1、0.8和0.1,
那么我们预测的类别是2,在我们的例子中代表“鸡”。
然而我们能否将未规范化的预测直接视作我们感兴趣的输出呢?
答案是否定的。
因为将线性层的输出直接视为概率时存在一些问题:
一方面,我们没有限制这些输出数字的总和为1。
另一方面,根据输入的不同,它们可以为负值。
这些违反了 :numref:sec_prob中所说的概率基本公理。
要将输出视为概率,我们必须保证在任何数据上的输出都是非负的且总和为1。
此外,我们需要一个训练的目标函数,来激励模型精准地估计概率。
例如,
在分类器输出0.5的所有样本中,我们希望这些样本是刚好有一半实际上属于预测的类别。
这个属性叫做校准(calibration)。
社会科学家邓肯·卢斯于1959年在选择模型(choice model)的理论基础上
发明的softmax函数正是这样做的:
softmax函数能够将未规范化的预测变换为非负数并且总和为1,同时让模型保持
可导的性质。
为了完成这一目标,我们首先对每个未规范化的预测求幂,这样可以确保输出非负。
为了确保最终输出的概率值总和为1,我们再让每个求幂后的结果除以它们的总和。如下式:
这里,对于所有的总有。
因此,可以视为一个正确的概率分布。
softmax运算不会改变未规范化的预测之间的大小次序,只会确定分配给每个类别的概率。
因此,在预测过程中,我们仍然可以用下式来选择最有可能的类别。
尽管softmax是一个非线性函数,但softmax回归的输出仍然由输入特征的仿射变换决定。
因此,softmax回归是一个线性模型(linear model)。
小批量样本的矢量化
为了提高计算效率并且充分利用GPU,我们通常会对小批量样本的数据执行矢量计算。
假设我们读取了一个批量的样本,
其中特征维度(输入数量)为,批量大小为。
此外,假设我们在输出中有个类别。
那么小批量样本的特征为,
权重为,
偏置为。
softmax回归的矢量计算表达式为:
相对于一次处理一个样本,
小批量样本的矢量化加快了的矩阵-向量乘法。
由于中的每一行代表一个数据样本,
那么softmax运算可以按行(rowwise)执行:
对于的每一行,我们先对所有项进行幂运算,然后通过求和对它们进行标准化。
在 :eqref:eq_minibatch_softmax_reg中,
的求和会使用广播机制,
小批量的未规范化预测和输出概率
都是形状为的矩阵。
损失函数
接下来,我们需要一个损失函数来度量预测的效果。
我们将使用最大似然估计,这与在线性回归
( :numref:subsec_normal_distribution_and_squared_loss)
中的方法相同。
对数似然
softmax函数给出了一个向量,
我们可以将其视为“对给定任意输入的每个类的条件概率”。
例如,=。
假设整个数据集具有个样本,
其中索引的样本由特征向量和独热标签向量组成。
我们可以将估计值与实际值进行比较:
根据最大似然估计,我们最大化,相当于最小化负对数似然:
其中,对于任何标签和模型预测,损失函数为:
在本节稍后的内容会讲到, :eqref:eq_l_cross_entropy中的损失函数
通常被称为交叉熵损失(cross-entropy loss)。
由于是一个长度为的独热编码向量,
所以除了一个项以外的所有项都消失了。
由于所有都是预测的概率,所以它们的对数永远不会大于。
因此,如果正确地预测实际标签,即如果实际标签,
则损失函数不能进一步最小化。
注意,这往往是不可能的。
例如,数据集中可能存在标签噪声(比如某些样本可能被误标),
或输入特征没有足够的信息来完美地对每一个样本分类。
softmax及其导数
由于softmax和相关的损失函数很常见,
因此我们需要更好地理解它的计算方式。
将 :eqref:eq_softmax_y_and_o代入损失 :eqref:eq_l_cross_entropy中。
利用softmax的定义,我们得到:
考虑相对于任何未规范化的预测的导数,我们得到:
换句话说,导数是我们softmax模型分配的概率与实际发生的情况(由独热标签向量表示)之间的差异。
从这个意义上讲,这与我们在回归中看到的非常相似,
其中梯度是观测值和估计值之间的差异。
这不是巧合,在任何指数族分布模型中
(参见本书附录中关于数学分布的一节),
对数似然的梯度正是由此得出的。
这使梯度计算在实践中变得容易很多。
交叉熵损失
现在让我们考虑整个结果分布的情况,即观察到的不仅仅是一个结果。
对于标签,我们可以使用与以前相同的表示形式。
唯一的区别是,我们现在用一个概率向量表示,如,
而不是仅包含二元项的向量。
我们使用 :eqref:eq_l_cross_entropy来定义损失,
它是所有标签分布的预期损失值。
此损失称为交叉熵损失(cross-entropy loss),它是分类问题最常用的损失之一。
本节我们将通过介绍信息论基础来理解交叉熵损失。
如果想了解更多信息论的细节,请进一步参考
本书附录中关于信息论的一节。
信息论基础
信息论(information theory)涉及编码、解码、发送以及尽可能简洁地处理信息或数据。
熵
信息论的核心思想是量化数据中的信息内容。
在信息论中,该数值被称为分布的熵(entropy)。可以通过以下方程得到:
信息论的基本定理之一指出,为了对从分布中随机抽取的数据进行编码,
我们至少需要“纳特(nat)”对其进行编码。
“纳特”相当于比特(bit),但是对数底为而不是2。因此,一个纳特是比特。
信息量
压缩与预测有什么关系呢?
想象一下,我们有一个要压缩的数据流。
如果我们很容易预测下一个数据,那么这个数据就很容易压缩。
为什么呢?
举一个极端的例子,假如数据流中的每个数据完全相同,这会是一个非常无聊的数据流。
由于它们总是相同的,我们总是知道下一个数据是什么。
所以,为了传递数据流的内容,我们不必传输任何信息。也就是说,“下一个数据是xx”这个事件毫无信息量。
但是,如果我们不能完全预测每一个事件,那么我们有时可能会感到"惊异"。
克劳德·香农决定用信息量来量化这种惊异程度。
在观察一个事件时,并赋予它(主观)概率。
当我们赋予一个事件较低的概率时,我们的惊异会更大,该事件的信息量也就更大。
在 :eqref:eq_softmax_reg_entropy中定义的熵,
是当分配的概率真正匹配数据生成过程时的信息量的期望。
重新审视交叉熵
如果把熵想象为“知道真实概率的人所经历的惊异程度”,那么什么是交叉熵?
交叉熵从到,记为。
我们可以把交叉熵想象为“主观概率为的观察者在看到根据概率生成的数据时的预期惊异”。
当时,交叉熵达到最低。
在这种情况下,从到的交叉熵是。
简而言之,我们可以从两方面来考虑交叉熵分类目标:
(i)最大化观测数据的似然;(ii)最小化传达标签所需的惊异。
模型预测和评估
在训练softmax回归模型后,给出任何样本特征,我们可以预测每个输出类别的概率。
通常我们使用预测概率最高的类别作为输出类别。
如果预测与实际类别(标签)一致,则预测是正确的。
在接下来的实验中,我们将使用精度(accuracy)来评估模型的性能。
精度等于正确预测数与预测总数之间的比率。
小结
- softmax运算获取一个向量并将其映射为概率。
- softmax回归适用于分类问题,它使用了softmax运算中输出类别的概率分布。
- 交叉熵是一个衡量两个概率分布之间差异的很好的度量,它测量给定模型编码数据所需的比特数。
练习
- 我们可以更深入地探讨指数族与softmax之间的联系。
- 计算softmax交叉熵损失的二阶导数。
- 计算给出的分布方差,并与上面计算的二阶导数匹配。
- 假设我们有三个类发生的概率相等,即概率向量是。
- 如果我们尝试为它设计二进制代码,有什么问题?
- 请设计一个更好的代码。提示:如果我们尝试编码两个独立的观察结果会发生什么?如果我们联合编码个观测值怎么办?
- softmax是对上面介绍的映射的误称(虽然深度学习领域中很多人都使用这个名字)。真正的softmax被定义为。
- 证明。
- 证明成立,前提是。
- 证明对于,有。
- soft-min会是什么样子?
- 将其扩展到两个以上的数字。
图像分类数据集
(MNIST数据集) (LeCun.Bottou.Bengio.ea.1998)
(是图像分类中广泛使用的数据集之一,但作为基准数据集过于简单。
我们将使用类似但更复杂的Fashion-MNIST数据集) (Xiao.Rasul.Vollgraf.2017)。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torchvision import transforms
from torch.utils import data

d2l.use_svg_display()
读取数据集
我们可以[通过框架中的内置函数将Fashion-MNIST数据集下载并读取到内存中]。
# 通过ToTensor实例将图像数据从PIL类型变换成32位浮点数格式,
# 并除以255使得所有像素的数值均在0~1之间
trans = transforms.ToTensor()
mnist_train = torchvision.datasets.FashionMNIST(
    root="../data", train=True, transform=trans, download=True)
mnist_test = torchvision.datasets.FashionMNIST(
    root="../data", train=False, transform=trans, download=True)
Fashion-MNIST由10个类别的图像组成,
每个类别由训练数据集(train dataset)中的6000张图像
和测试数据集(test dataset)中的1000张图像组成。
因此,训练集和测试集分别包含60000和10000张图像。
测试数据集不会用于训练,只用于评估模型性能。
每个输入图像的高度和宽度均为28像素。
数据集由灰度图像组成,其通道数为1。
为了简洁起见,本书将高度像素、宽度像素图像的形状记为或(,)。
[两个可视化数据集的函数]
Fashion-MNIST中包含的10个类别,分别为t-shirt(T恤)、trouser(裤子)、pullover(套衫)、dress(连衣裙)、coat(外套)、sandal(凉鞋)、shirt(衬衫)、sneaker(运动鞋)、bag(包)和ankle boot(短靴)。
以下函数用于在数字标签索引及其文本名称之间进行转换。
我们现在可以创建一个函数来可视化这些样本。
def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5):  #@save
    """绘制图像列表"""
    figsize = (num_cols * scale, num_rows * scale)
    _, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize)
    axes = axes.flatten()
    for i, (ax, img) in enumerate(zip(axes, imgs)):
        if torch.is_tensor(img):
            # 图片张量
            ax.imshow(img.numpy())
        else:
            # PIL图片
            ax.imshow(img)
        ax.axes.get_xaxis().set_visible(False)
        ax.axes.get_yaxis().set_visible(False)
        if titles:
            ax.set_title(titles[i])
return axes以下是训练数据集中前[几个样本的图像及其相应的标签]。
X, y = next(iter(data.DataLoader(mnist_train, batch_size=18)))
show_images(X.reshape(18, 28, 28), 2, 9, titles=get_fashion_mnist_labels(y));
读取小批量
为了使我们在读取训练集和测试集时更容易,我们使用内置的数据迭代器,而不是从零开始创建。
回顾一下,在每次迭代中,数据加载器每次都会[读取一小批量数据,大小为batch_size]。
通过内置数据迭代器,我们可以随机打乱了所有样本,从而无偏见地读取小批量。
batch_size = 256

def get_dataloader_workers():  #@save
    """使用4个进程来读取数据"""
    return 4

train_iter = data.DataLoader(mnist_train, batch_size, shuffle=True,
                             num_workers=get_dataloader_workers())
我们看一下读取训练数据所需的时间。
整合所有组件
现在我们[定义load_data_fashion_mnist函数],用于获取和读取Fashion-MNIST数据集。
这个函数返回训练集和验证集的数据迭代器。
此外,这个函数还接受一个可选参数resize,用来将图像大小调整为另一种形状。
def load_data_fashion_mnist(batch_size, resize=None):  #@save
    """下载Fashion-MNIST数据集,然后将其加载到内存中"""
    trans = [transforms.ToTensor()]
    if resize:
        trans.insert(0, transforms.Resize(resize))
    trans = transforms.Compose(trans)
    mnist_train = torchvision.datasets.FashionMNIST(
        root="../data", train=True, transform=trans, download=True)
    mnist_test = torchvision.datasets.FashionMNIST(
        root="../data", train=False, transform=trans, download=True)
    return (data.DataLoader(mnist_train, batch_size, shuffle=True,
                            num_workers=get_dataloader_workers()),
            data.DataLoader(mnist_test, batch_size, shuffle=False,
num_workers=get_dataloader_workers()))下面,我们通过指定resize参数来测试load_data_fashion_mnist函数的图像大小调整功能。
我们现在已经准备好使用Fashion-MNIST数据集,便于下面的章节调用来评估各种分类算法。
小结
- Fashion-MNIST是一个服装分类数据集,由10个类别的图像组成。我们将在后续章节中使用此数据集来评估各种分类算法。
- 我们将高度像素,宽度像素图像的形状记为或(,)。
- 数据迭代器是获得更高性能的关键组件。依靠实现良好的数据迭代器,利用高性能计算来避免减慢训练过程。
练习
- 减少
batch_size(如减少到1)是否会影响读取性能? - 数据迭代器的性能非常重要。当前的实现足够快吗?探索各种选择来改进它。
- 查阅框架的在线API文档。还有哪些其他数据集可用?
softmax回归的从零开始实现
(就像我们从零开始实现线性回归一样,)
我们认为softmax回归也是重要的基础,因此(应该知道实现softmax回归的细节)。
本节我们将使用刚刚在 :numref:sec_fashion_mnist中引入的Fashion-MNIST数据集,
并设置数据迭代器的批量大小为256。
from d2l import torch as d2l
import torch
from IPython import display
初始化模型参数
和之前线性回归的例子一样,这里的每个样本都将用固定长度的向量表示。
原始数据集中的每个样本都是的图像。
本节[将展平每个图像,把它们看作长度为784的向量。]
在后面的章节中,我们将讨论能够利用图像空间结构的特征,
但现在我们暂时只把每个像素位置看作一个特征。
回想一下,在softmax回归中,我们的输出与类别一样多。
(因为我们的数据集有10个类别,所以网络输出维度为10)。
因此,权重将构成一个的矩阵,
偏置将构成一个的行向量。
与线性回归一样,我们将使用正态分布初始化我们的权重W,偏置初始化为0。
num_inputs = 784
num_outputs = 10

W = torch.normal(0, 0.01, size=(num_inputs, num_outputs), requires_grad=True)
b = torch.zeros(num_outputs, requires_grad=True)
定义softmax操作
在实现softmax回归模型之前,我们简要回顾一下sum运算符如何沿着张量中的特定维度工作。
如 :numref:subseq_lin-alg-reduction和
:numref:subseq_lin-alg-non-reduction所述,
[给定一个矩阵X,我们可以对所有元素求和](默认情况下)。
也可以只求同一个轴上的元素,即同一列(轴0)或同一行(轴1)。
如果X是一个形状为(2, 3)的张量,我们对列进行求和,
则结果将是一个具有形状(3,)的向量。
当调用sum运算符时,我们可以指定保持在原始张量的轴数,而不折叠求和的维度。
这将产生一个具有形状(1, 3)的二维张量。
, paddle
X = d2l.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
d2l.reduce_sum(X, 0, keepdim=True), d2l.reduce_sum(X, 1, keepdim=True)回想一下,[实现softmax]由三个步骤组成:
- 对每个项求幂(使用
exp); - 对每一行求和(小批量中每个样本是一行),得到每个样本的规范化常数;
- 将每一行除以其规范化常数,确保结果的和为1。
在查看代码之前,我们回顾一下这个表达式:
(**
**)
分母或规范化常数,有时也称为配分函数(其对数称为对数-配分函数)。
该名称来自统计物理学中一个模拟粒子群分布的方程。
, paddle
def softmax(X):
    X_exp = d2l.exp(X)
    partition = d2l.reduce_sum(X_exp, 1, keepdim=True)
return X_exp / partition # 这里应用了广播机制正如上述代码,对于任何随机输入,[我们将每个元素变成一个非负数。 此外,依据概率原理,每行总和为1]。
注意,虽然这在数学上看起来是正确的,但我们在代码实现中有点草率。
矩阵中的非常大或非常小的元素可能造成数值上溢或下溢,但我们没有采取措施来防止这点。
定义模型
定义softmax操作后,我们可以[实现softmax回归模型]。
下面的代码定义了输入如何通过网络映射到输出。
注意,将数据传递到模型之前,我们使用reshape函数将每张原始图像展平为向量。
定义损失函数
接下来,我们实现 :numref:sec_softmax中引入的交叉熵损失函数。
这可能是深度学习中最常见的损失函数,因为目前分类问题的数量远远超过回归问题的数量。
回顾一下,交叉熵采用真实标签的预测概率的负对数似然。
这里我们不使用Python的for循环迭代预测(这往往是低效的),
而是通过一个运算符选择所有元素。
下面,我们[创建一个数据样本y_hat,其中包含2个样本在3个类别的预测概率,
以及它们对应的标签y。]
有了y,我们知道在第一个样本中,第一类是正确的预测;
而在第二个样本中,第三类是正确的预测。
然后(使用y作为y_hat中概率的索引),
我们选择第一个样本中第一个类的概率和第二个样本中第三个类的概率。
现在我们只需一行代码就可以[实现交叉熵损失函数]。
分类精度
给定预测概率分布y_hat,当我们必须输出硬预测(hard prediction)时,
我们通常选择预测概率最高的类。
许多应用都要求我们做出选择。如Gmail必须将电子邮件分类为“Primary(主要邮件)”、
“Social(社交邮件)”“Updates(更新邮件)”或“Forums(论坛邮件)”。
Gmail做分类时可能在内部估计概率,但最终它必须在类中选择一个。
当预测与标签分类y一致时,即是正确的。
分类精度即正确预测数量与总预测数量之比。
虽然直接优化精度可能很困难(因为精度的计算不可导),
但精度通常是我们最关心的性能衡量标准,我们在训练分类器时几乎总会关注它。
为了计算精度,我们执行以下操作。
首先,如果y_hat是矩阵,那么假定第二个维度存储每个类的预测分数。
我们使用argmax获得每行中最大元素的索引来获得预测类别。
然后我们[将预测类别与真实y元素进行比较]。
由于等式运算符“==”对数据类型很敏感,
因此我们将y_hat的数据类型转换为与y的数据类型一致。
结果是一个包含0(错)和1(对)的张量。
最后,我们求和会得到正确预测的数量。
我们将继续使用之前定义的变量y_hat和y分别作为预测的概率分布和标签。
可以看到,第一个样本的预测类别是2(该行的最大元素为0.6,索引为2),这与实际标签0不一致。
第二个样本的预测类别是2(该行的最大元素为0.5,索引为2),这与实际标签2一致。
因此,这两个样本的分类精度率为0.5。
同样,对于任意数据迭代器data_iter可访问的数据集,
[我们可以评估在任意模型net的精度]。
def evaluate_accuracy(net, data_iter):  #@save
    """计算在指定数据集上模型的精度"""
    if isinstance(net, torch.nn.Module):
        net.eval()  # 将模型设置为评估模式
    metric = Accumulator(2)  # 正确预测数、预测总数
    with torch.no_grad():
        for X, y in data_iter:
            metric.add(accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]这里定义一个实用程序类Accumulator,用于对多个变量进行累加。
在上面的evaluate_accuracy函数中,
我们在(Accumulator实例中创建了2个变量,
分别用于存储正确预测的数量和预测的总数量)。
当我们遍历数据集时,两者都将随着时间的推移而累加。
由于我们使用随机权重初始化net模型,
因此该模型的精度应接近于随机猜测。
例如在有10个类别情况下的精度为0.1。
训练
在我们看过 :numref:sec_linear_scratch中的线性回归实现,
[softmax回归的训练]过程代码应该看起来非常眼熟。
在这里,我们重构训练过程的实现以使其可重复使用。
首先,我们定义一个函数来训练一个迭代周期。
请注意,updater是更新模型参数的常用函数,它接受批量大小作为参数。
它可以是d2l.sgd函数,也可以是框架的内置优化函数。
def train_epoch_ch3(net, train_iter, loss, updater):  #@save
    """训练模型一个迭代周期(定义见第3章)"""
    # 将模型设置为训练模式
    if isinstance(net, torch.nn.Module):
        net.train()
    # 训练损失总和、训练准确度总和、样本数
    metric = Accumulator(3)
    for X, y in train_iter:
        # 计算梯度并更新参数
        y_hat = net(X)
        l = loss(y_hat, y)
        if isinstance(updater, torch.optim.Optimizer):
            # 使用PyTorch内置的优化器和损失函数
            updater.zero_grad()
            l.mean().backward()
            updater.step()
        else:
            # 使用定制的优化器和损失函数
            l.sum().backward()
            updater(X.shape[0])
        metric.add(float(l.sum()), accuracy(y_hat, y), y.numel())
    # 返回训练损失和训练精度
return metric[0] / metric[2], metric[1] / metric[2]在展示训练函数的实现之前,我们[定义一个在动画中绘制数据的实用程序类]Animator,
它能够简化本书其余部分的代码。
接下来我们实现一个[训练函数],
它会在train_iter访问到的训练数据集上训练一个模型net。
该训练函数将会运行多个迭代周期(由num_epochs指定)。
在每个迭代周期结束时,利用test_iter访问到的测试数据集对模型进行评估。
我们将利用Animator类来可视化训练进度。
作为一个从零开始的实现,我们使用 :numref:sec_linear_scratch中定义的
[小批量随机梯度下降来优化模型的损失函数],设置学习率为0.1。
现在,我们[训练模型10个迭代周期]。
请注意,迭代周期(num_epochs)和学习率(lr)都是可调节的超参数。
通过更改它们的值,我们可以提高模型的分类精度。
预测
现在训练已经完成,我们的模型已经准备好[对图像进行分类预测]。
给定一系列图像,我们将比较它们的实际标签(文本输出的第一行)和模型预测(文本输出的第二行)。
小结
- 借助softmax回归,我们可以训练多分类的模型。
- 训练softmax回归循环模型与训练线性回归模型非常相似:先读取数据,再定义模型和损失函数,然后使用优化算法训练模型。大多数常见的深度学习模型都有类似的训练过程。
练习
- 本节直接实现了基于数学定义softmax运算的
softmax函数。这可能会导致什么问题?提示:尝试计算的大小。 - 本节中的函数
cross_entropy是根据交叉熵损失函数的定义实现的。它可能有什么问题?提示:考虑对数的定义域。 - 请想一个解决方案来解决上述两个问题。
- 返回概率最大的分类标签总是最优解吗?例如,医疗诊断场景下可以这样做吗?
- 假设我们使用softmax回归来预测下一个单词,可选取的单词数目过多可能会带来哪些问题?
softmax回归的简洁实现
在 :numref:sec_linear_concise中,
我们发现(通过深度学习框架的高级API能够使实现)
(softmax)
线性(回归变得更加容易)。
同样,通过深度学习框架的高级API也能更方便地实现softmax回归模型。
本节如在 :numref:sec_softmax_scratch中一样,
继续使用Fashion-MNIST数据集,并保持批量大小为256。
from d2l import torch as d2l
import torch
from torch import nn
初始化模型参数
如我们在 :numref:sec_softmax所述,
[softmax回归的输出层是一个全连接层]。
因此,为了实现我们的模型,
我们只需在Sequential中添加一个带有10个输出的全连接层。
同样,在这里Sequential并不是必要的,
但它是实现深度模型的基础。
我们仍然以均值0和标准差0.01随机初始化权重。
# PyTorch不会隐式地调整输入的形状。因此,
# 我们在线性层前定义了展平层(flatten),来调整网络输入的形状
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))

def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights);
重新审视Softmax的实现
在前面 :numref:sec_softmax_scratch的例子中,
我们计算了模型的输出,然后将此输出送入交叉熵损失。
从数学上讲,这是一件完全合理的事情。
然而,从计算角度来看,指数可能会造成数值稳定性问题。
回想一下,softmax函数,
其中是预测的概率分布。
是未规范化的预测的第个元素。
如果中的一些数值非常大,
那么可能大于数据类型容许的最大数字,即上溢(overflow)。
这将使分母或分子变为inf(无穷大),
最后得到的是0、inf或nan(不是数字)的。
在这些情况下,我们无法得到一个明确定义的交叉熵值。
解决这个问题的一个技巧是:
在继续softmax计算之前,先从所有中减去。
这里可以看到每个按常数进行的移动不会改变softmax的返回值:
在减法和规范化步骤之后,可能有些具有较大的负值。
由于精度受限,将有接近零的值,即下溢(underflow)。
这些值可能会四舍五入为零,使为零,
并且使得的值为-inf。
反向传播几步后,我们可能会发现自己面对一屏幕可怕的nan结果。
尽管我们要计算指数函数,但我们最终在计算交叉熵损失时会取它们的对数。
通过将softmax和交叉熵结合在一起,可以避免反向传播过程中可能会困扰我们的数值稳定性问题。
如下面的等式所示,我们避免计算,
而可以直接使用,因为被抵消了。
我们也希望保留传统的softmax函数,以备我们需要评估通过模型输出的概率。
但是,我们没有将softmax概率传递到损失函数中,
而是[在交叉熵损失函数中传递未规范化的预测,并同时计算softmax及其对数],
这是一种类似"LogSumExp技巧"的聪明方式。
, paddle
loss = nn.CrossEntropyLoss(reduction='none')
优化算法
在这里,我们(使用学习率为0.1的小批量随机梯度下降作为优化算法)。
这与我们在线性回归例子中的相同,这说明了优化器的普适性。
trainer = torch.optim.SGD(net.parameters(), lr=0.1)训练
接下来我们[调用] :numref:sec_softmax_scratch中(之前)
(定义的训练函数来训练模型)。
和以前一样,这个算法使结果收敛到一个相当高的精度,而且这次的代码比之前更精简了。
小结
- 使用深度学习框架的高级API,我们可以更简洁地实现softmax回归。
- 从计算的角度来看,实现softmax回归比较复杂。在许多情况下,深度学习框架在这些著名的技巧之外采取了额外的预防措施,来确保数值的稳定性。这使我们避免了在实践中从零开始编写模型时可能遇到的陷阱。
练习
- 尝试调整超参数,例如批量大小、迭代周期数和学习率,并查看结果。
- 增加迭代周期的数量。为什么测试精度会在一段时间后降低?我们怎么解决这个问题?