11 / 19
循环神经网络
到目前为止,我们遇到过两种类型的数据:表格数据和图像数据。
对于图像数据,我们设计了专门的卷积神经网络架构来为这类特殊的数据结构建模。
换句话说,如果我们拥有一张图像,我们需要有效地利用其像素位置,
假若我们对图像中的像素位置进行重排,就会对图像中内容的推断造成极大的困难。
最重要的是,到目前为止我们默认数据都来自于某种分布,
并且所有样本都是独立同分布的
(independently and identically distributed,i.i.d.)。
然而,大多数的数据并非如此。
例如,文章中的单词是按顺序写的,如果顺序被随机地重排,就很难理解文章原始的意思。
同样,视频中的图像帧、对话中的音频信号以及网站上的浏览行为都是有顺序的。
因此,针对此类数据而设计特定模型,可能效果会更好。
另一个问题来自这样一个事实:
我们不仅仅可以接收一个序列作为输入,而是还可能期望继续猜测这个序列的后续。
例如,一个任务可以是继续预测。
这在时间序列分析中是相当常见的,可以用来预测股市的波动、
患者的体温曲线或者赛车所需的加速度。
同理,我们需要能够处理这些数据的特定模型。
简言之,如果说卷积神经网络可以有效地处理空间信息,
那么本章的循环神经网络(recurrent neural network,RNN)则可以更好地处理序列信息。
循环神经网络通过引入状态变量存储过去的信息和当前的输入,从而可以确定当前的输出。
许多使用循环网络的例子都是基于文本数据的,因此我们将在本章中重点介绍语言模型。
在对序列数据进行更详细的回顾之后,我们将介绍文本预处理的实用技术。
然后,我们将讨论语言模型的基本概念,并将此讨论作为循环神经网络设计的灵感。
最后,我们描述了循环神经网络的梯度计算方法,以探讨训练此类网络时可能遇到的问题。
:maxdepth: 2

sequence
text-preprocessing
language-models-and-dataset
rnn
rnn-scratch
rnn-concise
bptt
序列模型
想象一下有人正在看网飞(Netflix,一个国外的视频网站)上的电影。
一名忠实的用户会对每一部电影都给出评价,
毕竟一部好电影需要更多的支持和认可。
然而事实证明,事情并不那么简单。
随着时间的推移,人们对电影的看法会发生很大的变化。
事实上,心理学家甚至对这些现象起了名字:
- 锚定(anchoring)效应:基于其他人的意见做出评价。
例如,奥斯卡颁奖后,受到关注的电影的评分会上升,尽管它还是原来那部电影。
这种影响将持续几个月,直到人们忘记了这部电影曾经获得的奖项。
结果表明( (Wu.Ahmed.Beutel.ea.2017)),这种效应会使评分提高半个百分点以上。 - 享乐适应(hedonic adaption):人们迅速接受并且适应一种更好或者更坏的情况
作为新的常态。
例如,在看了很多好电影之后,人们会强烈期望下部电影会更好。
因此,在许多精彩的电影被看过之后,即使是一部普通的也可能被认为是糟糕的。 - 季节性(seasonality):少有观众喜欢在八月看圣诞老人的电影。
- 有时,电影会由于导演或演员在制作中的不当行为变得不受欢迎。
- 有些电影因为其极度糟糕只能成为小众电影。Plan9from Outer Space和Troll2就因为这个原因而臭名昭著的。
简而言之,电影评分决不是固定不变的。
因此,使用时间动力学可以得到更准确的电影推荐 (Koren.2009)。
当然,序列数据不仅仅是关于电影评分的。
下面给出了更多的场景。
- 在使用程序时,许多用户都有很强的特定习惯。
例如,在学生放学后社交媒体应用更受欢迎。在市场开放时股市交易软件更常用。 - 预测明天的股价要比过去的股价更困难,尽管两者都只是估计一个数字。
毕竟,先见之明比事后诸葛亮难得多。
在统计学中,前者(对超出已知观测范围进行预测)称为外推法(extrapolation),
而后者(在现有观测值之间进行估计)称为内插法(interpolation)。 - 在本质上,音乐、语音、文本和视频都是连续的。
如果它们的序列被我们重排,那么就会失去原有的意义。
比如,一个文本标题“狗咬人”远没有“人咬狗”那么令人惊讶,尽管组成两句话的字完全相同。 - 地震具有很强的相关性,即大地震发生后,很可能会有几次小余震,
这些余震的强度比非大地震后的余震要大得多。
事实上,地震是时空相关的,即余震通常发生在很短的时间跨度和很近的距离内。 - 人类之间的互动也是连续的,这可以从微博上的争吵和辩论中看出。
统计工具
处理序列数据需要统计工具和新的深度神经网络架构。
为了简单起见,我们以 :numref:fig_ftse100所示的股票价格(富时100指数)为例。
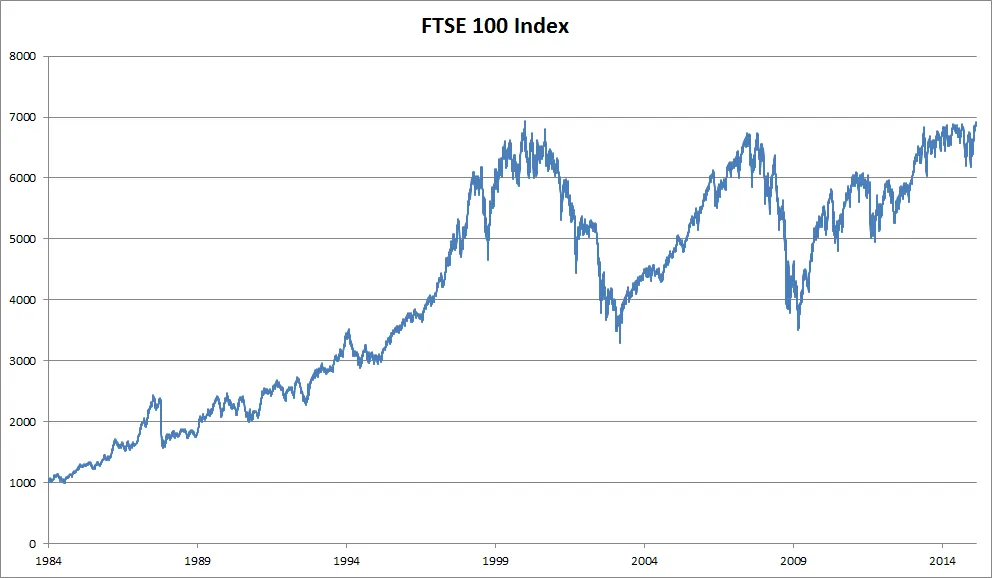
:width:400px
其中,用表示价格,即在时间步(time step)
时,观察到的价格。
请注意,对于本文中的序列通常是离散的,并在整数或其子集上变化。
假设一个交易员想在日的股市中表现良好,于是通过以下途径预测:
自回归模型
为了实现这个预测,交易员可以使用回归模型,
例如在 :numref:sec_linear_concise中训练的模型。
仅有一个主要问题:输入数据的数量,
输入本身因而异。
也就是说,输入数据的数量这个数字将会随着我们遇到的数据量的增加而增加,
因此需要一个近似方法来使这个计算变得容易处理。
本章后面的大部分内容将围绕着如何有效估计
展开。
简单地说,它归结为以下两种策略。
第一种策略,假设在现实情况下相当长的序列
可能是不必要的,
因此我们只需要满足某个长度为的时间跨度,
即使用观测序列。
当下获得的最直接的好处就是参数的数量总是不变的,
至少在时如此,这就使我们能够训练一个上面提及的深度网络。
这种模型被称为自回归模型(autoregressive models),
因为它们是对自己执行回归。
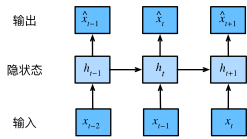
第二种策略,如 :numref:fig_sequence-model所示,
是保留一些对过去观测的总结,
并且同时更新预测和总结。
这就产生了基于估计,
以及公式更新的模型。
由于从未被观测到,这类模型也被称为
隐变量自回归模型(latent autoregressive models)。
这两种情况都有一个显而易见的问题:如何生成训练数据?
一个经典方法是使用历史观测来预测下一个未来观测。
显然,我们并不指望时间会停滞不前。
然而,一个常见的假设是虽然特定值可能会改变,
但是序列本身的动力学不会改变。
这样的假设是合理的,因为新的动力学一定受新的数据影响,
而我们不可能用目前所掌握的数据来预测新的动力学。
统计学家称不变的动力学为静止的(stationary)。
因此,整个序列的估计值都将通过以下的方式获得:
注意,如果我们处理的是离散的对象(如单词),
而不是连续的数字,则上述的考虑仍然有效。
唯一的差别是,对于离散的对象,
我们需要使用分类器而不是回归模型来估计。
马尔可夫模型
回想一下,在自回归模型的近似法中,
我们使用
而不是来估计。
只要这种是近似精确的,我们就说序列满足马尔可夫条件(Markov condition)。
特别是,如果,得到一个
一阶马尔可夫模型(first-order Markov model),
由下式给出:
当假设仅是离散值时,这样的模型特别棒,
因为在这种情况下,使用动态规划可以沿着马尔可夫链精确地计算结果。
例如,我们可以高效地计算:
利用这一事实,我们只需要考虑过去观察中的一个非常短的历史:
。
隐马尔可夫模型中的动态规划超出了本节的范围
(我们将在 :numref:sec_bi_rnn再次遇到),
而动态规划这些计算工具已经在控制算法和强化学习算法广泛使用。
因果关系
原则上,将倒序展开也没什么问题。
毕竟,基于条件概率公式,我们总是可以写出:
事实上,如果基于一个马尔可夫模型,
我们还可以得到一个反向的条件概率分布。
然而,在许多情况下,数据存在一个自然的方向,即在时间上是前进的。
很明显,未来的事件不能影响过去。
因此,如果我们改变,可能会影响未来发生的事情,但不能反过来。
也就是说,如果我们改变,基于过去事件得到的分布不会改变。
因此,解释应该比解释更容易。
例如,在某些情况下,对于某些可加性噪声,
显然我们可以找到,
而反之则不行 (Hoyer.Janzing.Mooij.ea.2009)。
而这个向前推进的方向恰好也是我们通常感兴趣的方向。
彼得斯等人 (Peters.Janzing.Scholkopf.2017)
对该主题的更多内容做了详尽的解释,而我们的上述讨论只是其中的冰山一角。
训练
在了解了上述统计工具后,让我们在实践中尝试一下!
首先,我们生成一些数据:(使用正弦函数和一些可加性噪声来生成序列数据,
时间步为。)
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn接下来,我们将这个序列转换为模型的特征-标签(feature-label)对。
基于嵌入维度,我们[将数据映射为数据对
和。]
这比我们提供的数据样本少了个,
因为我们没有足够的历史记录来描述前个数据样本。
一个简单的解决办法是:如果拥有足够长的序列就丢弃这几项;
另一个方法是用零填充序列。
在这里,我们仅使用前600个“特征-标签”对进行训练。
在这里,我们[使用一个相当简单的架构训练模型: 一个拥有两个全连接层的多层感知机],ReLU激活函数和平方损失。
# 初始化网络权重的函数
def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.xavier_uniform_(m.weight)

# 一个简单的多层感知机
def get_net():
    net = nn.Sequential(nn.Linear(4, 10),
                        nn.ReLU(),
                        nn.Linear(10, 1))
    net.apply(init_weights)
    return net

# 平方损失。注意:MSELoss计算平方误差时不带系数1/2
loss = nn.MSELoss(reduction='none')现在,准备[训练模型]了。实现下面的训练代码的方式与前面几节(如 :numref:sec_linear_concise)中的循环训练基本相同。因此,我们不会深入探讨太多细节。
def train(net, train_iter, loss, epochs, lr):
    trainer = torch.optim.Adam(net.parameters(), lr)
    for epoch in range(epochs):
        for X, y in train_iter:
            trainer.zero_grad()
            l = loss(net(X), y)
            l.sum().backward()
            trainer.step()
        print(f'epoch {epoch + 1}, '
              f'loss: {d2l.evaluate_loss(net, train_iter, loss):f}')

net = get_net()
train(net, train_iter, loss, 5, 0.01)
预测
由于训练损失很小,因此我们期望模型能有很好的工作效果。
让我们看看这在实践中意味着什么。
首先是检查[模型预测下一个时间步]的能力,
也就是单步预测(one-step-ahead prediction)。
正如我们所料,单步预测效果不错。
即使这些预测的时间步超过了(n_train + tau),
其结果看起来仍然是可信的。
然而有一个小问题:如果数据观察序列的时间步只到,
我们需要一步一步地向前迈进:
通常,对于直到的观测序列,其在时间步处的预测输出
称为步预测(-step-ahead-prediction)。
由于我们的观察已经到了,它的步预测是。
换句话说,我们必须使用我们自己的预测(而不是原始数据)来[进行多步预测]。
让我们看看效果如何。
如上面的例子所示,绿线的预测显然并不理想。
经过几个预测步骤之后,预测的结果很快就会衰减到一个常数。
为什么这个算法效果这么差呢?事实是由于错误的累积:
假设在步骤之后,我们积累了一些错误。
于是,步骤的输入被扰动了,
结果积累的误差是依照次序的,
其中为某个常数,后面的预测误差依此类推。
因此误差可能会相当快地偏离真实的观测结果。
例如,未来小时的天气预报往往相当准确,
但超过这一点,精度就会迅速下降。
我们将在本章及后续章节中讨论如何改进这一点。
基于,通过对整个序列预测的计算,
让我们[更仔细地看一下步预测]的困难。
以上例子清楚地说明了当我们试图预测更远的未来时,预测的质量是如何变化的。
虽然“步预测”看起来仍然不错,但超过这个跨度的任何预测几乎都是无用的。
小结
- 内插法(在现有观测值之间进行估计)和外推法(对超出已知观测范围进行预测)在实践的难度上差别很大。因此,对于所拥有的序列数据,在训练时始终要尊重其时间顺序,即最好不要基于未来的数据进行训练。
- 序列模型的估计需要专门的统计工具,两种较流行的选择是自回归模型和隐变量自回归模型。
- 对于时间是向前推进的因果模型,正向估计通常比反向估计更容易。
- 对于直到时间步的观测序列,其在时间步的预测输出是“步预测”。随着我们对预测时间值的增加,会造成误差的快速累积和预测质量的极速下降。
练习
- 改进本节实验中的模型。
- 是否包含了过去个以上的观测结果?真实值需要是多少个?
- 如果没有噪音,需要多少个过去的观测结果?提示:把和写成微分方程。
- 可以在保持特征总数不变的情况下合并旧的观察结果吗?这能提高正确度吗?为什么?
- 改变神经网络架构并评估其性能。
- 一位投资者想要找到一种好的证券来购买。他查看过去的回报,以决定哪一种可能是表现良好的。这一策略可能会出什么问题呢?
- 时间是向前推进的因果模型在多大程度上适用于文本呢?
- 举例说明什么时候可能需要隐变量自回归模型来捕捉数据的动力学模型。
文本预处理
对于序列数据处理问题,我们在 :numref:sec_sequence中
评估了所需的统计工具和预测时面临的挑战。
这样的数据存在许多种形式,文本是最常见例子之一。
例如,一篇文章可以被简单地看作一串单词序列,甚至是一串字符序列。
本节中,我们将解析文本的常见预处理步骤。
这些步骤通常包括:
- 将文本作为字符串加载到内存中。
- 将字符串拆分为词元(如单词和字符)。
- 建立一个词表,将拆分的词元映射到数字索引。
- 将文本转换为数字索引序列,方便模型操作。
import collections
from d2l import torch as d2l
import re
读取数据集
首先,我们从H.G.Well的时光机器中加载文本。
这是一个相当小的语料库,只有30000多个单词,但足够我们小试牛刀,
而现实中的文档集合可能会包含数十亿个单词。
下面的函数(将数据集读取到由多条文本行组成的列表中),其中每条文本行都是一个字符串。
为简单起见,我们在这里忽略了标点符号和字母大写。
词元化
下面的tokenize函数将文本行列表(lines)作为输入,
列表中的每个元素是一个文本序列(如一条文本行)。
[每个文本序列又被拆分成一个词元列表],词元(token)是文本的基本单位。
最后,返回一个由词元列表组成的列表,其中的每个词元都是一个字符串(string)。
词表
词元的类型是字符串,而模型需要的输入是数字,因此这种类型不方便模型使用。
现在,让我们[构建一个字典,通常也叫做词表(vocabulary),
用来将字符串类型的词元映射到从开始的数字索引中]。
我们先将训练集中的所有文档合并在一起,对它们的唯一词元进行统计,
得到的统计结果称之为语料(corpus)。
然后根据每个唯一词元的出现频率,为其分配一个数字索引。
很少出现的词元通常被移除,这可以降低复杂性。
另外,语料库中不存在或已删除的任何词元都将映射到一个特定的未知词元“<unk>”。
我们可以选择增加一个列表,用于保存那些被保留的词元,
例如:填充词元(“<pad>”);
序列开始词元(“<bos>”);
序列结束词元(“<eos>”)。
我们首先使用时光机器数据集作为语料库来[构建词表],然后打印前几个高频词元及其索引。
现在,我们可以(将每一条文本行转换成一个数字索引列表)。
整合所有功能
在使用上述函数时,我们[将所有功能打包到load_corpus_time_machine函数中],
该函数返回corpus(词元索引列表)和vocab(时光机器语料库的词表)。
我们在这里所做的改变是:
- 为了简化后面章节中的训练,我们使用字符(而不是单词)实现文本词元化;
- 时光机器数据集中的每个文本行不一定是一个句子或一个段落,还可能是一个单词,因此返回的
corpus仅处理为单个列表,而不是使用多词元列表构成的一个列表。
小结
- 文本是序列数据的一种最常见的形式之一。
- 为了对文本进行预处理,我们通常将文本拆分为词元,构建词表将词元字符串映射为数字索引,并将文本数据转换为词元索引以供模型操作。
练习
- 词元化是一个关键的预处理步骤,它因语言而异。尝试找到另外三种常用的词元化文本的方法。
- 在本节的实验中,将文本词元为单词和更改
Vocab实例的min_freq参数。这对词表大小有何影响?
语言模型和数据集
在 :numref:sec_text_preprocessing中,
我们了解了如何将文本数据映射为词元,
以及将这些词元可以视为一系列离散的观测,例如单词或字符。
假设长度为的文本序列中的词元依次为。
于是,()
可以被认为是文本序列在时间步处的观测或标签。
在给定这样的文本序列时,语言模型(language model)的目标是估计序列的联合概率
例如,只需要一次抽取一个词元,
一个理想的语言模型就能够基于模型本身生成自然文本。
与猴子使用打字机完全不同的是,从这样的模型中提取的文本
都将作为自然语言(例如,英语文本)来传递。
只需要基于前面的对话片断中的文本,
就足以生成一个有意义的对话。
显然,我们离设计出这样的系统还很遥远,
因为它需要“理解”文本,而不仅仅是生成语法合理的内容。
尽管如此,语言模型依然是非常有用的。
例如,短语“to recognize speech”和“to wreck a nice beach”读音上听起来非常相似。
这种相似性会导致语音识别中的歧义,但是这很容易通过语言模型来解决,
因为第二句的语义很奇怪。
同样,在文档摘要生成算法中,
“狗咬人”比“人咬狗”出现的频率要高得多,
或者“我想吃奶奶”是一个相当匪夷所思的语句,
而“我想吃,奶奶”则要正常得多。
学习语言模型
显而易见,我们面对的问题是如何对一个文档,
甚至是一个词元序列进行建模。
假设在单词级别对文本数据进行词元化,
我们可以依靠在 :numref:sec_sequence中对序列模型的分析。
让我们从基本概率规则开始:
例如,包含了四个单词的一个文本序列的概率是:
为了训练语言模型,我们需要计算单词的概率,
以及给定前面几个单词后出现某个单词的条件概率。
这些概率本质上就是语言模型的参数。
这里,我们假设训练数据集是一个大型的文本语料库。
比如,维基百科的所有条目、
古登堡计划,
或者所有发布在网络上的文本。
训练数据集中词的概率可以根据给定词的相对词频来计算。
例如,可以将估计值
计算为任何以单词“deep”开头的句子的概率。
一种(稍稍不太精确的)方法是统计单词“deep”在数据集中的出现次数,
然后将其除以整个语料库中的单词总数。
这种方法效果不错,特别是对于频繁出现的单词。
接下来,我们可以尝试估计
其中和分别是单个单词和连续单词对的出现次数。
不幸的是,由于连续单词对“deep learning”的出现频率要低得多,
所以估计这类单词正确的概率要困难得多。
特别是对于一些不常见的单词组合,要想找到足够的出现次数来获得准确的估计可能都不容易。
而对于三个或者更多的单词组合,情况会变得更糟。
许多合理的三个单词组合可能是存在的,但是在数据集中却找不到。
除非我们提供某种解决方案,来将这些单词组合指定为非零计数,
否则将无法在语言模型中使用它们。
如果数据集很小,或者单词非常罕见,那么这类单词出现一次的机会可能都找不到。
一种常见的策略是执行某种形式的拉普拉斯平滑(Laplace smoothing),
具体方法是在所有计数中添加一个小常量。
用表示训练集中的单词总数,用表示唯一单词的数量。
此解决方案有助于处理单元素问题,例如通过:
其中,和是超参数。
以为例:当时,不应用平滑;
当接近正无穷大时,接近均匀概率分布。
上面的公式是 (Wood.Gasthaus.Archambeau.ea.2011)
的一个相当原始的变形。
然而,这样的模型很容易变得无效,原因如下:
首先,我们需要存储所有的计数;
其次,这完全忽略了单词的意思。
例如,“猫”(cat)和“猫科动物”(feline)可能出现在相关的上下文中,
但是想根据上下文调整这类模型其实是相当困难的。
最后,长单词序列大部分是没出现过的,
因此一个模型如果只是简单地统计先前“看到”的单词序列频率,
那么模型面对这种问题肯定是表现不佳的。
马尔可夫模型与元语法
在讨论包含深度学习的解决方案之前,我们需要了解更多的概念和术语。
回想一下我们在 :numref:sec_sequence中对马尔可夫模型的讨论,
并且将其应用于语言建模。
如果,
则序列上的分布满足一阶马尔可夫性质。
阶数越高,对应的依赖关系就越长。
这种性质推导出了许多可以应用于序列建模的近似公式:
通常,涉及一个、两个和三个变量的概率公式分别被称为
一元语法(unigram)、二元语法(bigram)和三元语法(trigram)模型。
下面,我们将学习如何去设计更好的模型。
自然语言统计
我们看看在真实数据上如果进行自然语言统计。
根据 :numref:sec_text_preprocessing中介绍的时光机器数据集构建词表,
并打印前个最常用的(频率最高的)单词。
from d2l import torch as d2l
import torch
import random正如我们所看到的,(最流行的词)看起来很无聊,
这些词通常(被称为停用词)(stop words),因此可以被过滤掉。
尽管如此,它们本身仍然是有意义的,我们仍然会在模型中使用它们。
此外,还有个明显的问题是词频衰减的速度相当地快。
例如,最常用单词的词频对比,第个还不到第个的。
为了更好地理解,我们可以[画出的词频图]:
通过此图我们可以发现:词频以一种明确的方式迅速衰减。
将前几个单词作为例外消除后,剩余的所有单词大致遵循双对数坐标图上的一条直线。
这意味着单词的频率满足齐普夫定律(Zipf's law),
即第个最常用单词的频率为:
等价于
其中是刻画分布的指数,是常数。
这告诉我们想要通过计数统计和平滑来建模单词是不可行的,
因为这样建模的结果会大大高估尾部单词的频率,也就是所谓的不常用单词。
那么[其他的词元组合,比如二元语法、三元语法等等,又会如何呢?]
我们来看看二元语法的频率是否与一元语法的频率表现出相同的行为方式。
这里值得注意:在十个最频繁的词对中,有九个是由两个停用词组成的,
只有一个与“the time”有关。
我们再进一步看看三元语法的频率是否表现出相同的行为方式。
最后,我们[直观地对比三种模型中的词元频率]:一元语法、二元语法和三元语法。
这张图非常令人振奋!原因有很多:
- 除了一元语法词,单词序列似乎也遵循齐普夫定律,
尽管公式 :eqref:eq_zipf_law中的指数更小
(指数的大小受序列长度的影响); - 词表中元组的数量并没有那么大,这说明语言中存在相当多的结构,
这些结构给了我们应用模型的希望; - 很多元组很少出现,这使得拉普拉斯平滑非常不适合语言建模。
作为代替,我们将使用基于深度学习的模型。
读取长序列数据
由于序列数据本质上是连续的,因此我们在处理数据时需要解决这个问题。
在 :numref:sec_sequence中我们以一种相当特别的方式做到了这一点:
当序列变得太长而不能被模型一次性全部处理时,
我们可能希望拆分这样的序列方便模型读取。
在介绍该模型之前,我们看一下总体策略。
假设我们将使用神经网络来训练语言模型,
模型中的网络一次处理具有预定义长度
(例如个时间步)的一个小批量序列。
现在的问题是如何[随机生成一个小批量数据的特征和标签以供读取。]
首先,由于文本序列可以是任意长的,
例如整本《时光机器》(The Time Machine),
于是任意长的序列可以被我们划分为具有相同时间步数的子序列。
当训练我们的神经网络时,这样的小批量子序列将被输入到模型中。
假设网络一次只处理具有个时间步的子序列。
:numref:fig_timemachine_5gram画出了
从原始文本序列获得子序列的所有不同的方式,
其中,并且每个时间步的词元对应于一个字符。
请注意,因为我们可以选择任意偏移量来指示初始位置,所以我们有相当大的自由度。
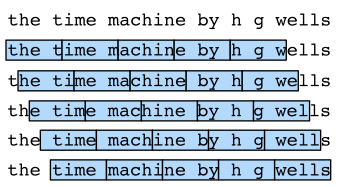
因此,我们应该从 :numref:fig_timemachine_5gram中选择哪一个呢?
事实上,他们都一样的好。
然而,如果我们只选择一个偏移量,
那么用于训练网络的、所有可能的子序列的覆盖范围将是有限的。
因此,我们可以从随机偏移量开始划分序列,
以同时获得覆盖性(coverage)和随机性(randomness)。
下面,我们将描述如何实现随机采样(random sampling)和
顺序分区(sequential partitioning)策略。
随机采样
(在随机采样中,每个样本都是在原始的长序列上任意捕获的子序列。)
在迭代过程中,来自两个相邻的、随机的、小批量中的子序列不一定在原始序列上相邻。
对于语言建模,目标是基于到目前为止我们看到的词元来预测下一个词元,
因此标签是移位了一个词元的原始序列。
下面的代码每次可以从数据中随机生成一个小批量。
在这里,参数batch_size指定了每个小批量中子序列样本的数目,
参数num_steps是每个子序列中预定义的时间步数。
下面我们[生成一个从到的序列]。
假设批量大小为,时间步数为,这意味着可以生成
个“特征-标签”子序列对。
如果设置小批量大小为,我们只能得到个小批量。
顺序分区
在迭代过程中,除了对原始序列可以随机抽样外,
我们还可以[保证两个相邻的小批量中的子序列在原始序列上也是相邻的]。
这种策略在基于小批量的迭代过程中保留了拆分的子序列的顺序,因此称为顺序分区。
基于相同的设置,通过顺序分区[读取每个小批量的子序列的特征X和标签Y]。
通过将它们打印出来可以发现:
迭代期间来自两个相邻的小批量中的子序列在原始序列中确实是相邻的。
现在,我们[将上面的两个采样函数包装到一个类中],
以便稍后可以将其用作数据迭代器。
[最后,我们定义了一个函数load_data_time_machine,
它同时返回数据迭代器和词表],
因此可以与其他带有load_data前缀的函数
(如 :numref:sec_fashion_mnist中定义的
d2l.load_data_fashion_mnist)类似地使用。
小结
- 语言模型是自然语言处理的关键。
- 元语法通过截断相关性,为处理长序列提供了一种实用的模型。
- 长序列存在一个问题:它们很少出现或者从不出现。
- 齐普夫定律支配着单词的分布,这个分布不仅适用于一元语法,还适用于其他元语法。
- 通过拉普拉斯平滑法可以有效地处理结构丰富而频率不足的低频词词组。
- 读取长序列的主要方式是随机采样和顺序分区。在迭代过程中,后者可以保证来自两个相邻的小批量中的子序列在原始序列上也是相邻的。
练习
- 假设训练数据集中有个单词。一个四元语法需要存储多少个词频和相邻多词频率?
- 我们如何对一系列对话建模?
- 一元语法、二元语法和三元语法的齐普夫定律的指数是不一样的,能设法估计么?
- 想一想读取长序列数据的其他方法?
- 考虑一下我们用于读取长序列的随机偏移量。
- 为什么随机偏移量是个好主意?
- 它真的会在文档的序列上实现完美的均匀分布吗?
- 要怎么做才能使分布更均匀?
- 如果我们希望一个序列样本是一个完整的句子,那么这在小批量抽样中会带来怎样的问题?如何解决?
循环神经网络
在 :numref:sec_language_model中,
我们介绍了元语法模型,
其中单词在时间步的条件概率仅取决于前面个单词。
对于时间步之前的单词,
如果我们想将其可能产生的影响合并到上,
需要增加,然而模型参数的数量也会随之呈指数增长,
因为词表需要存储个数字,
因此与其将模型化,
不如使用隐变量模型:
其中是隐状态(hidden state),
也称为隐藏变量(hidden variable),
它存储了到时间步的序列信息。
通常,我们可以基于当前输入和先前隐状态
来计算时间步处的任何时间的隐状态:
对于 :eqref:eq_ht_xt中的函数,隐变量模型不是近似值。
毕竟是可以仅仅存储到目前为止观察到的所有数据,
然而这样的操作可能会使计算和存储的代价都变得昂贵。
回想一下,我们在 :numref:chap_perceptrons中
讨论过的具有隐藏单元的隐藏层。
值得注意的是,隐藏层和隐状态指的是两个截然不同的概念。
如上所述,隐藏层是在从输入到输出的路径上(以观测角度来理解)的隐藏的层,
而隐状态则是在给定步骤所做的任何事情(以技术角度来定义)的输入,
并且这些状态只能通过先前时间步的数据来计算。
循环神经网络(recurrent neural networks,RNNs)
是具有隐状态的神经网络。
在介绍循环神经网络模型之前,
我们首先回顾 :numref:sec_mlp中介绍的多层感知机模型。
无隐状态的神经网络
让我们来看一看只有单隐藏层的多层感知机。
设隐藏层的激活函数为,
给定一个小批量样本,
其中批量大小为,输入维度为,
则隐藏层的输出通过下式计算:
在 :eqref:rnn_h_without_state中,
我们拥有的隐藏层权重参数为,
偏置参数为,
以及隐藏单元的数目为。
因此求和时可以应用广播机制(见 :numref:subsec_broadcasting)。
接下来,将隐藏变量用作输出层的输入。
输出层由下式给出:
其中,是输出变量,
是权重参数,
是输出层的偏置参数。
如果是分类问题,我们可以用
来计算输出类别的概率分布。
这完全类似于之前在 :numref:sec_sequence中解决的回归问题,
因此我们省略了细节。
无须多言,只要可以随机选择“特征-标签”对,
并且通过自动微分和随机梯度下降能够学习网络参数就可以了。
有隐状态的循环神经网络
有了隐状态后,情况就完全不同了。
假设我们在时间步有小批量输入。
换言之,对于个序列样本的小批量,
的每一行对应于来自该序列的时间步处的一个样本。
接下来,用
表示时间步的隐藏变量。
与多层感知机不同的是,
我们在这里保存了前一个时间步的隐藏变量,
并引入了一个新的权重参数,
来描述如何在当前时间步中使用前一个时间步的隐藏变量。
具体地说,当前时间步隐藏变量由当前时间步的输入
与前一个时间步的隐藏变量一起计算得出:
与 :eqref:rnn_h_without_state相比,
:eqref:rnn_h_with_state多添加了一项
,
从而实例化了 :eqref:eq_ht_xt。
从相邻时间步的隐藏变量和
之间的关系可知,
这些变量捕获并保留了序列直到其当前时间步的历史信息,
就如当前时间步下神经网络的状态或记忆,
因此这样的隐藏变量被称为隐状态(hidden state)。
由于在当前时间步中,
隐状态使用的定义与前一个时间步中使用的定义相同,
因此 :eqref:rnn_h_with_state的计算是循环的(recurrent)。
于是基于循环计算的隐状态神经网络被命名为
循环神经网络(recurrent neural network)。
在循环神经网络中执行 :eqref:rnn_h_with_state计算的层
称为循环层(recurrent layer)。
有许多不同的方法可以构建循环神经网络,
由 :eqref:rnn_h_with_state定义的隐状态的循环神经网络是非常常见的一种。
对于时间步,输出层的输出类似于多层感知机中的计算:
循环神经网络的参数包括隐藏层的权重
和偏置,
以及输出层的权重
和偏置。
值得一提的是,即使在不同的时间步,循环神经网络也总是使用这些模型参数。
因此,循环神经网络的参数开销不会随着时间步的增加而增加。
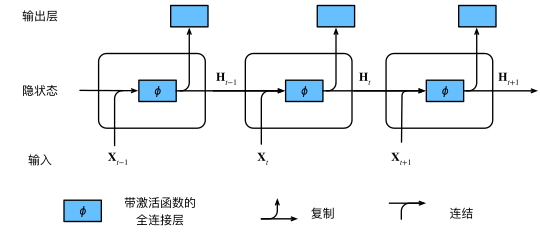
:numref:fig_rnn展示了循环神经网络在三个相邻时间步的计算逻辑。
在任意时间步,隐状态的计算可以被视为:
- 拼接当前时间步的输入和前一时间步的隐状态;
- 将拼接的结果送入带有激活函数的全连接层。
全连接层的输出是当前时间步的隐状态。
在本例中,模型参数是和的拼接,
以及的偏置,所有这些参数都来自 :eqref:rnn_h_with_state。
当前时间步的隐状态
将参与计算下一时间步的隐状态。
而且还将送入全连接输出层,
用于计算当前时间步的输出。
我们刚才提到,隐状态中
的计算,
相当于和的拼接
与和的拼接的矩阵乘法。
虽然这个性质可以通过数学证明,
但在下面我们使用一个简单的代码来说明一下。
首先,我们定义矩阵X、W_xh、H和W_hh,
它们的形状分别为、、和。
分别将X乘以W_xh,将H乘以W_hh,
然后将这两个乘法相加,我们得到一个形状为的矩阵。
from d2l import torch as d2l
import torch现在,我们沿列(轴1)拼接矩阵X和H,
沿行(轴0)拼接矩阵W_xh和W_hh。
这两个拼接分别产生形状和形状的矩阵。
再将这两个拼接的矩阵相乘,
我们得到与上面相同形状的输出矩阵。
基于循环神经网络的字符级语言模型
回想一下 :numref:sec_language_model中的语言模型,
我们的目标是根据过去的和当前的词元预测下一个词元,
因此我们将原始序列移位一个词元作为标签。
Bengio等人首先提出使用神经网络进行语言建模
(Bengio.Ducharme.Vincent.ea.2003)。
接下来,我们看一下如何使用循环神经网络来构建语言模型。
设小批量大小为1,批量中的文本序列为“machine”。
为了简化后续部分的训练,我们考虑使用
字符级语言模型(character-level language model),
将文本词元化为字符而不是单词。
:numref:fig_rnn_train演示了
如何通过基于字符级语言建模的循环神经网络,
使用当前的和先前的字符预测下一个字符。
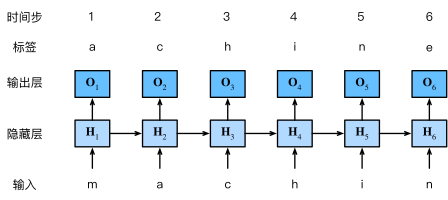
在训练过程中,我们对每个时间步的输出层的输出进行softmax操作,
然后利用交叉熵损失计算模型输出和标签之间的误差。
由于隐藏层中隐状态的循环计算,
:numref:fig_rnn_train中的第个时间步的输出
由文本序列“m”“a”和“c”确定。
由于训练数据中这个文本序列的下一个字符是“h”,
因此第个时间步的损失将取决于下一个字符的概率分布,
而下一个字符是基于特征序列“m”“a”“c”和这个时间步的标签“h”生成的。
在实践中,我们使用的批量大小为,
每个词元都由一个维向量表示。
因此,在时间步输入将是一个矩阵,
这与我们在 :numref:subsec_rnn_w_hidden_states中的讨论相同。
困惑度(Perplexity)
最后,让我们讨论如何度量语言模型的质量,
这将在后续部分中用于评估基于循环神经网络的模型。
一个好的语言模型能够用高度准确的词元来预测我们接下来会看到什么。
考虑一下由不同的语言模型给出的对“It is raining …”(“…下雨了”)的续写:
- "It is raining outside"(外面下雨了);
- "It is raining banana tree"(香蕉树下雨了);
- "It is raining piouw;kcj pwepoiut"(piouw;kcj pwepoiut下雨了)。
就质量而言,例显然是最合乎情理、在逻辑上最连贯的。
虽然这个模型可能没有很准确地反映出后续词的语义,
比如,“It is raining in San Francisco”(旧金山下雨了)
和“It is raining in winter”(冬天下雨了)
可能才是更完美的合理扩展,
但该模型已经能够捕捉到跟在后面的是哪类单词。
例则要糟糕得多,因为其产生了一个无意义的续写。
尽管如此,至少该模型已经学会了如何拼写单词,
以及单词之间的某种程度的相关性。
最后,例表明了训练不足的模型是无法正确地拟合数据的。
我们可以通过计算序列的似然概率来度量模型的质量。
然而这是一个难以理解、难以比较的数字。
毕竟,较短的序列比较长的序列更有可能出现,
因此评估模型产生托尔斯泰的巨著《战争与和平》的可能性
不可避免地会比产生圣埃克苏佩里的中篇小说《小王子》可能性要小得多。
而缺少的可能性值相当于平均数。
在这里,信息论可以派上用场了。
我们在引入softmax回归
( :numref:subsec_info_theory_basics)时定义了熵、惊异和交叉熵,
并在信息论的在线附录
中讨论了更多的信息论知识。
如果想要压缩文本,我们可以根据当前词元集预测的下一个词元。
一个更好的语言模型应该能让我们更准确地预测下一个词元。
因此,它应该允许我们在压缩序列时花费更少的比特。
所以我们可以通过一个序列中所有的个词元的交叉熵损失的平均值来衡量:
其中由语言模型给出,
是在时间步从该序列中观察到的实际词元。
这使得不同长度的文档的性能具有了可比性。
由于历史原因,自然语言处理的科学家更喜欢使用一个叫做困惑度(perplexity)的量。
简而言之,它是 :eqref:eq_avg_ce_for_lm的指数:
困惑度的最好的理解是“下一个词元的实际选择数的调和平均数”。
我们看看一些案例。
- 在最好的情况下,模型总是完美地估计标签词元的概率为1。
在这种情况下,模型的困惑度为1。 - 在最坏的情况下,模型总是预测标签词元的概率为0。
在这种情况下,困惑度是正无穷大。 - 在基线上,该模型的预测是词表的所有可用词元上的均匀分布。
在这种情况下,困惑度等于词表中唯一词元的数量。
事实上,如果我们在没有任何压缩的情况下存储序列,
这将是我们能做的最好的编码方式。
因此,这种方式提供了一个重要的上限,
而任何实际模型都必须超越这个上限。
在接下来的小节中,我们将基于循环神经网络实现字符级语言模型,
并使用困惑度来评估这样的模型。
小结
- 对隐状态使用循环计算的神经网络称为循环神经网络(RNN)。
- 循环神经网络的隐状态可以捕获直到当前时间步序列的历史信息。
- 循环神经网络模型的参数数量不会随着时间步的增加而增加。
- 我们可以使用循环神经网络创建字符级语言模型。
- 我们可以使用困惑度来评价语言模型的质量。
练习
- 如果我们使用循环神经网络来预测文本序列中的下一个字符,那么任意输出所需的维度是多少?
- 为什么循环神经网络可以基于文本序列中所有先前的词元,在某个时间步表示当前词元的条件概率?
- 如果基于一个长序列进行反向传播,梯度会发生什么状况?
- 与本节中描述的语言模型相关的问题有哪些?
循环神经网络的从零开始实现
本节将根据 :numref:sec_rnn中的描述,
从头开始基于循环神经网络实现字符级语言模型。
这样的模型将在H.G.Wells的时光机器数据集上训练。
和前面 :numref:sec_language_model中介绍过的一样,
我们先读取数据集。
%matplotlib inline
from d2l import torch as d2l
import math
import torch
from torch import nn
from torch.nn import functional as F[独热编码]
回想一下,在train_iter中,每个词元都表示为一个数字索引,
将这些索引直接输入神经网络可能会使学习变得困难。
我们通常将每个词元表示为更具表现力的特征向量。
最简单的表示称为独热编码(one-hot encoding),
它在 :numref:subsec_classification-problem中介绍过。
简言之,将每个索引映射为相互不同的单位向量:
假设词表中不同词元的数目为(即len(vocab)),
词元索引的范围为到。
如果词元的索引是整数,
那么我们将创建一个长度为的全向量,
并将第处的元素设置为。
此向量是原始词元的一个独热向量。
索引为和的独热向量如下所示:
F.one_hot(torch.tensor([0, 2]), len(vocab))我们每次采样的(小批量数据形状是二维张量:
(批量大小,时间步数)。)
one_hot函数将这样一个小批量数据转换成三维张量,
张量的最后一个维度等于词表大小(len(vocab))。
我们经常转换输入的维度,以便获得形状为
(时间步数,批量大小,词表大小)的输出。
这将使我们能够更方便地通过最外层的维度,
一步一步地更新小批量数据的隐状态。
X = d2l.reshape(d2l.arange(10), (2, 5))
F.one_hot(X.T, 28).shape
初始化模型参数
接下来,我们[初始化循环神经网络模型的模型参数]。
隐藏单元数num_hiddens是一个可调的超参数。
当训练语言模型时,输入和输出来自相同的词表。
因此,它们具有相同的维度,即词表的大小。
def get_params(vocab_size, num_hiddens, device):
    num_inputs = num_outputs = vocab_size

    def normal(shape):
        return torch.randn(size=shape, device=device) * 0.01

    # 隐藏层参数
    W_xh = normal((num_inputs, num_hiddens))
    W_hh = normal((num_hiddens, num_hiddens))
    b_h = d2l.zeros(num_hiddens, device=device)
    # 输出层参数
    W_hq = normal((num_hiddens, num_outputs))
    b_q = d2l.zeros(num_outputs, device=device)
    # 附加梯度
    params = [W_xh, W_hh, b_h, W_hq, b_q]
    for param in params:
        param.requires_grad_(True)
    return params
循环神经网络模型
为了定义循环神经网络模型,
我们首先需要[一个init_rnn_state函数在初始化时返回隐状态]。
这个函数的返回是一个张量,张量全用0填充,
形状为(批量大小,隐藏单元数)。
在后面的章节中我们将会遇到隐状态包含多个变量的情况,
而使用元组可以更容易地处理些。
def init_rnn_state(batch_size, num_hiddens, device):
return (d2l.zeros((batch_size, num_hiddens), device=device), )[下面的rnn函数定义了如何在一个时间步内计算隐状态和输出。]
循环神经网络模型通过inputs最外层的维度实现循环,
以便逐时间步更新小批量数据的隐状态H。
此外,这里使用函数作为激活函数。
如 :numref:sec_mlp所述,
当元素在实数上满足均匀分布时,函数的平均值为0。
def rnn(inputs, state, params):
    # inputs的形状:(时间步数量,批量大小,词表大小)
    W_xh, W_hh, b_h, W_hq, b_q = params
    H, = state
    outputs = []
    # X的形状:(批量大小,词表大小)
    for X in inputs:
        H = torch.tanh(torch.mm(X, W_xh) + torch.mm(H, W_hh) + b_h)
        Y = torch.mm(H, W_hq) + b_q
        outputs.append(Y)
return torch.cat(outputs, dim=0), (H,)定义了所有需要的函数之后,接下来我们[创建一个类来包装这些函数],
并存储从零开始实现的循环神经网络模型的参数。
class RNNModelScratch: #@save
    """从零开始实现的循环神经网络模型"""
    def __init__(self, vocab_size, num_hiddens, device,
                 get_params, init_state, forward_fn):
        self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
        self.params = get_params(vocab_size, num_hiddens, device)
        self.init_state, self.forward_fn = init_state, forward_fn

    def __call__(self, X, state):
        X = F.one_hot(X.T, self.vocab_size).type(torch.float32)
        return self.forward_fn(X, state, self.params)

    def begin_state(self, batch_size, device):
return self.init_state(batch_size, self.num_hiddens, device)让我们[检查输出是否具有正确的形状]。
例如,隐状态的维数是否保持不变。
num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
                      init_rnn_state, rnn)
state = net.begin_state(X.shape[0], d2l.try_gpu())
Y, new_state = net(X.to(d2l.try_gpu()), state)
Y.shape, len(new_state), new_state[0].shape我们可以看到输出形状是(时间步数批量大小,词表大小),
而隐状态形状保持不变,即(批量大小,隐藏单元数)。
预测
让我们[首先定义预测函数来生成prefix之后的新字符],
其中的prefix是一个用户提供的包含多个字符的字符串。
在循环遍历prefix中的开始字符时,
我们不断地将隐状态传递到下一个时间步,但是不生成任何输出。
这被称为预热(warm-up)期,
因为在此期间模型会自我更新(例如,更新隐状态),
但不会进行预测。
预热期结束后,隐状态的值通常比刚开始的初始值更适合预测,
从而预测字符并输出它们。
def predict_ch8(prefix, num_preds, net, vocab, device):  #@save
    """在prefix后面生成新字符"""
    state = net.begin_state(batch_size=1, device=device)
    outputs = [vocab[prefix[0]]]
    get_input = lambda: d2l.reshape(d2l.tensor(
        [outputs[-1]], device=device), (1, 1))
    for y in prefix[1:]:  # 预热期
        _, state = net(get_input(), state)
        outputs.append(vocab[y])
    for _ in range(num_preds):  # 预测num_preds步
        y, state = net(get_input(), state)
        outputs.append(int(y.argmax(dim=1).reshape(1)))
return ''.join([vocab.idx_to_token[i] for i in outputs])现在我们可以测试predict_ch8函数。
我们将前缀指定为time traveller,
并基于这个前缀生成10个后续字符。
鉴于我们还没有训练网络,它会生成荒谬的预测结果。
[梯度裁剪]
对于长度为的序列,我们在迭代中计算这个时间步上的梯度,
将会在反向传播过程中产生长度为的矩阵乘法链。
如 :numref:sec_numerical_stability所述,
当较大时,它可能导致数值不稳定,
例如可能导致梯度爆炸或梯度消失。
因此,循环神经网络模型往往需要额外的方式来支持稳定训练。
一般来说,当解决优化问题时,我们对模型参数采用更新步骤。
假定在向量形式的中,
或者在小批量数据的负梯度方向上。
例如,使用作为学习率时,在一次迭代中,
我们将更新为。
如果我们进一步假设目标函数表现良好,
即函数在常数下是利普希茨连续的(Lipschitz continuous)。
也就是说,对于任意和我们有:
在这种情况下,我们可以安全地假设:
如果我们通过更新参数向量,则
这意味着我们不会观察到超过的变化。
这既是坏事也是好事。
坏的方面,它限制了取得进展的速度;
好的方面,它限制了事情变糟的程度,尤其当我们朝着错误的方向前进时。
有时梯度可能很大,从而优化算法可能无法收敛。
我们可以通过降低的学习率来解决这个问题。
但是如果我们很少得到大的梯度呢?
在这种情况下,这种做法似乎毫无道理。
一个流行的替代方案是通过将梯度投影回给定半径
(例如)的球来裁剪梯度。
如下式:
()
通过这样做,我们知道梯度范数永远不会超过,
并且更新后的梯度完全与的原始方向对齐。
它还有一个值得拥有的副作用,
即限制任何给定的小批量数据(以及其中任何给定的样本)对参数向量的影响,
这赋予了模型一定程度的稳定性。
梯度裁剪提供了一个快速修复梯度爆炸的方法,
虽然它并不能完全解决问题,但它是众多有效的技术之一。
下面我们定义一个函数来裁剪模型的梯度,
模型是从零开始实现的模型或由高级API构建的模型。
我们在此计算了所有模型参数的梯度的范数。
def grad_clipping(net, theta):  #@save
    """裁剪梯度"""
    if isinstance(net, nn.Module):
        params = [p for p in net.parameters() if p.requires_grad]
    else:
        params = net.params
    norm = torch.sqrt(sum(torch.sum((p.grad ** 2)) for p in params))
    if norm > theta:
        for param in params:
            param.grad[:] *= theta / norm
训练
在训练模型之前,让我们[定义一个函数在一个迭代周期内训练模型]。
它与我们训练 :numref:sec_softmax_scratch模型的方式有三个不同之处。
- 序列数据的不同采样方法(随机采样和顺序分区)将导致隐状态初始化的差异。
- 我们在更新模型参数之前裁剪梯度。
这样的操作的目的是,即使训练过程中某个点上发生了梯度爆炸,也能保证模型不会发散。 - 我们用困惑度来评价模型。如 :numref:
subsec_perplexity所述,
这样的度量确保了不同长度的序列具有可比性。
具体来说,当使用顺序分区时,
我们只在每个迭代周期的开始位置初始化隐状态。
由于下一个小批量数据中的第个子序列样本
与当前第个子序列样本相邻,
因此当前小批量数据最后一个样本的隐状态,
将用于初始化下一个小批量数据第一个样本的隐状态。
这样,存储在隐状态中的序列的历史信息
可以在一个迭代周期内流经相邻的子序列。
然而,在任何一点隐状态的计算,
都依赖于同一迭代周期中前面所有的小批量数据,
这使得梯度计算变得复杂。
为了降低计算量,在处理任何一个小批量数据之前,
我们先分离梯度,使得隐状态的梯度计算总是限制在一个小批量数据的时间步内。
当使用随机抽样时,因为每个样本都是在一个随机位置抽样的,
因此需要为每个迭代周期重新初始化隐状态。
与 :numref:sec_softmax_scratch中的
train_epoch_ch3函数相同,
updater是更新模型参数的常用函数。
它既可以是从头开始实现的d2l.sgd函数,
也可以是深度学习框架中内置的优化函数。
#@save
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):
    """训练网络一个迭代周期(定义见第8章)"""
    state, timer = None, d2l.Timer()
    metric = d2l.Accumulator(2)  # 训练损失之和,词元数量
    for X, Y in train_iter:
        if state is None or use_random_iter:
            # 在第一次迭代或使用随机抽样时初始化state
            state = net.begin_state(batch_size=X.shape[0], device=device)
        else:
            if isinstance(net, nn.Module) and not isinstance(state, tuple):
                # state对于nn.GRU是个张量
                state.detach_()
            else:
                # state对于nn.LSTM或对于我们从零开始实现的模型是个张量
                for s in state:
                    s.detach_()
        y = Y.T.reshape(-1)
        X, y = X.to(device), y.to(device)
        y_hat, state = net(X, state)
        l = loss(y_hat, y.long()).mean()
        if isinstance(updater, torch.optim.Optimizer):
            updater.zero_grad()
            l.backward()
            grad_clipping(net, 1)
            updater.step()
        else:
            l.backward()
            grad_clipping(net, 1)
            # 因为已经调用了mean函数
            updater(batch_size=1)
        metric.add(l * d2l.size(y), d2l.size(y))
return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()[循环神经网络模型的训练函数既支持从零开始实现, 也可以使用高级API来实现。]
#@save
def train_ch8(net, train_iter, vocab, lr, num_epochs, device,
              use_random_iter=False):
    """训练模型(定义见第8章)"""
    loss = nn.CrossEntropyLoss()
    animator = d2l.Animator(xlabel='epoch', ylabel='perplexity',
                            legend=['train'], xlim=[10, num_epochs])
    # 初始化
    if isinstance(net, nn.Module):
        updater = torch.optim.SGD(net.parameters(), lr)
    else:
        updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)
    predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
    # 训练和预测
    for epoch in range(num_epochs):
        ppl, speed = train_epoch_ch8(
            net, train_iter, loss, updater, device, use_random_iter)
        if (epoch + 1) % 10 == 0:
            print(predict('time traveller'))
            animator.add(epoch + 1, [ppl])
    print(f'困惑度 {ppl:.1f}, {speed:.1f} 词元/秒 {str(device)}')
    print(predict('time traveller'))
print(predict('traveller'))[现在,我们训练循环神经网络模型。]
因为我们在数据集中只使用了10000个词元,
所以模型需要更多的迭代周期来更好地收敛。
[最后,让我们检查一下使用随机抽样方法的结果。]
从零开始实现上述循环神经网络模型,
虽然有指导意义,但是并不方便。
在下一节中,我们将学习如何改进循环神经网络模型。
例如,如何使其实现地更容易,且运行速度更快。
小结
- 我们可以训练一个基于循环神经网络的字符级语言模型,根据用户提供的文本的前缀生成后续文本。
- 一个简单的循环神经网络语言模型包括输入编码、循环神经网络模型和输出生成。
- 循环神经网络模型在训练以前需要初始化状态,不过随机抽样和顺序划分使用初始化方法不同。
- 当使用顺序划分时,我们需要分离梯度以减少计算量。
- 在进行任何预测之前,模型通过预热期进行自我更新(例如,获得比初始值更好的隐状态)。
- 梯度裁剪可以防止梯度爆炸,但不能应对梯度消失。
练习
- 尝试说明独热编码等价于为每个对象选择不同的嵌入表示。
- 通过调整超参数(如迭代周期数、隐藏单元数、小批量数据的时间步数、学习率等)来改善困惑度。
- 困惑度可以降到多少?
- 用可学习的嵌入表示替换独热编码,是否会带来更好的表现?
- 如果用H.G.Wells的其他书作为数据集时效果如何,
例如世界大战?
- 修改预测函数,例如使用采样,而不是选择最有可能的下一个字符。
- 会发生什么?
- 调整模型使之偏向更可能的输出,例如,当,从中采样。
- 在不裁剪梯度的情况下运行本节中的代码会发生什么?
- 更改顺序划分,使其不会从计算图中分离隐状态。运行时间会有变化吗?困惑度呢?
- 用ReLU替换本节中使用的激活函数,并重复本节中的实验。我们还需要梯度裁剪吗?为什么?
循环神经网络的简洁实现
虽然 :numref:sec_rnn_scratch
对了解循环神经网络的实现方式具有指导意义,但并不方便。
本节将展示如何使用深度学习框架的高级API提供的函数更有效地实现相同的语言模型。
我们仍然从读取时光机器数据集开始。
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F

batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)[定义模型]
高级API提供了循环神经网络的实现。
我们构造一个具有256个隐藏单元的单隐藏层的循环神经网络层rnn_layer。
事实上,我们还没有讨论多层循环神经网络的意义(这将在 :numref:sec_deep_rnn中介绍)。
现在仅需要将多层理解为一层循环神经网络的输出被用作下一层循环神经网络的输入就足够了。
num_hiddens = 256
rnn_layer = nn.RNN(len(vocab), num_hiddens)我们(使用张量来初始化隐状态),它的形状是(隐藏层数,批量大小,隐藏单元数)。
state = torch.zeros((1, batch_size, num_hiddens))
state.shape[通过一个隐状态和一个输入,我们就可以用更新后的隐状态计算输出。]
需要强调的是,rnn_layer的“输出”(Y)不涉及输出层的计算:
它是指每个时间步的隐状态,这些隐状态可以用作后续输出层的输入。
X = torch.rand(size=(num_steps, batch_size, len(vocab)))
Y, state_new = rnn_layer(X, state)
Y.shape, state_new.shape
与 :numref:sec_rnn_scratch类似,
[我们为一个完整的循环神经网络模型定义了一个RNNModel类]。
注意,rnn_layer只包含隐藏的循环层,我们还需要创建一个单独的输出层。
#@save
class RNNModel(nn.Module):
    """循环神经网络模型"""
    def __init__(self, rnn_layer, vocab_size, **kwargs):
        super(RNNModel, self).__init__(**kwargs)
        self.rnn = rnn_layer
        self.vocab_size = vocab_size
        self.num_hiddens = self.rnn.hidden_size
        # 如果RNN是双向的(之后将介绍),num_directions应该是2,否则应该是1
        if not self.rnn.bidirectional:
            self.num_directions = 1
            self.linear = nn.Linear(self.num_hiddens, self.vocab_size)
        else:
            self.num_directions = 2
            self.linear = nn.Linear(self.num_hiddens * 2, self.vocab_size)

    def forward(self, inputs, state):
        X = F.one_hot(inputs.T.long(), self.vocab_size)
        X = X.to(torch.float32)
        Y, state = self.rnn(X, state)
        # 全连接层首先将Y的形状改为(时间步数*批量大小,隐藏单元数)
        # 它的输出形状是(时间步数*批量大小,词表大小)。
        output = self.linear(Y.reshape((-1, Y.shape[-1])))
        return output, state

    def begin_state(self, device, batch_size=1):
        if not isinstance(self.rnn, nn.LSTM):
            # nn.GRU以张量作为隐状态
            return  torch.zeros((self.num_directions * self.rnn.num_layers,
                                 batch_size, self.num_hiddens),
                                device=device)
        else:
            # nn.LSTM以元组作为隐状态
            return (torch.zeros((
                self.num_directions * self.rnn.num_layers,
                batch_size, self.num_hiddens), device=device),
                    torch.zeros((
                        self.num_directions * self.rnn.num_layers,
                        batch_size, self.num_hiddens), device=device))
训练与预测
在训练模型之前,让我们[基于一个具有随机权重的模型进行预测]。
device = d2l.try_gpu()
net = RNNModel(rnn_layer, vocab_size=len(vocab))
net = net.to(device)
d2l.predict_ch8('time traveller', 10, net, vocab, device)
很明显,这种模型根本不能输出好的结果。
接下来,我们使用 :numref:sec_rnn_scratch中
定义的超参数调用train_ch8,并且[使用高级API训练模型]。
num_epochs, lr = 500, 1
d2l.train_ch8(net, train_iter, vocab, lr, num_epochs, device)
与上一节相比,由于深度学习框架的高级API对代码进行了更多的优化,
该模型在较短的时间内达到了较低的困惑度。
小结
- 深度学习框架的高级API提供了循环神经网络层的实现。
- 高级API的循环神经网络层返回一个输出和一个更新后的隐状态,我们还需要计算整个模型的输出层。
- 相比从零开始实现的循环神经网络,使用高级API实现可以加速训练。
练习
- 尝试使用高级API,能使循环神经网络模型过拟合吗?
- 如果在循环神经网络模型中增加隐藏层的数量会发生什么?能使模型正常工作吗?
- 尝试使用循环神经网络实现 :numref:
sec_sequence的自回归模型。
通过时间反向传播
到目前为止,我们已经反复提到像梯度爆炸或梯度消失,
以及需要对循环神经网络分离梯度。
例如,在 :numref:sec_rnn_scratch中,
我们在序列上调用了detach函数。
为了能够快速构建模型并了解其工作原理,
上面所说的这些概念都没有得到充分的解释。
本节将更深入地探讨序列模型反向传播的细节,
以及相关的数学原理。
当我们首次实现循环神经网络( :numref:sec_rnn_scratch)时,
遇到了梯度爆炸的问题。
如果做了练习题,就会发现梯度截断对于确保模型收敛至关重要。
为了更好地理解此问题,本节将回顾序列模型梯度的计算方式,
它的工作原理没有什么新概念,毕竟我们使用的仍然是链式法则来计算梯度。
我们在 :numref:sec_backprop中描述了多层感知机中的
前向与反向传播及相关的计算图。
循环神经网络中的前向传播相对简单。
通过时间反向传播(backpropagation through time,BPTT)
(Werbos.1990)实际上是循环神经网络中反向传播技术的一个特定应用。
它要求我们将循环神经网络的计算图一次展开一个时间步,
以获得模型变量和参数之间的依赖关系。
然后,基于链式法则,应用反向传播来计算和存储梯度。
由于序列可能相当长,因此依赖关系也可能相当长。
例如,某个1000个字符的序列,
其第一个词元可能会对最后位置的词元产生重大影响。
这在计算上是不可行的(它需要的时间和内存都太多了),
并且还需要超过1000个矩阵的乘积才能得到非常难以捉摸的梯度。
这个过程充满了计算与统计的不确定性。
在下文中,我们将阐明会发生什么以及如何在实践中解决它们。
循环神经网络的梯度分析
我们从一个描述循环神经网络工作原理的简化模型开始,
此模型忽略了隐状态的特性及其更新方式的细节。
这里的数学表示没有像过去那样明确地区分标量、向量和矩阵,
因为这些细节对于分析并不重要,
反而只会使本小节中的符号变得混乱。
在这个简化模型中,我们将时间步的隐状态表示为,
输入表示为,输出表示为。
回想一下我们在 :numref:subsec_rnn_w_hidden_states中的讨论,
输入和隐状态可以拼接后与隐藏层中的一个权重变量相乘。
因此,我们分别使用和来表示隐藏层和输出层的权重。
每个时间步的隐状态和输出可以写为:
其中和分别是隐藏层和输出层的变换。
因此,我们有一个链
,
它们通过循环计算彼此依赖。
前向传播相当简单,一次一个时间步的遍历三元组,
然后通过一个目标函数在所有个时间步内
评估输出和对应的标签之间的差异:
对于反向传播,问题则有点棘手,
特别是当我们计算目标函数关于参数的梯度时。
具体来说,按照链式法则:
在 :eqref:eq_bptt_partial_L_wh中乘积的第一项和第二项很容易计算,
而第三项是使事情变得棘手的地方,
因为我们需要循环地计算参数对的影响。
根据 :eqref:eq_bptt_ht_ot中的递归计算,
既依赖于又依赖于,
其中的计算也依赖于。
因此,使用链式法则产生:
为了导出上述梯度,假设我们有三个序列,
当时,序列满足且。
对于,就很容易得出:
基于下列公式替换、和:
公式 :eqref:eq_bptt_partial_ht_wh_recur中的梯度计算
满足。
因此,对于每个 :eqref:eq_bptt_at,
我们可以使用下面的公式移除 :eqref:eq_bptt_partial_ht_wh_recur中的循环计算
虽然我们可以使用链式法则递归地计算,
但当很大时这个链就会变得很长。
我们需要想想办法来处理这一问题.
完全计算
显然,我们可以仅仅计算 :eqref:eq_bptt_partial_ht_wh_gen中的全部总和,
然而,这样的计算非常缓慢,并且可能会发生梯度爆炸,
因为初始条件的微小变化就可能会对结果产生巨大的影响。
也就是说,我们可以观察到类似于蝴蝶效应的现象,
即初始条件的很小变化就会导致结果发生不成比例的变化。
这对于我们想要估计的模型而言是非常不可取的。
毕竟,我们正在寻找的是能够很好地泛化高稳定性模型的估计器。
因此,在实践中,这种方法几乎从未使用过。
截断时间步
或者,我们可以在步后截断
:eqref:eq_bptt_partial_ht_wh_gen中的求和计算。
这是我们到目前为止一直在讨论的内容,
例如在 :numref:sec_rnn_scratch中分离梯度时。
这会带来真实梯度的近似,
只需将求和终止为。
在实践中,这种方式工作得很好。
它通常被称为截断的通过时间反向传播 (Jaeger.2002)。
这样做导致该模型主要侧重于短期影响,而不是长期影响。
这在现实中是可取的,因为它会将估计值偏向更简单和更稳定的模型。
随机截断
最后,我们可以用一个随机变量替换,
该随机变量在预期中是正确的,但是会截断序列。
这个随机变量是通过使用序列来实现的,
序列预定义了,
其中且,
因此。
我们使用它来替换 :eqref:eq_bptt_partial_ht_wh_recur中的
梯度得到:
从的定义中推导出来。
每当时,递归计算终止在这个时间步。
这导致了不同长度序列的加权和,其中长序列出现的很少,
所以将适当地加大权重。
这个想法是由塔莱克和奥利维尔 (Tallec.Ollivier.2017)提出的。
比较策略
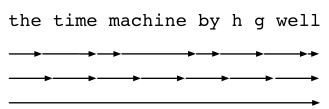
:numref:fig_truncated_bptt说明了
当基于循环神经网络使用通过时间反向传播
分析《时间机器》书中前几个字符的三种策略:
- 第一行采用随机截断,方法是将文本划分为不同长度的片断;
- 第二行采用常规截断,方法是将文本分解为相同长度的子序列。
这也是我们在循环神经网络实验中一直在做的; - 第三行采用通过时间的完全反向传播,结果是产生了在计算上不可行的表达式。
遗憾的是,虽然随机截断在理论上具有吸引力,
但很可能是由于多种因素在实践中并不比常规截断更好。
首先,在对过去若干个时间步经过反向传播后,
观测结果足以捕获实际的依赖关系。
其次,增加的方差抵消了时间步数越多梯度越精确的事实。
第三,我们真正想要的是只有短范围交互的模型。
因此,模型需要的正是截断的通过时间反向传播方法所具备的轻度正则化效果。
通过时间反向传播的细节
在讨论一般性原则之后,我们看一下通过时间反向传播问题的细节。
与 :numref:subsec_bptt_analysis中的分析不同,
下面我们将展示如何计算目标函数相对于所有分解模型参数的梯度。
为了保持简单,我们考虑一个没有偏置参数的循环神经网络,
其在隐藏层中的激活函数使用恒等映射()。
对于时间步,设单个样本的输入及其对应的标签分别为
和。
计算隐状态和
输出的方式为:
其中权重参数为、
和
。
用表示时间步处
(即从序列开始起的超过个时间步)的损失函数,
则我们的目标函数的总体损失是:
为了在循环神经网络的计算过程中可视化模型变量和参数之间的依赖关系,
我们可以为模型绘制一个计算图,
如 :numref:fig_rnn_bptt所示。
例如,时间步3的隐状态的计算
取决于模型参数和,
以及最终时间步的隐状态
以及当前时间步的输入。
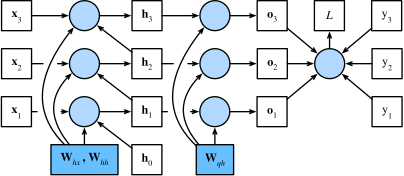
正如刚才所说, :numref:fig_rnn_bptt中的模型参数是
、和。
通常,训练该模型需要对这些参数进行梯度计算:
、
和
。
根据 :numref:fig_rnn_bptt中的依赖关系,
我们可以沿箭头的相反方向遍历计算图,依次计算和存储梯度。
为了灵活地表示链式法则中不同形状的矩阵、向量和标量的乘法,
我们继续使用如 :numref:sec_backprop中
所述的运算符。
首先,在任意时间步,
目标函数关于模型输出的微分计算是相当简单的:
现在,我们可以计算目标函数关于输出层中参数的梯度:
。
基于 :numref:fig_rnn_bptt,
目标函数通过
依赖于。
依据链式法则,得到
其中是
由 :eqref:eq_bptt_partial_L_ot给出的。
接下来,如 :numref:fig_rnn_bptt所示,
在最后的时间步,目标函数仅通过
依赖于隐状态。
因此,我们通过使用链式法可以很容易地得到梯度
:
当目标函数通过和
依赖时,
对任意时间步来说都变得更加棘手。
根据链式法则,隐状态的梯度
在任何时间步骤时都可以递归地计算为:
为了进行分析,对于任何时间步展开递归计算得
我们可以从 :eqref:eq_bptt_partial_L_ht中看到,
这个简单的线性例子已经展现了长序列模型的一些关键问题:
它陷入到的潜在的非常大的幂。
在这个幂中,小于1的特征值将会消失,大于1的特征值将会发散。
这在数值上是不稳定的,表现形式为梯度消失或梯度爆炸。
解决此问题的一种方法是按照计算方便的需要截断时间步长的尺寸
如 :numref:subsec_bptt_analysis中所述。
实际上,这种截断是通过在给定数量的时间步之后分离梯度来实现的。
稍后,我们将学习更复杂的序列模型(如长短期记忆模型)
是如何进一步缓解这一问题的。
最后, :numref:fig_rnn_bptt表明:
目标函数通过隐状态
依赖于隐藏层中的模型参数和。
为了计算有关这些参数的梯度
和,
我们应用链式规则得:
其中
是由 :eqref:eq_bptt_partial_L_hT_final_step和
:eqref:eq_bptt_partial_L_ht_recur递归计算得到的,
是影响数值稳定性的关键量。
正如我们在 :numref:sec_backprop中所解释的那样,
由于通过时间反向传播是反向传播在循环神经网络中的应用方式,
所以训练循环神经网络交替使用前向传播和通过时间反向传播。
通过时间反向传播依次计算并存储上述梯度。
具体而言,存储的中间值会被重复使用,以避免重复计算,
例如存储,
以便在计算和
时使用。
小结
- “通过时间反向传播”仅仅适用于反向传播在具有隐状态的序列模型。
- 截断是计算方便性和数值稳定性的需要。截断包括:规则截断和随机截断。
- 矩阵的高次幂可能导致神经网络特征值的发散或消失,将以梯度爆炸或梯度消失的形式表现。
- 为了计算的效率,“通过时间反向传播”在计算期间会缓存中间值。
练习
- 假设我们拥有一个对称矩阵,其特征值为,对应的特征向量是()。通常情况下,假设特征值的序列顺序为。
- 证明拥有特征值。
- 证明对于一个随机向量,将有较高概率与的特征向量在一条直线上。形式化这个证明过程。
- 上述结果对于循环神经网络中的梯度意味着什么?
- 除了梯度截断,还有其他方法来应对循环神经网络中的梯度爆炸吗?