5 / 19
预备知识
要学习深度学习,首先需要先掌握一些基本技能。
所有机器学习方法都涉及从数据中提取信息。
因此,我们先学习一些关于数据的实用技能,包括存储、操作和预处理数据。
机器学习通常需要处理大型数据集。
我们可以将某些数据集视为一个表,其中表的行对应样本,列对应属性。
线性代数为人们提供了一些用来处理表格数据的方法。
我们不会太深究细节,而是将重点放在矩阵运算的基本原理及其实现上。
深度学习是关于优化的学习。
对于一个带有参数的模型,我们想要找到其中能拟合数据的最好模型。
在算法的每个步骤中,决定以何种方式调整参数需要一点微积分知识。
本章将简要介绍这些知识。
幸运的是,autograd包会自动计算微分,本章也将介绍它。
机器学习还涉及如何做出预测:给定观察到的信息,某些未知属性可能的值是多少?
要在不确定的情况下进行严格的推断,我们需要借用概率语言。
最后,官方文档提供了本书之外的大量描述和示例。
在本章的结尾,我们将展示如何在官方文档中查找所需信息。
本书对读者数学基础无过分要求,只要可以正确理解深度学习所需的数学知识即可。
但这并不意味着本书中不涉及数学方面的内容,本章会快速介绍一些基本且常用的数学知识,
以便读者能够理解书中的大部分数学内容。
如果读者想要深入理解全部数学内容,可以进一步学习本书数学附录中给出的数学基础知识。
:maxdepth: 2

ndarray
pandas
linear-algebra
calculus
autograd
probability
lookup-api
数据操作
为了能够完成各种数据操作,我们需要某种方法来存储和操作数据。
通常,我们需要做两件重要的事:(1)获取数据;(2)将数据读入计算机后对其进行处理。
如果没有某种方法来存储数据,那么获取数据是没有意义的。
首先,我们介绍维数组,也称为张量(tensor)。
使用过Python中NumPy计算包的读者会对本部分很熟悉。
无论使用哪个深度学习框架,它的张量类(在MXNet中为ndarray,
在PyTorch和TensorFlow中为Tensor)都与Numpy的ndarray类似。
但深度学习框架又比Numpy的ndarray多一些重要功能:
首先,GPU很好地支持加速计算,而NumPy仅支持CPU计算;
其次,张量类支持自动微分。
这些功能使得张量类更适合深度学习。
如果没有特殊说明,本书中所说的张量均指的是张量类的实例。
入门
本节的目标是帮助读者了解并运行一些在阅读本书的过程中会用到的基本数值计算工具。
如果你很难理解一些数学概念或库函数,请不要担心。
后面的章节将通过一些实际的例子来回顾这些内容。
如果你已经具有相关经验,想要深入学习数学内容,可以跳过本节。
(首先,我们导入torch。请注意,虽然它被称为PyTorch,但是代码中使用torch而不是pytorch。)
import torch[张量表示一个由数值组成的数组,这个数组可能有多个维度]。
具有一个轴的张量对应数学上的向量(vector);
具有两个轴的张量对应数学上的矩阵(matrix);
具有两个轴以上的张量没有特殊的数学名称。
首先,我们可以使用 arange 创建一个行向量 x。这个行向量包含以0开始的前12个整数,它们默认创建为整数。也可指定创建类型为浮点数。张量中的每个值都称为张量的 元素(element)。例如,张量 x 中有 12 个元素。除非额外指定,新的张量将存储在内存中,并采用基于CPU的计算。
x = torch.arange(12)
x[可以通过张量的shape属性来访问张量(沿每个轴的长度)的形状]
(和张量中元素的总数)。
如果只想知道张量中元素的总数,即形状的所有元素乘积,可以检查它的大小(size)。
因为这里在处理的是一个向量,所以它的shape与它的size相同。
x.numel()[要想改变一个张量的形状而不改变元素数量和元素值,可以调用reshape函数。]
例如,可以把张量x从形状为(12,)的行向量转换为形状为(3,4)的矩阵。
这个新的张量包含与转换前相同的值,但是它被看成一个3行4列的矩阵。
要重点说明一下,虽然张量的形状发生了改变,但其元素值并没有变。
注意,通过改变张量的形状,张量的大小不会改变。
我们不需要通过手动指定每个维度来改变形状。
也就是说,如果我们的目标形状是(高度,宽度),
那么在知道宽度后,高度会被自动计算得出,不必我们自己做除法。
在上面的例子中,为了获得一个3行的矩阵,我们手动指定了它有3行和4列。
幸运的是,我们可以通过-1来调用此自动计算出维度的功能。
即我们可以用x.reshape(-1,4)或x.reshape(3,-1)来取代x.reshape(3,4)。
有时,我们希望[使用全0、全1、其他常量,或者从特定分布中随机采样的数字]来初始化矩阵。
我们可以创建一个形状为(2,3,4)的张量,其中所有元素都设置为0。代码如下:
torch.zeros((2, 3, 4))同样,我们可以创建一个形状为(2,3,4)的张量,其中所有元素都设置为1。代码如下:
torch.ones((2, 3, 4))有时我们想通过从某个特定的概率分布中随机采样来得到张量中每个元素的值。
例如,当我们构造数组来作为神经网络中的参数时,我们通常会随机初始化参数的值。
以下代码创建一个形状为(3,4)的张量。
其中的每个元素都从均值为0、标准差为1的标准高斯分布(正态分布)中随机采样。
torch.randn(3, 4)我们还可以[通过提供包含数值的Python列表(或嵌套列表),来为所需张量中的每个元素赋予确定值]。
在这里,最外层的列表对应于轴0,内层的列表对应于轴1。
torch.tensor([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])运算符
我们的兴趣不仅限于读取数据和写入数据。
我们想在这些数据上执行数学运算,其中最简单且最有用的操作是按元素(elementwise)运算。
它们将标准标量运算符应用于数组的每个元素。
对于将两个数组作为输入的函数,按元素运算将二元运算符应用于两个数组中的每对位置对应的元素。
我们可以基于任何从标量到标量的函数来创建按元素函数。
在数学表示法中,我们将通过符号
来表示一元标量运算符(只接收一个输入)。
这意味着该函数从任何实数()映射到另一个实数。
同样,我们通过符号
表示二元标量运算符,这意味着该函数接收两个输入,并产生一个输出。
给定同一形状的任意两个向量和和二元运算符,
我们可以得到向量。
具体计算方法是,
其中、和分别是向量、和中的元素。
在这里,我们通过将标量函数升级为按元素向量运算来生成向量值
。
对于任意具有相同形状的张量,
[常见的标准算术运算符(+、-、*、/和**)都可以被升级为按元素运算]。
我们可以在同一形状的任意两个张量上调用按元素操作。
在下面的例子中,我们使用逗号来表示一个具有5个元素的元组,其中每个元素都是按元素操作的结果。
x = torch.tensor([1.0, 2, 4, 8])
y = torch.tensor([2, 2, 2, 2])
x + y, x - y, x * y, x / y, x ** y # **运算符是求幂运算(“按元素”方式可以应用更多的计算),包括像求幂这样的一元运算符。
torch.exp(x)除了按元素计算外,我们还可以执行线性代数运算,包括向量点积和矩阵乘法。
我们将在 :numref:sec_linear-algebra中解释线性代数的重点内容。
[我们也可以把多个张量连结(concatenate)在一起],
把它们端对端地叠起来形成一个更大的张量。
我们只需要提供张量列表,并给出沿哪个轴连结。
下面的例子分别演示了当我们沿行(轴-0,形状的第一个元素)
和按列(轴-1,形状的第二个元素)连结两个矩阵时,会发生什么情况。
我们可以看到,第一个输出张量的轴-0长度()是两个输入张量轴-0长度的总和();
第二个输出张量的轴-1长度()是两个输入张量轴-1长度的总和()。
X = torch.arange(12, dtype=torch.float32).reshape((3,4))
Y = torch.tensor([[2.0, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
torch.cat((X, Y), dim=0), torch.cat((X, Y), dim=1)有时,我们想[通过逻辑运算符构建二元张量]。
以X == Y为例:
对于每个位置,如果X和Y在该位置相等,则新张量中相应项的值为1。
这意味着逻辑语句X == Y在该位置处为真,否则该位置为0。
[对张量中的所有元素进行求和,会产生一个单元素张量。]
广播机制
在上面的部分中,我们看到了如何在相同形状的两个张量上执行按元素操作。
在某些情况下,[即使形状不同,我们仍然可以通过调用
广播机制(broadcasting mechanism)来执行按元素操作]。
这种机制的工作方式如下:
- 通过适当复制元素来扩展一个或两个数组,以便在转换之后,两个张量具有相同的形状;
- 对生成的数组执行按元素操作。
在大多数情况下,我们将沿着数组中长度为1的轴进行广播,如下例子:
a = torch.arange(3).reshape((3, 1))
b = torch.arange(2).reshape((1, 2))
a, b由于a和b分别是和矩阵,如果让它们相加,它们的形状不匹配。
我们将两个矩阵广播为一个更大的矩阵,如下所示:矩阵a将复制列,
矩阵b将复制行,然后再按元素相加。
索引和切片
就像在任何其他Python数组中一样,张量中的元素可以通过索引访问。
与任何Python数组一样:第一个元素的索引是0,最后一个元素索引是-1;
可以指定范围以包含第一个元素和最后一个之前的元素。
如下所示,我们[可以用[-1]选择最后一个元素,可以用[1:3]选择第二个和第三个元素]:
[除读取外,我们还可以通过指定索引来将元素写入矩阵。]
如果我们想[为多个元素赋值相同的值,我们只需要索引所有元素,然后为它们赋值。]
例如,[0:2, :]访问第1行和第2行,其中“:”代表沿轴1(列)的所有元素。
虽然我们讨论的是矩阵的索引,但这也适用于向量和超过2个维度的张量。
节省内存
[运行一些操作可能会导致为新结果分配内存]。
例如,如果我们用Y = X + Y,我们将取消引用Y指向的张量,而是指向新分配的内存处的张量。
在下面的例子中,我们用Python的id()函数演示了这一点,
它给我们提供了内存中引用对象的确切地址。
运行Y = Y + X后,我们会发现id(Y)指向另一个位置。
这是因为Python首先计算Y + X,为结果分配新的内存,然后使Y指向内存中的这个新位置。
这可能是不可取的,原因有两个:
- 首先,我们不想总是不必要地分配内存。在机器学习中,我们可能有数百兆的参数,并且在一秒内多次更新所有参数。通常情况下,我们希望原地执行这些更新;
- 如果我们不原地更新,其他引用仍然会指向旧的内存位置,这样我们的某些代码可能会无意中引用旧的参数。
幸运的是,(执行原地操作)非常简单。
我们可以使用切片表示法将操作的结果分配给先前分配的数组,例如Y[:] = <expression>。
为了说明这一点,我们首先创建一个新的矩阵Z,其形状与另一个Y相同,
使用zeros_like来分配一个全的块。
Z = torch.zeros_like(Y)
print('id(Z):', id(Z))
Z[:] = X + Y
print('id(Z):', id(Z))[如果在后续计算中没有重复使用X,
我们也可以使用X[:] = X + Y或X += Y来减少操作的内存开销。]
转换为其他Python对象
将深度学习框架定义的张量[转换为NumPy张量(ndarray)]很容易,反之也同样容易。
torch张量和numpy数组将共享它们的底层内存,就地操作更改一个张量也会同时更改另一个张量。
A = X.numpy()
B = torch.tensor(A)
type(A), type(B)要(将大小为1的张量转换为Python标量),我们可以调用item函数或Python的内置函数。
a = torch.tensor([3.5])
a, a.item(), float(a), int(a)
小结
- 深度学习存储和操作数据的主要接口是张量(维数组)。它提供了各种功能,包括基本数学运算、广播、索引、切片、内存节省和转换其他Python对象。
练习
- 运行本节中的代码。将本节中的条件语句
X == Y更改为X < Y或X > Y,然后看看你可以得到什么样的张量。 - 用其他形状(例如三维张量)替换广播机制中按元素操作的两个张量。结果是否与预期相同?
数据预处理
为了能用深度学习来解决现实世界的问题,我们经常从预处理原始数据开始,
而不是从那些准备好的张量格式数据开始。
在Python中常用的数据分析工具中,我们通常使用pandas软件包。
像庞大的Python生态系统中的许多其他扩展包一样,pandas可以与张量兼容。
本节我们将简要介绍使用pandas预处理原始数据,并将原始数据转换为张量格式的步骤。
后面的章节将介绍更多的数据预处理技术。
读取数据集
举一个例子,我们首先(创建一个人工数据集,并存储在CSV(逗号分隔值)文件)
../data/house_tiny.csv中。
以其他格式存储的数据也可以通过类似的方式进行处理。
下面我们将数据集按行写入CSV文件中。
要[从创建的CSV文件中加载原始数据集],我们导入pandas包并调用read_csv函数。该数据集有四行三列。其中每行描述了房间数量(“NumRooms”)、巷子类型(“Alley”)和房屋价格(“Price”)。
处理缺失值
注意,“NaN”项代表缺失值。
[为了处理缺失的数据,典型的方法包括插值法和删除法,]
其中插值法用一个替代值弥补缺失值,而删除法则直接忽略缺失值。
在(这里,我们将考虑插值法)。
通过位置索引iloc,我们将data分成inputs和outputs,
其中前者为data的前两列,而后者为data的最后一列。
对于inputs中缺少的数值,我们用同一列的均值替换“NaN”项。
[对于inputs中的类别值或离散值,我们将“NaN”视为一个类别。]
由于“巷子类型”(“Alley”)列只接受两种类型的类别值“Pave”和“NaN”,
pandas可以自动将此列转换为两列“Alley_Pave”和“Alley_nan”。
巷子类型为“Pave”的行会将“Alley_Pave”的值设置为1,“Alley_nan”的值设置为0。
缺少巷子类型的行会将“Alley_Pave”和“Alley_nan”分别设置为0和1。
转换为张量格式
[现在inputs和outputs中的所有条目都是数值类型,它们可以转换为张量格式。]
当数据采用张量格式后,可以通过在 :numref:sec_ndarray中引入的那些张量函数来进一步操作。
import torch

X = torch.tensor(inputs.to_numpy(dtype=float))
y = torch.tensor(outputs.to_numpy(dtype=float))
X, y
小结
pandas软件包是Python中常用的数据分析工具中,pandas可以与张量兼容。- 用
pandas处理缺失的数据时,我们可根据情况选择用插值法和删除法。
练习
创建包含更多行和列的原始数据集。
- 删除缺失值最多的列。
- 将预处理后的数据集转换为张量格式。
线性代数
在介绍完如何存储和操作数据后,接下来将简要地回顾一下部分基本线性代数内容。
这些内容有助于读者了解和实现本书中介绍的大多数模型。
本节将介绍线性代数中的基本数学对象、算术和运算,并用数学符号和相应的代码实现来表示它们。
标量
如果你曾经在餐厅支付餐费,那么应该已经知道一些基本的线性代数,比如在数字间相加或相乘。
例如,北京的温度为(华氏度,除摄氏度外的另一种温度计量单位)。
严格来说,仅包含一个数值被称为标量(scalar)。
如果要将此华氏度值转换为更常用的摄氏度,
则可以计算表达式,并将赋为。
在此等式中,每一项(、和)都是标量值。
符号和称为变量(variable),它们表示未知的标量值。
本书采用了数学表示法,其中标量变量由普通小写字母表示(例如,、和)。
本书用表示所有(连续)实数标量的空间,之后将严格定义空间(space)是什么,
但现在只要记住表达式是表示是一个实值标量的正式形式。
符号称为“属于”,它表示“是集合中的成员”。
例如可以用来表明和是值只能为或的数字。
(标量由只有一个元素的张量表示)。
下面的代码将实例化两个标量,并执行一些熟悉的算术运算,即加法、乘法、除法和指数。
import torch

x = torch.tensor(3.0)
y = torch.tensor(2.0)

x + y, x * y, x / y, x**y
向量
[向量可以被视为标量值组成的列表]。
这些标量值被称为向量的元素(element)或分量(component)。
当向量表示数据集中的样本时,它们的值具有一定的现实意义。
例如,如果我们正在训练一个模型来预测贷款违约风险,可能会将每个申请人与一个向量相关联,
其分量与其收入、工作年限、过往违约次数和其他因素相对应。
如果我们正在研究医院患者可能面临的心脏病发作风险,可能会用一个向量来表示每个患者,
其分量为最近的生命体征、胆固醇水平、每天运动时间等。
在数学表示法中,向量通常记为粗体、小写的符号
(例如,、和)。
人们通过一维张量表示向量。一般来说,张量可以具有任意长度,取决于机器的内存限制。
x = torch.arange(4)
x我们可以使用下标来引用向量的任一元素,例如可以通过来引用第个元素。
注意,元素是一个标量,所以我们在引用它时不会加粗。
大量文献认为列向量是向量的默认方向,在本书中也是如此。
在数学中,向量可以写为:
其中是向量的元素。在代码中,我们(通过张量的索引来访问任一元素)。
x[3]长度、维度和形状
向量只是一个数字数组,就像每个数组都有一个长度一样,每个向量也是如此。
在数学表示法中,如果我们想说一个向量由个实值标量组成,
可以将其表示为。
向量的长度通常称为向量的维度(dimension)。
与普通的Python数组一样,我们可以通过调用Python的内置len()函数来[访问张量的长度]。
len(x)当用张量表示一个向量(只有一个轴)时,我们也可以通过.shape属性访问向量的长度。
形状(shape)是一个元素组,列出了张量沿每个轴的长度(维数)。
对于(只有一个轴的张量,形状只有一个元素。)
x.shape请注意,维度(dimension)这个词在不同上下文时往往会有不同的含义,这经常会使人感到困惑。
为了清楚起见,我们在此明确一下:
向量或轴的维度被用来表示向量或轴的长度,即向量或轴的元素数量。
然而,张量的维度用来表示张量具有的轴数。
在这个意义上,张量的某个轴的维数就是这个轴的长度。
矩阵
正如向量将标量从零阶推广到一阶,矩阵将向量从一阶推广到二阶。
矩阵,我们通常用粗体、大写字母来表示
(例如,、和),
在代码中表示为具有两个轴的张量。
数学表示法使用
来表示矩阵,其由行和列的实值标量组成。
我们可以将任意矩阵视为一个表格,
其中每个元素属于第行第列:
对于任意,
的形状是(,)或。
当矩阵具有相同数量的行和列时,其形状将变为正方形;
因此,它被称为方阵(square matrix)。
当调用函数来实例化张量时,
我们可以[通过指定两个分量和来创建一个形状为的矩阵]。
A = torch.arange(20).reshape(5, 4)
A我们可以通过行索引()和列索引()来访问矩阵中的标量元素,
例如。
如果没有给出矩阵的标量元素,如在 :eqref:eq_matrix_def那样,
我们可以简单地使用矩阵的小写字母索引下标
来引用。
为了表示起来简单,只有在必要时才会将逗号插入到单独的索引中,
例如和。
当我们交换矩阵的行和列时,结果称为矩阵的转置(transpose)。
通常用来表示矩阵的转置,如果,
则对于任意和,都有。
因此,在 :eqref:eq_matrix_def中的转置是一个形状为的矩阵:
现在在代码中访问(矩阵的转置)。
A.T作为方阵的一种特殊类型,[对称矩阵(symmetric matrix)等于其转置:]。
这里定义一个对称矩阵:
B = torch.tensor([[1, 2, 3], [2, 0, 4], [3, 4, 5]])
B现在我们将B与它的转置进行比较。
B == B.T矩阵是有用的数据结构:它们允许我们组织具有不同模式的数据。
例如,我们矩阵中的行可能对应于不同的房屋(数据样本),而列可能对应于不同的属性。
曾经使用过电子表格软件或已阅读过 :numref:sec_pandas的人,应该对此很熟悉。
因此,尽管单个向量的默认方向是列向量,但在表示表格数据集的矩阵中,
将每个数据样本作为矩阵中的行向量更为常见。
后面的章节将讲到这点,这种约定将支持常见的深度学习实践。
例如,沿着张量的最外轴,我们可以访问或遍历小批量的数据样本。
张量
[就像向量是标量的推广,矩阵是向量的推广一样,我们可以构建具有更多轴的数据结构]。
张量(本小节中的“张量”指代数对象)是描述具有任意数量轴的维数组的通用方法。
例如,向量是一阶张量,矩阵是二阶张量。
张量用特殊字体的大写字母表示(例如,、和),
它们的索引机制(例如和)与矩阵类似。
当我们开始处理图像时,张量将变得更加重要,图像以维数组形式出现,
其中3个轴对应于高度、宽度,以及一个通道(channel)轴,
用于表示颜色通道(红色、绿色和蓝色)。
现在先将高阶张量暂放一边,而是专注学习其基础知识。
X = torch.arange(24).reshape(2, 3, 4)
X
张量算法的基本性质
标量、向量、矩阵和任意数量轴的张量(本小节中的“张量”指代数对象)有一些实用的属性。
例如,从按元素操作的定义中可以注意到,任何按元素的一元运算都不会改变其操作数的形状。
同样,[给定具有相同形状的任意两个张量,任何按元素二元运算的结果都将是相同形状的张量]。
例如,将两个相同形状的矩阵相加,会在这两个矩阵上执行元素加法。
A = torch.arange(20, dtype=torch.float32).reshape(5, 4)
B = A.clone()  # 通过分配新内存,将A的一个副本分配给B
A, A + B具体而言,[两个矩阵的按元素乘法称为Hadamard积(Hadamard product)(数学符号)]。
对于矩阵,
其中第行和第列的元素是。
矩阵(在 :eqref:eq_matrix_def中定义)和的Hadamard积为:
A * B将张量乘以或加上一个标量不会改变张量的形状,其中张量的每个元素都将与标量相加或相乘。
a = 2
X = torch.arange(24).reshape(2, 3, 4)
a + X, (a * X).shape
降维
我们可以对任意张量进行的一个有用的操作是[计算其元素的和]。
数学表示法使用符号表示求和。
为了表示长度为的向量中元素的总和,可以记为。
在代码中可以调用计算求和的函数:
x = torch.arange(4, dtype=torch.float32)
x, x.sum()我们可以(表示任意形状张量的元素和)。
例如,矩阵中元素的和可以记为。
A.shape, A.sum()默认情况下,调用求和函数会沿所有的轴降低张量的维度,使它变为一个标量。
我们还可以[指定张量沿哪一个轴来通过求和降低维度]。
以矩阵为例,为了通过求和所有行的元素来降维(轴0),可以在调用函数时指定axis=0。
由于输入矩阵沿0轴降维以生成输出向量,因此输入轴0的维数在输出形状中消失。
A_sum_axis0 = A.sum(axis=0)
A_sum_axis0, A_sum_axis0.shape指定axis=1将通过汇总所有列的元素降维(轴1)。因此,输入轴1的维数在输出形状中消失。
A_sum_axis1 = A.sum(axis=1)
A_sum_axis1, A_sum_axis1.shape
沿着行和列对矩阵求和,等价于对矩阵的所有元素进行求和。
A.sum(axis=[0, 1]) # 结果和A.sum()相同[一个与求和相关的量是平均值(mean或average)]。
我们通过将总和除以元素总数来计算平均值。
在代码中,我们可以调用函数来计算任意形状张量的平均值。
A.mean(), A.sum() / A.numel()同样,计算平均值的函数也可以沿指定轴降低张量的维度。
A.mean(axis=0), A.sum(axis=0) / A.shape[0]非降维求和
但是,有时在调用函数来[计算总和或均值时保持轴数不变]会很有用。
sum_A = A.sum(axis=1, keepdims=True)
sum_A例如,由于sum_A在对每行进行求和后仍保持两个轴,我们可以(通过广播将A除以sum_A)。
A / sum_A如果我们想沿[某个轴计算A元素的累积总和],
比如axis=0(按行计算),可以调用cumsum函数。
此函数不会沿任何轴降低输入张量的维度。
A.cumsum(axis=0)点积(Dot Product)
我们已经学习了按元素操作、求和及平均值。
另一个最基本的操作之一是点积。
给定两个向量,
它们的点积(dot product)
(或)
是相同位置的按元素乘积的和:。
[点积是相同位置的按元素乘积的和]
y = torch.ones(4, dtype = torch.float32)
x, y, torch.dot(x, y)注意,(我们可以通过执行按元素乘法,然后进行求和来表示两个向量的点积):
torch.sum(x * y)点积在很多场合都很有用。
例如,给定一组由向量表示的值,
和一组由表示的权重。
中的值根据权重的加权和,
可以表示为点积。
当权重为非负数且和为1(即)时,
点积表示加权平均(weighted average)。
将两个向量规范化得到单位长度后,点积表示它们夹角的余弦。
本节后面的内容将正式介绍长度(length)的概念。
矩阵-向量积
现在我们知道如何计算点积,可以开始理解矩阵-向量积(matrix-vector product)。
回顾分别在 :eqref:eq_matrix_def和 :eqref:eq_vec_def中定义的矩阵和向量。
让我们将矩阵用它的行向量表示:
其中每个都是行向量,表示矩阵的第行。
[矩阵向量积是一个长度为的列向量,
其第个元素是点积]:
我们可以把一个矩阵乘法看作一个从到向量的转换。
这些转换是非常有用的,例如可以用方阵的乘法来表示旋转。
后续章节将讲到,我们也可以使用矩阵-向量积来描述在给定前一层的值时,
求解神经网络每一层所需的复杂计算。
在代码中使用张量表示矩阵-向量积,我们使用mv函数。
当我们为矩阵A和向量x调用torch.mv(A, x)时,会执行矩阵-向量积。
注意,A的列维数(沿轴1的长度)必须与x的维数(其长度)相同。
A.shape, x.shape, torch.mv(A, x)矩阵-矩阵乘法
在掌握点积和矩阵-向量积的知识后,
那么矩阵-矩阵乘法(matrix-matrix multiplication)应该很简单。
假设有两个矩阵和:
用行向量表示矩阵的第行,并让列向量作为矩阵的第列。要生成矩阵积,最简单的方法是考虑的行向量和的列向量:
当我们简单地将每个元素计算为点积:
[我们可以将矩阵-矩阵乘法看作简单地执行次矩阵-向量积,并将结果拼接在一起,形成一个矩阵]。
在下面的代码中,我们在A和B上执行矩阵乘法。
这里的A是一个5行4列的矩阵,B是一个4行3列的矩阵。
两者相乘后,我们得到了一个5行3列的矩阵。
B = torch.ones(4, 3)
torch.mm(A, B)矩阵-矩阵乘法可以简单地称为矩阵乘法,不应与"Hadamard积"混淆。
范数
线性代数中最有用的一些运算符是范数(norm)。
非正式地说,向量的范数是表示一个向量有多大。
这里考虑的大小(size)概念不涉及维度,而是分量的大小。
在线性代数中,向量范数是将向量映射到标量的函数。
给定任意向量,向量范数要满足一些属性。
第一个性质是:如果我们按常数因子缩放向量的所有元素,
其范数也会按相同常数因子的绝对值缩放:
第二个性质是熟悉的三角不等式:
第三个性质简单地说范数必须是非负的:
这是有道理的。因为在大多数情况下,任何东西的最小的大小是0。
最后一个性质要求范数最小为0,当且仅当向量全由0组成。
范数听起来很像距离的度量。
欧几里得距离和毕达哥拉斯定理中的非负性概念和三角不等式可能会给出一些启发。
事实上,欧几里得距离是一个范数:
假设维向量中的元素是,其[范数是向量元素平方和的平方根:]
()
其中,在范数中常常省略下标,也就是说等同于。
在代码中,我们可以按如下方式计算向量的范数。
u = torch.tensor([3.0, -4.0])
torch.norm(u)深度学习中更经常地使用范数的平方,也会经常遇到[范数,它表示为向量元素的绝对值之和:]
()
与范数相比,范数受异常值的影响较小。
为了计算范数,我们将绝对值函数和按元素求和组合起来。
torch.abs(u).sum()范数和范数都是更一般的范数的特例:
类似于向量的范数,[矩阵](的Frobenius范数(Frobenius norm)是矩阵元素平方和的平方根:)
()
Frobenius范数满足向量范数的所有性质,它就像是矩阵形向量的范数。
调用以下函数将计算矩阵的Frobenius范数。
torch.norm(torch.ones((4, 9)))范数和目标
在深度学习中,我们经常试图解决优化问题:
最大化分配给观测数据的概率;
最小化预测和真实观测之间的距离。
用向量表示物品(如单词、产品或新闻文章),以便最小化相似项目之间的距离,最大化不同项目之间的距离。
目标,或许是深度学习算法最重要的组成部分(除了数据),通常被表达为范数。
关于线性代数的更多信息
仅用一节,我们就教会了阅读本书所需的、用以理解现代深度学习的线性代数。
线性代数还有很多,其中很多数学对于机器学习非常有用。
例如,矩阵可以分解为因子,这些分解可以显示真实世界数据集中的低维结构。
机器学习的整个子领域都侧重于使用矩阵分解及其向高阶张量的泛化,来发现数据集中的结构并解决预测问题。
当开始动手尝试并在真实数据集上应用了有效的机器学习模型,你会更倾向于学习更多数学。
因此,这一节到此结束,本书将在后面介绍更多数学知识。
如果渴望了解有关线性代数的更多信息,可以参考线性代数运算的在线附录或其他优秀资源 (Strang.1993;Kolter.2008;Petersen.Pedersen.ea.2008)。
小结
- 标量、向量、矩阵和张量是线性代数中的基本数学对象。
- 向量泛化自标量,矩阵泛化自向量。
- 标量、向量、矩阵和张量分别具有零、一、二和任意数量的轴。
- 一个张量可以通过
sum和mean沿指定的轴降低维度。 - 两个矩阵的按元素乘法被称为他们的Hadamard积。它与矩阵乘法不同。
- 在深度学习中,我们经常使用范数,如范数、范数和Frobenius范数。
- 我们可以对标量、向量、矩阵和张量执行各种操作。
练习
- 证明一个矩阵的转置的转置是,即。
- 给出两个矩阵和,证明“它们转置的和”等于“它们和的转置”,即。
- 给定任意方阵,总是对称的吗?为什么?
- 本节中定义了形状的张量
X。len(X)的输出结果是什么? - 对于任意形状的张量
X,len(X)是否总是对应于X特定轴的长度?这个轴是什么? - 运行
A/A.sum(axis=1),看看会发生什么。请分析一下原因? - 考虑一个具有形状的张量,在轴0、1、2上的求和输出是什么形状?
- 为
linalg.norm函数提供3个或更多轴的张量,并观察其输出。对于任意形状的张量这个函数计算得到什么?
微积分
在2500年前,古希腊人把一个多边形分成三角形,并把它们的面积相加,才找到计算多边形面积的方法。
为了求出曲线形状(比如圆)的面积,古希腊人在这样的形状上刻内接多边形。
如 :numref:fig_circle_area所示,内接多边形的等长边越多,就越接近圆。
这个过程也被称为逼近法(method of exhaustion)。
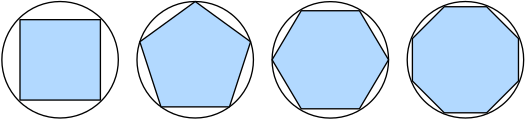
事实上,逼近法就是积分(integral calculus)的起源。
2000多年后,微积分的另一支,微分(differential calculus)被发明出来。
在微分学最重要的应用是优化问题,即考虑如何把事情做到最好。
正如在 :numref:subsec_norms_and_objectives中讨论的那样,
这种问题在深度学习中是无处不在的。
在深度学习中,我们“训练”模型,不断更新它们,使它们在看到越来越多的数据时变得越来越好。
通常情况下,变得更好意味着最小化一个损失函数(loss function),
即一个衡量“模型有多糟糕”这个问题的分数。
最终,我们真正关心的是生成一个模型,它能够在从未见过的数据上表现良好。
但“训练”模型只能将模型与我们实际能看到的数据相拟合。
因此,我们可以将拟合模型的任务分解为两个关键问题:
- 优化(optimization):用模型拟合观测数据的过程;
- 泛化(generalization):数学原理和实践者的智慧,能够指导我们生成出有效性超出用于训练的数据集本身的模型。
为了帮助读者在后面的章节中更好地理解优化问题和方法,
本节提供了一个非常简短的入门教程,帮助读者快速掌握深度学习中常用的微分知识。
导数和微分
我们首先讨论导数的计算,这是几乎所有深度学习优化算法的关键步骤。
在深度学习中,我们通常选择对于模型参数可微的损失函数。
简而言之,对于每个参数,
如果我们把这个参数增加或减少一个无穷小的量,可以知道损失会以多快的速度增加或减少,
假设我们有一个函数,其输入和输出都是标量。
(如果的导数存在,这个极限被定义为)
()
如果存在,则称在处是可微(differentiable)的。
如果在一个区间内的每个数上都是可微的,则此函数在此区间中是可微的。
我们可以将 :eqref:eq_derivative中的导数解释为相对于的瞬时(instantaneous)变化率。
所谓的瞬时变化率是基于中的变化,且接近。
为了更好地解释导数,让我们做一个实验。
(定义)如下:
%matplotlib inline
from d2l import torch as d2l
from matplotlib_inline import backend_inline
import numpy as np

def f(x):
return 3 * x ** 2 - 4 * x[通过令并让接近,] :eqref:eq_derivative中(的数值结果接近)。
虽然这个实验不是一个数学证明,但稍后会看到,当时,导数是。
让我们熟悉一下导数的几个等价符号。
给定,其中和分别是函数的自变量和因变量。以下表达式是等价的:
其中符号和是微分运算符,表示微分操作。
我们可以使用以下规则来对常见函数求微分:
- (是一个常数)
- (幂律(power rule),是任意实数)
为了微分一个由一些常见函数组成的函数,下面的一些法则方便使用。
假设函数和都是可微的,是一个常数,则:
常数相乘法则
加法法则
乘法法则
除法法则
现在我们可以应用上述几个法则来计算。
令,我们有:在这个实验中,数值结果接近,
这一点得到了在本节前面的实验的支持。
当时,此导数也是曲线切线的斜率。
[为了对导数的这种解释进行可视化,我们将使用matplotlib],
这是一个Python中流行的绘图库。
要配置matplotlib生成图形的属性,我们需要(定义几个函数)。
在下面,use_svg_display函数指定matplotlib软件包输出svg图表以获得更清晰的图像。
注意,注释#@save是一个特殊的标记,会将对应的函数、类或语句保存在d2l包中。
因此,以后无须重新定义就可以直接调用它们(例如,d2l.use_svg_display())。
我们定义set_figsize函数来设置图表大小。
注意,这里可以直接使用d2l.plt,因为导入语句
from matplotlib import pyplot as plt已标记为保存到d2l包中。
下面的set_axes函数用于设置由matplotlib生成图表的轴的属性。
通过这三个用于图形配置的函数,定义一个plot函数来简洁地绘制多条曲线,
因为我们需要在整个书中可视化许多曲线。
现在我们可以[绘制函数及其在处的切线],
其中系数是切线的斜率。
偏导数
到目前为止,我们只讨论了仅含一个变量的函数的微分。
在深度学习中,函数通常依赖于许多变量。
因此,我们需要将微分的思想推广到多元函数(multivariate function)上。
设是一个具有个变量的函数。
关于第个参数的偏导数(partial derivative)为:
为了计算,
我们可以简单地将看作常数,
并计算关于的导数。
对于偏导数的表示,以下是等价的:
梯度
我们可以连结一个多元函数对其所有变量的偏导数,以得到该函数的梯度(gradient)向量。
具体而言,设函数的输入是
一个维向量,并且输出是一个标量。
函数相对于的梯度是一个包含个偏导数的向量:
其中通常在没有歧义时被取代。
假设为维向量,在微分多元函数时经常使用以下规则:
- 对于所有,都有
- 对于所有,都有
- 对于所有,都有
同样,对于任何矩阵,都有。
正如我们之后将看到的,梯度对于设计深度学习中的优化算法有很大用处。
链式法则
然而,上面方法可能很难找到梯度。
这是因为在深度学习中,多元函数通常是复合(composite)的,
所以难以应用上述任何规则来微分这些函数。
幸运的是,链式法则可以被用来微分复合函数。
让我们先考虑单变量函数。假设函数和都是可微的,根据链式法则:
现在考虑一个更一般的场景,即函数具有任意数量的变量的情况。
假设可微分函数有变量,其中每个可微分函数都有变量。
注意,是的函数。
对于任意,链式法则给出:
小结
- 微分和积分是微积分的两个分支,前者可以应用于深度学习中的优化问题。
- 导数可以被解释为函数相对于其变量的瞬时变化率,它也是函数曲线的切线的斜率。
- 梯度是一个向量,其分量是多变量函数相对于其所有变量的偏导数。
- 链式法则可以用来微分复合函数。
练习
- 绘制函数和其在处切线的图像。
- 求函数的梯度。
- 函数的梯度是什么?
- 尝试写出函数,其中,,的链式法则。
自动微分
正如 :numref:sec_calculus中所说,求导是几乎所有深度学习优化算法的关键步骤。
虽然求导的计算很简单,只需要一些基本的微积分。
但对于复杂的模型,手工进行更新是一件很痛苦的事情(而且经常容易出错)。
深度学习框架通过自动计算导数,即自动微分(automatic differentiation)来加快求导。
实际中,根据设计好的模型,系统会构建一个计算图(computational graph),
来跟踪计算是哪些数据通过哪些操作组合起来产生输出。
自动微分使系统能够随后反向传播梯度。
这里,反向传播(backpropagate)意味着跟踪整个计算图,填充关于每个参数的偏导数。
一个简单的例子
作为一个演示例子,(假设我们想对函数关于列向量求导)。
首先,我们创建变量x并为其分配一个初始值。
import torch

x = torch.arange(4.0)
x[在我们计算关于的梯度之前,需要一个地方来存储梯度。]
重要的是,我们不会在每次对一个参数求导时都分配新的内存。
因为我们经常会成千上万次地更新相同的参数,每次都分配新的内存可能很快就会将内存耗尽。
注意,一个标量函数关于向量的梯度是向量,并且与具有相同的形状。
x.requires_grad_(True)  # 等价于x=torch.arange(4.0,requires_grad=True)
x.grad # 默认值是None(现在计算。)
y = 2 * torch.dot(x, x)
yx是一个长度为4的向量,计算x和x的点积,得到了我们赋值给y的标量输出。
接下来,[通过调用反向传播函数来自动计算y关于x每个分量的梯度],并打印这些梯度。
y.backward()
x.grad函数关于的梯度应为。
让我们快速验证这个梯度是否计算正确。
x.grad == 4 * x[现在计算x的另一个函数。]
# 在默认情况下,PyTorch会累积梯度,我们需要清除之前的值
x.grad.zero_()
y = x.sum()
y.backward()
x.grad
非标量变量的反向传播
当y不是标量时,向量y关于向量x的导数的最自然解释是一个矩阵。
对于高阶和高维的y和x,求导的结果可以是一个高阶张量。
然而,虽然这些更奇特的对象确实出现在高级机器学习中(包括[深度学习中]),
但当调用向量的反向计算时,我们通常会试图计算一批训练样本中每个组成部分的损失函数的导数。
这里(,我们的目的不是计算微分矩阵,而是单独计算批量中每个样本的偏导数之和。)
# 对非标量调用backward需要传入一个gradient参数,该参数指定微分函数关于self的梯度。
# 本例只想求偏导数的和,所以传递一个1的梯度是合适的
x.grad.zero_()
y = x * x
# 等价于y.backward(torch.ones(len(x)))
y.sum().backward()
x.grad
分离计算
有时,我们希望[将某些计算移动到记录的计算图之外]。
例如,假设y是作为x的函数计算的,而z则是作为y和x的函数计算的。
想象一下,我们想计算z关于x的梯度,但由于某种原因,希望将y视为一个常数,
并且只考虑到x在y被计算后发挥的作用。
这里可以分离y来返回一个新变量u,该变量与y具有相同的值,
但丢弃计算图中如何计算y的任何信息。
换句话说,梯度不会向后流经u到x。
因此,下面的反向传播函数计算z=u*x关于x的偏导数,同时将u作为常数处理,
而不是z=x*x*x关于x的偏导数。
x.grad.zero_()
y = x * x
u = y.detach()
z = u * x

z.sum().backward()
x.grad == u由于记录了y的计算结果,我们可以随后在y上调用反向传播,
得到y=x*x关于的x的导数,即2*x。
x.grad.zero_()
y.sum().backward()
x.grad == 2 * x
Python控制流的梯度计算
使用自动微分的一个好处是:
[即使构建函数的计算图需要通过Python控制流(例如,条件、循环或任意函数调用),我们仍然可以计算得到的变量的梯度]。
在下面的代码中,while循环的迭代次数和if语句的结果都取决于输入a的值。
def f(a):
    b = a * 2
    while b.norm() < 1000:
        b = b * 2
    if b.sum() > 0:
        c = b
    else:
        c = 100 * b
    return c
让我们计算梯度。
a = torch.randn(size=(), requires_grad=True)
d = f(a)
d.backward()我们现在可以分析上面定义的f函数。
请注意,它在其输入a中是分段线性的。
换言之,对于任何a,存在某个常量标量k,使得f(a)=k*a,其中k的值取决于输入a,因此可以用d/a验证梯度是否正确。
a.grad == d / a小结
- 深度学习框架可以自动计算导数:我们首先将梯度附加到想要对其计算偏导数的变量上,然后记录目标值的计算,执行它的反向传播函数,并访问得到的梯度。
练习
- 为什么计算二阶导数比一阶导数的开销要更大?
- 在运行反向传播函数之后,立即再次运行它,看看会发生什么。
- 在控制流的例子中,我们计算
d关于a的导数,如果将变量a更改为随机向量或矩阵,会发生什么? - 重新设计一个求控制流梯度的例子,运行并分析结果。
- 使,绘制和的图像,其中后者不使用。
概率
简单地说,机器学习就是做出预测。
根据病人的临床病史,我们可能想预测他们在下一年心脏病发作的概率。
在飞机喷气发动机的异常检测中,我们想要评估一组发动机读数为正常运行情况的概率有多大。
在强化学习中,我们希望智能体(agent)能在一个环境中智能地行动。
这意味着我们需要考虑在每种可行的行为下获得高奖励的概率。
当我们建立推荐系统时,我们也需要考虑概率。
例如,假设我们为一家大型在线书店工作,我们可能希望估计某些用户购买特定图书的概率。
为此,我们需要使用概率学。
有完整的课程、专业、论文、职业、甚至院系,都致力于概率学的工作。
所以很自然地,我们在这部分的目标不是教授整个科目。
相反,我们希望教给读者基础的概率知识,使读者能够开始构建第一个深度学习模型,
以便读者可以开始自己探索它。
现在让我们更认真地考虑第一个例子:根据照片区分猫和狗。
这听起来可能很简单,但对于机器却可能是一个艰巨的挑战。
首先,问题的难度可能取决于图像的分辨率。
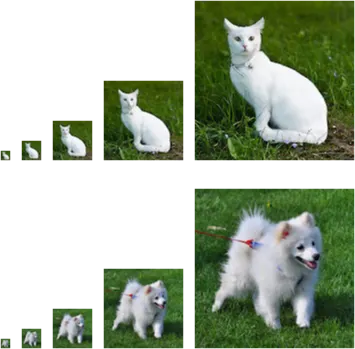 , , , , 和 pixels)" />
:width:300px
如 :numref:fig_cat_dog所示,虽然人类很容易以像素的分辨率识别猫和狗,
但它在像素上变得具有挑战性,而且在像素下几乎是不可能的。
换句话说,我们在很远的距离(从而降低分辨率)区分猫和狗的能力可能会变为猜测。
概率给了我们一种正式的途径来说明我们的确定性水平。
如果我们完全肯定图像是一只猫,我们说标签是"猫"的概率,表示为"猫"等于。
如果我们没有证据表明“猫”或“狗”,那么我们可以说这两种可能性是相等的,
即"猫""狗"。
如果我们不十分确定图像描绘的是一只猫,我们可以将概率赋值为"猫"。
现在考虑第二个例子:给出一些天气监测数据,我们想预测明天北京下雨的概率。
如果是夏天,下雨的概率是0.5。
在这两种情况下,我们都不确定结果,但这两种情况之间有一个关键区别。
在第一种情况中,图像实际上是狗或猫二选一。
在第二种情况下,结果实际上是一个随机的事件。
因此,概率是一种灵活的语言,用于说明我们的确定程度,并且它可以有效地应用于广泛的领域中。
基本概率论
假设我们掷骰子,想知道看到1的几率有多大,而不是看到另一个数字。
如果骰子是公平的,那么所有六个结果都有相同的可能发生,
因此我们可以说发生的概率为。
然而现实生活中,对于我们从工厂收到的真实骰子,我们需要检查它是否有瑕疵。
检查骰子的唯一方法是多次投掷并记录结果。
对于每个骰子,我们将观察到中的一个值。
对于每个值,一种自然的方法是将它出现的次数除以投掷的总次数,
即此事件(event)概率的估计值。
大数定律(law of large numbers)告诉我们:
随着投掷次数的增加,这个估计值会越来越接近真实的潜在概率。
让我们用代码试一试!
首先,我们导入必要的软件包。
%matplotlib inline
from d2l import torch as d2l
import torch
from torch.distributions import multinomial在统计学中,我们把从概率分布中抽取样本的过程称为抽样(sampling)。
笼统来说,可以把分布(distribution)看作对事件的概率分配,
稍后我们将给出的更正式定义。
将概率分配给一些离散选择的分布称为多项分布(multinomial distribution)。
为了抽取一个样本,即掷骰子,我们只需传入一个概率向量。
输出是另一个相同长度的向量:它在索引处的值是采样结果中出现的次数。
fair_probs = torch.ones([6]) / 6
multinomial.Multinomial(1, fair_probs).sample()
在估计一个骰子的公平性时,我们希望从同一分布中生成多个样本。
如果用Python的for循环来完成这个任务,速度会慢得惊人。
因此我们使用深度学习框架的函数同时抽取多个样本,得到我们想要的任意形状的独立样本数组。
multinomial.Multinomial(10, fair_probs).sample()现在我们知道如何对骰子进行采样,我们可以模拟1000次投掷。
然后,我们可以统计1000次投掷后,每个数字被投中了多少次。
具体来说,我们计算相对频率,以作为真实概率的估计。
# 将结果存储为32位浮点数以进行除法
counts = multinomial.Multinomial(1000, fair_probs).sample()
counts / 1000 # 相对频率作为估计值因为我们是从一个公平的骰子中生成的数据,我们知道每个结果都有真实的概率,
大约是,所以上面输出的估计值看起来不错。
我们也可以看到这些概率如何随着时间的推移收敛到真实概率。
让我们进行500组实验,每组抽取10个样本。
counts = multinomial.Multinomial(10, fair_probs).sample((500,))
cum_counts = counts.cumsum(dim=0)
estimates = cum_counts / cum_counts.sum(dim=1, keepdims=True)

d2l.set_figsize((6, 4.5))
for i in range(6):
    d2l.plt.plot(estimates[:, i].numpy(),
                 label=("P(die=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Groups of experiments')
d2l.plt.gca().set_ylabel('Estimated probability')
d2l.plt.legend();
每条实线对应于骰子的6个值中的一个,并给出骰子在每组实验后出现值的估计概率。
当我们通过更多的实验获得更多的数据时,这条实体曲线向真实概率收敛。
概率论公理
在处理骰子掷出时,我们将集合
称为样本空间(sample space)或结果空间(outcome space),
其中每个元素都是结果(outcome)。
事件(event)是一组给定样本空间的随机结果。
例如,“看到”()和“看到奇数”()都是掷出骰子的有效事件。
注意,如果一个随机实验的结果在中,则事件已经发生。
也就是说,如果投掷出点,因为,我们可以说,“看到奇数”的事件发生了。
概率(probability)可以被认为是将集合映射到真实值的函数。
在给定的样本空间中,事件的概率,
表示为,满足以下属性:
- 对于任意事件,其概率从不会是负数,即;
- 整个样本空间的概率为,即;
- 对于互斥(mutually exclusive)事件(对于所有都有)的任意一个可数序列,序列中任意一个事件发生的概率等于它们各自发生的概率之和,即。
以上也是概率论的公理,由科尔莫戈罗夫于1933年提出。
有了这个公理系统,我们可以避免任何关于随机性的哲学争论;
相反,我们可以用数学语言严格地推理。
例如,假设事件为整个样本空间,
且当所有时的,
那么我们可以证明,即不可能发生事件的概率是。
随机变量
在我们掷骰子的随机实验中,我们引入了随机变量(random variable)的概念。
随机变量几乎可以是任何数量,并且它可以在随机实验的一组可能性中取一个值。
考虑一个随机变量,其值在掷骰子的样本空间中。
我们可以将事件“看到一个”表示为或,
其概率表示为或。
通过,我们区分了随机变量和可以采取的值(例如)。
然而,这可能会导致繁琐的表示。
为了简化符号,一方面,我们可以将表示为随机变量上的分布(distribution):
分布告诉我们获得某一值的概率。
另一方面,我们可以简单用表示随机变量取值的概率。
由于概率论中的事件是来自样本空间的一组结果,因此我们可以为随机变量指定值的可取范围。
例如,表示事件,
即的概率。
等价地,表示随机变量从中取值的概率。
请注意,离散(discrete)随机变量(如骰子的每一面)
和连续(continuous)随机变量(如人的体重和身高)之间存在微妙的区别。
现实生活中,测量两个人是否具有完全相同的身高没有太大意义。
如果我们进行足够精确的测量,最终会发现这个星球上没有两个人具有完全相同的身高。
在这种情况下,询问某人的身高是否落入给定的区间,比如是否在1.79米和1.81米之间更有意义。
在这些情况下,我们将这个看到某个数值的可能性量化为密度(density)。
高度恰好为1.80米的概率为0,但密度不是0。
在任何两个不同高度之间的区间,我们都有非零的概率。
在本节的其余部分中,我们将考虑离散空间中的概率。
连续随机变量的概率可以参考深度学习数学附录中随机变量
的一节。
处理多个随机变量
很多时候,我们会考虑多个随机变量。
比如,我们可能需要对疾病和症状之间的关系进行建模。
给定一个疾病和一个症状,比如“流感”和“咳嗽”,以某个概率存在或不存在于某个患者身上。
我们需要估计这些概率以及概率之间的关系,以便我们可以运用我们的推断来实现更好的医疗服务。
再举一个更复杂的例子:图像包含数百万像素,因此有数百万个随机变量。
在许多情况下,图像会附带一个标签(label),标识图像中的对象。
我们也可以将标签视为一个随机变量。
我们甚至可以将所有元数据视为随机变量,例如位置、时间、光圈、焦距、ISO、对焦距离和相机类型。
所有这些都是联合发生的随机变量。
当我们处理多个随机变量时,会有若干个变量是我们感兴趣的。
联合概率
第一个被称为联合概率(joint probability)。
给定任意值和,联合概率可以回答:和同时满足的概率是多少?
请注意,对于任何和的取值,。
这点是确定的,因为要同时发生和,就必须发生,也必须发生(反之亦然)。因此,和同时发生的可能性不大于或是单独发生的可能性。
条件概率
联合概率的不等式带给我们一个有趣的比率:
。
我们称这个比率为条件概率(conditional probability),
并用表示它:它是的概率,前提是已发生。
贝叶斯定理
使用条件概率的定义,我们可以得出统计学中最有用的方程之一:
Bayes定理(Bayes' theorem)。
根据乘法法则(multiplication rule )可得到。
根据对称性,可得到。
假设,求解其中一个条件变量,我们得到
请注意,这里我们使用紧凑的表示法:
其中是一个联合分布(joint distribution),
是一个条件分布(conditional distribution)。
这种分布可以在给定值上进行求值。
边际化
为了能进行事件概率求和,我们需要求和法则(sum rule),
即的概率相当于计算的所有可能选择,并将所有选择的联合概率聚合在一起:
这也称为边际化(marginalization)。
边际化结果的概率或分布称为边际概率(marginal probability)
或边际分布(marginal distribution)。
独立性
另一个有用属性是依赖(dependence)与独立(independence)。
如果两个随机变量和是独立的,意味着事件的发生跟事件的发生无关。
在这种情况下,统计学家通常将这一点表述为。
根据贝叶斯定理,马上就能同样得到。
在所有其他情况下,我们称和依赖。
比如,两次连续抛出一个骰子的事件是相互独立的。
相比之下,灯开关的位置和房间的亮度并不是(因为可能存在灯泡坏掉、电源故障,或者开关故障)。
由于等价于,
因此两个随机变量是独立的,当且仅当两个随机变量的联合分布是其各自分布的乘积。
同样地,给定另一个随机变量时,两个随机变量和是条件独立的(conditionally independent),
当且仅当。
这个情况表示为。
应用
我们实战演练一下!
假设一个医生对患者进行艾滋病病毒(HIV)测试。
这个测试是相当准确的,如果患者健康但测试显示他患病,这个概率只有1%;
如果患者真正感染HIV,它永远不会检测不出。
我们使用来表示诊断结果(如果阳性,则为,如果阴性,则为),
来表示感染艾滋病病毒的状态(如果阳性,则为,如果阴性,则为)。
在 :numref:conditional_prob_D1中列出了这样的条件概率。
:条件概率为
| 条件概率 | "> | "> |
|---|---|---|
| 1 | 0.01 | |
| 0 | 0.99 |
请注意,每列的加和都是1(但每行的加和不是),因为条件概率需要总和为1,就像概率一样。
让我们计算如果测试出来呈阳性,患者感染HIV的概率,即。
显然,这将取决于疾病有多常见,因为它会影响错误警报的数量。
假设人口总体是相当健康的,例如,。
为了应用贝叶斯定理,我们需要运用边际化和乘法法则来确定
因此,我们得到
换句话说,尽管使用了非常准确的测试,患者实际上患有艾滋病的几率只有13.06%。
正如我们所看到的,概率可能是违反直觉的。
患者在收到这样可怕的消息后应该怎么办?
很可能,患者会要求医生进行另一次测试来确定病情。
第二个测试具有不同的特性,它不如第一个测试那么精确,
如 :numref:conditional_prob_D2所示。
:条件概率为
| 条件概率 | "> | "> |
|---|---|---|
| 0.98 | 0.03 | |
| 0.02 | 0.97 |
不幸的是,第二次测试也显示阳性。让我们通过假设条件独立性来计算出应用Bayes定理的必要概率:
现在我们可以应用边际化和乘法规则:
最后,鉴于存在两次阳性检测,患者患有艾滋病的概率为
也就是说,第二次测试使我们能够对患病的情况获得更高的信心。
尽管第二次检验比第一次检验的准确性要低得多,但它仍然显著提高我们的预测概率。
期望和方差
为了概括概率分布的关键特征,我们需要一些测量方法。
一个随机变量的期望(expectation,或平均值(average))表示为
当函数的输入是从分布中抽取的随机变量时,的期望值为
在许多情况下,我们希望衡量随机变量与其期望值的偏置。这可以通过方差来量化
方差的平方根被称为标准差(standard deviation)。
随机变量函数的方差衡量的是:当从该随机变量分布中采样不同值时,
函数值偏离该函数的期望的程度:
小结
- 我们可以从概率分布中采样。
- 我们可以使用联合分布、条件分布、Bayes定理、边缘化和独立性假设来分析多个随机变量。
- 期望和方差为概率分布的关键特征的概括提供了实用的度量形式。
练习
- 进行组实验,每组抽取个样本。改变和,观察和分析实验结果。
- 给定两个概率为和的事件,计算和的上限和下限。(提示:使用友元图来展示这些情况。)
- 假设我们有一系列随机变量,例如、和,其中只依赖于,而只依赖于,能简化联合概率吗?(提示:这是一个马尔可夫链。)
- 在 :numref:
subsec_probability_hiv_app中,第一个测试更准确。为什么不运行第一个测试两次,而是同时运行第一个和第二个测试?
查阅文档
由于篇幅限制,本书不可能介绍每一个PyTorch函数和类。
API文档、其他教程和示例提供了本书之外的大量文档。
本节提供了一些查看PyTorch API的指导。
查找模块中的所有函数和类
为了知道模块中可以调用哪些函数和类,可以调用dir函数。
例如,我们可以(查询随机数生成模块中的所有属性:)
import torch
print(dir(torch.distributions))通常可以忽略以“__”(双下划线)开始和结束的函数,它们是Python中的特殊对象,
或以单个“_”(单下划线)开始的函数,它们通常是内部函数。
根据剩余的函数名或属性名,我们可能会猜测这个模块提供了各种生成随机数的方法,
包括从均匀分布(uniform)、正态分布(normal)和多项分布(multinomial)中采样。
查找特定函数和类的用法
有关如何使用给定函数或类的更具体说明,可以调用help函数。
例如,我们来[查看张量ones函数的用法。]
help(torch.ones)从文档中,我们可以看到ones函数创建一个具有指定形状的新张量,并将所有元素值设置为1。
下面来[运行一个快速测试]来确认这一解释:
torch.ones(4)在Jupyter记事本中,我们可以使用?指令在另一个浏览器窗口中显示文档。
例如,list?指令将创建与help(list)指令几乎相同的内容,并在新的浏览器窗口中显示它。
此外,如果我们使用两个问号,如list??,将显示实现该函数的Python代码。
小结
- 官方文档提供了本书之外的大量描述和示例。
- 可以通过调用
dir和help函数或在Jupyter记事本中使用?和??查看API的用法文档。
练习
- 在深度学习框架中查找任何函数或类的文档。请尝试在这个框架的官方网站上找到文档。