17 / 19
自然语言处理:预训练
人与人之间需要交流。
出于人类这种基本需要,每天都有大量的书面文本产生。
比如,社交媒体、聊天应用、电子邮件、产品评论、新闻文章、
研究论文和书籍中的丰富文本,
使计算机能够理解它们以提供帮助或基于人类语言做出决策变得至关重要。
自然语言处理是指研究使用自然语言的计算机和人类之间的交互。
在实践中,使用自然语言处理技术来处理和分析文本数据是非常常见的,
例如 :numref:sec_language_model的语言模型
和 :numref:sec_machine_translation的机器翻译模型。
要理解文本,我们可以从学习它的表示开始。
利用来自大型语料库的现有文本序列,
自监督学习(self-supervised learning)
已被广泛用于预训练文本表示,
例如通过使用周围文本的其它部分来预测文本的隐藏部分。
通过这种方式,模型可以通过有监督地从海量文本数据中学习,而不需要昂贵的标签标注!
本章我们将看到:当将每个单词或子词视为单个词元时,
可以在大型语料库上使用word2vec、GloVe或子词嵌入模型预先训练每个词元的词元。
经过预训练后,每个词元的表示可以是一个向量。
但是,无论上下文是什么,它都保持不变。
例如,“bank”(可以译作银行或者河岸)的向量表示在
“go to the bank to deposit some money”(去银行存点钱)
和“go to the bank to sit down”(去河岸坐下来)中是相同的。
因此,许多较新的预训练模型使相同词元的表示适应于不同的上下文,
其中包括基于Transformer编码器的更深的自监督模型BERT。
在本章中,我们将重点讨论如何预训练文本的这种表示,
如 :numref:fig_nlp-map-pretrain中所强调的那样。
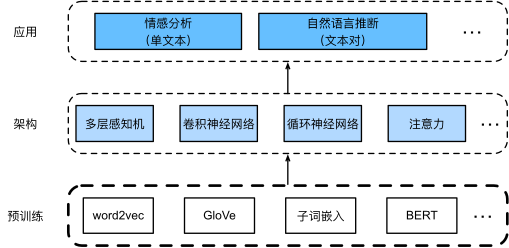
:numref:fig_nlp-map-pretrain显示了
预训练好的文本表示可以放入各种深度学习架构,应用于不同自然语言处理任务。
我们将在 :numref:chap_nlp_app中介绍它们。
:maxdepth: 2

word2vec
approx-training
word-embedding-dataset
word2vec-pretraining
glove
subword-embedding
similarity-analogy
bert
bert-dataset
bert-pretraining
词嵌入(word2vec)
自然语言是用来表达人脑思维的复杂系统。
在这个系统中,词是意义的基本单元。顾名思义,
词向量是用于表示单词意义的向量,
并且还可以被认为是单词的特征向量或表示。
将单词映射到实向量的技术称为词嵌入。
近年来,词嵌入逐渐成为自然语言处理的基础知识。
为何独热向量是一个糟糕的选择
在 :numref:sec_rnn_scratch中,我们使用独热向量来表示词(字符就是单词)。假设词典中不同词的数量(词典大小)为,每个词对应一个从到的不同整数(索引)。为了得到索引为的任意词的独热向量表示,我们创建了一个全为0的长度为的向量,并将位置的元素设置为1。这样,每个词都被表示为一个长度为的向量,可以直接由神经网络使用。
虽然独热向量很容易构建,但它们通常不是一个好的选择。一个主要原因是独热向量不能准确表达不同词之间的相似度,比如我们经常使用的“余弦相似度”。对于向量,它们的余弦相似度是它们之间角度的余弦:
由于任意两个不同词的独热向量之间的余弦相似度为0,所以独热向量不能编码词之间的相似性。
自监督的word2vec
word2vec工具是为了解决上述问题而提出的。它将每个词映射到一个固定长度的向量,这些向量能更好地表达不同词之间的相似性和类比关系。word2vec工具包含两个模型,即跳元模型(skip-gram) (Mikolov.Sutskever.Chen.ea.2013)和连续词袋(CBOW) (Mikolov.Chen.Corrado.ea.2013)。对于在语义上有意义的表示,它们的训练依赖于条件概率,条件概率可以被看作使用语料库中一些词来预测另一些单词。由于是不带标签的数据,因此跳元模型和连续词袋都是自监督模型。
下面,我们将介绍这两种模式及其训练方法。
跳元模型(Skip-Gram)
跳元模型假设一个词可以用来在文本序列中生成其周围的单词。以文本序列“the”“man”“loves”“his”“son”为例。假设中心词选择“loves”,并将上下文窗口设置为2,如图 :numref:fig_skip_gram所示,给定中心词“loves”,跳元模型考虑生成上下文词“the”“man”“him”“son”的条件概率:
假设上下文词是在给定中心词的情况下独立生成的(即条件独立性)。在这种情况下,上述条件概率可以重写为:
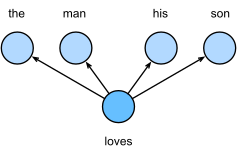
在跳元模型中,每个词都有两个维向量表示,用于计算条件概率。更具体地说,对于词典中索引为的任何词,分别用和表示其用作中心词和上下文词时的两个向量。给定中心词(词典中的索引),生成任何上下文词(词典中的索引)的条件概率可以通过对向量点积的softmax操作来建模:
其中词表索引集。给定长度为的文本序列,其中时间步处的词表示为。假设上下文词是在给定任何中心词的情况下独立生成的。对于上下文窗口,跳元模型的似然函数是在给定任何中心词的情况下生成所有上下文词的概率:
其中可以省略小于或大于的任何时间步。
训练
跳元模型参数是词表中每个词的中心词向量和上下文词向量。在训练中,我们通过最大化似然函数(即极大似然估计)来学习模型参数。这相当于最小化以下损失函数:
当使用随机梯度下降来最小化损失时,在每次迭代中可以随机抽样一个较短的子序列来计算该子序列的(随机)梯度,以更新模型参数。为了计算该(随机)梯度,我们需要获得对数条件概率关于中心词向量和上下文词向量的梯度。通常,根据 :eqref:eq_skip-gram-softmax,涉及中心词和上下文词的对数条件概率为:
通过微分,我们可以获得其相对于中心词向量的梯度为
注意, :eqref:eq_skip-gram-grad中的计算需要词典中以为中心词的所有词的条件概率。其他词向量的梯度可以以相同的方式获得。
对词典中索引为的词进行训练后,得到(作为中心词)和(作为上下文词)两个词向量。在自然语言处理应用中,跳元模型的中心词向量通常用作词表示。
连续词袋(CBOW)模型
连续词袋(CBOW)模型类似于跳元模型。与跳元模型的主要区别在于,连续词袋模型假设中心词是基于其在文本序列中的周围上下文词生成的。例如,在文本序列“the”“man”“loves”“his”“son”中,在“loves”为中心词且上下文窗口为2的情况下,连续词袋模型考虑基于上下文词“the”“man”“him”“son”(如 :numref:fig_cbow所示)生成中心词“loves”的条件概率,即:
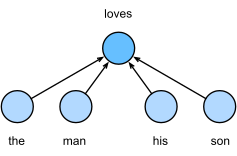
由于连续词袋模型中存在多个上下文词,因此在计算条件概率时对这些上下文词向量进行平均。具体地说,对于字典中索引的任意词,分别用和表示用作上下文词和中心词的两个向量(符号与跳元模型中相反)。给定上下文词(在词表中索引是)生成任意中心词(在词表中索引是)的条件概率可以由以下公式建模:
为了简洁起见,我们设为和。那么 :eqref:fig_cbow-full可以简化为:
给定长度为的文本序列,其中时间步处的词表示为。对于上下文窗口,连续词袋模型的似然函数是在给定其上下文词的情况下生成所有中心词的概率:
训练
训练连续词袋模型与训练跳元模型几乎是一样的。连续词袋模型的最大似然估计等价于最小化以下损失函数:
请注意,
通过微分,我们可以获得其关于任意上下文词向量()的梯度,如下:
其他词向量的梯度可以以相同的方式获得。与跳元模型不同,连续词袋模型通常使用上下文词向量作为词表示。
小结
- 词向量是用于表示单词意义的向量,也可以看作词的特征向量。将词映射到实向量的技术称为词嵌入。
- word2vec工具包含跳元模型和连续词袋模型。
- 跳元模型假设一个单词可用于在文本序列中,生成其周围的单词;而连续词袋模型假设基于上下文词来生成中心单词。
练习
- 计算每个梯度的计算复杂度是多少?如果词表很大,会有什么问题呢?
- 英语中的一些固定短语由多个单词组成,例如“new york”。如何训练它们的词向量?提示:查看word2vec论文的第四节 (Mikolov.Sutskever.Chen.ea.2013)。
- 让我们以跳元模型为例来思考word2vec设计。跳元模型中两个词向量的点积与余弦相似度之间有什么关系?对于语义相似的一对词,为什么它们的词向量(由跳元模型训练)的余弦相似度可能很高?
近似训练
回想一下我们在 :numref:sec_word2vec中的讨论。跳元模型的主要思想是使用softmax运算来计算基于给定的中心词生成上下文字的条件概率(如 :eqref:eq_skip-gram-softmax),对应的对数损失在 :eqref:eq_skip-gram-log给出。
由于softmax操作的性质,上下文词可以是词表中的任意项, :eqref:eq_skip-gram-log包含与整个词表大小一样多的项的求和。因此, :eqref:eq_skip-gram-grad中跳元模型的梯度计算和 :eqref:eq_cbow-gradient中的连续词袋模型的梯度计算都包含求和。不幸的是,在一个词典上(通常有几十万或数百万个单词)求和的梯度的计算成本是巨大的!
为了降低上述计算复杂度,本节将介绍两种近似训练方法:负采样和分层softmax。
由于跳元模型和连续词袋模型的相似性,我们将以跳元模型为例来描述这两种近似训练方法。
负采样
负采样修改了原目标函数。给定中心词的上下文窗口,任意上下文词来自该上下文窗口的被认为是由下式建模概率的事件:
其中使用了sigmoid激活函数的定义:
让我们从最大化文本序列中所有这些事件的联合概率开始训练词嵌入。具体而言,给定长度为的文本序列,以表示时间步的词,并使上下文窗口为,考虑最大化联合概率:
然而, :eqref:eq-negative-sample-pos只考虑那些正样本的事件。仅当所有词向量都等于无穷大时, :eqref:eq-negative-sample-pos中的联合概率才最大化为1。当然,这样的结果毫无意义。为了使目标函数更有意义,负采样添加从预定义分布中采样的负样本。
用表示上下文词来自中心词的上下文窗口的事件。对于这个涉及的事件,从预定义分布中采样个不是来自这个上下文窗口噪声词。用表示噪声词()不是来自的上下文窗口的事件。假设正例和负例的这些事件是相互独立的。负采样将 :eqref:eq-negative-sample-pos中的联合概率(仅涉及正例)重写为
通过事件近似条件概率:
分别用和表示词和噪声词在文本序列的时间步处的索引。 :eqref:eq-negative-sample-conditional-prob中关于条件概率的对数损失为:
我们可以看到,现在每个训练步的梯度计算成本与词表大小无关,而是线性依赖于。当将超参数设置为较小的值时,在负采样的每个训练步处的梯度的计算成本较小。
层序Softmax
作为另一种近似训练方法,层序Softmax(hierarchical softmax)使用二叉树( :numref:fig_hi_softmax中说明的数据结构),其中树的每个叶节点表示词表中的一个词。
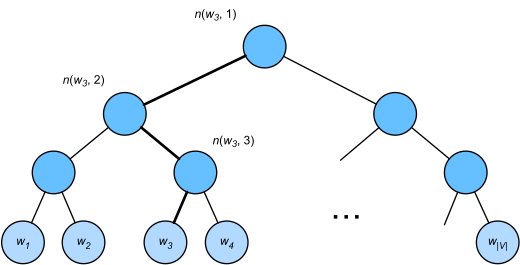
用表示二叉树中表示字的从根节点到叶节点的路径上的节点数(包括两端)。设为该路径上的节点,其上下文字向量为。例如, :numref:fig_hi_softmax中的。分层softmax将 :eqref:eq_skip-gram-softmax中的条件概率近似为
其中函数在 :eqref:eq_sigma-f中定义,是节点的左子节点:如果为真,;否则。
为了说明,让我们计算 :numref:fig_hi_softmax中给定词生成词的条件概率。这需要的词向量和从根到的路径( :numref:fig_hi_softmax中加粗的路径)上的非叶节点向量之间的点积,该路径依次向左、向右和向左遍历:
由,它认为基于任意词生成词表中所有词的条件概率总和为1:
幸运的是,由于二叉树结构,大约与是一个数量级。当词表大小很大时,与没有近似训练的相比,使用分层softmax的每个训练步的计算代价显著降低。
小结
- 负采样通过考虑相互独立的事件来构造损失函数,这些事件同时涉及正例和负例。训练的计算量与每一步的噪声词数成线性关系。
- 分层softmax使用二叉树中从根节点到叶节点的路径构造损失函数。训练的计算成本取决于词表大小的对数。
练习
- 如何在负采样中对噪声词进行采样?
- 验证 :eqref:
eq_hi-softmax-sum-one是否有效。 - 如何分别使用负采样和分层softmax训练连续词袋模型?
用于预训练词嵌入的数据集
现在我们已经了解了word2vec模型的技术细节和大致的训练方法,让我们来看看它们的实现。具体地说,我们将以 :numref:sec_word2vec的跳元模型和 :numref:sec_approx_train的负采样为例。本节从用于预训练词嵌入模型的数据集开始:数据的原始格式将被转换为可以在训练期间迭代的小批量。
from d2l import torch as d2l
import math
import torch
import os
import random
读取数据集
我们在这里使用的数据集是Penn Tree Bank(PTB)。该语料库取自“华尔街日报”的文章,分为训练集、验证集和测试集。在原始格式中,文本文件的每一行表示由空格分隔的一句话。在这里,我们将每个单词视为一个词元。
在读取训练集之后,我们为语料库构建了一个词表,其中出现次数少于10次的任何单词都将由“<unk>”词元替换。请注意,原始数据集还包含表示稀有(未知)单词的“<unk>”词元。
下采样
文本数据通常有“the”“a”和“in”等高频词:它们在非常大的语料库中甚至可能出现数十亿次。然而,这些词经常在上下文窗口中与许多不同的词共同出现,提供的有用信息很少。例如,考虑上下文窗口中的词“chip”:直观地说,它与低频单词“intel”的共现比与高频单词“a”的共现在训练中更有用。此外,大量(高频)单词的训练速度很慢。因此,当训练词嵌入模型时,可以对高频单词进行下采样 (Mikolov.Sutskever.Chen.ea.2013)。具体地说,数据集中的每个词将有概率地被丢弃
其中是的词数与数据集中的总词数的比率,常量是超参数(在实验中为)。我们可以看到,只有当相对比率时,(高频)词才能被丢弃,且该词的相对比率越高,被丢弃的概率就越大。
下面的代码片段绘制了下采样前后每句话的词元数量的直方图。正如预期的那样,下采样通过删除高频词来显著缩短句子,这将使训练加速。
对于单个词元,高频词“the”的采样率不到1/20。
相比之下,低频词“join”则被完全保留。
在下采样之后,我们将词元映射到它们在语料库中的索引。
中心词和上下文词的提取
下面的get_centers_and_contexts函数从corpus中提取所有中心词及其上下文词。它随机采样1到max_window_size之间的整数作为上下文窗口。对于任一中心词,与其距离不超过采样上下文窗口大小的词为其上下文词。
接下来,我们创建一个人工数据集,分别包含7个和3个单词的两个句子。设置最大上下文窗口大小为2,并打印所有中心词及其上下文词。
在PTB数据集上进行训练时,我们将最大上下文窗口大小设置为5。下面提取数据集中的所有中心词及其上下文词。
负采样
我们使用负采样进行近似训练。为了根据预定义的分布对噪声词进行采样,我们定义以下RandomGenerator类,其中(可能未规范化的)采样分布通过变量sampling_weights传递。
例如,我们可以在索引1、2和3中绘制10个随机变量,采样概率为和,如下所示。
对于一对中心词和上下文词,我们随机抽取了K个(实验中为5个)噪声词。根据word2vec论文中的建议,将噪声词的采样概率设置为其在字典中的相对频率,其幂为0.75 (Mikolov.Sutskever.Chen.ea.2013)。
小批量加载训练实例
在提取所有中心词及其上下文词和采样噪声词后,将它们转换成小批量的样本,在训练过程中可以迭代加载。
在小批量中,个样本包括中心词及其个上下文词和个噪声词。由于上下文窗口大小不同,对于不同的是不同的。因此,对于每个样本,我们在contexts_negatives个变量中将其上下文词和噪声词连结起来,并填充零,直到连结长度达到(max_len)。为了在计算损失时排除填充,我们定义了掩码变量masks。在masks中的元素和contexts_negatives中的元素之间存在一一对应关系,其中masks中的0(否则为1)对应于contexts_negatives中的填充。
为了区分正反例,我们在contexts_negatives中通过一个labels变量将上下文词与噪声词分开。类似于masks,在labels中的元素和contexts_negatives中的元素之间也存在一一对应关系,其中labels中的1(否则为0)对应于contexts_negatives中的上下文词的正例。
上述思想在下面的batchify函数中实现。其输入data是长度等于批量大小的列表,其中每个元素是由中心词center、其上下文词context和其噪声词negative组成的样本。此函数返回一个可以在训练期间加载用于计算的小批量,例如包括掩码变量。
让我们使用一个小批量的两个样本来测试此函数。
整合代码
最后,我们定义了读取PTB数据集并返回数据迭代器和词表的load_data_ptb函数。
#@save
def load_data_ptb(batch_size, max_window_size, num_noise_words):
    """下载PTB数据集,然后将其加载到内存中"""
    num_workers = d2l.get_dataloader_workers()
    sentences = read_ptb()
    vocab = d2l.Vocab(sentences, min_freq=10)
    subsampled, counter = subsample(sentences, vocab)
    corpus = [vocab[line] for line in subsampled]
    all_centers, all_contexts = get_centers_and_contexts(
        corpus, max_window_size)
    all_negatives = get_negatives(
        all_contexts, vocab, counter, num_noise_words)

    class PTBDataset(torch.utils.data.Dataset):
        def __init__(self, centers, contexts, negatives):
            assert len(centers) == len(contexts) == len(negatives)
            self.centers = centers
            self.contexts = contexts
            self.negatives = negatives

        def __getitem__(self, index):
            return (self.centers[index], self.contexts[index],
                    self.negatives[index])

        def __len__(self):
            return len(self.centers)

    dataset = PTBDataset(all_centers, all_contexts, all_negatives)

    data_iter = torch.utils.data.DataLoader(
        dataset, batch_size, shuffle=True,
        collate_fn=batchify, num_workers=num_workers)
    return data_iter, vocab
让我们打印数据迭代器的第一个小批量。
小结
- 高频词在训练中可能不是那么有用。我们可以对他们进行下采样,以便在训练中加快速度。
- 为了提高计算效率,我们以小批量方式加载样本。我们可以定义其他变量来区分填充标记和非填充标记,以及正例和负例。
练习
- 如果不使用下采样,本节中代码的运行时间会发生什么变化?
RandomGenerator类缓存k个随机采样结果。将k设置为其他值,看看它如何影响数据加载速度。- 本节代码中的哪些其他超参数可能会影响数据加载速度?
预训练word2vec
我们继续实现 :numref:sec_word2vec中定义的跳元语法模型。然后,我们将在PTB数据集上使用负采样预训练word2vec。首先,让我们通过调用d2l.load_data_ptb函数来获得该数据集的数据迭代器和词表,该函数在 :numref:sec_word2vec_data中进行了描述。
from d2l import torch as d2l
import math
import torch
from torch import nn

batch_size, max_window_size, num_noise_words = 512, 5, 5
data_iter, vocab = d2l.load_data_ptb(batch_size, max_window_size,
                                     num_noise_words)
跳元模型
我们通过嵌入层和批量矩阵乘法实现了跳元模型。首先,让我们回顾一下嵌入层是如何工作的。
嵌入层
如 :numref:sec_seq2seq中所述,嵌入层将词元的索引映射到其特征向量。该层的权重是一个矩阵,其行数等于字典大小(input_dim),列数等于每个标记的向量维数(output_dim)。在词嵌入模型训练之后,这个权重就是我们所需要的。
embed = nn.Embedding(num_embeddings=20, embedding_dim=4)
print(f'Parameter embedding_weight ({embed.weight.shape}, '
f'dtype={embed.weight.dtype})')嵌入层的输入是词元(词)的索引。对于任何词元索引,其向量表示可以从嵌入层中的权重矩阵的第行获得。由于向量维度(output_dim)被设置为4,因此当小批量词元索引的形状为(2,3)时,嵌入层返回具有形状(2,3,4)的向量。
定义前向传播
在前向传播中,跳元语法模型的输入包括形状为(批量大小,1)的中心词索引center和形状为(批量大小,max_len)的上下文与噪声词索引contexts_and_negatives,其中max_len在 :numref:subsec_word2vec-minibatch-loading中定义。这两个变量首先通过嵌入层从词元索引转换成向量,然后它们的批量矩阵相乘(在 :numref:subsec_batch_dot中描述)返回形状为(批量大小,1,max_len)的输出。输出中的每个元素是中心词向量和上下文或噪声词向量的点积。
def skip_gram(center, contexts_and_negatives, embed_v, embed_u):
    v = embed_v(center)
    u = embed_u(contexts_and_negatives)
    pred = torch.bmm(v, u.permute(0, 2, 1))
return pred让我们为一些样例输入打印此skip_gram函数的输出形状。
skip_gram(torch.ones((2, 1), dtype=torch.long),
          torch.ones((2, 4), dtype=torch.long), embed, embed).shape
训练
在训练带负采样的跳元模型之前,我们先定义它的损失函数。
二元交叉熵损失
根据 :numref:subsec_negative-sampling中负采样损失函数的定义,我们将使用二元交叉熵损失。
class SigmoidBCELoss(nn.Module):
    # 带掩码的二元交叉熵损失
    def __init__(self):
        super().__init__()

    def forward(self, inputs, target, mask=None):
        out = nn.functional.binary_cross_entropy_with_logits(
            inputs, target, weight=mask, reduction="none")
        return out.mean(dim=1)

loss = SigmoidBCELoss()
回想一下我们在 :numref:subsec_word2vec-minibatch-loading中对掩码变量和标签变量的描述。下面计算给定变量的二进制交叉熵损失。
下面显示了如何使用二元交叉熵损失中的Sigmoid激活函数(以较低效率的方式)计算上述结果。我们可以将这两个输出视为两个规范化的损失,在非掩码预测上进行平均。
初始化模型参数
我们定义了两个嵌入层,将词表中的所有单词分别作为中心词和上下文词使用。字向量维度embed_size被设置为100。
, paddle
embed_size = 100
net = nn.Sequential(nn.Embedding(num_embeddings=len(vocab),
                                 embedding_dim=embed_size),
                    nn.Embedding(num_embeddings=len(vocab),
                                 embedding_dim=embed_size))
定义训练阶段代码
训练阶段代码实现定义如下。由于填充的存在,损失函数的计算与以前的训练函数略有不同。
def train(net, data_iter, lr, num_epochs, device=d2l.try_gpu()):
    def init_weights(m):
        if type(m) == nn.Embedding:
            nn.init.xavier_uniform_(m.weight)
    net.apply(init_weights)
    net = net.to(device)
    optimizer = torch.optim.Adam(net.parameters(), lr=lr)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                            xlim=[1, num_epochs])
    # 规范化的损失之和,规范化的损失数
    metric = d2l.Accumulator(2)
    for epoch in range(num_epochs):
        timer, num_batches = d2l.Timer(), len(data_iter)
        for i, batch in enumerate(data_iter):
            optimizer.zero_grad()
            center, context_negative, mask, label = [
                data.to(device) for data in batch]

            pred = skip_gram(center, context_negative, net[0], net[1])
            l = (loss(pred.reshape(label.shape).float(), label.float(), mask)
                     / mask.sum(axis=1) * mask.shape[1])
            l.sum().backward()
            optimizer.step()
            metric.add(l.sum(), l.numel())
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (metric[0] / metric[1],))
    print(f'loss {metric[0] / metric[1]:.3f}, '
          f'{metric[1] / timer.stop():.1f} tokens/sec on {str(device)}')
现在,我们可以使用负采样来训练跳元模型。
应用词嵌入
在训练word2vec模型之后,我们可以使用训练好模型中词向量的余弦相似度来从词表中找到与输入单词语义最相似的单词。
def get_similar_tokens(query_token, k, embed):
    W = embed.weight.data
    x = W[vocab[query_token]]
    # 计算余弦相似性。增加1e-9以获得数值稳定性
    cos = torch.mv(W, x) / torch.sqrt(torch.sum(W * W, dim=1) *
                                      torch.sum(x * x) + 1e-9)
    topk = torch.topk(cos, k=k+1)[1].cpu().numpy().astype('int32')
    for i in topk[1:]:  # 删除输入词
        print(f'cosine sim={float(cos[i]):.3f}: {vocab.to_tokens(i)}')

get_similar_tokens('chip', 3, net[0])
小结
- 我们可以使用嵌入层和二元交叉熵损失来训练带负采样的跳元模型。
- 词嵌入的应用包括基于词向量的余弦相似度为给定词找到语义相似的词。
练习
- 使用训练好的模型,找出其他输入词在语义上相似的词。您能通过调优超参数来改进结果吗?
- 当训练语料库很大时,在更新模型参数时,我们经常对当前小批量的中心词进行上下文词和噪声词的采样。换言之,同一中心词在不同的训练迭代轮数可以有不同的上下文词或噪声词。这种方法的好处是什么?尝试实现这种训练方法。
全局向量的词嵌入(GloVe)
上下文窗口内的词共现可以携带丰富的语义信息。例如,在一个大型语料库中,“固体”比“气体”更有可能与“冰”共现,但“气体”一词与“蒸汽”的共现频率可能比与“冰”的共现频率更高。此外,可以预先计算此类共现的全局语料库统计数据:这可以提高训练效率。为了利用整个语料库中的统计信息进行词嵌入,让我们首先回顾 :numref:subsec_skip-gram中的跳元模型,但是使用全局语料库统计(如共现计数)来解释它。
带全局语料统计的跳元模型
用表示词的条件概率,在跳元模型中给定词,我们有:
其中,对于任意索引,向量和分别表示词作为中心词和上下文词,且是词表的索引集。
考虑词可能在语料库中出现多次。在整个语料库中,所有以为中心词的上下文词形成一个词索引的多重集,该索引允许同一元素的多个实例。对于任何元素,其实例数称为其重数。举例说明,假设词在语料库中出现两次,并且在两个上下文窗口中以为其中心词的上下文词索引是和。因此,多重集,其中元素的重数分别为2、4、1、1。
现在,让我们将多重集中的元素的重数表示为。这是词(作为上下文词)和词(作为中心词)在整个语料库的同一上下文窗口中的全局共现计数。使用这样的全局语料库统计,跳元模型的损失函数等价于:
我们用表示上下文窗口中的所有上下文词的数量,其中作为它们的中心词出现,这相当于。设为用于生成上下文词的条件概率。给定中心词, :eqref:eq_skipgram-x_ij可以重写为:
在 :eqref:eq_skipgram-p_ij中,计算全局语料统计的条件分布和模型预测的条件分布的交叉熵。如上所述,这一损失也按加权。在 :eqref:eq_skipgram-p_ij中最小化损失函数将使预测的条件分布接近全局语料库统计中的条件分布。
虽然交叉熵损失函数通常用于测量概率分布之间的距离,但在这里可能不是一个好的选择。一方面,正如我们在 :numref:sec_approx_train中提到的,规范化的代价在于整个词表的求和,这在计算上可能非常昂贵。另一方面,来自大型语料库的大量罕见事件往往被交叉熵损失建模,从而赋予过多的权重。
GloVe模型
有鉴于此,GloVe模型基于平方损失 (Pennington.Socher.Manning.2014)对跳元模型做了三个修改:
- 使用变量和
而非概率分布,并取两者的对数。所以平方损失项是。 - 为每个词添加两个标量模型参数:中心词偏置和上下文词偏置。
- 用权重函数替换每个损失项的权重,其中在的间隔内递增。
整合代码,训练GloVe是为了尽量降低以下损失函数:
对于权重函数,建议的选择是:当(例如,)时,(例如);否则。在这种情况下,由于,为了提高计算效率,可以省略任意的平方损失项。例如,当使用小批量随机梯度下降进行训练时,在每次迭代中,我们随机抽样一小批量非零的来计算梯度并更新模型参数。注意,这些非零的是预先计算的全局语料库统计数据;因此,该模型GloVe被称为全局向量。
应该强调的是,当词出现在词的上下文窗口时,词也出现在词的上下文窗口。因此,。与拟合非对称条件概率的word2vec不同,GloVe拟合对称概率。因此,在GloVe模型中,任意词的中心词向量和上下文词向量在数学上是等价的。但在实际应用中,由于初始值不同,同一个词经过训练后,在这两个向量中可能得到不同的值:GloVe将它们相加作为输出向量。
从条件概率比值理解GloVe模型
我们也可以从另一个角度来理解GloVe模型。使用 :numref:subsec_skipgram-global中的相同符号,设为生成上下文词的条件概率,给定作为语料库中的中心词。 :numref:tab_glove根据大量语料库的统计数据,列出了给定单词“ice”和“steam”的共现概率及其比值。
大型语料库中的词-词共现概率及其比值(根据 (Pennington.Socher.Manning.2014)中的表1改编)
|=|solid|gas|water|fashion|
|:--|:-|:-|:-|:-|
||0.00019|0.000066|0.003|0.000017|
||0.000022|0.00078|0.0022|0.000018|
||8.9|0.085|1.36|0.96|
从 :numref:tab_glove中,我们可以观察到以下几点:
- 对于与“ice”相关但与“steam”无关的单词,例如,我们预计会有更大的共现概率比值,例如8.9。
- 对于与“steam”相关但与“ice”无关的单词,例如,我们预计较小的共现概率比值,例如0.085。
- 对于同时与“ice”和“steam”相关的单词,例如,我们预计其共现概率的比值接近1,例如1.36.
- 对于与“ice”和“steam”都不相关的单词,例如,我们预计共现概率的比值接近1,例如0.96.
由此可见,共现概率的比值能够直观地表达词与词之间的关系。因此,我们可以设计三个词向量的函数来拟合这个比值。对于共现概率的比值,其中是中心词,和是上下文词,我们希望使用某个函数来拟合该比值:
在的许多可能的设计中,我们只在以下几点中选择了一个合理的选择。因为共现概率的比值是标量,所以我们要求是标量函数,例如。在 :eqref:eq_glove-f中交换词索引和,它必须保持,所以一种可能性是,即:
现在让我们选择,其中是常数。从开始,取两边的对数得到。我们可以使用附加的偏置项来拟合,如中心词偏置和上下文词偏置:
通过对 :eqref:eq_glove-square的加权平方误差的度量,得到了 :eqref:eq_glove-loss的GloVe损失函数。
小结
- 诸如词-词共现计数的全局语料库统计可以来解释跳元模型。
- 交叉熵损失可能不是衡量两种概率分布差异的好选择,特别是对于大型语料库。GloVe使用平方损失来拟合预先计算的全局语料库统计数据。
- 对于GloVe中的任意词,中心词向量和上下文词向量在数学上是等价的。
- GloVe可以从词-词共现概率的比率来解释。
练习
- 如果词和在同一上下文窗口中同时出现,我们如何使用它们在文本序列中的距离来重新设计计算条件概率的方法?提示:参见GloVe论文 (Pennington.Socher.Manning.2014)的第4.2节。
- 对于任何一个词,它的中心词偏置和上下文偏置在数学上是等价的吗?为什么?
子词嵌入
在英语中,“helps”“helped”和“helping”等单词都是同一个词“help”的变形形式。“dog”和“dogs”之间的关系与“cat”和“cats”之间的关系相同,“boy”和“boyfriend”之间的关系与“girl”和“girlfriend”之间的关系相同。在法语和西班牙语等其他语言中,许多动词有40多种变形形式,而在芬兰语中,名词最多可能有15种变形。在语言学中,形态学研究单词形成和词汇关系。但是,word2vec和GloVe都没有对词的内部结构进行探讨。
fastText模型
回想一下词在word2vec中是如何表示的。在跳元模型和连续词袋模型中,同一词的不同变形形式直接由不同的向量表示,不需要共享参数。为了使用形态信息,fastText模型提出了一种子词嵌入方法,其中子词是一个字符-gram (Bojanowski.Grave.Joulin.ea.2017)。fastText可以被认为是子词级跳元模型,而非学习词级向量表示,其中每个中心词由其子词级向量之和表示。
让我们来说明如何以单词“where”为例获得fastText中每个中心词的子词。首先,在词的开头和末尾添加特殊字符“<”和“>”,以将前缀和后缀与其他子词区分开来。
然后,从词中提取字符-gram。
例如,值时,我们将获得长度为3的所有子词:
“<wh”“whe”“her”“ere”“re>”和特殊子词“<where>”。
在fastText中,对于任意词,用表示其长度在3和6之间的所有子词与其特殊子词的并集。词表是所有词的子词的集合。假设是词典中的子词的向量,则跳元模型中作为中心词的词的向量是其子词向量的和:
fastText的其余部分与跳元模型相同。与跳元模型相比,fastText的词量更大,模型参数也更多。此外,为了计算一个词的表示,它的所有子词向量都必须求和,这导致了更高的计算复杂度。然而,由于具有相似结构的词之间共享来自子词的参数,罕见词甚至词表外的词在fastText中可能获得更好的向量表示。
字节对编码(Byte Pair Encoding)
在fastText中,所有提取的子词都必须是指定的长度,例如到,因此词表大小不能预定义。为了在固定大小的词表中允许可变长度的子词,我们可以应用一种称为字节对编码(Byte Pair Encoding,BPE)的压缩算法来提取子词 (Sennrich.Haddow.Birch.2015)。
字节对编码执行训练数据集的统计分析,以发现单词内的公共符号,诸如任意长度的连续字符。从长度为1的符号开始,字节对编码迭代地合并最频繁的连续符号对以产生新的更长的符号。请注意,为提高效率,不考虑跨越单词边界的对。最后,我们可以使用像子词这样的符号来切分单词。字节对编码及其变体已经用于诸如GPT-2 (Radford.Wu.Child.ea.2019)和RoBERTa (Liu.Ott.Goyal.ea.2019)等自然语言处理预训练模型中的输入表示。在下面,我们将说明字节对编码是如何工作的。
首先,我们将符号词表初始化为所有英文小写字符、特殊的词尾符号'_'和特殊的未知符号'[UNK]'。
因为我们不考虑跨越词边界的符号对,所以我们只需要一个字典raw_token_freqs将词映射到数据集中的频率(出现次数)。注意,特殊符号'_'被附加到每个词的尾部,以便我们可以容易地从输出符号序列(例如,“a_all er_man”)恢复单词序列(例如,“a_all er_man”)。由于我们仅从单个字符和特殊符号的词开始合并处理,所以在每个词(词典token_freqs的键)内的每对连续字符之间插入空格。换句话说,空格是词中符号之间的分隔符。
我们定义以下get_max_freq_pair函数,其返回词内最频繁的连续符号对,其中词来自输入词典token_freqs的键。
作为基于连续符号频率的贪心方法,字节对编码将使用以下merge_symbols函数来合并最频繁的连续符号对以产生新符号。
现在,我们对词典token_freqs的键迭代地执行字节对编码算法。在第一次迭代中,最频繁的连续符号对是't'和'a',因此字节对编码将它们合并以产生新符号'ta'。在第二次迭代中,字节对编码继续合并'ta'和'l'以产生另一个新符号'tal'。
在字节对编码的10次迭代之后,我们可以看到列表symbols现在又包含10个从其他符号迭代合并而来的符号。
对于在词典raw_token_freqs的键中指定的同一数据集,作为字节对编码算法的结果,数据集中的每个词现在被子词“fast_”“fast”“er_”“tall_”和“tall”分割。例如,单词“fast er_”和“tall er_”分别被分割为“fast er_”和“tall er_”。
请注意,字节对编码的结果取决于正在使用的数据集。我们还可以使用从一个数据集学习的子词来切分另一个数据集的单词。作为一种贪心方法,下面的segment_BPE函数尝试将单词从输入参数symbols分成可能最长的子词。
我们使用列表symbols中的子词(从前面提到的数据集学习)来表示另一个数据集的tokens。
小结
- fastText模型提出了一种子词嵌入方法:基于word2vec中的跳元模型,它将中心词表示为其子词向量之和。
- 字节对编码执行训练数据集的统计分析,以发现词内的公共符号。作为一种贪心方法,字节对编码迭代地合并最频繁的连续符号对。
- 子词嵌入可以提高稀有词和词典外词的表示质量。
练习
- 例如,英语中大约有种可能的-元组。子词太多会有什么问题呢?如何解决这个问题?提示:请参阅fastText论文第3.2节末尾 (Bojanowski.Grave.Joulin.ea.2017)。
- 如何在连续词袋模型的基础上设计一个子词嵌入模型?
- 要获得大小为的词表,当初始符号词表大小为时,需要多少合并操作?
- 如何扩展字节对编码的思想来提取短语?
词的相似性和类比任务
在 :numref:sec_word2vec_pretraining中,我们在一个小的数据集上训练了一个word2vec模型,并使用它为一个输入词寻找语义相似的词。实际上,在大型语料库上预先训练的词向量可以应用于下游的自然语言处理任务,这将在后面的 :numref:chap_nlp_app中讨论。为了直观地演示大型语料库中预训练词向量的语义,让我们将预训练词向量应用到词的相似性和类比任务中。
from d2l import torch as d2l
import torch
from torch import nn
import os
加载预训练词向量
以下列出维度为50、100和300的预训练GloVe嵌入,可从GloVe网站下载。预训练的fastText嵌入有多种语言。这里我们使用可以从fastText网站下载300维度的英文版本(“wiki.en”)。
为了加载这些预训练的GloVe和fastText嵌入,我们定义了以下TokenEmbedding类。
下面我们加载50维GloVe嵌入(在维基百科的子集上预训练)。创建TokenEmbedding实例时,如果尚未下载指定的嵌入文件,则必须下载该文件。
输出词表大小。词表包含400000个词(词元)和一个特殊的未知词元。
我们可以得到词表中一个单词的索引,反之亦然。
应用预训练词向量
使用加载的GloVe向量,我们将通过下面的词相似性和类比任务中来展示词向量的语义。
词相似度
与 :numref:subsec_apply-word-embed类似,为了根据词向量之间的余弦相似性为输入词查找语义相似的词,我们实现了以下knn(近邻)函数。
def knn(W, x, k):
    # 增加1e-9以获得数值稳定性
    cos = torch.mv(W, x.reshape(-1,)) / (
        torch.sqrt(torch.sum(W * W, axis=1) + 1e-9) *
        torch.sqrt((x * x).sum()))
    _, topk = torch.topk(cos, k=k)
return topk, [cos[int(i)] for i in topk]然后,我们使用TokenEmbedding的实例embed中预训练好的词向量来搜索相似的词。
glove_6b50d中预训练词向量的词表包含400000个词和一个特殊的未知词元。排除输入词和未知词元后,我们在词表中找到与“chip”一词语义最相似的三个词。
下面输出与“baby”和“beautiful”相似的词。
词类比
除了找到相似的词,我们还可以将词向量应用到词类比任务中。
例如,“man” : “woman” :: “son” : “daughter”是一个词的类比。
“man”是对“woman”的类比,“son”是对“daughter”的类比。
具体来说,词类比任务可以定义为:
对于单词类比,给出前三个词、和,找到。
用表示词的向量,
为了完成这个类比,我们将找到一个词,
其向量与的结果最相似。
让我们使用加载的词向量来验证“male-female”类比。
下面完成一个“首都-国家”的类比:
“beijing” : “china” :: “tokyo” : “japan”。
这说明了预训练词向量中的语义。
另外,对于“bad” : “worst” :: “big” : “biggest”等“形容词-形容词最高级”的比喻,预训练词向量可以捕捉到句法信息。
为了演示在预训练词向量中捕捉到的过去式概念,我们可以使用“现在式-过去式”的类比来测试句法:“do” : “did” :: “go” : “went”。
小结
- 在实践中,在大型语料库上预先练的词向量可以应用于下游的自然语言处理任务。
- 预训练的词向量可以应用于词的相似性和类比任务。
练习
- 使用
TokenEmbedding('wiki.en')测试fastText结果。 - 当词表非常大时,我们怎样才能更快地找到相似的词或完成一个词的类比呢?
来自Transformers的双向编码器表示(BERT)
我们已经介绍了几种用于自然语言理解的词嵌入模型。在预训练之后,输出可以被认为是一个矩阵,其中每一行都是一个表示预定义词表中词的向量。事实上,这些词嵌入模型都是与上下文无关的。让我们先来说明这个性质。
从上下文无关到上下文敏感
回想一下 :numref:sec_word2vec_pretraining和 :numref:sec_synonyms中的实验。例如,word2vec和GloVe都将相同的预训练向量分配给同一个词,而不考虑词的上下文(如果有的话)。形式上,任何词元的上下文无关表示是函数,其仅将作为其输入。考虑到自然语言中丰富的多义现象和复杂的语义,上下文无关表示具有明显的局限性。例如,在“a crane is flying”(一只鹤在飞)和“a crane driver came”(一名吊车司机来了)的上下文中,“crane”一词有完全不同的含义;因此,同一个词可以根据上下文被赋予不同的表示。
这推动了“上下文敏感”词表示的发展,其中词的表征取决于它们的上下文。因此,词元的上下文敏感表示是函数,其取决于及其上下文。流行的上下文敏感表示包括TagLM(language-model-augmented sequence tagger,语言模型增强的序列标记器) (Peters.Ammar.Bhagavatula.ea.2017)、CoVe(Context Vectors,上下文向量) (McCann.Bradbury.Xiong.ea.2017)和ELMo(Embeddings from Language Models,来自语言模型的嵌入) (Peters.Neumann.Iyyer.ea.2018)。
例如,通过将整个序列作为输入,ELMo是为输入序列中的每个单词分配一个表示的函数。具体来说,ELMo将来自预训练的双向长短期记忆网络的所有中间层表示组合为输出表示。然后,ELMo的表示将作为附加特征添加到下游任务的现有监督模型中,例如通过将ELMo的表示和现有模型中词元的原始表示(例如GloVe)连结起来。一方面,在加入ELMo表示后,冻结了预训练的双向LSTM模型中的所有权重。另一方面,现有的监督模型是专门为给定的任务定制的。利用当时不同任务的不同最佳模型,添加ELMo改进了六种自然语言处理任务的技术水平:情感分析、自然语言推断、语义角色标注、共指消解、命名实体识别和问答。
从特定于任务到不可知任务
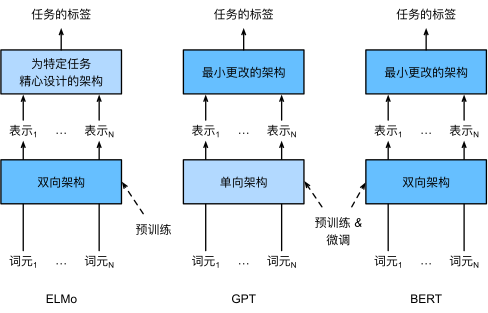
尽管ELMo显著改进了各种自然语言处理任务的解决方案,但每个解决方案仍然依赖于一个特定于任务的架构。然而,为每一个自然语言处理任务设计一个特定的架构实际上并不是一件容易的事。GPT(Generative Pre Training,生成式预训练)模型为上下文的敏感表示设计了通用的任务无关模型 (Radford.Narasimhan.Salimans.ea.2018)。GPT建立在Transformer解码器的基础上,预训练了一个用于表示文本序列的语言模型。当将GPT应用于下游任务时,语言模型的输出将被送到一个附加的线性输出层,以预测任务的标签。与ELMo冻结预训练模型的参数不同,GPT在下游任务的监督学习过程中对预训练Transformer解码器中的所有参数进行微调。GPT在自然语言推断、问答、句子相似性和分类等12项任务上进行了评估,并在对模型架构进行最小更改的情况下改善了其中9项任务的最新水平。
然而,由于语言模型的自回归特性,GPT只能向前看(从左到右)。在“i went to the bank to deposit cash”(我去银行存现金)和“i went to the bank to sit down”(我去河岸边坐下)的上下文中,由于“bank”对其左边的上下文敏感,GPT将返回“bank”的相同表示,尽管它有不同的含义。
BERT:把两个最好的结合起来
如我们所见,ELMo对上下文进行双向编码,但使用特定于任务的架构;而GPT是任务无关的,但是从左到右编码上下文。BERT(来自Transformers的双向编码器表示)结合了这两个方面的优点。它对上下文进行双向编码,并且对于大多数的自然语言处理任务 (Devlin.Chang.Lee.ea.2018)只需要最少的架构改变。通过使用预训练的Transformer编码器,BERT能够基于其双向上下文表示任何词元。在下游任务的监督学习过程中,BERT在两个方面与GPT相似。首先,BERT表示将被输入到一个添加的输出层中,根据任务的性质对模型架构进行最小的更改,例如预测每个词元与预测整个序列。其次,对预训练Transformer编码器的所有参数进行微调,而额外的输出层将从头开始训练。 :numref:fig_elmo-gpt-bert 描述了ELMo、GPT和BERT之间的差异。
BERT进一步改进了11种自然语言处理任务的技术水平,这些任务分为以下几个大类:(1)单一文本分类(如情感分析)、(2)文本对分类(如自然语言推断)、(3)问答、(4)文本标记(如命名实体识别)。从上下文敏感的ELMo到任务不可知的GPT和BERT,它们都是在2018年提出的。概念上简单但经验上强大的自然语言深度表示预训练已经彻底改变了各种自然语言处理任务的解决方案。
在本章的其余部分,我们将深入了解BERT的训练前准备。当在 :numref:chap_nlp_app中解释自然语言处理应用时,我们将说明针对下游应用的BERT微调。
from d2l import torch as d2l
import torch
from torch import nn
输入表示
在自然语言处理中,有些任务(如情感分析)以单个文本作为输入,而有些任务(如自然语言推断)以一对文本序列作为输入。BERT输入序列明确地表示单个文本和文本对。当输入为单个文本时,BERT输入序列是特殊类别词元“<cls>”、文本序列的标记、以及特殊分隔词元“<sep>”的连结。当输入为文本对时,BERT输入序列是“<cls>”、第一个文本序列的标记、“<sep>”、第二个文本序列标记、以及“<sep>”的连结。我们将始终如一地将术语“BERT输入序列”与其他类型的“序列”区分开来。例如,一个BERT输入序列可以包括一个文本序列或两个文本序列。
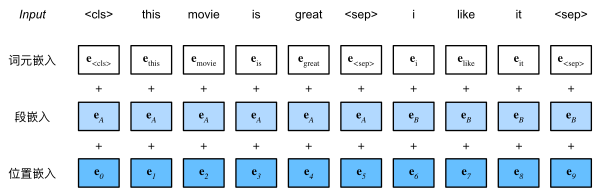
为了区分文本对,根据输入序列学到的片段嵌入和分别被添加到第一序列和第二序列的词元嵌入中。对于单文本输入,仅使用。
下面的get_tokens_and_segments将一个句子或两个句子作为输入,然后返回BERT输入序列的标记及其相应的片段索引。
BERT选择Transformer编码器作为其双向架构。在Transformer编码器中常见是,位置嵌入被加入到输入序列的每个位置。然而,与原始的Transformer编码器不同,BERT使用可学习的位置嵌入。总之,
:numref:fig_bert-input表明BERT输入序列的嵌入是词元嵌入、片段嵌入和位置嵌入的和。
下面的BERTEncoder类类似于 :numref:sec_transformer中实现的TransformerEncoder类。与TransformerEncoder不同,BERTEncoder使用片段嵌入和可学习的位置嵌入。
#@save
class BERTEncoder(nn.Module):
    """BERT编码器"""
    def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
                 ffn_num_hiddens, num_heads, num_layers, dropout,
                 max_len=1000, key_size=768, query_size=768, value_size=768,
                 **kwargs):
        super(BERTEncoder, self).__init__(**kwargs)
        self.token_embedding = nn.Embedding(vocab_size, num_hiddens)
        self.segment_embedding = nn.Embedding(2, num_hiddens)
        self.blks = nn.Sequential()
        for i in range(num_layers):
            self.blks.add_module(f"{i}", d2l.EncoderBlock(
                key_size, query_size, value_size, num_hiddens, norm_shape,
                ffn_num_input, ffn_num_hiddens, num_heads, dropout, True))
        # 在BERT中,位置嵌入是可学习的,因此我们创建一个足够长的位置嵌入参数
        self.pos_embedding = nn.Parameter(torch.randn(1, max_len,
                                                      num_hiddens))

    def forward(self, tokens, segments, valid_lens):
        # 在以下代码段中,X的形状保持不变:(批量大小,最大序列长度,num_hiddens)
        X = self.token_embedding(tokens) + self.segment_embedding(segments)
        X = X + self.pos_embedding.data[:, :X.shape[1], :]
        for blk in self.blks:
            X = blk(X, valid_lens)
return X假设词表大小为10000,为了演示BERTEncoder的前向推断,让我们创建一个实例并初始化它的参数。
, paddle
vocab_size, num_hiddens, ffn_num_hiddens, num_heads = 10000, 768, 1024, 4
norm_shape, ffn_num_input, num_layers, dropout = [768], 768, 2, 0.2
encoder = BERTEncoder(vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout)我们将tokens定义为长度为8的2个输入序列,其中每个词元是词表的索引。使用输入tokens的BERTEncoder的前向推断返回编码结果,其中每个词元由向量表示,其长度由超参数num_hiddens定义。此超参数通常称为Transformer编码器的隐藏大小(隐藏单元数)。
tokens = torch.randint(0, vocab_size, (2, 8))
segments = torch.tensor([[0, 0, 0, 0, 1, 1, 1, 1], [0, 0, 0, 1, 1, 1, 1, 1]])
encoded_X = encoder(tokens, segments, None)
encoded_X.shape
预训练任务
BERTEncoder的前向推断给出了输入文本的每个词元和插入的特殊标记“<cls>”及“<seq>”的BERT表示。接下来,我们将使用这些表示来计算预训练BERT的损失函数。预训练包括以下两个任务:掩蔽语言模型和下一句预测。
掩蔽语言模型(Masked Language Modeling)
如 :numref:sec_language_model所示,语言模型使用左侧的上下文预测词元。为了双向编码上下文以表示每个词元,BERT随机掩蔽词元并使用来自双向上下文的词元以自监督的方式预测掩蔽词元。此任务称为掩蔽语言模型。
在这个预训练任务中,将随机选择15%的词元作为预测的掩蔽词元。要预测一个掩蔽词元而不使用标签作弊,一个简单的方法是总是用一个特殊的“<mask>”替换输入序列中的词元。然而,人造特殊词元“<mask>”不会出现在微调中。为了避免预训练和微调之间的这种不匹配,如果为预测而屏蔽词元(例如,在“this movie is great”中选择掩蔽和预测“great”),则在输入中将其替换为:
- 80%时间为特殊的“<mask>“词元(例如,“this movie is great”变为“this movie is<mask>”;
- 10%时间为随机词元(例如,“this movie is great”变为“this movie is drink”);
- 10%时间内为不变的标签词元(例如,“this movie is great”变为“this movie is great”)。
请注意,在15%的时间中,有10%的时间插入了随机词元。这种偶然的噪声鼓励BERT在其双向上下文编码中不那么偏向于掩蔽词元(尤其是当标签词元保持不变时)。
我们实现了下面的MaskLM类来预测BERT预训练的掩蔽语言模型任务中的掩蔽标记。预测使用单隐藏层的多层感知机(self.mlp)。在前向推断中,它需要两个输入:BERTEncoder的编码结果和用于预测的词元位置。输出是这些位置的预测结果。
#@save
class MaskLM(nn.Module):
    """BERT的掩蔽语言模型任务"""
    def __init__(self, vocab_size, num_hiddens, num_inputs=768, **kwargs):
        super(MaskLM, self).__init__(**kwargs)
        self.mlp = nn.Sequential(nn.Linear(num_inputs, num_hiddens),
                                 nn.ReLU(),
                                 nn.LayerNorm(num_hiddens),
                                 nn.Linear(num_hiddens, vocab_size))

    def forward(self, X, pred_positions):
        num_pred_positions = pred_positions.shape[1]
        pred_positions = pred_positions.reshape(-1)
        batch_size = X.shape[0]
        batch_idx = torch.arange(0, batch_size)
        # 假设batch_size=2,num_pred_positions=3
        # 那么batch_idx是np.array([0,0,0,1,1,1])
        batch_idx = torch.repeat_interleave(batch_idx, num_pred_positions)
        masked_X = X[batch_idx, pred_positions]
        masked_X = masked_X.reshape((batch_size, num_pred_positions, -1))
        mlm_Y_hat = self.mlp(masked_X)
return mlm_Y_hat为了演示MaskLM的前向推断,我们创建了其实例mlm并对其进行了初始化。回想一下,来自BERTEncoder的正向推断encoded_X表示2个BERT输入序列。我们将mlm_positions定义为在encoded_X的任一输入序列中预测的3个指示。mlm的前向推断返回encoded_X的所有掩蔽位置mlm_positions处的预测结果mlm_Y_hat。对于每个预测,结果的大小等于词表的大小。
mlm = MaskLM(vocab_size, num_hiddens)
mlm_positions = torch.tensor([[1, 5, 2], [6, 1, 5]])
mlm_Y_hat = mlm(encoded_X, mlm_positions)
mlm_Y_hat.shape通过掩码下的预测词元mlm_Y的真实标签mlm_Y_hat,我们可以计算在BERT预训练中的遮蔽语言模型任务的交叉熵损失。
mlm_Y = torch.tensor([[7, 8, 9], [10, 20, 30]])
loss = nn.CrossEntropyLoss(reduction='none')
mlm_l = loss(mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y.reshape(-1))
mlm_l.shape
下一句预测(Next Sentence Prediction)
尽管掩蔽语言建模能够编码双向上下文来表示单词,但它不能显式地建模文本对之间的逻辑关系。为了帮助理解两个文本序列之间的关系,BERT在预训练中考虑了一个二元分类任务——下一句预测。在为预训练生成句子对时,有一半的时间它们确实是标签为“真”的连续句子;在另一半的时间里,第二个句子是从语料库中随机抽取的,标记为“假”。
下面的NextSentencePred类使用单隐藏层的多层感知机来预测第二个句子是否是BERT输入序列中第一个句子的下一个句子。由于Transformer编码器中的自注意力,特殊词元“<cls>”的BERT表示已经对输入的两个句子进行了编码。因此,多层感知机分类器的输出层(self.output)以X作为输入,其中X是多层感知机隐藏层的输出,而MLP隐藏层的输入是编码后的“<cls>”词元。
#@save
class NextSentencePred(nn.Module):
    """BERT的下一句预测任务"""
    def __init__(self, num_inputs, **kwargs):
        super(NextSentencePred, self).__init__(**kwargs)
        self.output = nn.Linear(num_inputs, 2)

    def forward(self, X):
        # X的形状:(batchsize,num_hiddens)
return self.output(X)我们可以看到,NextSentencePred实例的前向推断返回每个BERT输入序列的二分类预测。
encoded_X = torch.flatten(encoded_X, start_dim=1)
# NSP的输入形状:(batchsize,num_hiddens)
nsp = NextSentencePred(encoded_X.shape[-1])
nsp_Y_hat = nsp(encoded_X)
nsp_Y_hat.shape
还可以计算两个二元分类的交叉熵损失。
nsp_y = torch.tensor([0, 1])
nsp_l = loss(nsp_Y_hat, nsp_y)
nsp_l.shape
值得注意的是,上述两个预训练任务中的所有标签都可以从预训练语料库中获得,而无需人工标注。原始的BERT已经在图书语料库 (Zhu.Kiros.Zemel.ea.2015)和英文维基百科的连接上进行了预训练。这两个文本语料库非常庞大:它们分别有8亿个单词和25亿个单词。
整合代码
在预训练BERT时,最终的损失函数是掩蔽语言模型损失函数和下一句预测损失函数的线性组合。现在我们可以通过实例化三个类BERTEncoder、MaskLM和NextSentencePred来定义BERTModel类。前向推断返回编码后的BERT表示encoded_X、掩蔽语言模型预测mlm_Y_hat和下一句预测nsp_Y_hat。
#@save
class BERTModel(nn.Module):
    """BERT模型"""
    def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
                 ffn_num_hiddens, num_heads, num_layers, dropout,
                 max_len=1000, key_size=768, query_size=768, value_size=768,
                 hid_in_features=768, mlm_in_features=768,
                 nsp_in_features=768):
        super(BERTModel, self).__init__()
        self.encoder = BERTEncoder(vocab_size, num_hiddens, norm_shape,
                    ffn_num_input, ffn_num_hiddens, num_heads, num_layers,
                    dropout, max_len=max_len, key_size=key_size,
                    query_size=query_size, value_size=value_size)
        self.hidden = nn.Sequential(nn.Linear(hid_in_features, num_hiddens),
                                    nn.Tanh())
        self.mlm = MaskLM(vocab_size, num_hiddens, mlm_in_features)
        self.nsp = NextSentencePred(nsp_in_features)

    def forward(self, tokens, segments, valid_lens=None,
                pred_positions=None):
        encoded_X = self.encoder(tokens, segments, valid_lens)
        if pred_positions is not None:
            mlm_Y_hat = self.mlm(encoded_X, pred_positions)
        else:
            mlm_Y_hat = None
        # 用于下一句预测的多层感知机分类器的隐藏层,0是“<cls>”标记的索引
        nsp_Y_hat = self.nsp(self.hidden(encoded_X[:, 0, :]))
        return encoded_X, mlm_Y_hat, nsp_Y_hat
小结
- word2vec和GloVe等词嵌入模型与上下文无关。它们将相同的预训练向量赋给同一个词,而不考虑词的上下文(如果有的话)。它们很难处理好自然语言中的一词多义或复杂语义。
- 对于上下文敏感的词表示,如ELMo和GPT,词的表示依赖于它们的上下文。
- ELMo对上下文进行双向编码,但使用特定于任务的架构(然而,为每个自然语言处理任务设计一个特定的体系架构实际上并不容易);而GPT是任务无关的,但是从左到右编码上下文。
- BERT结合了这两个方面的优点:它对上下文进行双向编码,并且需要对大量自然语言处理任务进行最小的架构更改。
- BERT输入序列的嵌入是词元嵌入、片段嵌入和位置嵌入的和。
- 预训练包括两个任务:掩蔽语言模型和下一句预测。前者能够编码双向上下文来表示单词,而后者则显式地建模文本对之间的逻辑关系。
练习
- 为什么BERT成功了?
- 在所有其他条件相同的情况下,掩蔽语言模型比从左到右的语言模型需要更多或更少的预训练步骤来收敛吗?为什么?
- 在BERT的原始实现中,
BERTEncoder中的位置前馈网络(通过d2l.EncoderBlock)和MaskLM中的全连接层都使用高斯误差线性单元(Gaussian error linear unit,GELU) (Hendrycks.Gimpel.2016)作为激活函数。研究GELU与ReLU之间的差异。
用于预训练BERT的数据集
为了预训练 :numref:sec_bert中实现的BERT模型,我们需要以理想的格式生成数据集,以便于两个预训练任务:遮蔽语言模型和下一句预测。一方面,最初的BERT模型是在两个庞大的图书语料库和英语维基百科(参见 :numref:subsec_bert_pretraining_tasks)的合集上预训练的,但它很难吸引这本书的大多数读者。另一方面,现成的预训练BERT模型可能不适合医学等特定领域的应用。因此,在定制的数据集上对BERT进行预训练变得越来越流行。为了方便BERT预训练的演示,我们使用了较小的语料库WikiText-2 (Merity.Xiong.Bradbury.ea.2016)。
与 :numref:sec_word2vec_data中用于预训练word2vec的PTB数据集相比,WikiText-2(1)保留了原来的标点符号,适合于下一句预测;(2)保留了原来的大小写和数字;(3)大了一倍以上。
from d2l import torch as d2l
import os
import random
import torch
在WikiText-2数据集中,每行代表一个段落,其中在任意标点符号及其前面的词元之间插入空格。保留至少有两句话的段落。为了简单起见,我们仅使用句号作为分隔符来拆分句子。我们将更复杂的句子拆分技术的讨论留在本节末尾的练习中。
为预训练任务定义辅助函数
在下文中,我们首先为BERT的两个预训练任务实现辅助函数。这些辅助函数将在稍后将原始文本语料库转换为理想格式的数据集时调用,以预训练BERT。
生成下一句预测任务的数据
根据 :numref:subsec_nsp的描述,_get_next_sentence函数生成二分类任务的训练样本。
下面的函数通过调用_get_next_sentence函数从输入paragraph生成用于下一句预测的训练样本。这里paragraph是句子列表,其中每个句子都是词元列表。自变量max_len指定预训练期间的BERT输入序列的最大长度。
生成遮蔽语言模型任务的数据
为了从BERT输入序列生成遮蔽语言模型的训练样本,我们定义了以下_replace_mlm_tokens函数。在其输入中,tokens是表示BERT输入序列的词元的列表,candidate_pred_positions是不包括特殊词元的BERT输入序列的词元索引的列表(特殊词元在遮蔽语言模型任务中不被预测),以及num_mlm_preds指示预测的数量(选择15%要预测的随机词元)。在 :numref:subsec_mlm中定义遮蔽语言模型任务之后,在每个预测位置,输入可以由特殊的“掩码”词元或随机词元替换,或者保持不变。最后,该函数返回可能替换后的输入词元、发生预测的词元索引和这些预测的标签。
通过调用前述的_replace_mlm_tokens函数,以下函数将BERT输入序列(tokens)作为输入,并返回输入词元的索引(在 :numref:subsec_mlm中描述的可能的词元替换之后)、发生预测的词元索引以及这些预测的标签索引。
将文本转换为预训练数据集
现在我们几乎准备好为BERT预训练定制一个Dataset类。在此之前,我们仍然需要定义辅助函数_pad_bert_inputs来将特殊的“<mask>”词元附加到输入。它的参数examples包含来自两个预训练任务的辅助函数_get_nsp_data_from_paragraph和_get_mlm_data_from_tokens的输出。
#@save
def _pad_bert_inputs(examples, max_len, vocab):
    max_num_mlm_preds = round(max_len * 0.15)
    all_token_ids, all_segments, valid_lens,  = [], [], []
    all_pred_positions, all_mlm_weights, all_mlm_labels = [], [], []
    nsp_labels = []
    for (token_ids, pred_positions, mlm_pred_label_ids, segments,
         is_next) in examples:
        all_token_ids.append(torch.tensor(token_ids + [vocab['<pad>']] * (
            max_len - len(token_ids)), dtype=torch.long))
        all_segments.append(torch.tensor(segments + [0] * (
            max_len - len(segments)), dtype=torch.long))
        # valid_lens不包括'<pad>'的计数
        valid_lens.append(torch.tensor(len(token_ids), dtype=torch.float32))
        all_pred_positions.append(torch.tensor(pred_positions + [0] * (
            max_num_mlm_preds - len(pred_positions)), dtype=torch.long))
        # 填充词元的预测将通过乘以0权重在损失中过滤掉
        all_mlm_weights.append(
            torch.tensor([1.0] * len(mlm_pred_label_ids) + [0.0] * (
                max_num_mlm_preds - len(pred_positions)),
                dtype=torch.float32))
        all_mlm_labels.append(torch.tensor(mlm_pred_label_ids + [0] * (
            max_num_mlm_preds - len(mlm_pred_label_ids)), dtype=torch.long))
        nsp_labels.append(torch.tensor(is_next, dtype=torch.long))
    return (all_token_ids, all_segments, valid_lens, all_pred_positions,
all_mlm_weights, all_mlm_labels, nsp_labels)将用于生成两个预训练任务的训练样本的辅助函数和用于填充输入的辅助函数放在一起,我们定义以下_WikiTextDataset类为用于预训练BERT的WikiText-2数据集。通过实现__getitem__函数,我们可以任意访问WikiText-2语料库的一对句子生成的预训练样本(遮蔽语言模型和下一句预测)样本。
最初的BERT模型使用词表大小为30000的WordPiece嵌入 (Wu.Schuster.Chen.ea.2016)。WordPiece的词元化方法是对 :numref:subsec_Byte_Pair_Encoding中原有的字节对编码算法稍作修改。为简单起见,我们使用d2l.tokenize函数进行词元化。出现次数少于5次的不频繁词元将被过滤掉。
#@save
class _WikiTextDataset(torch.utils.data.Dataset):
    def __init__(self, paragraphs, max_len):
        # 输入paragraphs[i]是代表段落的句子字符串列表;
        # 而输出paragraphs[i]是代表段落的句子列表,其中每个句子都是词元列表
        paragraphs = [d2l.tokenize(
            paragraph, token='word') for paragraph in paragraphs]
        sentences = [sentence for paragraph in paragraphs
                     for sentence in paragraph]
        self.vocab = d2l.Vocab(sentences, min_freq=5, reserved_tokens=[
            '<pad>', '<mask>', '<cls>', '<sep>'])
        # 获取下一句子预测任务的数据
        examples = []
        for paragraph in paragraphs:
            examples.extend(_get_nsp_data_from_paragraph(
                paragraph, paragraphs, self.vocab, max_len))
        # 获取遮蔽语言模型任务的数据
        examples = [(_get_mlm_data_from_tokens(tokens, self.vocab)
                      + (segments, is_next))
                     for tokens, segments, is_next in examples]
        # 填充输入
        (self.all_token_ids, self.all_segments, self.valid_lens,
         self.all_pred_positions, self.all_mlm_weights,
         self.all_mlm_labels, self.nsp_labels) = _pad_bert_inputs(
            examples, max_len, self.vocab)

    def __getitem__(self, idx):
        return (self.all_token_ids[idx], self.all_segments[idx],
                self.valid_lens[idx], self.all_pred_positions[idx],
                self.all_mlm_weights[idx], self.all_mlm_labels[idx],
                self.nsp_labels[idx])

    def __len__(self):
return len(self.all_token_ids)通过使用_read_wiki函数和_WikiTextDataset类,我们定义了下面的load_data_wiki来下载并生成WikiText-2数据集,并从中生成预训练样本。
#@save
def load_data_wiki(batch_size, max_len):
    """加载WikiText-2数据集"""
    num_workers = d2l.get_dataloader_workers()
    data_dir = d2l.download_extract('wikitext-2', 'wikitext-2')
    paragraphs = _read_wiki(data_dir)
    train_set = _WikiTextDataset(paragraphs, max_len)
    train_iter = torch.utils.data.DataLoader(train_set, batch_size,
                                        shuffle=True, num_workers=num_workers)
return train_iter, train_set.vocab将批量大小设置为512,将BERT输入序列的最大长度设置为64,我们打印出小批量的BERT预训练样本的形状。注意,在每个BERT输入序列中,为遮蔽语言模型任务预测()个位置。
最后,我们来看一下词量。即使在过滤掉不频繁的词元之后,它仍然比PTB数据集的大两倍以上。
小结
- 与PTB数据集相比,WikiText-2数据集保留了原来的标点符号、大小写和数字,并且比PTB数据集大了两倍多。
- 我们可以任意访问从WikiText-2语料库中的一对句子生成的预训练(遮蔽语言模型和下一句预测)样本。
练习
- 为简单起见,句号用作拆分句子的唯一分隔符。尝试其他的句子拆分技术,比如Spacy和NLTK。以NLTK为例,需要先安装NLTK:
pip install nltk。在代码中先import nltk。然后下载Punkt语句词元分析器:nltk.download('punkt')。要拆分句子,比如sentences = 'This is great ! Why not ?',调用nltk.tokenize.sent_tokenize(sentences)将返回两个句子字符串的列表:['This is great !', 'Why not ?']。 - 如果我们不过滤出一些不常见的词元,词量会有多大?
预训练BERT
利用 :numref:sec_bert中实现的BERT模型和 :numref:sec_bert-dataset中从WikiText-2数据集生成的预训练样本,我们将在本节中在WikiText-2数据集上对BERT进行预训练。
from d2l import torch as d2l
import torch
from torch import nn
首先,我们加载WikiText-2数据集作为小批量的预训练样本,用于遮蔽语言模型和下一句预测。批量大小是512,BERT输入序列的最大长度是64。注意,在原始BERT模型中,最大长度是512。
预训练BERT
原始BERT (Devlin.Chang.Lee.ea.2018)有两个不同模型尺寸的版本。基本模型()使用12层(Transformer编码器块),768个隐藏单元(隐藏大小)和12个自注意头。大模型()使用24层,1024个隐藏单元和16个自注意头。值得注意的是,前者有1.1亿个参数,后者有3.4亿个参数。为了便于演示,我们定义了一个小的BERT,使用了2层、128个隐藏单元和2个自注意头。
, paddle
net = d2l.BERTModel(len(vocab), num_hiddens=128, norm_shape=[128],
                    ffn_num_input=128, ffn_num_hiddens=256, num_heads=2,
                    num_layers=2, dropout=0.2, key_size=128, query_size=128,
                    value_size=128, hid_in_features=128, mlm_in_features=128,
                    nsp_in_features=128)
devices = d2l.try_all_gpus()
loss = nn.CrossEntropyLoss()在定义训练代码实现之前,我们定义了一个辅助函数_get_batch_loss_bert。给定训练样本,该函数计算遮蔽语言模型和下一句子预测任务的损失。请注意,BERT预训练的最终损失是遮蔽语言模型损失和下一句预测损失的和。
#@save
def _get_batch_loss_bert(net, loss, vocab_size, tokens_X,
                         segments_X, valid_lens_x,
                         pred_positions_X, mlm_weights_X,
                         mlm_Y, nsp_y):
    # 前向传播
    _, mlm_Y_hat, nsp_Y_hat = net(tokens_X, segments_X,
                                  valid_lens_x.reshape(-1),
                                  pred_positions_X)
    # 计算遮蔽语言模型损失
    mlm_l = loss(mlm_Y_hat.reshape(-1, vocab_size), mlm_Y.reshape(-1)) *\
    mlm_weights_X.reshape(-1, 1)
    mlm_l = mlm_l.sum() / (mlm_weights_X.sum() + 1e-8)
    # 计算下一句子预测任务的损失
    nsp_l = loss(nsp_Y_hat, nsp_y)
    l = mlm_l + nsp_l
return mlm_l, nsp_l, l通过调用上述两个辅助函数,下面的train_bert函数定义了在WikiText-2(train_iter)数据集上预训练BERT(net)的过程。训练BERT可能需要很长时间。以下函数的输入num_steps指定了训练的迭代步数,而不是像train_ch13函数那样指定训练的轮数(参见 :numref:sec_image_augmentation)。
def train_bert(train_iter, net, loss, vocab_size, devices, num_steps):
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    trainer = torch.optim.Adam(net.parameters(), lr=0.01)
    step, timer = 0, d2l.Timer()
    animator = d2l.Animator(xlabel='step', ylabel='loss',
                            xlim=[1, num_steps], legend=['mlm', 'nsp'])
    # 遮蔽语言模型损失的和,下一句预测任务损失的和,句子对的数量,计数
    metric = d2l.Accumulator(4)
    num_steps_reached = False
    while step < num_steps and not num_steps_reached:
        for tokens_X, segments_X, valid_lens_x, pred_positions_X,\
            mlm_weights_X, mlm_Y, nsp_y in train_iter:
            tokens_X = tokens_X.to(devices[0])
            segments_X = segments_X.to(devices[0])
            valid_lens_x = valid_lens_x.to(devices[0])
            pred_positions_X = pred_positions_X.to(devices[0])
            mlm_weights_X = mlm_weights_X.to(devices[0])
            mlm_Y, nsp_y = mlm_Y.to(devices[0]), nsp_y.to(devices[0])
            trainer.zero_grad()
            timer.start()
            mlm_l, nsp_l, l = _get_batch_loss_bert(
                net, loss, vocab_size, tokens_X, segments_X, valid_lens_x,
                pred_positions_X, mlm_weights_X, mlm_Y, nsp_y)
            l.backward()
            trainer.step()
            metric.add(mlm_l, nsp_l, tokens_X.shape[0], 1)
            timer.stop()
            animator.add(step + 1,
                         (metric[0] / metric[3], metric[1] / metric[3]))
            step += 1
            if step == num_steps:
                num_steps_reached = True
                break

    print(f'MLM loss {metric[0] / metric[3]:.3f}, '
          f'NSP loss {metric[1] / metric[3]:.3f}')
    print(f'{metric[2] / timer.sum():.1f} sentence pairs/sec on '
          f'{str(devices)}')
在预训练过程中,我们可以绘制出遮蔽语言模型损失和下一句预测损失。
用BERT表示文本
在预训练BERT之后,我们可以用它来表示单个文本、文本对或其中的任何词元。下面的函数返回tokens_a和tokens_b中所有词元的BERT(net)表示。
def get_bert_encoding(net, tokens_a, tokens_b=None):
    tokens, segments = d2l.get_tokens_and_segments(tokens_a, tokens_b)
    token_ids = torch.tensor(vocab[tokens], device=devices[0]).unsqueeze(0)
    segments = torch.tensor(segments, device=devices[0]).unsqueeze(0)
    valid_len = torch.tensor(len(tokens), device=devices[0]).unsqueeze(0)
    encoded_X, _, _ = net(token_ids, segments, valid_len)
    return encoded_X
考虑“a crane is flying”这句话。回想一下 :numref:subsec_bert_input_rep中讨论的BERT的输入表示。插入特殊标记“<cls>”(用于分类)和“<sep>”(用于分隔)后,BERT输入序列的长度为6。因为零是“<cls>”词元,encoded_text[:, 0, :]是整个输入语句的BERT表示。为了评估一词多义词元“crane”,我们还打印出了该词元的BERT表示的前三个元素。
现在考虑一个句子“a crane driver came”和“he just left”。类似地,encoded_pair[:, 0, :]是来自预训练BERT的整个句子对的编码结果。注意,多义词元“crane”的前三个元素与上下文不同时的元素不同。这支持了BERT表示是上下文敏感的。
在 :numref:chap_nlp_app中,我们将为下游自然语言处理应用微调预训练的BERT模型。
小结
- 原始的BERT有两个版本,其中基本模型有1.1亿个参数,大模型有3.4亿个参数。
- 在预训练BERT之后,我们可以用它来表示单个文本、文本对或其中的任何词元。
- 在实验中,同一个词元在不同的上下文中具有不同的BERT表示。这支持BERT表示是上下文敏感的。
练习
- 在实验中,我们可以看到遮蔽语言模型损失明显高于下一句预测损失。为什么?
- 将BERT输入序列的最大长度设置为512(与原始BERT模型相同)。使用原始BERT模型的配置,如。运行此部分时是否遇到错误?为什么?