16 / 19
计算机视觉
近年来,深度学习一直是提高计算机视觉系统性能的变革力量。
无论是医疗诊断、自动驾驶,还是智能滤波器、摄像头监控,许多计算机视觉领域的应用都与我们当前和未来的生活密切相关。
可以说,最先进的计算机视觉应用与深度学习几乎是不可分割的。
有鉴于此,本章将重点介绍计算机视觉领域,并探讨最近在学术界和行业中具有影响力的方法和应用。
在 :numref:chap_cnn和 :numref:chap_modern_cnn中,我们研究了计算机视觉中常用的各种卷积神经网络,并将它们应用到简单的图像分类任务中。
本章开头,我们将介绍两种可以改进模型泛化的方法,即图像增广和微调,并将它们应用于图像分类。
由于深度神经网络可以有效地表示多个层次的图像,因此这种分层表示已成功用于各种计算机视觉任务,例如目标检测(object detection)、语义分割(semantic segmentation)和样式迁移(style transfer)。
秉承计算机视觉中利用分层表示的关键思想,我们将从物体检测的主要组件和技术开始,继而展示如何使用完全卷积网络对图像进行语义分割,然后我们将解释如何使用样式迁移技术来生成像本书封面一样的图像。
最后在结束本章时,我们将本章和前几章的知识应用于两个流行的计算机视觉基准数据集。
:maxdepth: 2

image-augmentation
fine-tuning
bounding-box
anchor
multiscale-object-detection
object-detection-dataset
ssd
rcnn
semantic-segmentation-and-dataset
transposed-conv
fcn
neural-style
kaggle-cifar10
kaggle-dog
图像增广
:numref:sec_alexnet提到过大型数据集是成功应用深度神经网络的先决条件。
图像增广在对训练图像进行一系列的随机变化之后,生成相似但不同的训练样本,从而扩大了训练集的规模。
此外,应用图像增广的原因是,随机改变训练样本可以减少模型对某些属性的依赖,从而提高模型的泛化能力。
例如,我们可以以不同的方式裁剪图像,使感兴趣的对象出现在不同的位置,减少模型对于对象出现位置的依赖。
我们还可以调整亮度、颜色等因素来降低模型对颜色的敏感度。
可以说,图像增广技术对于AlexNet的成功是必不可少的。本节将讨论这项广泛应用于计算机视觉的技术。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
常用的图像增广方法
在对常用图像增广方法的探索时,我们将使用下面这个尺寸为的图像作为示例。
, paddle
d2l.set_figsize()
img = d2l.Image.open('../img/cat1.jpg')
d2l.plt.imshow(img);大多数图像增广方法都具有一定的随机性。为了便于观察图像增广的效果,我们下面定义辅助函数apply。
此函数在输入图像img上多次运行图像增广方法aug并显示所有结果。
翻转和裁剪
[左右翻转图像]通常不会改变对象的类别。这是最早且最广泛使用的图像增广方法之一。
接下来,我们使用transforms模块来创建RandomFlipLeftRight实例,这样就各有50%的几率使图像向左或向右翻转。
apply(img, torchvision.transforms.RandomHorizontalFlip())[上下翻转图像]不如左右图像翻转那样常用。但是,至少对于这个示例图像,上下翻转不会妨碍识别。接下来,我们创建一个RandomFlipTopBottom实例,使图像各有50%的几率向上或向下翻转。
apply(img, torchvision.transforms.RandomVerticalFlip())在我们使用的示例图像中,猫位于图像的中间,但并非所有图像都是这样。
在 :numref:sec_pooling中,我们解释了汇聚层可以降低卷积层对目标位置的敏感性。
另外,我们可以通过对图像进行随机裁剪,使物体以不同的比例出现在图像的不同位置。
这也可以降低模型对目标位置的敏感性。
下面的代码将[随机裁剪]一个面积为原始面积10%到100%的区域,该区域的宽高比从0.5~2之间随机取值。
然后,区域的宽度和高度都被缩放到200像素。
在本节中(除非另有说明),和之间的随机数指的是在区间中通过均匀采样获得的连续值。
shape_aug = torchvision.transforms.RandomResizedCrop(
    (200, 200), scale=(0.1, 1), ratio=(0.5, 2))
apply(img, shape_aug)
改变颜色
另一种增广方法是改变颜色。
我们可以改变图像颜色的四个方面:亮度、对比度、饱和度和色调。
在下面的示例中,我们[随机更改图像的亮度],随机值为原始图像的50%()到150%()之间。
apply(img, torchvision.transforms.ColorJitter(
brightness=0.5, contrast=0, saturation=0, hue=0))同样,我们可以[随机更改图像的色调]。
apply(img, torchvision.transforms.ColorJitter(
brightness=0, contrast=0, saturation=0, hue=0.5))我们还可以创建一个RandomColorJitter实例,并设置如何同时[随机更改图像的亮度(brightness)、对比度(contrast)、饱和度(saturation)和色调(hue)]。
color_aug = torchvision.transforms.ColorJitter(
    brightness=0.5, contrast=0.5, saturation=0.5, hue=0.5)
apply(img, color_aug)[结合多种图像增广方法]
在实践中,我们将结合多种图像增广方法。比如,我们可以通过使用一个Compose实例来综合上面定义的不同的图像增广方法,并将它们应用到每个图像。
augs = torchvision.transforms.Compose([
    torchvision.transforms.RandomHorizontalFlip(), color_aug, shape_aug])
apply(img, augs)[使用图像增广进行训练]
让我们使用图像增广来训练模型。
这里,我们使用CIFAR-10数据集,而不是我们之前使用的Fashion-MNIST数据集。
这是因为Fashion-MNIST数据集中对象的位置和大小已被规范化,而CIFAR-10数据集中对象的颜色和大小差异更明显。
CIFAR-10数据集中的前32个训练图像如下所示。
all_images = torchvision.datasets.CIFAR10(train=True, root="../data",
                                          download=True)
d2l.show_images([all_images[i][0] for i in range(32)], 4, 8, scale=0.8);
为了在预测过程中得到确切的结果,我们通常对训练样本只进行图像增广,且在预测过程中不使用随机操作的图像增广。
在这里,我们[只使用最简单的随机左右翻转]。
此外,我们使用ToTensor实例将一批图像转换为深度学习框架所要求的格式,即形状为(批量大小,通道数,高度,宽度)的32位浮点数,取值范围为0~1。
train_augs = torchvision.transforms.Compose([
     torchvision.transforms.RandomHorizontalFlip(),
     torchvision.transforms.ToTensor()])

test_augs = torchvision.transforms.Compose([
torchvision.transforms.ToTensor()])接下来,我们[定义一个辅助函数,以便于读取图像和应用图像增广]。PyTorch数据集提供的transform参数应用图像增广来转化图像。有关DataLoader的详细介绍,请参阅 :numref:sec_fashion_mnist。
def load_cifar10(is_train, augs, batch_size):
    dataset = torchvision.datasets.CIFAR10(root="../data", train=is_train,
                                           transform=augs, download=True)
    dataloader = torch.utils.data.DataLoader(dataset, batch_size=batch_size,
                    shuffle=is_train, num_workers=d2l.get_dataloader_workers())
    return dataloader
多GPU训练
我们在CIFAR-10数据集上训练 :numref:sec_resnet中的ResNet-18模型。
回想一下 :numref:sec_multi_gpu_concise中对多GPU训练的介绍。
接下来,我们[定义一个函数,使用多GPU对模型进行训练和评估]。
#@save
def train_batch_ch13(net, X, y, loss, trainer, devices):
    """用多GPU进行小批量训练"""
    if isinstance(X, list):
        # 微调BERT中所需
        X = [x.to(devices[0]) for x in X]
    else:
        X = X.to(devices[0])
    y = y.to(devices[0])
    net.train()
    trainer.zero_grad()
    pred = net(X)
    l = loss(pred, y)
    l.sum().backward()
    trainer.step()
    train_loss_sum = l.sum()
    train_acc_sum = d2l.accuracy(pred, y)
    return train_loss_sum, train_acc_sum
#@save
def train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices=d2l.try_all_gpus()):
"""用多GPU进行模型训练"""
timer, num_batches = d2l.Timer(), len(train_iter)
animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs], ylim=[0, 1],
legend=['train loss', 'train acc', 'test acc'])
net = nn.DataParallel(net, device_ids=devices).to(devices[0])
for epoch in range(num_epochs):
# 4个维度:储存训练损失,训练准确度,实例数,特点数
metric = d2l.Accumulator(4)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = train_batch_ch13(
net, features, labels, loss, trainer, devices)
metric.add(l, acc, labels.shape[0], labels.numel())
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[3],
None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'loss {metric[0] / metric[2]:.3f}, train acc '
f'{metric[1] / metric[3]:.3f}, test acc {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} examples/sec on '
f'{str(devices)}')现在,我们可以[定义train_with_data_aug函数,使用图像增广来训练模型]。该函数获取所有的GPU,并使用Adam作为训练的优化算法,将图像增广应用于训练集,最后调用刚刚定义的用于训练和评估模型的train_ch13函数。
batch_size, devices, net = 256, d2l.try_all_gpus(), d2l.resnet18(10, 3)

def init_weights(m):
    if type(m) in [nn.Linear, nn.Conv2d]:
        nn.init.xavier_uniform_(m.weight)

net.apply(init_weights)

def train_with_data_aug(train_augs, test_augs, net, lr=0.001):
    train_iter = load_cifar10(True, train_augs, batch_size)
    test_iter = load_cifar10(False, test_augs, batch_size)
    loss = nn.CrossEntropyLoss(reduction="none")
    trainer = torch.optim.Adam(net.parameters(), lr=lr)
train_ch13(net, train_iter, test_iter, loss, trainer, 10, devices)让我们使用基于随机左右翻转的图像增广来[训练模型]。
小结
- 图像增广基于现有的训练数据生成随机图像,来提高模型的泛化能力。
- 为了在预测过程中得到确切的结果,我们通常对训练样本只进行图像增广,而在预测过程中不使用带随机操作的图像增广。
- 深度学习框架提供了许多不同的图像增广方法,这些方法可以被同时应用。
练习
- 在不使用图像增广的情况下训练模型:
train_with_data_aug(no_aug, no_aug)。比较使用和不使用图像增广的训练结果和测试精度。这个对比实验能支持图像增广可以减轻过拟合的论点吗?为什么? - 在基于CIFAR-10数据集的模型训练中结合多种不同的图像增广方法。它能提高测试准确性吗?
- 参阅深度学习框架的在线文档。它还提供了哪些其他的图像增广方法?
微调
前面的一些章节介绍了如何在只有6万张图像的Fashion-MNIST训练数据集上训练模型。
我们还描述了学术界当下使用最广泛的大规模图像数据集ImageNet,它有超过1000万的图像和1000类的物体。
然而,我们平常接触到的数据集的规模通常在这两者之间。
假如我们想识别图片中不同类型的椅子,然后向用户推荐购买链接。
一种可能的方法是首先识别100把普通椅子,为每把椅子拍摄1000张不同角度的图像,然后在收集的图像数据集上训练一个分类模型。
尽管这个椅子数据集可能大于Fashion-MNIST数据集,但实例数量仍然不到ImageNet中的十分之一。
适合ImageNet的复杂模型可能会在这个椅子数据集上过拟合。
此外,由于训练样本数量有限,训练模型的准确性可能无法满足实际要求。
为了解决上述问题,一个显而易见的解决方案是收集更多的数据。
但是,收集和标记数据可能需要大量的时间和金钱。
例如,为了收集ImageNet数据集,研究人员花费了数百万美元的研究资金。
尽管目前的数据收集成本已大幅降低,但这一成本仍不能忽视。
另一种解决方案是应用迁移学习(transfer learning)将从源数据集学到的知识迁移到目标数据集。
例如,尽管ImageNet数据集中的大多数图像与椅子无关,但在此数据集上训练的模型可能会提取更通用的图像特征,这有助于识别边缘、纹理、形状和对象组合。
这些类似的特征也可能有效地识别椅子。
步骤
本节将介绍迁移学习中的常见技巧:微调(fine-tuning)。如 :numref:fig_finetune所示,微调包括以下四个步骤。
- 在源数据集(例如ImageNet数据集)上预训练神经网络模型,即源模型。
- 创建一个新的神经网络模型,即目标模型。这将复制源模型上的所有模型设计及其参数(输出层除外)。我们假定这些模型参数包含从源数据集中学到的知识,这些知识也将适用于目标数据集。我们还假设源模型的输出层与源数据集的标签密切相关;因此不在目标模型中使用该层。
- 向目标模型添加输出层,其输出数是目标数据集中的类别数。然后随机初始化该层的模型参数。
- 在目标数据集(如椅子数据集)上训练目标模型。输出层将从头开始进行训练,而所有其他层的参数将根据源模型的参数进行微调。
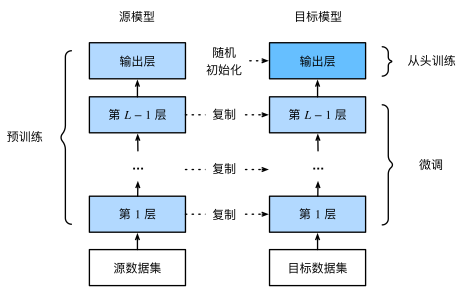
当目标数据集比源数据集小得多时,微调有助于提高模型的泛化能力。
热狗识别
让我们通过具体案例演示微调:热狗识别。
我们将在一个小型数据集上微调ResNet模型。该模型已在ImageNet数据集上进行了预训练。
这个小型数据集包含数千张包含热狗和不包含热狗的图像,我们将使用微调模型来识别图像中是否包含热狗。
%matplotlib inline
from d2l import torch as d2l
from torch import nn
import torch
import torchvision
import os
获取数据集
我们使用的[热狗数据集来源于网络]。
该数据集包含1400张热狗的“正类”图像,以及包含尽可能多的其他食物的“负类”图像。
含着两个类别的1000张图片用于训练,其余的则用于测试。
解压下载的数据集,我们获得了两个文件夹hotdog/train和hotdog/test。
这两个文件夹都有hotdog(有热狗)和not-hotdog(无热狗)两个子文件夹,
子文件夹内都包含相应类的图像。
我们创建两个实例来分别读取训练和测试数据集中的所有图像文件。
train_imgs = torchvision.datasets.ImageFolder(os.path.join(data_dir, 'train'))
test_imgs = torchvision.datasets.ImageFolder(os.path.join(data_dir, 'test'))下面显示了前8个正类样本图片和最后8张负类样本图片。正如所看到的,[图像的大小和纵横比各有不同]。
在训练期间,我们首先从图像中裁切随机大小和随机长宽比的区域,然后将该区域缩放为输入图像。
在测试过程中,我们将图像的高度和宽度都缩放到256像素,然后裁剪中央区域作为输入。
此外,对于RGB(红、绿和蓝)颜色通道,我们分别标准化每个通道。
具体而言,该通道的每个值减去该通道的平均值,然后将结果除以该通道的标准差。
[数据增广]
# 使用RGB通道的均值和标准差,以标准化每个通道
normalize = torchvision.transforms.Normalize(
    [0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

train_augs = torchvision.transforms.Compose([
    torchvision.transforms.RandomResizedCrop(224),
    torchvision.transforms.RandomHorizontalFlip(),
    torchvision.transforms.ToTensor(),
    normalize])

test_augs = torchvision.transforms.Compose([
    torchvision.transforms.Resize([256, 256]),
    torchvision.transforms.CenterCrop(224),
    torchvision.transforms.ToTensor(),
normalize])[定义和初始化模型]
我们使用在ImageNet数据集上预训练的ResNet-18作为源模型。
在这里,我们指定pretrained=True以自动下载预训练的模型参数。
如果首次使用此模型,则需要连接互联网才能下载。
pretrained_net = torchvision.models.resnet18(pretrained=True)预训练的源模型实例包含许多特征层和一个输出层fc。
此划分的主要目的是促进对除输出层以外所有层的模型参数进行微调。
下面给出了源模型的成员变量fc。
, paddle
pretrained_net.fc
在ResNet的全局平均汇聚层后,全连接层转换为ImageNet数据集的1000个类输出。
之后,我们构建一个新的神经网络作为目标模型。
它的定义方式与预训练源模型的定义方式相同,只是最终层中的输出数量被设置为目标数据集中的类数(而不是1000个)。
在下面的代码中,目标模型finetune_net中成员变量features的参数被初始化为源模型相应层的模型参数。
由于模型参数是在ImageNet数据集上预训练的,并且足够好,因此通常只需要较小的学习率即可微调这些参数。
成员变量output的参数是随机初始化的,通常需要更高的学习率才能从头开始训练。
假设Trainer实例中的学习率为,我们将成员变量output中参数的学习率设置为。
finetune_net = torchvision.models.resnet18(pretrained=True)
finetune_net.fc = nn.Linear(finetune_net.fc.in_features, 2)
nn.init.xavier_uniform_(finetune_net.fc.weight);[微调模型]
首先,我们定义了一个训练函数train_fine_tuning,该函数使用微调,因此可以多次调用。
# 如果param_group=True,输出层中的模型参数将使用十倍的学习率
def train_fine_tuning(net, learning_rate, batch_size=128, num_epochs=5,
                      param_group=True):
    train_iter = torch.utils.data.DataLoader(torchvision.datasets.ImageFolder(
        os.path.join(data_dir, 'train'), transform=train_augs),
        batch_size=batch_size, shuffle=True)
    test_iter = torch.utils.data.DataLoader(torchvision.datasets.ImageFolder(
        os.path.join(data_dir, 'test'), transform=test_augs),
        batch_size=batch_size)
    devices = d2l.try_all_gpus()
    loss = nn.CrossEntropyLoss(reduction="none")
    if param_group:
        params_1x = [param for name, param in net.named_parameters()
             if name not in ["fc.weight", "fc.bias"]]
        trainer = torch.optim.SGD([{'params': params_1x},
                                   {'params': net.fc.parameters(),
                                    'lr': learning_rate * 10}],
                                lr=learning_rate, weight_decay=0.001)
    else:
        trainer = torch.optim.SGD(net.parameters(), lr=learning_rate,
                                  weight_decay=0.001)
    d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)我们[使用较小的学习率],通过微调预训练获得的模型参数。
, paddle
train_fine_tuning(finetune_net, 5e-5)[为了进行比较,]我们定义了一个相同的模型,但是将其(所有模型参数初始化为随机值)。
由于整个模型需要从头开始训练,因此我们需要使用更大的学习率。
scratch_net = torchvision.models.resnet18()
scratch_net.fc = nn.Linear(scratch_net.fc.in_features, 2)
train_fine_tuning(scratch_net, 5e-4, param_group=False)
意料之中,微调模型往往表现更好,因为它的初始参数值更有效。
小结
- 迁移学习将从源数据集中学到的知识迁移到目标数据集,微调是迁移学习的常见技巧。
- 除输出层外,目标模型从源模型中复制所有模型设计及其参数,并根据目标数据集对这些参数进行微调。但是,目标模型的输出层需要从头开始训练。
- 通常,微调参数使用较小的学习率,而从头开始训练输出层可以使用更大的学习率。
练习
- 继续提高
finetune_net的学习率,模型的准确性如何变化? - 在比较实验中进一步调整
finetune_net和scratch_net的超参数。它们的准确性还有不同吗? - 将输出层
finetune_net之前的参数设置为源模型的参数,在训练期间不要更新它们。模型的准确性如何变化?提示:可以使用以下代码。
for param in finetune_net.parameters():
param.requires_grad = False- 事实上,
ImageNet数据集中有一个“热狗”类别。我们可以通过以下代码获取其输出层中的相应权重参数,但是我们怎样才能利用这个权重参数?
weight = pretrained_net.fc.weight
hotdog_w = torch.split(weight.data, 1, dim=0)[934]
hotdog_w.shape目标检测和边界框
前面的章节(例如 :numref:sec_alexnet— :numref:sec_googlenet)介绍了各种图像分类模型。
在图像分类任务中,我们假设图像中只有一个主要物体对象,我们只关注如何识别其类别。
然而,很多时候图像里有多个我们感兴趣的目标,我们不仅想知道它们的类别,还想得到它们在图像中的具体位置。
在计算机视觉里,我们将这类任务称为目标检测(object detection)或目标识别(object recognition)。
目标检测在多个领域中被广泛使用。
例如,在无人驾驶里,我们需要通过识别拍摄到的视频图像里的车辆、行人、道路和障碍物的位置来规划行进线路。
机器人也常通过该任务来检测感兴趣的目标。安防领域则需要检测异常目标,如歹徒或者炸弹。
接下来的几节将介绍几种用于目标检测的深度学习方法。
我们将首先介绍目标的位置。
%matplotlib inline
from d2l import torch as d2l
import torch
下面加载本节将使用的示例图像。可以看到图像左边是一只狗,右边是一只猫。
它们是这张图像里的两个主要目标。
, tensorflow, paddle
d2l.set_figsize()
img = d2l.plt.imread('../img/catdog.jpg')
d2l.plt.imshow(img);
边界框
在目标检测中,我们通常使用边界框(bounding box)来描述对象的空间位置。
边界框是矩形的,由矩形左上角的以及右下角的和坐标决定。
另一种常用的边界框表示方法是边界框中心的轴坐标以及框的宽度和高度。
在这里,我们[定义在这两种表示法之间进行转换的函数]:box_corner_to_center从两角表示法转换为中心宽度表示法,而box_center_to_corner反之亦然。
输入参数boxes可以是长度为4的张量,也可以是形状为(,4)的二维张量,其中是边界框的数量。
我们将根据坐标信息[定义图像中狗和猫的边界框]。
图像中坐标的原点是图像的左上角,向右的方向为轴的正方向,向下的方向为轴的正方向。
我们可以通过转换两次来验证边界框转换函数的正确性。
我们可以[将边界框在图中画出],以检查其是否准确。
画之前,我们定义一个辅助函数bbox_to_rect。
它将边界框表示成matplotlib的边界框格式。
在图像上添加边界框之后,我们可以看到两个物体的主要轮廓基本上在两个框内。
小结
- 目标检测不仅可以识别图像中所有感兴趣的物体,还能识别它们的位置,该位置通常由矩形边界框表示。
- 我们可以在两种常用的边界框表示(中间,宽度,高度)和(左上,右下)坐标之间进行转换。
练习
- 找到另一张图像,然后尝试标记包含该对象的边界框。比较标注边界框和标注类别哪个需要更长的时间?
- 为什么
box_corner_to_center和box_center_to_corner的输入参数的最内层维度总是4?
锚框
目标检测算法通常会在输入图像中采样大量的区域,然后判断这些区域中是否包含我们感兴趣的目标,并调整区域边界从而更准确地预测目标的真实边界框(ground-truth bounding box)。
不同的模型使用的区域采样方法可能不同。
这里我们介绍其中的一种方法:以每个像素为中心,生成多个缩放比和宽高比(aspect ratio)不同的边界框。
这些边界框被称为锚框(anchor box)我们将在 :numref:sec_ssd中设计一个基于锚框的目标检测模型。
首先,让我们修改输出精度,以获得更简洁的输出。
%matplotlib inline
from d2l import torch as d2l
import torch

torch.set_printoptions(2)  # 精简输出精度
生成多个锚框
假设输入图像的高度为,宽度为。
我们以图像的每个像素为中心生成不同形状的锚框:缩放比为,宽高比为。
那么[锚框的宽度和高度分别是和。]
请注意,当中心位置给定时,已知宽和高的锚框是确定的。
要生成多个不同形状的锚框,让我们设置许多缩放比(scale)取值和许多宽高比(aspect ratio)取值。
当使用这些比例和长宽比的所有组合以每个像素为中心时,输入图像将总共有个锚框。
尽管这些锚框可能会覆盖所有真实边界框,但计算复杂性很容易过高。
在实践中,(我们只考虑)包含或的(组合:)
(**
**)
也就是说,以同一像素为中心的锚框的数量是。
对于整个输入图像,将共生成个锚框。
上述生成锚框的方法在下面的multibox_prior函数中实现。
我们指定输入图像、尺寸列表和宽高比列表,然后此函数将返回所有的锚框。
#@save
def multibox_prior(data, sizes, ratios):
    """生成以每个像素为中心具有不同形状的锚框"""
    in_height, in_width = data.shape[-2:]
    device, num_sizes, num_ratios = data.device, len(sizes), len(ratios)
    boxes_per_pixel = (num_sizes + num_ratios - 1)
    size_tensor = d2l.tensor(sizes, device=device)
    ratio_tensor = d2l.tensor(ratios, device=device)

    # 为了将锚点移动到像素的中心,需要设置偏移量。
    # 因为一个像素的高为1且宽为1,我们选择偏移我们的中心0.5
    offset_h, offset_w = 0.5, 0.5
    steps_h = 1.0 / in_height  # 在y轴上缩放步长
    steps_w = 1.0 / in_width  # 在x轴上缩放步长

    # 生成锚框的所有中心点
    center_h = (torch.arange(in_height, device=device) + offset_h) * steps_h
    center_w = (torch.arange(in_width, device=device) + offset_w) * steps_w
    shift_y, shift_x = torch.meshgrid(center_h, center_w, indexing='ij')
    shift_y, shift_x = shift_y.reshape(-1), shift_x.reshape(-1)

    # 生成“boxes_per_pixel”个高和宽,
    # 之后用于创建锚框的四角坐标(xmin,xmax,ymin,ymax)
    w = torch.cat((size_tensor * torch.sqrt(ratio_tensor[0]),
                   sizes[0] * torch.sqrt(ratio_tensor[1:])))\
                   * in_height / in_width  # 处理矩形输入
    h = torch.cat((size_tensor / torch.sqrt(ratio_tensor[0]),
                   sizes[0] / torch.sqrt(ratio_tensor[1:])))
    # 除以2来获得半高和半宽
    anchor_manipulations = torch.stack((-w, -h, w, h)).T.repeat(
                                        in_height * in_width, 1) / 2

    # 每个中心点都将有“boxes_per_pixel”个锚框,
    # 所以生成含所有锚框中心的网格,重复了“boxes_per_pixel”次
    out_grid = torch.stack([shift_x, shift_y, shift_x, shift_y],
                dim=1).repeat_interleave(boxes_per_pixel, dim=0)
    output = out_grid + anchor_manipulations
return output.unsqueeze(0)可以看到[返回的锚框变量Y的形状]是(批量大小,锚框的数量,4)。
img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]

print(h, w)
X = torch.rand(size=(1, 3, h, w))
Y = multibox_prior(X, sizes=[0.75, 0.5, 0.25], ratios=[1, 2, 0.5])
Y.shape将锚框变量Y的形状更改为(图像高度,图像宽度,以同一像素为中心的锚框的数量,4)后,我们可以获得以指定像素的位置为中心的所有锚框。
在接下来的内容中,我们[访问以(250,250)为中心的第一个锚框]。
它有四个元素:锚框左上角的轴坐标和右下角的轴坐标。
输出中两个轴的坐标各分别除以了图像的宽度和高度。
为了[显示以图像中以某个像素为中心的所有锚框],定义下面的show_bboxes函数来在图像上绘制多个边界框。
正如从上面代码中所看到的,变量boxes中轴和轴的坐标值已分别除以图像的宽度和高度。
绘制锚框时,我们需要恢复它们原始的坐标值。
因此,在下面定义了变量bbox_scale。
现在可以绘制出图像中所有以(250,250)为中心的锚框了。
如下所示,缩放比为0.75且宽高比为1的蓝色锚框很好地围绕着图像中的狗。
[交并比(IoU)]
我们刚刚提到某个锚框“较好地”覆盖了图像中的狗。
如果已知目标的真实边界框,那么这里的“好”该如何如何量化呢?
直观地说,可以衡量锚框和真实边界框之间的相似性。
杰卡德系数(Jaccard)可以衡量两组之间的相似性。
给定集合和,他们的杰卡德系数是他们交集的大小除以他们并集的大小:
事实上,我们可以将任何边界框的像素区域视为一组像素。通
过这种方式,我们可以通过其像素集的杰卡德系数来测量两个边界框的相似性。
对于两个边界框,它们的杰卡德系数通常称为交并比(intersection over union,IoU),即两个边界框相交面积与相并面积之比,如 :numref:fig_iou所示。
交并比的取值范围在0和1之间:0表示两个边界框无重合像素,1表示两个边界框完全重合。
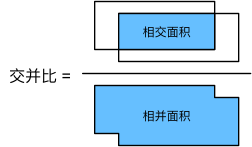
接下来部分将使用交并比来衡量锚框和真实边界框之间、以及不同锚框之间的相似度。
给定两个锚框或边界框的列表,以下box_iou函数将在这两个列表中计算它们成对的交并比。
#@save
def box_iou(boxes1, boxes2):
    """计算两个锚框或边界框列表中成对的交并比"""
    box_area = lambda boxes: ((boxes[:, 2] - boxes[:, 0]) *
                              (boxes[:, 3] - boxes[:, 1]))
    # boxes1,boxes2,areas1,areas2的形状:
    # boxes1:(boxes1的数量,4),
    # boxes2:(boxes2的数量,4),
    # areas1:(boxes1的数量,),
    # areas2:(boxes2的数量,)
    areas1 = box_area(boxes1)
    areas2 = box_area(boxes2)
    # inter_upperlefts,inter_lowerrights,inters的形状:
    # (boxes1的数量,boxes2的数量,2)
    inter_upperlefts = torch.max(boxes1[:, None, :2], boxes2[:, :2])
    inter_lowerrights = torch.min(boxes1[:, None, 2:], boxes2[:, 2:])
    inters = (inter_lowerrights - inter_upperlefts).clamp(min=0)
    # inter_areasandunion_areas的形状:(boxes1的数量,boxes2的数量)
    inter_areas = inters[:, :, 0] * inters[:, :, 1]
    union_areas = areas1[:, None] + areas2 - inter_areas
    return inter_areas / union_areas
在训练数据中标注锚框
在训练集中,我们将每个锚框视为一个训练样本。
为了训练目标检测模型,我们需要每个锚框的类别(class)和偏移量(offset)标签,其中前者是与锚框相关的对象的类别,后者是真实边界框相对于锚框的偏移量。
在预测时,我们为每个图像生成多个锚框,预测所有锚框的类别和偏移量,根据预测的偏移量调整它们的位置以获得预测的边界框,最后只输出符合特定条件的预测边界框。
目标检测训练集带有真实边界框的位置及其包围物体类别的标签。
要标记任何生成的锚框,我们可以参考分配到的最接近此锚框的真实边界框的位置和类别标签。
下文将介绍一个算法,它能够把最接近的真实边界框分配给锚框。
[将真实边界框分配给锚框]
给定图像,假设锚框是,真实边界框是,其中。
让我们定义一个矩阵,其中第行、第列的元素是锚框和真实边界框的IoU。
该算法包含以下步骤。
- 在矩阵中找到最大的元素,并将它的行索引和列索引分别表示为和。然后将真实边界框分配给锚框。这很直观,因为和是所有锚框和真实边界框配对中最相近的。在第一个分配完成后,丢弃矩阵中行和列中的所有元素。
- 在矩阵中找到剩余元素中最大的元素,并将它的行索引和列索引分别表示为和。我们将真实边界框分配给锚框,并丢弃矩阵中行和列中的所有元素。
- 此时,矩阵中两行和两列中的元素已被丢弃。我们继续,直到丢弃掉矩阵中列中的所有元素。此时已经为这个锚框各自分配了一个真实边界框。
- 只遍历剩下的个锚框。例如,给定任何锚框,在矩阵的第行中找到与的IoU最大的真实边界框,只有当此IoU大于预定义的阈值时,才将分配给。
下面用一个具体的例子来说明上述算法。
如 :numref:fig_anchor_label(左)所示,假设矩阵中的最大值为,我们将真实边界框分配给锚框。
然后,我们丢弃矩阵第2行和第3列中的所有元素,在剩余元素(阴影区域)中找到最大的,然后将真实边界框分配给锚框。
接下来,如 :numref:fig_anchor_label(中)所示,丢弃矩阵第7行和第1列中的所有元素,在剩余元素(阴影区域)中找到最大的,然后将真实边界框分配给锚框。
最后,如 :numref:fig_anchor_label(右)所示,丢弃矩阵第5行和第4列中的所有元素,在剩余元素(阴影区域)中找到最大的,然后将真实边界框分配给锚框。
之后,我们只需要遍历剩余的锚框,然后根据阈值确定是否为它们分配真实边界框。
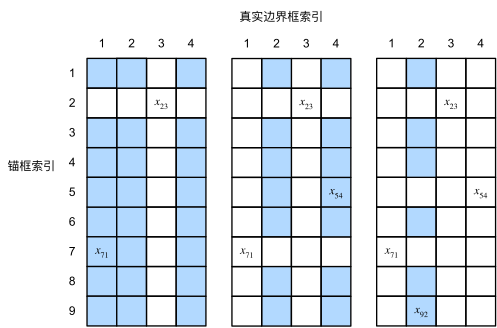
此算法在下面的assign_anchor_to_bbox函数中实现。
#@save
def assign_anchor_to_bbox(ground_truth, anchors, device, iou_threshold=0.5):
    """将最接近的真实边界框分配给锚框"""
    num_anchors, num_gt_boxes = anchors.shape[0], ground_truth.shape[0]
    # 位于第i行和第j列的元素x_ij是锚框i和真实边界框j的IoU
    jaccard = box_iou(anchors, ground_truth)
    # 对于每个锚框,分配的真实边界框的张量
    anchors_bbox_map = torch.full((num_anchors,), -1, dtype=torch.long,
                                  device=device)
    # 根据阈值,决定是否分配真实边界框
    max_ious, indices = torch.max(jaccard, dim=1)
    anc_i = torch.nonzero(max_ious >= iou_threshold).reshape(-1)
    box_j = indices[max_ious >= iou_threshold]
    anchors_bbox_map[anc_i] = box_j
    col_discard = torch.full((num_anchors,), -1)
    row_discard = torch.full((num_gt_boxes,), -1)
    for _ in range(num_gt_boxes):
        max_idx = torch.argmax(jaccard)
        box_idx = (max_idx % num_gt_boxes).long()
        anc_idx = (max_idx / num_gt_boxes).long()
        anchors_bbox_map[anc_idx] = box_idx
        jaccard[:, box_idx] = col_discard
        jaccard[anc_idx, :] = row_discard
    return anchors_bbox_map
标记类别和偏移量
现在我们可以为每个锚框标记类别和偏移量了。
假设一个锚框被分配了一个真实边界框。
一方面,锚框的类别将被标记为与相同。
另一方面,锚框的偏移量将根据和中心坐标的相对位置以及这两个框的相对大小进行标记。
鉴于数据集内不同的框的位置和大小不同,我们可以对那些相对位置和大小应用变换,使其获得分布更均匀且易于拟合的偏移量。
这里介绍一种常见的变换。
[**给定框和,中心坐标分别为和,宽度分别为和,高度分别为和,可以将的偏移量标记为:
**]
其中常量的默认值为 , 。
这种转换在下面的 offset_boxes 函数中实现。
如果一个锚框没有被分配真实边界框,我们只需将锚框的类别标记为背景(background)。
背景类别的锚框通常被称为负类锚框,其余的被称为正类锚框。
我们使用真实边界框(labels参数)实现以下multibox_target函数,来[标记锚框的类别和偏移量](anchors参数)。
此函数将背景类别的索引设置为零,然后将新类别的整数索引递增一。
#@save
def multibox_target(anchors, labels):
    """使用真实边界框标记锚框"""
    batch_size, anchors = labels.shape[0], anchors.squeeze(0)
    batch_offset, batch_mask, batch_class_labels = [], [], []
    device, num_anchors = anchors.device, anchors.shape[0]
    for i in range(batch_size):
        label = labels[i, :, :]
        anchors_bbox_map = assign_anchor_to_bbox(
            label[:, 1:], anchors, device)
        bbox_mask = ((anchors_bbox_map >= 0).float().unsqueeze(-1)).repeat(
            1, 4)
        # 将类标签和分配的边界框坐标初始化为零
        class_labels = torch.zeros(num_anchors, dtype=torch.long,
                                   device=device)
        assigned_bb = torch.zeros((num_anchors, 4), dtype=torch.float32,
                                  device=device)
        # 使用真实边界框来标记锚框的类别。
        # 如果一个锚框没有被分配,标记其为背景(值为零)
        indices_true = torch.nonzero(anchors_bbox_map >= 0)
        bb_idx = anchors_bbox_map[indices_true]
        class_labels[indices_true] = label[bb_idx, 0].long() + 1
        assigned_bb[indices_true] = label[bb_idx, 1:]
        # 偏移量转换
        offset = offset_boxes(anchors, assigned_bb) * bbox_mask
        batch_offset.append(offset.reshape(-1))
        batch_mask.append(bbox_mask.reshape(-1))
        batch_class_labels.append(class_labels)
    bbox_offset = torch.stack(batch_offset)
    bbox_mask = torch.stack(batch_mask)
    class_labels = torch.stack(batch_class_labels)
    return (bbox_offset, bbox_mask, class_labels)
一个例子
下面通过一个具体的例子来说明锚框标签。
我们已经为加载图像中的狗和猫定义了真实边界框,其中第一个元素是类别(0代表狗,1代表猫),其余四个元素是左上角和右下角的轴坐标(范围介于0和1之间)。
我们还构建了五个锚框,用左上角和右下角的坐标进行标记:(索引从0开始)。
然后我们[在图像中绘制这些真实边界框和锚框]。
使用上面定义的multibox_target函数,我们可以[根据狗和猫的真实边界框,标注这些锚框的分类和偏移量]。
在这个例子中,背景、狗和猫的类索引分别为0、1和2。
下面我们为锚框和真实边界框样本添加一个维度。
labels = multibox_target(anchors.unsqueeze(dim=0),
                         ground_truth.unsqueeze(dim=0))
返回的结果中有三个元素,都是张量格式。第三个元素包含标记的输入锚框的类别。
让我们根据图像中的锚框和真实边界框的位置来分析下面返回的类别标签。
首先,在所有的锚框和真实边界框配对中,锚框与猫的真实边界框的IoU是最大的。
因此,的类别被标记为猫。
去除包含或猫的真实边界框的配对,在剩下的配对中,锚框和狗的真实边界框有最大的IoU。
因此,的类别被标记为狗。
接下来,我们需要遍历剩下的三个未标记的锚框:、和。
对于,与其拥有最大IoU的真实边界框的类别是狗,但IoU低于预定义的阈值(0.5),因此该类别被标记为背景;
对于,与其拥有最大IoU的真实边界框的类别是猫,IoU超过阈值,所以类别被标记为猫;
对于,与其拥有最大IoU的真实边界框的类别是猫,但值低于阈值,因此该类别被标记为背景。
返回的第二个元素是掩码(mask)变量,形状为(批量大小,锚框数的四倍)。
掩码变量中的元素与每个锚框的4个偏移量一一对应。
由于我们不关心对背景的检测,负类的偏移量不应影响目标函数。
通过元素乘法,掩码变量中的零将在计算目标函数之前过滤掉负类偏移量。
返回的第一个元素包含了为每个锚框标记的四个偏移值。
请注意,负类锚框的偏移量被标记为零。
使用非极大值抑制预测边界框
在预测时,我们先为图像生成多个锚框,再为这些锚框一一预测类别和偏移量。
一个预测好的边界框则根据其中某个带有预测偏移量的锚框而生成。
下面我们实现了offset_inverse函数,该函数将锚框和偏移量预测作为输入,并[应用逆偏移变换来返回预测的边界框坐标]。
当有许多锚框时,可能会输出许多相似的具有明显重叠的预测边界框,都围绕着同一目标。
为了简化输出,我们可以使用非极大值抑制(non-maximum suppression,NMS)合并属于同一目标的类似的预测边界框。
以下是非极大值抑制的工作原理。
对于一个预测边界框,目标检测模型会计算每个类别的预测概率。
假设最大的预测概率为,则该概率所对应的类别即为预测的类别。
具体来说,我们将称为预测边界框的置信度(confidence)。
在同一张图像中,所有预测的非背景边界框都按置信度降序排序,以生成列表。然后我们通过以下步骤操作排序列表。
- 从中选取置信度最高的预测边界框作为基准,然后将所有与的IoU超过预定阈值的非基准预测边界框从中移除。这时,保留了置信度最高的预测边界框,去除了与其太过相似的其他预测边界框。简而言之,那些具有非极大值置信度的边界框被抑制了。
- 从中选取置信度第二高的预测边界框作为又一个基准,然后将所有与的IoU大于的非基准预测边界框从中移除。
- 重复上述过程,直到中的所有预测边界框都曾被用作基准。此时,中任意一对预测边界框的IoU都小于阈值;因此,没有一对边界框过于相似。
- 输出列表中的所有预测边界框。
[以下nms函数按降序对置信度进行排序并返回其索引]。
#@save
def nms(boxes, scores, iou_threshold):
    """对预测边界框的置信度进行排序"""
    B = torch.argsort(scores, dim=-1, descending=True)
    keep = []  # 保留预测边界框的指标
    while B.numel() > 0:
        i = B[0]
        keep.append(i)
        if B.numel() == 1: break
        iou = box_iou(boxes[i, :].reshape(-1, 4),
                      boxes[B[1:], :].reshape(-1, 4)).reshape(-1)
        inds = torch.nonzero(iou <= iou_threshold).reshape(-1)
        B = B[inds + 1]
return d2l.tensor(keep, device=boxes.device)我们定义以下multibox_detection函数来[将非极大值抑制应用于预测边界框]。
这里的实现有点复杂,请不要担心。我们将在实现之后,马上用一个具体的例子来展示它是如何工作的。
#@save
def multibox_detection(cls_probs, offset_preds, anchors, nms_threshold=0.5,
                       pos_threshold=0.009999999):
    """使用非极大值抑制来预测边界框"""
    device, batch_size = cls_probs.device, cls_probs.shape[0]
    anchors = anchors.squeeze(0)
    num_classes, num_anchors = cls_probs.shape[1], cls_probs.shape[2]
    out = []
    for i in range(batch_size):
        cls_prob, offset_pred = cls_probs[i], offset_preds[i].reshape(-1, 4)
        conf, class_id = torch.max(cls_prob[1:], 0)
        predicted_bb = offset_inverse(anchors, offset_pred)
        keep = nms(predicted_bb, conf, nms_threshold)

        # 找到所有的non_keep索引,并将类设置为背景
        all_idx = torch.arange(num_anchors, dtype=torch.long, device=device)
        combined = torch.cat((keep, all_idx))
        uniques, counts = combined.unique(return_counts=True)
        non_keep = uniques[counts == 1]
        all_id_sorted = torch.cat((keep, non_keep))
        class_id[non_keep] = -1
        class_id = class_id[all_id_sorted]
        conf, predicted_bb = conf[all_id_sorted], predicted_bb[all_id_sorted]
        # pos_threshold是一个用于非背景预测的阈值
        below_min_idx = (conf < pos_threshold)
        class_id[below_min_idx] = -1
        conf[below_min_idx] = 1 - conf[below_min_idx]
        pred_info = torch.cat((class_id.unsqueeze(1),
                               conf.unsqueeze(1),
                               predicted_bb), dim=1)
        out.append(pred_info)
return d2l.stack(out)现在让我们[将上述算法应用到一个带有四个锚框的具体示例中]。
为简单起见,我们假设预测的偏移量都是零,这意味着预测的边界框即是锚框。
对于背景、狗和猫其中的每个类,我们还定义了它的预测概率。
我们可以[在图像上绘制这些预测边界框和置信度]。
现在我们可以调用multibox_detection函数来执行非极大值抑制,其中阈值设置为0.5。
请注意,我们在示例的张量输入中添加了维度。
我们可以看到[返回结果的形状是(批量大小,锚框的数量,6)]。
最内层维度中的六个元素提供了同一预测边界框的输出信息。
第一个元素是预测的类索引,从0开始(0代表狗,1代表猫),值-1表示背景或在非极大值抑制中被移除了。
第二个元素是预测的边界框的置信度。
其余四个元素分别是预测边界框左上角和右下角的轴坐标(范围介于0和1之间)。
output = multibox_detection(cls_probs.unsqueeze(dim=0),
                            offset_preds.unsqueeze(dim=0),
                            anchors.unsqueeze(dim=0),
                            nms_threshold=0.5)
output删除-1类别(背景)的预测边界框后,我们可以[输出由非极大值抑制保存的最终预测边界框]。
实践中,在执行非极大值抑制前,我们甚至可以将置信度较低的预测边界框移除,从而减少此算法中的计算量。
我们也可以对非极大值抑制的输出结果进行后处理。例如,只保留置信度更高的结果作为最终输出。
小结
- 我们以图像的每个像素为中心生成不同形状的锚框。
- 交并比(IoU)也被称为杰卡德系数,用于衡量两个边界框的相似性。它是相交面积与相并面积的比率。
- 在训练集中,我们需要给每个锚框两种类型的标签。一个是与锚框中目标检测的类别,另一个是锚框真实相对于边界框的偏移量。
- 预测期间可以使用非极大值抑制(NMS)来移除类似的预测边界框,从而简化输出。
练习
- 在
multibox_prior函数中更改sizes和ratios的值。生成的锚框有什么变化? - 构建并可视化两个IoU为0.5的边界框。它们是怎样重叠的?
- 在 :numref:
subsec_labeling-anchor-boxes和 :numref:subsec_predicting-bounding-boxes-nms中修改变量anchors,结果如何变化? - 非极大值抑制是一种贪心算法,它通过移除来抑制预测的边界框。是否存在一种可能,被移除的一些框实际上是有用的?如何修改这个算法来柔和地抑制?可以参考Soft-NMS (Bodla.Singh.Chellappa.ea.2017)。
- 如果非手动,非最大限度的抑制可以被学习吗?
多尺度目标检测
在 :numref:sec_anchor中,我们以输入图像的每个像素为中心,生成了多个锚框。
基本而言,这些锚框代表了图像不同区域的样本。
然而,如果为每个像素都生成的锚框,我们最终可能会得到太多需要计算的锚框。
想象一个的输入图像,如果以每个像素为中心生成五个形状不同的锚框,就需要在图像上标记和预测超过200万个锚框()。
多尺度锚框
减少图像上的锚框数量并不困难。
比如,我们可以在输入图像中均匀采样一小部分像素,并以它们为中心生成锚框。
此外,在不同尺度下,我们可以生成不同数量和不同大小的锚框。
直观地说,比起较大的目标,较小的目标在图像上出现的可能性更多样。
例如,、和的目标可以分别以4、2和1种可能的方式出现在图像上。
因此,当使用较小的锚框检测较小的物体时,我们可以采样更多的区域,而对于较大的物体,我们可以采样较少的区域。
为了演示如何在多个尺度下生成锚框,让我们先读取一张图像。
它的高度和宽度分别为561和728像素。
%matplotlib inline
from d2l import torch as d2l
import torch

img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]
h, w
回想一下,在 :numref:sec_conv_layer中,我们将卷积图层的二维数组输出称为特征图。
通过定义特征图的形状,我们可以确定任何图像上均匀采样锚框的中心。
display_anchors函数定义如下。
我们[在特征图(fmap)上生成锚框(anchors),每个单位(像素)作为锚框的中心]。
由于锚框中的轴坐标值(anchors)已经被除以特征图(fmap)的宽度和高度,因此这些值介于0和1之间,表示特征图中锚框的相对位置。
由于锚框(anchors)的中心分布于特征图(fmap)上的所有单位,因此这些中心必须根据其相对空间位置在任何输入图像上均匀分布。
更具体地说,给定特征图的宽度和高度fmap_w和fmap_h,以下函数将均匀地对任何输入图像中fmap_h行和fmap_w列中的像素进行采样。
以这些均匀采样的像素为中心,将会生成大小为s(假设列表s的长度为1)且宽高比(ratios)不同的锚框。
def display_anchors(fmap_w, fmap_h, s):
    d2l.set_figsize()
    # 前两个维度上的值不影响输出
    fmap = d2l.zeros((1, 10, fmap_h, fmap_w))
    anchors = d2l.multibox_prior(fmap, sizes=s, ratios=[1, 2, 0.5])
    bbox_scale = d2l.tensor((w, h, w, h))
    d2l.show_bboxes(d2l.plt.imshow(img).axes,
anchors[0] * bbox_scale)首先,让我们考虑[探测小目标]。
为了在显示时更容易分辨,在这里具有不同中心的锚框不会重叠:
锚框的尺度设置为0.15,特征图的高度和宽度设置为4。
我们可以看到,图像上4行和4列的锚框的中心是均匀分布的。
然后,我们[将特征图的高度和宽度减小一半,然后使用较大的锚框来检测较大的目标]。
当尺度设置为0.4时,一些锚框将彼此重叠。
最后,我们进一步[将特征图的高度和宽度减小一半,然后将锚框的尺度增加到0.8]。
此时,锚框的中心即是图像的中心。
多尺度检测
既然我们已经生成了多尺度的锚框,我们就将使用它们来检测不同尺度下各种大小的目标。
下面,我们介绍一种基于CNN的多尺度目标检测方法,将在 :numref:sec_ssd中实现。
在某种规模上,假设我们有张形状为的特征图。
使用 :numref:subsec_multiscale-anchor-boxes中的方法,我们生成了组锚框,其中每组都有个中心相同的锚框。
例如,在 :numref:subsec_multiscale-anchor-boxes实验的第一个尺度上,给定10个(通道数量)的特征图,我们生成了16组锚框,每组包含3个中心相同的锚框。
接下来,每个锚框都根据真实值边界框来标记了类和偏移量。
在当前尺度下,目标检测模型需要预测输入图像上组锚框类别和偏移量,其中不同组锚框具有不同的中心。
假设此处的张特征图是CNN基于输入图像的正向传播算法获得的中间输出。
既然每张特征图上都有个不同的空间位置,那么相同空间位置可以看作含有个单元。
根据 :numref:sec_conv_layer中对感受野的定义,特征图在相同空间位置的个单元在输入图像上的感受野相同:
它们表征了同一感受野内的输入图像信息。
因此,我们可以将特征图在同一空间位置的个单元变换为使用此空间位置生成的个锚框类别和偏移量。
本质上,我们用输入图像在某个感受野区域内的信息,来预测输入图像上与该区域位置相近的锚框类别和偏移量。
当不同层的特征图在输入图像上分别拥有不同大小的感受野时,它们可以用于检测不同大小的目标。
例如,我们可以设计一个神经网络,其中靠近输出层的特征图单元具有更宽的感受野,这样它们就可以从输入图像中检测到较大的目标。
简言之,我们可以利用深层神经网络在多个层次上对图像进行分层表示,从而实现多尺度目标检测。
在 :numref:sec_ssd,我们将通过一个具体的例子来说明它是如何工作的。
小结
- 在多个尺度下,我们可以生成不同尺寸的锚框来检测不同尺寸的目标。
- 通过定义特征图的形状,我们可以决定任何图像上均匀采样的锚框的中心。
- 我们使用输入图像在某个感受野区域内的信息,来预测输入图像上与该区域位置相近的锚框类别和偏移量。
- 我们可以通过深入学习,在多个层次上的图像分层表示进行多尺度目标检测。
练习
- 根据我们在 :numref:
sec_alexnet中的讨论,深度神经网络学习图像特征级别抽象层次,随网络深度的增加而升级。在多尺度目标检测中,不同尺度的特征映射是否对应于不同的抽象层次?为什么? - 在 :numref:
subsec_multiscale-anchor-boxes中的实验里的第一个尺度(fmap_w=4, fmap_h=4)下,生成可能重叠的均匀分布的锚框。 - 给定形状为的特征图变量,其中、和分别是特征图的通道数、高度和宽度。怎样才能将这个变量转换为锚框类别和偏移量?输出的形状是什么?
目标检测数据集
目标检测领域没有像MNIST和Fashion-MNIST那样的小数据集。
为了快速测试目标检测模型,[我们收集并标记了一个小型数据集]。
首先,我们拍摄了一组香蕉的照片,并生成了1000张不同角度和大小的香蕉图像。
然后,我们在一些背景图片的随机位置上放一张香蕉的图像。
最后,我们在图片上为这些香蕉标记了边界框。
[下载数据集]
包含所有图像和CSV标签文件的香蕉检测数据集可以直接从互联网下载。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
import os
import pandas as pd
读取数据集
通过read_data_bananas函数,我们[读取香蕉检测数据集]。
该数据集包括一个的CSV文件,内含目标类别标签和位于左上角和右下角的真实边界框坐标。
#@save
def read_data_bananas(is_train=True):
    """读取香蕉检测数据集中的图像和标签"""
    data_dir = d2l.download_extract('banana-detection')
    csv_fname = os.path.join(data_dir, 'bananas_train' if is_train
                             else 'bananas_val', 'label.csv')
    csv_data = pd.read_csv(csv_fname)
    csv_data = csv_data.set_index('img_name')
    images, targets = [], []
    for img_name, target in csv_data.iterrows():
        images.append(torchvision.io.read_image(
            os.path.join(data_dir, 'bananas_train' if is_train else
                         'bananas_val', 'images', f'{img_name}')))
        # 这里的target包含(类别,左上角x,左上角y,右下角x,右下角y),
        # 其中所有图像都具有相同的香蕉类(索引为0)
        targets.append(list(target))
return images, torch.tensor(targets).unsqueeze(1) / 256通过使用read_data_bananas函数读取图像和标签,以下BananasDataset类别将允许我们[创建一个自定义Dataset实例]来加载香蕉检测数据集。
#@save
class BananasDataset(torch.utils.data.Dataset):
    """一个用于加载香蕉检测数据集的自定义数据集"""
    def __init__(self, is_train):
        self.features, self.labels = read_data_bananas(is_train)
        print('read ' + str(len(self.features)) + (f' training examples' if
              is_train else f' validation examples'))

    def __getitem__(self, idx):
        return (self.features[idx].float(), self.labels[idx])

    def __len__(self):
return len(self.features)最后,我们定义load_data_bananas函数,来[为训练集和测试集返回两个数据加载器实例]。对于测试集,无须按随机顺序读取它。
#@save
def load_data_bananas(batch_size):
    """加载香蕉检测数据集"""
    train_iter = torch.utils.data.DataLoader(BananasDataset(is_train=True),
                                             batch_size, shuffle=True)
    val_iter = torch.utils.data.DataLoader(BananasDataset(is_train=False),
                                           batch_size)
return train_iter, val_iter让我们[读取一个小批量,并打印其中的图像和标签的形状]。
图像的小批量的形状为(批量大小、通道数、高度、宽度),看起来很眼熟:它与我们之前图像分类任务中的相同。
标签的小批量的形状为(批量大小,,5),其中是数据集的任何图像中边界框可能出现的最大数量。
小批量计算虽然高效,但它要求每张图像含有相同数量的边界框,以便放在同一个批量中。
通常来说,图像可能拥有不同数量个边界框;因此,在达到之前,边界框少于的图像将被非法边界框填充。
这样,每个边界框的标签将被长度为5的数组表示。
数组中的第一个元素是边界框中对象的类别,其中-1表示用于填充的非法边界框。
数组的其余四个元素是边界框左上角和右下角的(,)坐标值(值域在0~1之间)。
对于香蕉数据集而言,由于每张图像上只有一个边界框,因此。
[演示]
让我们展示10幅带有真实边界框的图像。
我们可以看到在所有这些图像中香蕉的旋转角度、大小和位置都有所不同。
当然,这只是一个简单的人工数据集,实践中真实世界的数据集通常要复杂得多。
imgs = (batch[0][0:10].permute(0, 2, 3, 1)) / 255
axes = d2l.show_images(imgs, 2, 5, scale=2)
for ax, label in zip(axes, batch[1][0:10]):
    d2l.show_bboxes(ax, [label[0][1:5] * edge_size], colors=['w'])
小结
- 我们收集的香蕉检测数据集可用于演示目标检测模型。
- 用于目标检测的数据加载与图像分类的数据加载类似。但是,在目标检测中,标签还包含真实边界框的信息,它不出现在图像分类中。
练习
- 在香蕉检测数据集中演示其他带有真实边界框的图像。它们在边界框和目标方面有什么不同?
- 假设我们想要将数据增强(例如随机裁剪)应用于目标检测。它与图像分类中的有什么不同?提示:如果裁剪的图像只包含物体的一小部分会怎样?
单发多框检测(SSD)
在 :numref:sec_bbox— :numref:sec_object-detection-dataset中,我们分别介绍了边界框、锚框、多尺度目标检测和用于目标检测的数据集。
现在我们已经准备好使用这样的背景知识来设计一个目标检测模型:单发多框检测(SSD) (Liu.Anguelov.Erhan.ea.2016)。
该模型简单、快速且被广泛使用。尽管这只是其中一种目标检测模型,但本节中的一些设计原则和实现细节也适用于其他模型。
模型
:numref:fig_ssd描述了单发多框检测模型的设计。
此模型主要由基础网络组成,其后是几个多尺度特征块。
基本网络用于从输入图像中提取特征,因此它可以使用深度卷积神经网络。
单发多框检测论文中选用了在分类层之前截断的VGG (Liu.Anguelov.Erhan.ea.2016),现在也常用ResNet替代。
我们可以设计基础网络,使它输出的高和宽较大。
这样一来,基于该特征图生成的锚框数量较多,可以用来检测尺寸较小的目标。
接下来的每个多尺度特征块将上一层提供的特征图的高和宽缩小(如减半),并使特征图中每个单元在输入图像上的感受野变得更广阔。
回想一下在 :numref:sec_multiscale-object-detection中,通过深度神经网络分层表示图像的多尺度目标检测的设计。
由于接近 :numref:fig_ssd顶部的多尺度特征图较小,但具有较大的感受野,它们适合检测较少但较大的物体。
简而言之,通过多尺度特征块,单发多框检测生成不同大小的锚框,并通过预测边界框的类别和偏移量来检测大小不同的目标,因此这是一个多尺度目标检测模型。
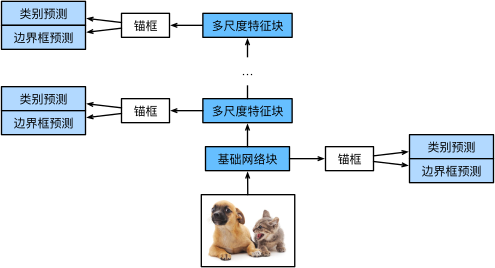
在下面,我们将介绍 :numref:fig_ssd中不同块的实施细节。
首先,我们将讨论如何实施类别和边界框预测。
[类别预测层]
设目标类别的数量为。这样一来,锚框有个类别,其中0类是背景。
在某个尺度下,设特征图的高和宽分别为和。
如果以其中每个单元为中心生成个锚框,那么我们需要对个锚框进行分类。
如果使用全连接层作为输出,很容易导致模型参数过多。
回忆 :numref:sec_nin一节介绍的使用卷积层的通道来输出类别预测的方法,
单发多框检测采用同样的方法来降低模型复杂度。
具体来说,类别预测层使用一个保持输入高和宽的卷积层。
这样一来,输出和输入在特征图宽和高上的空间坐标一一对应。
考虑输出和输入同一空间坐标(、):输出特征图上(、)坐标的通道里包含了以输入特征图(、)坐标为中心生成的所有锚框的类别预测。
因此输出通道数为,其中索引为()的通道代表了索引为的锚框有关类别索引为的预测。
在下面,我们定义了这样一个类别预测层,通过参数num_anchors和num_classes分别指定了和。
该图层使用填充为1的的卷积层。此卷积层的输入和输出的宽度和高度保持不变。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
from torch.nn import functional as F

def cls_predictor(num_inputs, num_anchors, num_classes):
    return nn.Conv2d(num_inputs, num_anchors * (num_classes + 1),
kernel_size=3, padding=1)(边界框预测层)
边界框预测层的设计与类别预测层的设计类似。
唯一不同的是,这里需要为每个锚框预测4个偏移量,而不是个类别。
def bbox_predictor(num_inputs, num_anchors):
return nn.Conv2d(num_inputs, num_anchors * 4, kernel_size=3, padding=1)[连结多尺度的预测]
正如我们所提到的,单发多框检测使用多尺度特征图来生成锚框并预测其类别和偏移量。
在不同的尺度下,特征图的形状或以同一单元为中心的锚框的数量可能会有所不同。
因此,不同尺度下预测输出的形状可能会有所不同。
在以下示例中,我们为同一个小批量构建两个不同比例(Y1和Y2)的特征图,其中Y2的高度和宽度是Y1的一半。
以类别预测为例,假设Y1和Y2的每个单元分别生成了个和个锚框。
进一步假设目标类别的数量为,对于特征图Y1和Y2,类别预测输出中的通道数分别为和,其中任一输出的形状是(批量大小,通道数,高度,宽度)。
def forward(x, block):
    return block(x)

Y1 = forward(torch.zeros((2, 8, 20, 20)), cls_predictor(8, 5, 10))
Y2 = forward(torch.zeros((2, 16, 10, 10)), cls_predictor(16, 3, 10))
Y1.shape, Y2.shape
正如我们所看到的,除了批量大小这一维度外,其他三个维度都具有不同的尺寸。
为了将这两个预测输出链接起来以提高计算效率,我们将把这些张量转换为更一致的格式。
通道维包含中心相同的锚框的预测结果。我们首先将通道维移到最后一维。
因为不同尺度下批量大小仍保持不变,我们可以将预测结果转成二维的(批量大小,高宽通道数)的格式,以方便之后在维度上的连结。
def flatten_pred(pred):
    return torch.flatten(pred.permute(0, 2, 3, 1), start_dim=1)

def concat_preds(preds):
return torch.cat([flatten_pred(p) for p in preds], dim=1)这样一来,尽管Y1和Y2在通道数、高度和宽度方面具有不同的大小,我们仍然可以在同一个小批量的两个不同尺度上连接这两个预测输出。
[高和宽减半块]
为了在多个尺度下检测目标,我们在下面定义了高和宽减半块down_sample_blk,该模块将输入特征图的高度和宽度减半。
事实上,该块应用了在 :numref:subsec_vgg-blocks中的VGG模块设计。
更具体地说,每个高和宽减半块由两个填充为的的卷积层、以及步幅为的最大汇聚层组成。
我们知道,填充为的卷积层不改变特征图的形状。但是,其后的的最大汇聚层将输入特征图的高度和宽度减少了一半。
对于此高和宽减半块的输入和输出特征图,因为,所以输出中的每个单元在输入上都有一个的感受野。因此,高和宽减半块会扩大每个单元在其输出特征图中的感受野。
def down_sample_blk(in_channels, out_channels):
    blk = []
    for _ in range(2):
        blk.append(nn.Conv2d(in_channels, out_channels,
                             kernel_size=3, padding=1))
        blk.append(nn.BatchNorm2d(out_channels))
        blk.append(nn.ReLU())
        in_channels = out_channels
    blk.append(nn.MaxPool2d(2))
    return nn.Sequential(*blk)
在以下示例中,我们构建的高和宽减半块会更改输入通道的数量,并将输入特征图的高度和宽度减半。
forward(torch.zeros((2, 3, 20, 20)), down_sample_blk(3, 10)).shape[基本网络块]
基本网络块用于从输入图像中抽取特征。
为了计算简洁,我们构造了一个小的基础网络,该网络串联3个高和宽减半块,并逐步将通道数翻倍。
给定输入图像的形状为,此基本网络块输出的特征图形状为()。
def base_net():
    blk = []
    num_filters = [3, 16, 32, 64]
    for i in range(len(num_filters) - 1):
        blk.append(down_sample_blk(num_filters[i], num_filters[i+1]))
    return nn.Sequential(*blk)

forward(torch.zeros((2, 3, 256, 256)), base_net()).shape
完整的模型
[完整的单发多框检测模型由五个模块组成]。每个块生成的特征图既用于生成锚框,又用于预测这些锚框的类别和偏移量。在这五个模块中,第一个是基本网络块,第二个到第四个是高和宽减半块,最后一个模块使用全局最大池将高度和宽度都降到1。从技术上讲,第二到第五个区块都是 :numref:fig_ssd中的多尺度特征块。
def get_blk(i):
    if i == 0:
        blk = base_net()
    elif i == 1:
        blk = down_sample_blk(64, 128)
    elif i == 4:
        blk = nn.AdaptiveMaxPool2d((1,1))
    else:
        blk = down_sample_blk(128, 128)
return blk现在我们[为每个块定义前向传播]。与图像分类任务不同,此处的输出包括:CNN特征图Y;在当前尺度下根据Y生成的锚框;预测的这些锚框的类别和偏移量(基于Y)。
def blk_forward(X, blk, size, ratio, cls_predictor, bbox_predictor):
    Y = blk(X)
    anchors = d2l.multibox_prior(Y, sizes=size, ratios=ratio)
    cls_preds = cls_predictor(Y)
    bbox_preds = bbox_predictor(Y)
    return (Y, anchors, cls_preds, bbox_preds)
回想一下,在 :numref:fig_ssd中,一个较接近顶部的多尺度特征块是用于检测较大目标的,因此需要生成更大的锚框。
在上面的前向传播中,在每个多尺度特征块上,我们通过调用的multibox_prior函数(见 :numref:sec_anchor)的sizes参数传递两个比例值的列表。
在下面,0.2和1.05之间的区间被均匀分成五个部分,以确定五个模块的在不同尺度下的较小值:0.2、0.37、0.54、0.71和0.88。
之后,他们较大的值由、等给出。
[超参数]
现在,我们就可以按如下方式[定义完整的模型]TinySSD了。
class TinySSD(nn.Module):
    def __init__(self, num_classes, **kwargs):
        super(TinySSD, self).__init__(**kwargs)
        self.num_classes = num_classes
        idx_to_in_channels = [64, 128, 128, 128, 128]
        for i in range(5):
            # 即赋值语句self.blk_i=get_blk(i)
            setattr(self, f'blk_{i}', get_blk(i))
            setattr(self, f'cls_{i}', cls_predictor(idx_to_in_channels[i],
                                                    num_anchors, num_classes))
            setattr(self, f'bbox_{i}', bbox_predictor(idx_to_in_channels[i],
                                                      num_anchors))

    def forward(self, X):
        anchors, cls_preds, bbox_preds = [None] * 5, [None] * 5, [None] * 5
        for i in range(5):
            # getattr(self,'blk_%d'%i)即访问self.blk_i
            X, anchors[i], cls_preds[i], bbox_preds[i] = blk_forward(
                X, getattr(self, f'blk_{i}'), sizes[i], ratios[i],
                getattr(self, f'cls_{i}'), getattr(self, f'bbox_{i}'))
        anchors = torch.cat(anchors, dim=1)
        cls_preds = concat_preds(cls_preds)
        cls_preds = cls_preds.reshape(
            cls_preds.shape[0], -1, self.num_classes + 1)
        bbox_preds = concat_preds(bbox_preds)
return anchors, cls_preds, bbox_preds我们[创建一个模型实例,然后使用它]对一个像素的小批量图像X(执行前向传播)。
如本节前面部分所示,第一个模块输出特征图的形状为。
回想一下,第二到第四个模块为高和宽减半块,第五个模块为全局汇聚层。
由于以特征图的每个单元为中心有个锚框生成,因此在所有五个尺度下,每个图像总共生成个锚框。
net = TinySSD(num_classes=1)
X = torch.zeros((32, 3, 256, 256))
anchors, cls_preds, bbox_preds = net(X)

print('output anchors:', anchors.shape)
print('output class preds:', cls_preds.shape)
print('output bbox preds:', bbox_preds.shape)
训练模型
现在,我们将描述如何训练用于目标检测的单发多框检测模型。
读取数据集和初始化
首先,让我们[读取] :numref:sec_object-detection-dataset中描述的(香蕉检测数据集)。
香蕉检测数据集中,目标的类别数为1。
定义好模型后,我们需要(初始化其参数并定义优化算法)。
device, net = d2l.try_gpu(), TinySSD(num_classes=1)
trainer = torch.optim.SGD(net.parameters(), lr=0.2, weight_decay=5e-4)[定义损失函数和评价函数]
目标检测有两种类型的损失。
第一种有关锚框类别的损失:我们可以简单地复用之前图像分类问题里一直使用的交叉熵损失函数来计算;
第二种有关正类锚框偏移量的损失:预测偏移量是一个回归问题。
但是,对于这个回归问题,我们在这里不使用 :numref:subsec_normal_distribution_and_squared_loss中描述的平方损失,而是使用范数损失,即预测值和真实值之差的绝对值。
掩码变量bbox_masks令负类锚框和填充锚框不参与损失的计算。
最后,我们将锚框类别和偏移量的损失相加,以获得模型的最终损失函数。
cls_loss = nn.CrossEntropyLoss(reduction='none')
bbox_loss = nn.L1Loss(reduction='none')

def calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels, bbox_masks):
    batch_size, num_classes = cls_preds.shape[0], cls_preds.shape[2]
    cls = cls_loss(cls_preds.reshape(-1, num_classes),
                   cls_labels.reshape(-1)).reshape(batch_size, -1).mean(dim=1)
    bbox = bbox_loss(bbox_preds * bbox_masks,
                     bbox_labels * bbox_masks).mean(dim=1)
    return cls + bbox
我们可以沿用准确率评价分类结果。
由于偏移量使用了范数损失,我们使用平均绝对误差来评价边界框的预测结果。这些预测结果是从生成的锚框及其预测偏移量中获得的。
def cls_eval(cls_preds, cls_labels):
    # 由于类别预测结果放在最后一维,argmax需要指定最后一维。
    return float((cls_preds.argmax(dim=-1).type(
        cls_labels.dtype) == cls_labels).sum())

def bbox_eval(bbox_preds, bbox_labels, bbox_masks):
return float((torch.abs((bbox_labels - bbox_preds) * bbox_masks)).sum())[训练模型]
在训练模型时,我们需要在模型的前向传播过程中生成多尺度锚框(anchors),并预测其类别(cls_preds)和偏移量(bbox_preds)。
然后,我们根据标签信息Y为生成的锚框标记类别(cls_labels)和偏移量(bbox_labels)。
最后,我们根据类别和偏移量的预测和标注值计算损失函数。为了代码简洁,这里没有评价测试数据集。
num_epochs, timer = 20, d2l.Timer()
animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                        legend=['class error', 'bbox mae'])
net = net.to(device)
for epoch in range(num_epochs):
    # 训练精确度的和,训练精确度的和中的示例数
    # 绝对误差的和,绝对误差的和中的示例数
    metric = d2l.Accumulator(4)
    net.train()
    for features, target in train_iter:
        timer.start()
        trainer.zero_grad()
        X, Y = features.to(device), target.to(device)
        # 生成多尺度的锚框,为每个锚框预测类别和偏移量
        anchors, cls_preds, bbox_preds = net(X)
        # 为每个锚框标注类别和偏移量
        bbox_labels, bbox_masks, cls_labels = d2l.multibox_target(anchors, Y)
        # 根据类别和偏移量的预测和标注值计算损失函数
        l = calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels,
                      bbox_masks)
        l.mean().backward()
        trainer.step()
        metric.add(cls_eval(cls_preds, cls_labels), cls_labels.numel(),
                   bbox_eval(bbox_preds, bbox_labels, bbox_masks),
                   bbox_labels.numel())
    cls_err, bbox_mae = 1 - metric[0] / metric[1], metric[2] / metric[3]
    animator.add(epoch + 1, (cls_err, bbox_mae))
print(f'class err {cls_err:.2e}, bbox mae {bbox_mae:.2e}')
print(f'{len(train_iter.dataset) / timer.stop():.1f} examples/sec on '
f'{str(device)}')[预测目标]
在预测阶段,我们希望能把图像里面所有我们感兴趣的目标检测出来。在下面,我们读取并调整测试图像的大小,然后将其转成卷积层需要的四维格式。
X = torchvision.io.read_image('../img/banana.jpg').unsqueeze(0).float()
img = X.squeeze(0).permute(1, 2, 0).long()使用下面的multibox_detection函数,我们可以根据锚框及其预测偏移量得到预测边界框。然后,通过非极大值抑制来移除相似的预测边界框。
def predict(X):
    net.eval()
    anchors, cls_preds, bbox_preds = net(X.to(device))
    cls_probs = F.softmax(cls_preds, dim=2).permute(0, 2, 1)
    output = d2l.multibox_detection(cls_probs, bbox_preds, anchors)
    idx = [i for i, row in enumerate(output[0]) if row[0] != -1]
    return output[0, idx]

output = predict(X)最后,我们[筛选所有置信度不低于0.9的边界框,做为最终输出]。
def display(img, output, threshold):
    d2l.set_figsize((5, 5))
    fig = d2l.plt.imshow(img)
    for row in output:
        score = float(row[1])
        if score < threshold:
            continue
        h, w = img.shape[0:2]
        bbox = [row[2:6] * torch.tensor((w, h, w, h), device=row.device)]
        d2l.show_bboxes(fig.axes, bbox, '%.2f' % score, 'w')

display(img, output.cpu(), threshold=0.9)
小结
- 单发多框检测是一种多尺度目标检测模型。基于基础网络块和各个多尺度特征块,单发多框检测生成不同数量和不同大小的锚框,并通过预测这些锚框的类别和偏移量检测不同大小的目标。
- 在训练单发多框检测模型时,损失函数是根据锚框的类别和偏移量的预测及标注值计算得出的。
练习
- 能通过改进损失函数来改进单发多框检测吗?例如,将预测偏移量用到的范数损失替换为平滑范数损失。它在零点附近使用平方函数从而更加平滑,这是通过一个超参数来控制平滑区域的:
当非常大时,这种损失类似于范数损失。当它的值较小时,损失函数较平滑。
def smooth_l1(data, scalar):
    out = []
    for i in data:
        if abs(i) < 1 / (scalar ** 2):
            out.append(((scalar * i) ** 2) / 2)
        else:
            out.append(abs(i) - 0.5 / (scalar ** 2))
    return torch.tensor(out)

sigmas = [10, 1, 0.5]
lines = ['-', '--', '-.']
x = torch.arange(-2, 2, 0.1)
d2l.set_figsize()

for l, s in zip(lines, sigmas):
    y = smooth_l1(x, scalar=s)
    d2l.plt.plot(x, y, l, label='sigma=%.1f' % s)
d2l.plt.legend();此外,在类别预测时,实验中使用了交叉熵损失:设真实类别的预测概率是,交叉熵损失为。我们还可以使用焦点损失 (Lin.Goyal.Girshick.ea.2017)。给定超参数和,此损失的定义为:
可以看到,增大可以有效地减少正类预测概率较大时(例如)的相对损失,因此训练可以更集中在那些错误分类的困难示例上。
def focal_loss(gamma, x):
    return -(1 - x) ** gamma * torch.log(x)

x = torch.arange(0.01, 1, 0.01)
for l, gamma in zip(lines, [0, 1, 5]):
    y = d2l.plt.plot(x, focal_loss(gamma, x), l, label='gamma=%.1f' % gamma)
d2l.plt.legend();- 由于篇幅限制,我们在本节中省略了单发多框检测模型的一些实现细节。能否从以下几个方面进一步改进模型:
- 当目标比图像小得多时,模型可以将输入图像调大;
- 通常会存在大量的负锚框。为了使类别分布更加平衡,我们可以将负锚框的高和宽减半;
- 在损失函数中,给类别损失和偏移损失设置不同比重的超参数;
- 使用其他方法评估目标检测模型,例如单发多框检测论文 (Liu.Anguelov.Erhan.ea.2016)中的方法。
区域卷积神经网络(R-CNN)系列
除了 :numref:sec_ssd中描述的单发多框检测之外,
区域卷积神经网络(region-based CNN或regions with CNN features,R-CNN) (Girshick.Donahue.Darrell.ea.2014)也是将深度模型应用于目标检测的开创性工作之一。
本节将介绍R-CNN及其一系列改进方法:快速的R-CNN(Fast R-CNN) (Girshick.2015)、更快的R-CNN(Faster R-CNN) (Ren.He.Girshick.ea.2015)和掩码R-CNN(Mask R-CNN) (He.Gkioxari.Dollar.ea.2017)。
限于篇幅,我们只着重介绍这些模型的设计思路。
R-CNN
R-CNN首先从输入图像中选取若干(例如2000个)提议区域(如锚框也是一种选取方法),并标注它们的类别和边界框(如偏移量)。 (Girshick.Donahue.Darrell.ea.2014)然后,用卷积神经网络对每个提议区域进行前向传播以抽取其特征。
接下来,我们用每个提议区域的特征来预测类别和边界框。
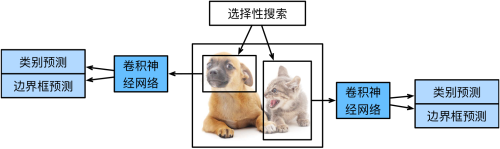
:numref:fig_r-cnn展示了R-CNN模型。具体来说,R-CNN包括以下四个步骤:
- 对输入图像使用选择性搜索来选取多个高质量的提议区域 (Uijlings.Van-De-Sande.Gevers.ea.2013)。这些提议区域通常是在多个尺度下选取的,并具有不同的形状和大小。每个提议区域都将被标注类别和真实边界框;
- 选择一个预训练的卷积神经网络,并将其在输出层之前截断。将每个提议区域变形为网络需要的输入尺寸,并通过前向传播输出抽取的提议区域特征;
- 将每个提议区域的特征连同其标注的类别作为一个样本。训练多个支持向量机对目标分类,其中每个支持向量机用来判断样本是否属于某一个类别;
- 将每个提议区域的特征连同其标注的边界框作为一个样本,训练线性回归模型来预测真实边界框。
尽管R-CNN模型通过预训练的卷积神经网络有效地抽取了图像特征,但它的速度很慢。
想象一下,我们可能从一张图像中选出上千个提议区域,这需要上千次的卷积神经网络的前向传播来执行目标检测。
这种庞大的计算量使得R-CNN在现实世界中难以被广泛应用。
Fast R-CNN
R-CNN的主要性能瓶颈在于,对每个提议区域,卷积神经网络的前向传播是独立的,而没有共享计算。
由于这些区域通常有重叠,独立的特征抽取会导致重复的计算。
Fast R-CNN (Girshick.2015)对R-CNN的主要改进之一,是仅在整张图象上执行卷积神经网络的前向传播。
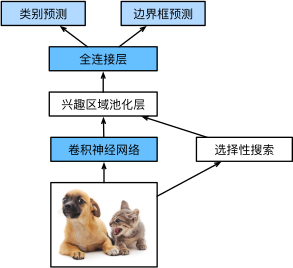
:numref:fig_fast_r-cnn中描述了Fast R-CNN模型。它的主要计算如下:
- 与R-CNN相比,Fast R-CNN用来提取特征的卷积神经网络的输入是整个图像,而不是各个提议区域。此外,这个网络通常会参与训练。设输入为一张图像,将卷积神经网络的输出的形状记为;
- 假设选择性搜索生成了个提议区域。这些形状各异的提议区域在卷积神经网络的输出上分别标出了形状各异的兴趣区域。然后,这些感兴趣的区域需要进一步抽取出形状相同的特征(比如指定高度和宽度),以便于连结后输出。为了实现这一目标,Fast R-CNN引入了兴趣区域汇聚层(RoI pooling):将卷积神经网络的输出和提议区域作为输入,输出连结后的各个提议区域抽取的特征,形状为;
- 通过全连接层将输出形状变换为,其中超参数取决于模型设计;
- 预测个提议区域中每个区域的类别和边界框。更具体地说,在预测类别和边界框时,将全连接层的输出分别转换为形状为(是类别的数量)的输出和形状为的输出。其中预测类别时使用softmax回归。
在Fast R-CNN中提出的兴趣区域汇聚层与 :numref:sec_pooling中介绍的汇聚层有所不同。在汇聚层中,我们通过设置汇聚窗口、填充和步幅的大小来间接控制输出形状。而兴趣区域汇聚层对每个区域的输出形状是可以直接指定的。
例如,指定每个区域输出的高和宽分别为和。
对于任何形状为的兴趣区域窗口,该窗口将被划分为子窗口网格,其中每个子窗口的大小约为。
在实践中,任何子窗口的高度和宽度都应向上取整,其中的最大元素作为该子窗口的输出。
因此,兴趣区域汇聚层可从形状各异的兴趣区域中均抽取出形状相同的特征。
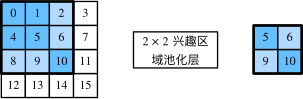
作为说明性示例, :numref:fig_roi中提到,在的输入中,我们选取了左上角的兴趣区域。
对于该兴趣区域,我们通过的兴趣区域汇聚层得到一个的输出。
请注意,四个划分后的子窗口中分别含有元素0、1、4、5(5最大);2、6(6最大);8、9(9最大);以及10。
 的兴趣区域汇聚层" />
下面,我们演示了兴趣区域汇聚层的计算方法。
假设卷积神经网络抽取的特征X的高度和宽度都是4,且只有单通道。
import torch
import torchvision

X = torch.arange(16.).reshape(1, 1, 4, 4)
X
让我们进一步假设输入图像的高度和宽度都是40像素,且选择性搜索在此图像上生成了两个提议区域。
每个区域由5个元素表示:区域目标类别、左上角和右下角的坐标。
rois = torch.Tensor([[0, 0, 0, 20, 20], [0, 0, 10, 30, 30]])由于X的高和宽是输入图像高和宽的,因此,两个提议区域的坐标先按spatial_scale乘以0.1。
然后,在X上分别标出这两个兴趣区域X[:, :, 0:3, 0:3]和X[:, :, 1:4, 0:4]。
最后,在的兴趣区域汇聚层中,每个兴趣区域被划分为子窗口网格,并进一步抽取相同形状的特征。
torchvision.ops.roi_pool(X, rois, output_size=(2, 2), spatial_scale=0.1)Faster R-CNN
为了较精确地检测目标结果,Fast R-CNN模型通常需要在选择性搜索中生成大量的提议区域。
Faster R-CNN (Ren.He.Girshick.ea.2015)提出将选择性搜索替换为区域提议网络(region proposal network),从而减少提议区域的生成数量,并保证目标检测的精度。
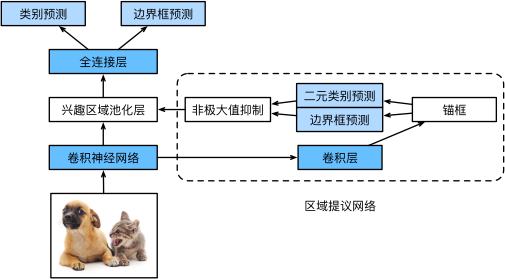
:numref:fig_faster_r-cnn描述了Faster R-CNN模型。
与Fast R-CNN相比,Faster R-CNN只将生成提议区域的方法从选择性搜索改为了区域提议网络,模型的其余部分保持不变。具体来说,区域提议网络的计算步骤如下:
- 使用填充为1的的卷积层变换卷积神经网络的输出,并将输出通道数记为。这样,卷积神经网络为图像抽取的特征图中的每个单元均得到一个长度为的新特征。
- 以特征图的每个像素为中心,生成多个不同大小和宽高比的锚框并标注它们。
- 使用锚框中心单元长度为的特征,分别预测该锚框的二元类别(含目标还是背景)和边界框。
- 使用非极大值抑制,从预测类别为目标的预测边界框中移除相似的结果。最终输出的预测边界框即是兴趣区域汇聚层所需的提议区域。
值得一提的是,区域提议网络作为Faster R-CNN模型的一部分,是和整个模型一起训练得到的。
换句话说,Faster R-CNN的目标函数不仅包括目标检测中的类别和边界框预测,还包括区域提议网络中锚框的二元类别和边界框预测。
作为端到端训练的结果,区域提议网络能够学习到如何生成高质量的提议区域,从而在减少了从数据中学习的提议区域的数量的情况下,仍保持目标检测的精度。
Mask R-CNN
如果在训练集中还标注了每个目标在图像上的像素级位置,那么Mask R-CNN (He.Gkioxari.Dollar.ea.2017)能够有效地利用这些详尽的标注信息进一步提升目标检测的精度。
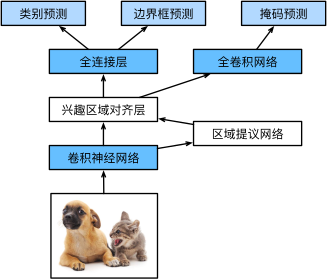
如 :numref:fig_mask_r-cnn所示,Mask R-CNN是基于Faster R-CNN修改而来的。
具体来说,Mask R-CNN将兴趣区域汇聚层替换为了
兴趣区域对齐层,使用双线性插值(bilinear interpolation)来保留特征图上的空间信息,从而更适于像素级预测。
兴趣区域对齐层的输出包含了所有与兴趣区域的形状相同的特征图。
它们不仅被用于预测每个兴趣区域的类别和边界框,还通过额外的全卷积网络预测目标的像素级位置。
本章的后续章节将更详细地介绍如何使用全卷积网络预测图像中像素级的语义。
小结
- R-CNN对图像选取若干提议区域,使用卷积神经网络对每个提议区域执行前向传播以抽取其特征,然后再用这些特征来预测提议区域的类别和边界框。
- Fast R-CNN对R-CNN的一个主要改进:只对整个图像做卷积神经网络的前向传播。它还引入了兴趣区域汇聚层,从而为具有不同形状的兴趣区域抽取相同形状的特征。
- Faster R-CNN将Fast R-CNN中使用的选择性搜索替换为参与训练的区域提议网络,这样后者可以在减少提议区域数量的情况下仍保证目标检测的精度。
- Mask R-CNN在Faster R-CNN的基础上引入了一个全卷积网络,从而借助目标的像素级位置进一步提升目标检测的精度。
练习
- 我们能否将目标检测视为回归问题(例如预测边界框和类别的概率)?可以参考YOLO模型 (Redmon.Divvala.Girshick.ea.2016)的设计。
- 将单发多框检测与本节介绍的方法进行比较。他们的主要区别是什么?可以参考 (Zhao.Zheng.Xu.ea.2019)中的图2。
语义分割和数据集
在 :numref:sec_bbox— :numref:sec_rcnn中讨论的目标检测问题中,我们一直使用方形边界框来标注和预测图像中的目标。
本节将探讨语义分割(semantic segmentation)问题,它重点关注于如何将图像分割成属于不同语义类别的区域。
与目标检测不同,语义分割可以识别并理解图像中每一个像素的内容:其语义区域的标注和预测是像素级的。
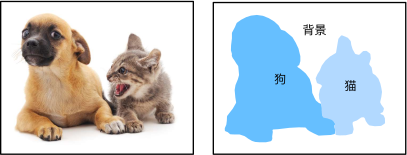
:numref:fig_segmentation展示了语义分割中图像有关狗、猫和背景的标签。
与目标检测相比,语义分割标注的像素级的边框显然更加精细。
图像分割和实例分割
计算机视觉领域还有2个与语义分割相似的重要问题,即图像分割(image segmentation)和实例分割(instance segmentation)。
我们在这里将它们同语义分割简单区分一下。
- 图像分割将图像划分为若干组成区域,这类问题的方法通常利用图像中像素之间的相关性。它在训练时不需要有关图像像素的标签信息,在预测时也无法保证分割出的区域具有我们希望得到的语义。以 :numref:
fig_segmentation中的图像作为输入,图像分割可能会将狗分为两个区域:一个覆盖以黑色为主的嘴和眼睛,另一个覆盖以黄色为主的其余部分身体。 - 实例分割也叫同时检测并分割(simultaneous detection and segmentation),它研究如何识别图像中各个目标实例的像素级区域。与语义分割不同,实例分割不仅需要区分语义,还要区分不同的目标实例。例如,如果图像中有两条狗,则实例分割需要区分像素属于的两条狗中的哪一条。
Pascal VOC2012 语义分割数据集
[最重要的语义分割数据集之一是Pascal VOC2012。]
下面我们深入了解一下这个数据集。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
import os
数据集的tar文件大约为2GB,所以下载可能需要一段时间。
提取出的数据集位于../data/VOCdevkit/VOC2012。
进入路径../data/VOCdevkit/VOC2012之后,我们可以看到数据集的不同组件。
ImageSets/Segmentation路径包含用于训练和测试样本的文本文件,而JPEGImages和SegmentationClass路径分别存储着每个示例的输入图像和标签。
此处的标签也采用图像格式,其尺寸和它所标注的输入图像的尺寸相同。
此外,标签中颜色相同的像素属于同一个语义类别。
下面将read_voc_images函数定义为[将所有输入的图像和标签读入内存]。
#@save
def read_voc_images(voc_dir, is_train=True):
    """读取所有VOC图像并标注"""
    txt_fname = os.path.join(voc_dir, 'ImageSets', 'Segmentation',
                             'train.txt' if is_train else 'val.txt')
    mode = torchvision.io.image.ImageReadMode.RGB
    with open(txt_fname, 'r') as f:
        images = f.read().split()
    features, labels = [], []
    for i, fname in enumerate(images):
        features.append(torchvision.io.read_image(os.path.join(
            voc_dir, 'JPEGImages', f'{fname}.jpg')))
        labels.append(torchvision.io.read_image(os.path.join(
            voc_dir, 'SegmentationClass' ,f'{fname}.png'), mode))
    return features, labels

train_features, train_labels = read_voc_images(voc_dir, True)下面我们[绘制前5个输入图像及其标签]。
在标签图像中,白色和黑色分别表示边框和背景,而其他颜色则对应不同的类别。
n = 5
imgs = train_features[0:n] + train_labels[0:n]
imgs = [img.permute(1,2,0) for img in imgs]
d2l.show_images(imgs, 2, n);接下来,我们[列举RGB颜色值和类名]。
通过上面定义的两个常量,我们可以方便地[查找标签中每个像素的类索引]。
我们定义了voc_colormap2label函数来构建从上述RGB颜色值到类别索引的映射,而voc_label_indices函数将RGB值映射到在Pascal VOC2012数据集中的类别索引。
#@save
def voc_colormap2label():
    """构建从RGB到VOC类别索引的映射"""
    colormap2label = torch.zeros(256 ** 3, dtype=torch.long)
    for i, colormap in enumerate(VOC_COLORMAP):
        colormap2label[
            (colormap[0] * 256 + colormap[1]) * 256 + colormap[2]] = i
    return colormap2label

#@save
def voc_label_indices(colormap, colormap2label):
    """将VOC标签中的RGB值映射到它们的类别索引"""
    colormap = colormap.permute(1, 2, 0).numpy().astype('int32')
    idx = ((colormap[:, :, 0] * 256 + colormap[:, :, 1]) * 256
           + colormap[:, :, 2])
return colormap2label[idx][例如],在第一张样本图像中,飞机头部区域的类别索引为1,而背景索引为0。
预处理数据
在之前的实验,例如 :numref:sec_alexnet— :numref:sec_googlenet中,我们通过再缩放图像使其符合模型的输入形状。
然而在语义分割中,这样做需要将预测的像素类别重新映射回原始尺寸的输入图像。
这样的映射可能不够精确,尤其在不同语义的分割区域。
为了避免这个问题,我们将图像裁剪为固定尺寸,而不是再缩放。
具体来说,我们[使用图像增广中的随机裁剪,裁剪输入图像和标签的相同区域]。
#@save
def voc_rand_crop(feature, label, height, width):
    """随机裁剪特征和标签图像"""
    rect = torchvision.transforms.RandomCrop.get_params(
        feature, (height, width))
    feature = torchvision.transforms.functional.crop(feature, *rect)
    label = torchvision.transforms.functional.crop(label, *rect)
    return feature, label
imgs = []
for _ in range(n):
imgs += voc_rand_crop(train_features[0], train_labels[0], 200, 300)
imgs = [img.permute(1, 2, 0) for img in imgs]
d2l.show_images(imgs[::2] + imgs[1::2], 2, n);[自定义语义分割数据集类]
我们通过继承高级API提供的Dataset类,自定义了一个语义分割数据集类VOCSegDataset。
通过实现__getitem__函数,我们可以任意访问数据集中索引为idx的输入图像及其每个像素的类别索引。
由于数据集中有些图像的尺寸可能小于随机裁剪所指定的输出尺寸,这些样本可以通过自定义的filter函数移除掉。
此外,我们还定义了normalize_image函数,从而对输入图像的RGB三个通道的值分别做标准化。
#@save
class VOCSegDataset(torch.utils.data.Dataset):
    """一个用于加载VOC数据集的自定义数据集"""

    def __init__(self, is_train, crop_size, voc_dir):
        self.transform = torchvision.transforms.Normalize(
            mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
        self.crop_size = crop_size
        features, labels = read_voc_images(voc_dir, is_train=is_train)
        self.features = [self.normalize_image(feature)
                         for feature in self.filter(features)]
        self.labels = self.filter(labels)
        self.colormap2label = voc_colormap2label()
        print('read ' + str(len(self.features)) + ' examples')

    def normalize_image(self, img):
        return self.transform(img.float() / 255)

    def filter(self, imgs):
        return [img for img in imgs if (
            img.shape[1] >= self.crop_size[0] and
            img.shape[2] >= self.crop_size[1])]

    def __getitem__(self, idx):
        feature, label = voc_rand_crop(self.features[idx], self.labels[idx],
                                       *self.crop_size)
        return (feature, voc_label_indices(label, self.colormap2label))

    def __len__(self):
return len(self.features)[读取数据集]
我们通过自定义的VOCSegDataset类来分别创建训练集和测试集的实例。
假设我们指定随机裁剪的输出图像的形状为,
下面我们可以查看训练集和测试集所保留的样本个数。
设批量大小为64,我们定义训练集的迭代器。
打印第一个小批量的形状会发现:与图像分类或目标检测不同,这里的标签是一个三维数组。
batch_size = 64
train_iter = torch.utils.data.DataLoader(voc_train, batch_size, shuffle=True,
                                    drop_last=True,
                                    num_workers=d2l.get_dataloader_workers())
for X, Y in train_iter:
    print(X.shape)
    print(Y.shape)
break[整合所有组件]
最后,我们定义以下load_data_voc函数来下载并读取Pascal VOC2012语义分割数据集。
它返回训练集和测试集的数据迭代器。
#@save
def load_data_voc(batch_size, crop_size):
    """加载VOC语义分割数据集"""
    voc_dir = d2l.download_extract('voc2012', os.path.join(
        'VOCdevkit', 'VOC2012'))
    num_workers = d2l.get_dataloader_workers()
    train_iter = torch.utils.data.DataLoader(
        VOCSegDataset(True, crop_size, voc_dir), batch_size,
        shuffle=True, drop_last=True, num_workers=num_workers)
    test_iter = torch.utils.data.DataLoader(
        VOCSegDataset(False, crop_size, voc_dir), batch_size,
        drop_last=True, num_workers=num_workers)
    return train_iter, test_iter
小结
- 语义分割通过将图像划分为属于不同语义类别的区域,来识别并理解图像中像素级别的内容。
- 语义分割的一个重要的数据集叫做Pascal VOC2012。
- 由于语义分割的输入图像和标签在像素上一一对应,输入图像会被随机裁剪为固定尺寸而不是缩放。
练习
- 如何在自动驾驶和医疗图像诊断中应用语义分割?还能想到其他领域的应用吗?
- 回想一下 :numref:
sec_image_augmentation中对数据增强的描述。图像分类中使用的哪种图像增强方法是难以用于语义分割的?
转置卷积
到目前为止,我们所见到的卷积神经网络层,例如卷积层( :numref:sec_conv_layer)和汇聚层( :numref:sec_pooling),通常会减少下采样输入图像的空间维度(高和宽)。
然而如果输入和输出图像的空间维度相同,在以像素级分类的语义分割中将会很方便。
例如,输出像素所处的通道维可以保有输入像素在同一位置上的分类结果。
为了实现这一点,尤其是在空间维度被卷积神经网络层缩小后,我们可以使用另一种类型的卷积神经网络层,它可以增加上采样中间层特征图的空间维度。
本节将介绍
转置卷积(transposed convolution) (Dumoulin.Visin.2016),
用于逆转下采样导致的空间尺寸减小。
import torch
from torch import nn
from d2l import torch as d2l
基本操作
让我们暂时忽略通道,从基本的转置卷积开始,设步幅为1且没有填充。
假设我们有一个的输入张量和一个的卷积核。
以步幅为1滑动卷积核窗口,每行次,每列次,共产生个中间结果。
每个中间结果都是一个的张量,初始化为0。
为了计算每个中间张量,输入张量中的每个元素都要乘以卷积核,从而使所得的张量替换中间张量的一部分。
请注意,每个中间张量被替换部分的位置与输入张量中元素的位置相对应。
最后,所有中间结果相加以获得最终结果。
例如, :numref:fig_trans_conv解释了如何为的输入张量计算卷积核为的转置卷积。
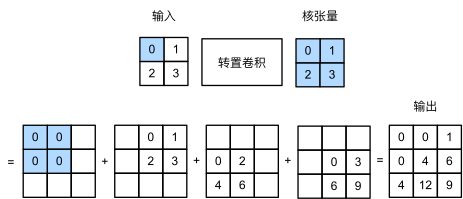 的转置卷积。阴影部分是中间张量的一部分,也是用于计算的输入和卷积核张量元素。 " />
我们可以对输入矩阵X和卷积核矩阵K(实现基本的转置卷积运算)trans_conv。
与通过卷积核“减少”输入元素的常规卷积(在 :numref:sec_conv_layer中)相比,转置卷积通过卷积核“广播”输入元素,从而产生大于输入的输出。
我们可以通过 :numref:fig_trans_conv来构建输入张量X和卷积核张量K从而[验证上述实现输出]。
此实现是基本的二维转置卷积运算。
或者,当输入X和卷积核K都是四维张量时,我们可以[使用高级API获得相同的结果]。
X, K = X.reshape(1, 1, 2, 2), K.reshape(1, 1, 2, 2)
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, bias=False)
tconv.weight.data = K
tconv(X)[填充、步幅和多通道]
与常规卷积不同,在转置卷积中,填充被应用于的输出(常规卷积将填充应用于输入)。
例如,当将高和宽两侧的填充数指定为1时,转置卷积的输出中将删除第一和最后的行与列。
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, padding=1, bias=False)
tconv.weight.data = K
tconv(X)
在转置卷积中,步幅被指定为中间结果(输出),而不是输入。
使用 :numref:fig_trans_conv中相同输入和卷积核张量,将步幅从1更改为2会增加中间张量的高和权重,因此输出张量在 :numref:fig_trans_conv_stride2中。
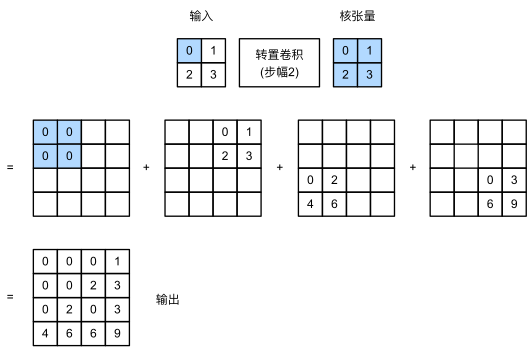 ,步幅为2的转置卷积。阴影部分是中间张量的一部分,也是用于计算的输入和卷积核张量元素。" />
以下代码可以验证 :numref:fig_trans_conv_stride2中步幅为2的转置卷积的输出。
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, stride=2, bias=False)
tconv.weight.data = K
tconv(X)
对于多个输入和输出通道,转置卷积与常规卷积以相同方式运作。
假设输入有个通道,且转置卷积为每个输入通道分配了一个的卷积核张量。
当指定多个输出通道时,每个输出通道将有一个的卷积核。
同样,如果我们将代入卷积层来输出,并创建一个与具有相同的超参数、但输出通道数量是中通道数的转置卷积层,那么的形状将与相同。
下面的示例可以解释这一点。
X = torch.rand(size=(1, 10, 16, 16))
conv = nn.Conv2d(10, 20, kernel_size=5, padding=2, stride=3)
tconv = nn.ConvTranspose2d(20, 10, kernel_size=5, padding=2, stride=3)
tconv(conv(X)).shape == X.shape[与矩阵变换的联系]
转置卷积为何以矩阵变换命名呢?
让我们首先看看如何使用矩阵乘法来实现卷积。
在下面的示例中,我们定义了一个的输入X和卷积核K,然后使用corr2d函数计算卷积输出Y。
接下来,我们将卷积核K重写为包含大量0的稀疏权重矩阵W。
权重矩阵的形状是(,),其中非0元素来自卷积核K。
逐行连结输入X,获得了一个长度为9的矢量。
然后,W的矩阵乘法和向量化的X给出了一个长度为4的向量。
重塑它之后,可以获得与上面的原始卷积操作所得相同的结果Y:我们刚刚使用矩阵乘法实现了卷积。
同样,我们可以使用矩阵乘法来实现转置卷积。
在下面的示例中,我们将上面的常规卷积的输出Y作为转置卷积的输入。
想要通过矩阵相乘来实现它,我们只需要将权重矩阵W的形状转置为。
抽象来看,给定输入向量和权重矩阵,卷积的前向传播函数可以通过将其输入与权重矩阵相乘并输出向量来实现。
由于反向传播遵循链式法则和,卷积的反向传播函数可以通过将其输入与转置的权重矩阵相乘来实现。
因此,转置卷积层能够交换卷积层的正向传播函数和反向传播函数:它的正向传播和反向传播函数将输入向量分别与和相乘。
小结
- 与通过卷积核减少输入元素的常规卷积相反,转置卷积通过卷积核广播输入元素,从而产生形状大于输入的输出。
- 如果我们将输入卷积层来获得输出并创造一个与有相同的超参数、但输出通道数是中通道数的转置卷积层,那么的形状将与相同。
- 我们可以使用矩阵乘法来实现卷积。转置卷积层能够交换卷积层的正向传播函数和反向传播函数。
练习
- 在 :numref:
subsec-connection-to-mat-transposition中,卷积输入X和转置的卷积输出Z具有相同的形状。他们的数值也相同吗?为什么? - 使用矩阵乘法来实现卷积是否有效率?为什么?
全卷积网络
如 :numref:sec_semantic_segmentation中所介绍的那样,语义分割是对图像中的每个像素分类。
全卷积网络(fully convolutional network,FCN)采用卷积神经网络实现了从图像像素到像素类别的变换 (Long.Shelhamer.Darrell.2015)。
与我们之前在图像分类或目标检测部分介绍的卷积神经网络不同,全卷积网络将中间层特征图的高和宽变换回输入图像的尺寸:这是通过在 :numref:sec_transposed_conv中引入的转置卷积(transposed convolution)实现的。
因此,输出的类别预测与输入图像在像素级别上具有一一对应关系:通道维的输出即该位置对应像素的类别预测。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
构造模型
下面我们了解一下全卷积网络模型最基本的设计。
如 :numref:fig_fcn所示,全卷积网络先使用卷积神经网络抽取图像特征,然后通过卷积层将通道数变换为类别个数,最后在 :numref:sec_transposed_conv中通过转置卷积层将特征图的高和宽变换为输入图像的尺寸。
因此,模型输出与输入图像的高和宽相同,且最终输出通道包含了该空间位置像素的类别预测。
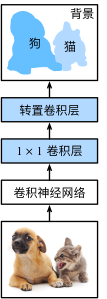
下面,我们[使用在ImageNet数据集上预训练的ResNet-18模型来提取图像特征],并将该网络记为pretrained_net。
ResNet-18模型的最后几层包括全局平均汇聚层和全连接层,然而全卷积网络中不需要它们。
pretrained_net = torchvision.models.resnet18(pretrained=True)
list(pretrained_net.children())[-3:]接下来,我们[创建一个全卷积网络net]。
它复制了ResNet-18中大部分的预训练层,除了最后的全局平均汇聚层和最接近输出的全连接层。
, paddle
net = nn.Sequential(*list(pretrained_net.children())[:-2])给定高度为320和宽度为480的输入,net的前向传播将输入的高和宽减小至原来的,即10和15。
X = torch.rand(size=(1, 3, 320, 480))
net(X).shape接下来[使用卷积层将输出通道数转换为Pascal VOC2012数据集的类数(21类)。]
最后需要(将特征图的高度和宽度增加32倍),从而将其变回输入图像的高和宽。
回想一下 :numref:sec_padding中卷积层输出形状的计算方法:
由于且,我们构造一个步幅为的转置卷积层,并将卷积核的高和宽设为,填充为。
我们可以看到如果步幅为,填充为(假设是整数)且卷积核的高和宽为,转置卷积核会将输入的高和宽分别放大倍。
num_classes = 21
net.add_module('final_conv', nn.Conv2d(512, num_classes, kernel_size=1))
net.add_module('transpose_conv', nn.ConvTranspose2d(num_classes, num_classes,
kernel_size=64, padding=16, stride=32))[初始化转置卷积层]
在图像处理中,我们有时需要将图像放大,即上采样(upsampling)。
双线性插值(bilinear interpolation)
是常用的上采样方法之一,它也经常用于初始化转置卷积层。
为了解释双线性插值,假设给定输入图像,我们想要计算上采样输出图像上的每个像素。
- 将输出图像的坐标映射到输入图像的坐标上。
例如,根据输入与输出的尺寸之比来映射。
请注意,映射后的和是实数。 - 在输入图像上找到离坐标最近的4个像素。
- 输出图像在坐标上的像素依据输入图像上这4个像素及其与的相对距离来计算。
双线性插值的上采样可以通过转置卷积层实现,内核由以下bilinear_kernel函数构造。
限于篇幅,我们只给出bilinear_kernel函数的实现,不讨论算法的原理。
def bilinear_kernel(in_channels, out_channels, kernel_size):
    factor = (kernel_size + 1) // 2
    if kernel_size % 2 == 1:
        center = factor - 1
    else:
        center = factor - 0.5
    og = (torch.arange(kernel_size).reshape(-1, 1),
          torch.arange(kernel_size).reshape(1, -1))
    filt = (1 - torch.abs(og[0] - center) / factor) * \
           (1 - torch.abs(og[1] - center) / factor)
    weight = torch.zeros((in_channels, out_channels,
                          kernel_size, kernel_size))
    weight[range(in_channels), range(out_channels), :, :] = filt
return weight让我们用[双线性插值的上采样实验]它由转置卷积层实现。
我们构造一个将输入的高和宽放大2倍的转置卷积层,并将其卷积核用bilinear_kernel函数初始化。
conv_trans = nn.ConvTranspose2d(3, 3, kernel_size=4, padding=1, stride=2,
                                bias=False)
conv_trans.weight.data.copy_(bilinear_kernel(3, 3, 4));读取图像X,将上采样的结果记作Y。为了打印图像,我们需要调整通道维的位置。
img = torchvision.transforms.ToTensor()(d2l.Image.open('../img/catdog.jpg'))
X = img.unsqueeze(0)
Y = conv_trans(X)
out_img = Y[0].permute(1, 2, 0).detach()
可以看到,转置卷积层将图像的高和宽分别放大了2倍。
除了坐标刻度不同,双线性插值放大的图像和在 :numref:sec_bbox中打印出的原图看上去没什么两样。
d2l.set_figsize()
print('input image shape:', img.permute(1, 2, 0).shape)
d2l.plt.imshow(img.permute(1, 2, 0));
print('output image shape:', out_img.shape)
d2l.plt.imshow(out_img);全卷积网络[用双线性插值的上采样初始化转置卷积层。对于卷积层,我们使用Xavier初始化参数。]
W = bilinear_kernel(num_classes, num_classes, 64)
net.transpose_conv.weight.data.copy_(W);[读取数据集]
我们用 :numref:sec_semantic_segmentation中介绍的语义分割读取数据集。
指定随机裁剪的输出图像的形状为:高和宽都可以被整除。
[训练]
现在我们可以训练全卷积网络了。
这里的损失函数和准确率计算与图像分类中的并没有本质上的不同,因为我们使用转置卷积层的通道来预测像素的类别,所以需要在损失计算中指定通道维。
此外,模型基于每个像素的预测类别是否正确来计算准确率。
def loss(inputs, targets):
    return F.cross_entropy(inputs, targets, reduction='none').mean(1).mean(1)

num_epochs, lr, wd, devices = 5, 0.001, 1e-3, d2l.try_all_gpus()
trainer = torch.optim.SGD(net.parameters(), lr=lr, weight_decay=wd)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)[预测]
在预测时,我们需要将输入图像在各个通道做标准化,并转成卷积神经网络所需要的四维输入格式。
def predict(img):
    X = test_iter.dataset.normalize_image(img).unsqueeze(0)
    pred = net(X.to(devices[0])).argmax(dim=1)
return pred.reshape(pred.shape[1], pred.shape[2])为了[可视化预测的类别]给每个像素,我们将预测类别映射回它们在数据集中的标注颜色。
def label2image(pred):
    colormap = torch.tensor(d2l.VOC_COLORMAP, device=devices[0])
    X = pred.long()
    return colormap[X, :]
测试数据集中的图像大小和形状各异。
由于模型使用了步幅为32的转置卷积层,因此当输入图像的高或宽无法被32整除时,转置卷积层输出的高或宽会与输入图像的尺寸有偏差。
为了解决这个问题,我们可以在图像中截取多块高和宽为32的整数倍的矩形区域,并分别对这些区域中的像素做前向传播。
请注意,这些区域的并集需要完整覆盖输入图像。
当一个像素被多个区域所覆盖时,它在不同区域前向传播中转置卷积层输出的平均值可以作为softmax运算的输入,从而预测类别。
为简单起见,我们只读取几张较大的测试图像,并从图像的左上角开始截取形状为的区域用于预测。
对于这些测试图像,我们逐一打印它们截取的区域,再打印预测结果,最后打印标注的类别。
voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
test_images, test_labels = d2l.read_voc_images(voc_dir, False)
n, imgs = 4, []
for i in range(n):
    crop_rect = (0, 0, 320, 480)
    X = torchvision.transforms.functional.crop(test_images[i], *crop_rect)
    pred = label2image(predict(X))
    imgs += [X.permute(1,2,0), pred.cpu(),
             torchvision.transforms.functional.crop(
                 test_labels[i], *crop_rect).permute(1,2,0)]
d2l.show_images(imgs[::3] + imgs[1::3] + imgs[2::3], 3, n, scale=2);
小结
- 全卷积网络先使用卷积神经网络抽取图像特征,然后通过卷积层将通道数变换为类别个数,最后通过转置卷积层将特征图的高和宽变换为输入图像的尺寸。
- 在全卷积网络中,我们可以将转置卷积层初始化为双线性插值的上采样。
练习
- 如果将转置卷积层改用Xavier随机初始化,结果有什么变化?
- 调节超参数,能进一步提升模型的精度吗?
- 预测测试图像中所有像素的类别。
- 最初的全卷积网络的论文中 (Long.Shelhamer.Darrell.2015)还使用了某些卷积神经网络中间层的输出。试着实现这个想法。
风格迁移
摄影爱好者也许接触过滤波器。它能改变照片的颜色风格,从而使风景照更加锐利或者令人像更加美白。但一个滤波器通常只能改变照片的某个方面。如果要照片达到理想中的风格,可能需要尝试大量不同的组合。这个过程的复杂程度不亚于模型调参。
本节将介绍如何使用卷积神经网络,自动将一个图像中的风格应用在另一图像之上,即风格迁移(style transfer) (Gatys.Ecker.Bethge.2016)。
这里我们需要两张输入图像:一张是内容图像,另一张是风格图像。
我们将使用神经网络修改内容图像,使其在风格上接近风格图像。
例如, :numref:fig_style_transfer中的内容图像为本书作者在西雅图郊区的雷尼尔山国家公园拍摄的风景照,而风格图像则是一幅主题为秋天橡树的油画。
最终输出的合成图像应用了风格图像的油画笔触让整体颜色更加鲜艳,同时保留了内容图像中物体主体的形状。
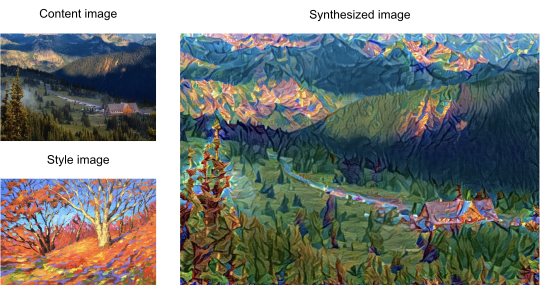
方法
:numref:fig_style_transfer_model用简单的例子阐述了基于卷积神经网络的风格迁移方法。
首先,我们初始化合成图像,例如将其初始化为内容图像。
该合成图像是风格迁移过程中唯一需要更新的变量,即风格迁移所需迭代的模型参数。
然后,我们选择一个预训练的卷积神经网络来抽取图像的特征,其中的模型参数在训练中无须更新。
这个深度卷积神经网络凭借多个层逐级抽取图像的特征,我们可以选择其中某些层的输出作为内容特征或风格特征。
以 :numref:fig_style_transfer_model为例,这里选取的预训练的神经网络含有3个卷积层,其中第二层输出内容特征,第一层和第三层输出风格特征。
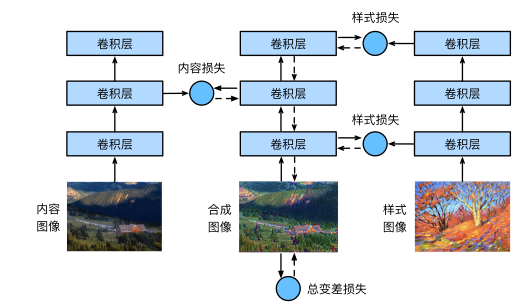
接下来,我们通过前向传播(实线箭头方向)计算风格迁移的损失函数,并通过反向传播(虚线箭头方向)迭代模型参数,即不断更新合成图像。
风格迁移常用的损失函数由3部分组成:
- 内容损失使合成图像与内容图像在内容特征上接近;
- 风格损失使合成图像与风格图像在风格特征上接近;
- 全变分损失则有助于减少合成图像中的噪点。
最后,当模型训练结束时,我们输出风格迁移的模型参数,即得到最终的合成图像。
在下面,我们将通过代码来进一步了解风格迁移的技术细节。
[阅读内容和风格图像]
首先,我们读取内容和风格图像。
从打印出的图像坐标轴可以看出,它们的尺寸并不一样。
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn

d2l.set_figsize()
content_img = d2l.Image.open('../img/rainier.jpg')
d2l.plt.imshow(content_img);
, paddle
style_img = d2l.Image.open('../img/autumn-oak.jpg')
d2l.plt.imshow(style_img);[预处理和后处理]
下面,定义图像的预处理函数和后处理函数。
预处理函数preprocess对输入图像在RGB三个通道分别做标准化,并将结果变换成卷积神经网络接受的输入格式。
后处理函数postprocess则将输出图像中的像素值还原回标准化之前的值。
由于图像打印函数要求每个像素的浮点数值在0~1之间,我们对小于0和大于1的值分别取0和1。
rgb_mean = torch.tensor([0.485, 0.456, 0.406])
rgb_std = torch.tensor([0.229, 0.224, 0.225])

def preprocess(img, image_shape):
    transforms = torchvision.transforms.Compose([
        torchvision.transforms.Resize(image_shape),
        torchvision.transforms.ToTensor(),
        torchvision.transforms.Normalize(mean=rgb_mean, std=rgb_std)])
    return transforms(img).unsqueeze(0)

def postprocess(img):
    img = img[0].to(rgb_std.device)
    img = torch.clamp(img.permute(1, 2, 0) * rgb_std + rgb_mean, 0, 1)
return torchvision.transforms.ToPILImage()(img.permute(2, 0, 1))[抽取图像特征]
我们使用基于ImageNet数据集预训练的VGG-19模型来抽取图像特征 (Gatys.Ecker.Bethge.2016)。
pretrained_net = torchvision.models.vgg19(pretrained=True)为了抽取图像的内容特征和风格特征,我们可以选择VGG网络中某些层的输出。
一般来说,越靠近输入层,越容易抽取图像的细节信息;反之,则越容易抽取图像的全局信息。
为了避免合成图像过多保留内容图像的细节,我们选择VGG较靠近输出的层,即内容层,来输出图像的内容特征。
我们还从VGG中选择不同层的输出来匹配局部和全局的风格,这些图层也称为风格层。
正如 :numref:sec_vgg中所介绍的,VGG网络使用了5个卷积块。
实验中,我们选择第四卷积块的最后一个卷积层作为内容层,选择每个卷积块的第一个卷积层作为风格层。
这些层的索引可以通过打印pretrained_net实例获取。
使用VGG层抽取特征时,我们只需要用到从输入层到最靠近输出层的内容层或风格层之间的所有层。
下面构建一个新的网络net,它只保留需要用到的VGG的所有层。
, paddle
net = nn.Sequential(*[pretrained_net.features[i] for i in
range(max(content_layers + style_layers) + 1)])给定输入X,如果我们简单地调用前向传播net(X),只能获得最后一层的输出。
由于我们还需要中间层的输出,因此这里我们逐层计算,并保留内容层和风格层的输出。
下面定义两个函数:get_contents函数对内容图像抽取内容特征;
get_styles函数对风格图像抽取风格特征。
因为在训练时无须改变预训练的VGG的模型参数,所以我们可以在训练开始之前就提取出内容特征和风格特征。
由于合成图像是风格迁移所需迭代的模型参数,我们只能在训练过程中通过调用extract_features函数来抽取合成图像的内容特征和风格特征。
def get_contents(image_shape, device):
    content_X = preprocess(content_img, image_shape).to(device)
    contents_Y, _ = extract_features(content_X, content_layers, style_layers)
    return content_X, contents_Y

def get_styles(image_shape, device):
    style_X = preprocess(style_img, image_shape).to(device)
    _, styles_Y = extract_features(style_X, content_layers, style_layers)
return style_X, styles_Y[定义损失函数]
下面我们来描述风格迁移的损失函数。
它由内容损失、风格损失和全变分损失3部分组成。
内容损失
与线性回归中的损失函数类似,内容损失通过平方误差函数衡量合成图像与内容图像在内容特征上的差异。
平方误差函数的两个输入均为extract_features函数计算所得到的内容层的输出。
def content_loss(Y_hat, Y):
    # 我们从动态计算梯度的树中分离目标:
    # 这是一个规定的值,而不是一个变量。
    return torch.square(Y_hat - Y.detach()).mean()
风格损失
风格损失与内容损失类似,也通过平方误差函数衡量合成图像与风格图像在风格上的差异。
为了表达风格层输出的风格,我们先通过extract_features函数计算风格层的输出。
假设该输出的样本数为1,通道数为,高和宽分别为和,我们可以将此输出转换为矩阵,其有行和列。
这个矩阵可以被看作由个长度为的向量组合而成的。其中向量代表了通道上的风格特征。
在这些向量的格拉姆矩阵中,行列的元素即向量和的内积。它表达了通道和通道上风格特征的相关性。我们用这样的格拉姆矩阵来表达风格层输出的风格。
需要注意的是,当的值较大时,格拉姆矩阵中的元素容易出现较大的值。
此外,格拉姆矩阵的高和宽皆为通道数。
为了让风格损失不受这些值的大小影响,下面定义的gram函数将格拉姆矩阵除以了矩阵中元素的个数,即。
自然地,风格损失的平方误差函数的两个格拉姆矩阵输入分别基于合成图像与风格图像的风格层输出。这里假设基于风格图像的格拉姆矩阵gram_Y已经预先计算好了。
def style_loss(Y_hat, gram_Y):
    return torch.square(gram(Y_hat) - gram_Y.detach()).mean()
全变分损失
有时候,我们学到的合成图像里面有大量高频噪点,即有特别亮或者特别暗的颗粒像素。
一种常见的去噪方法是全变分去噪(total variation denoising):
假设表示坐标处的像素值,降低全变分损失
能够尽可能使邻近的像素值相似。
损失函数
[风格转移的损失函数是内容损失、风格损失和总变化损失的加权和]。
通过调节这些权重超参数,我们可以权衡合成图像在保留内容、迁移风格以及去噪三方面的相对重要性。
[初始化合成图像]
在风格迁移中,合成的图像是训练期间唯一需要更新的变量。因此,我们可以定义一个简单的模型SynthesizedImage,并将合成的图像视为模型参数。模型的前向传播只需返回模型参数即可。
class SynthesizedImage(nn.Module):
    def __init__(self, img_shape, **kwargs):
        super(SynthesizedImage, self).__init__(**kwargs)
        self.weight = nn.Parameter(torch.rand(*img_shape))

    def forward(self):
return self.weight下面,我们定义get_inits函数。该函数创建了合成图像的模型实例,并将其初始化为图像X。风格图像在各个风格层的格拉姆矩阵styles_Y_gram将在训练前预先计算好。
def get_inits(X, device, lr, styles_Y):
    gen_img = SynthesizedImage(X.shape).to(device)
    gen_img.weight.data.copy_(X.data)
    trainer = torch.optim.Adam(gen_img.parameters(), lr=lr)
    styles_Y_gram = [gram(Y) for Y in styles_Y]
return gen_img(), styles_Y_gram, trainer[训练模型]
在训练模型进行风格迁移时,我们不断抽取合成图像的内容特征和风格特征,然后计算损失函数。下面定义了训练循环。
def train(X, contents_Y, styles_Y, device, lr, num_epochs, lr_decay_epoch):
    X, styles_Y_gram, trainer = get_inits(X, device, lr, styles_Y)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_decay_epoch, 0.8)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                            xlim=[10, num_epochs],
                            legend=['content', 'style', 'TV'],
                            ncols=2, figsize=(7, 2.5))
    for epoch in range(num_epochs):
        trainer.zero_grad()
        contents_Y_hat, styles_Y_hat = extract_features(
            X, content_layers, style_layers)
        contents_l, styles_l, tv_l, l = compute_loss(
            X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram)
        l.backward()
        trainer.step()
        scheduler.step()
        if (epoch + 1) % 10 == 0:
            animator.axes[1].imshow(postprocess(X))
            animator.add(epoch + 1, [float(sum(contents_l)),
                                     float(sum(styles_l)), float(tv_l)])
return X现在我们[训练模型]:
首先将内容图像和风格图像的高和宽分别调整为300和450像素,用内容图像来初始化合成图像。
device, image_shape = d2l.try_gpu(), (300, 450)
net = net.to(device)
content_X, contents_Y = get_contents(image_shape, device)
_, styles_Y = get_styles(image_shape, device)
output = train(content_X, contents_Y, styles_Y, device, 0.3, 500, 50)
我们可以看到,合成图像保留了内容图像的风景和物体,并同时迁移了风格图像的色彩。例如,合成图像具有与风格图像中一样的色彩块,其中一些甚至具有画笔笔触的细微纹理。
小结
- 风格迁移常用的损失函数由3部分组成:(1)内容损失使合成图像与内容图像在内容特征上接近;(2)风格损失令合成图像与风格图像在风格特征上接近;(3)全变分损失则有助于减少合成图像中的噪点。
- 我们可以通过预训练的卷积神经网络来抽取图像的特征,并通过最小化损失函数来不断更新合成图像来作为模型参数。
- 我们使用格拉姆矩阵表达风格层输出的风格。
练习
- 选择不同的内容和风格层,输出有什么变化?
- 调整损失函数中的权重超参数。输出是否保留更多内容或减少更多噪点?
- 替换实验中的内容图像和风格图像,能创作出更有趣的合成图像吗?
- 我们可以对文本使用风格迁移吗?提示:可以参阅调查报告 (Hu.Lee.Aggarwal.ea.2020)。
实战 Kaggle 比赛:图像分类 (CIFAR-10)
之前几节中,我们一直在使用深度学习框架的高级API直接获取张量格式的图像数据集。
但是在实践中,图像数据集通常以图像文件的形式出现。
本节将从原始图像文件开始,然后逐步组织、读取并将它们转换为张量格式。
我们在 :numref:sec_image_augmentation中对CIFAR-10数据集做了一个实验。CIFAR-10是计算机视觉领域中的一个重要的数据集。
本节将运用我们在前几节中学到的知识来参加CIFAR-10图像分类问题的Kaggle竞赛,(**比赛的网址是https://www.kaggle.com/c/cifar-10**)。
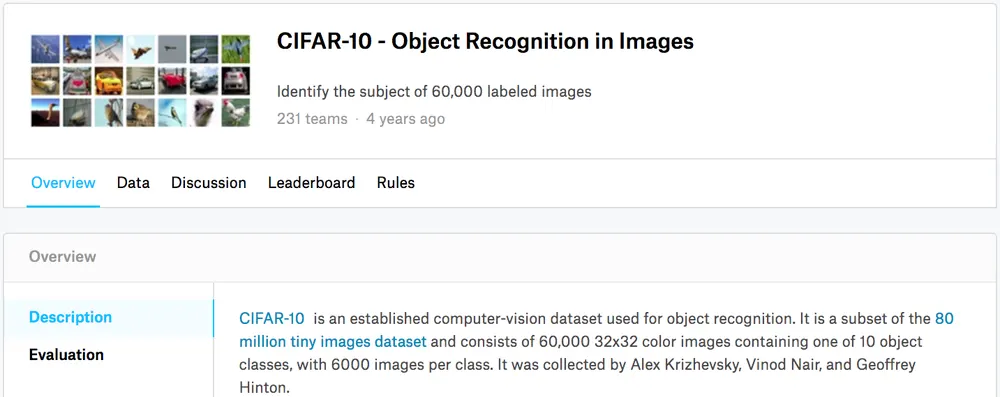
:numref:fig_kaggle_cifar10显示了竞赛网站页面上的信息。
为了能提交结果,首先需要注册一个Kaggle账户。
:width:600px
首先,导入竞赛所需的包和模块。
import collections
from d2l import torch as d2l
import math
import torch
import torchvision
from torch import nn
import os
import pandas as pd
import shutil
获取并组织数据集
比赛数据集分为训练集和测试集,其中训练集包含50000张、测试集包含300000张图像。
在测试集中,10000张图像将被用于评估,而剩下的290000张图像将不会被进行评估,包含它们只是为了防止手动标记测试集并提交标记结果。
两个数据集中的图像都是png格式,高度和宽度均为32像素并有三个颜色通道(RGB)。
这些图片共涵盖10个类别:飞机、汽车、鸟类、猫、鹿、狗、青蛙、马、船和卡车。
:numref:fig_kaggle_cifar10的左上角显示了数据集中飞机、汽车和鸟类的一些图像。
下载数据集
登录Kaggle后,我们可以点击 :numref:fig_kaggle_cifar10中显示的CIFAR-10图像分类竞赛网页上的“Data”选项卡,然后单击“Download All”按钮下载数据集。
在../data中解压下载的文件并在其中解压缩train.7z和test.7z后,在以下路径中可以找到整个数据集:
../data/cifar-10/train/[1-50000].png../data/cifar-10/test/[1-300000].png../data/cifar-10/trainLabels.csv../data/cifar-10/sampleSubmission.csv
train和test文件夹分别包含训练和测试图像,trainLabels.csv含有训练图像的标签,
sample_submission.csv是提交文件的范例。
为了便于入门,[我们提供包含前1000个训练图像和5个随机测试图像的数据集的小规模样本]。
要使用Kaggle竞赛的完整数据集,需要将以下demo变量设置为False。
[整理数据集]
我们需要整理数据集来训练和测试模型。
首先,我们用以下函数读取CSV文件中的标签,它返回一个字典,该字典将文件名中不带扩展名的部分映射到其标签。
接下来,我们定义reorg_train_valid函数来[将验证集从原始的训练集中拆分出来]。
此函数中的参数valid_ratio是验证集中的样本数与原始训练集中的样本数之比。
更具体地说,令等于样本最少的类别中的图像数量,而是比率。
验证集将为每个类别拆分出张图像。
让我们以valid_ratio=0.1为例,由于原始的训练集有50000张图像,因此train_valid_test/train路径中将有45000张图像用于训练,而剩下5000张图像将作为路径train_valid_test/valid中的验证集。
组织数据集后,同类别的图像将被放置在同一文件夹下。
下面的reorg_test函数用来[在预测期间整理测试集,以方便读取]。
最后,我们使用一个函数来[调用前面定义的函数]read_csv_labels、reorg_train_valid和reorg_test。
在这里,我们只将样本数据集的批量大小设置为32。
在实际训练和测试中,应该使用Kaggle竞赛的完整数据集,并将batch_size设置为更大的整数,例如128。
我们将10%的训练样本作为调整超参数的验证集。
[图像增广]
我们使用图像增广来解决过拟合的问题。例如在训练中,我们可以随机水平翻转图像。
我们还可以对彩色图像的三个RGB通道执行标准化。
下面,我们列出了其中一些可以调整的操作。
transform_train = torchvision.transforms.Compose([
    # 在高度和宽度上将图像放大到40像素的正方形
    torchvision.transforms.Resize(40),
    # 随机裁剪出一个高度和宽度均为40像素的正方形图像,
    # 生成一个面积为原始图像面积0.64~1倍的小正方形,
    # 然后将其缩放为高度和宽度均为32像素的正方形
    torchvision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
                                                   ratio=(1.0, 1.0)),
    torchvision.transforms.RandomHorizontalFlip(),
    torchvision.transforms.ToTensor(),
    # 标准化图像的每个通道
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])
在测试期间,我们只对图像执行标准化,以消除评估结果中的随机性。
transform_test = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])
读取数据集
接下来,我们[读取由原始图像组成的数据集],每个样本都包括一张图片和一个标签。
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_train) for folder in ['train', 'train_valid']]

valid_ds, test_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_test) for folder in ['valid', 'test']]在训练期间,我们需要[指定上面定义的所有图像增广操作]。
当验证集在超参数调整过程中用于模型评估时,不应引入图像增广的随机性。
在最终预测之前,我们根据训练集和验证集组合而成的训练模型进行训练,以充分利用所有标记的数据。
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
    dataset, batch_size, shuffle=True, drop_last=True)
    for dataset in (train_ds, train_valid_ds)]

valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
                                         drop_last=True)

test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
drop_last=False)定义[模型]
我们定义了 :numref:sec_resnet中描述的Resnet-18模型。
def get_net():
    num_classes = 10
    net = d2l.resnet18(num_classes, 3)
    return net

loss = nn.CrossEntropyLoss(reduction="none")定义[训练函数]
我们将根据模型在验证集上的表现来选择模型并调整超参数。
下面我们定义了模型训练函数train。
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
          lr_decay):
    trainer = torch.optim.SGD(net.parameters(), lr=lr, momentum=0.9,
                              weight_decay=wd)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
    num_batches, timer = len(train_iter), d2l.Timer()
    legend = ['train loss', 'train acc']
    if valid_iter is not None:
        legend.append('valid acc')
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=legend)
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    for epoch in range(num_epochs):
        net.train()
        metric = d2l.Accumulator(3)
        for i, (features, labels) in enumerate(train_iter):
            timer.start()
            l, acc = d2l.train_batch_ch13(net, features, labels,
                                          loss, trainer, devices)
            metric.add(l, acc, labels.shape[0])
            timer.stop()
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (metric[0] / metric[2], metric[1] / metric[2],
                              None))
        if valid_iter is not None:
            valid_acc = d2l.evaluate_accuracy_gpu(net, valid_iter)
            animator.add(epoch + 1, (None, None, valid_acc))
        scheduler.step()
    measures = (f'train loss {metric[0] / metric[2]:.3f}, '
                f'train acc {metric[1] / metric[2]:.3f}')
    if valid_iter is not None:
        measures += f', valid acc {valid_acc:.3f}'
    print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
f' examples/sec on {str(devices)}')[训练和验证模型]
现在,我们可以训练和验证模型了,而以下所有超参数都可以调整。
例如,我们可以增加周期的数量。当lr_period和lr_decay分别设置为4和0.9时,优化算法的学习速率将在每4个周期乘以0.9。
为便于演示,我们在这里只训练20个周期。
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 2e-4, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
      lr_decay)
在 Kaggle 上[对测试集进行分类并提交结果]
在获得具有超参数的满意的模型后,我们使用所有标记的数据(包括验证集)来重新训练模型并对测试集进行分类。
net, preds = get_net(), []
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
      lr_decay)

for X, _ in test_iter:
    y_hat = net(X.to(devices[0]))
    preds.extend(y_hat.argmax(dim=1).type(torch.int32).cpu().numpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.classes[x])
df.to_csv('submission.csv', index=False)
向Kaggle提交结果的方法与 :numref:sec_kaggle_house中的方法类似,上面的代码将生成一个
submission.csv文件,其格式符合Kaggle竞赛的要求。
小结
将包含原始图像文件的数据集组织为所需格式后,我们可以读取它们。
我们可以在图像分类竞赛中使用卷积神经网络和图像增广。
练习
- 在这场Kaggle竞赛中使用完整的CIFAR-10数据集。将超参数设为
batch_size = 128,num_epochs = 100,lr = 0.1,lr_period = 50,lr_decay = 0.1。看看在这场比赛中能达到什么准确度和排名。能进一步改进吗? - 不使用图像增广时,能获得怎样的准确度?
实战Kaggle比赛:狗的品种识别(ImageNet Dogs)
本节我们将在Kaggle上实战狗品种识别问题。
本次(**比赛网址是https://www.kaggle.com/c/dog-breed-identification**)。
:numref:fig_kaggle_dog显示了鉴定比赛网页上的信息。
需要一个Kaggle账户才能提交结果。
在这场比赛中,我们将识别120类不同品种的狗。
这个数据集实际上是著名的ImageNet的数据集子集。与 :numref:sec_kaggle_cifar10中CIFAR-10数据集中的图像不同,
ImageNet数据集中的图像更高更宽,且尺寸不一。
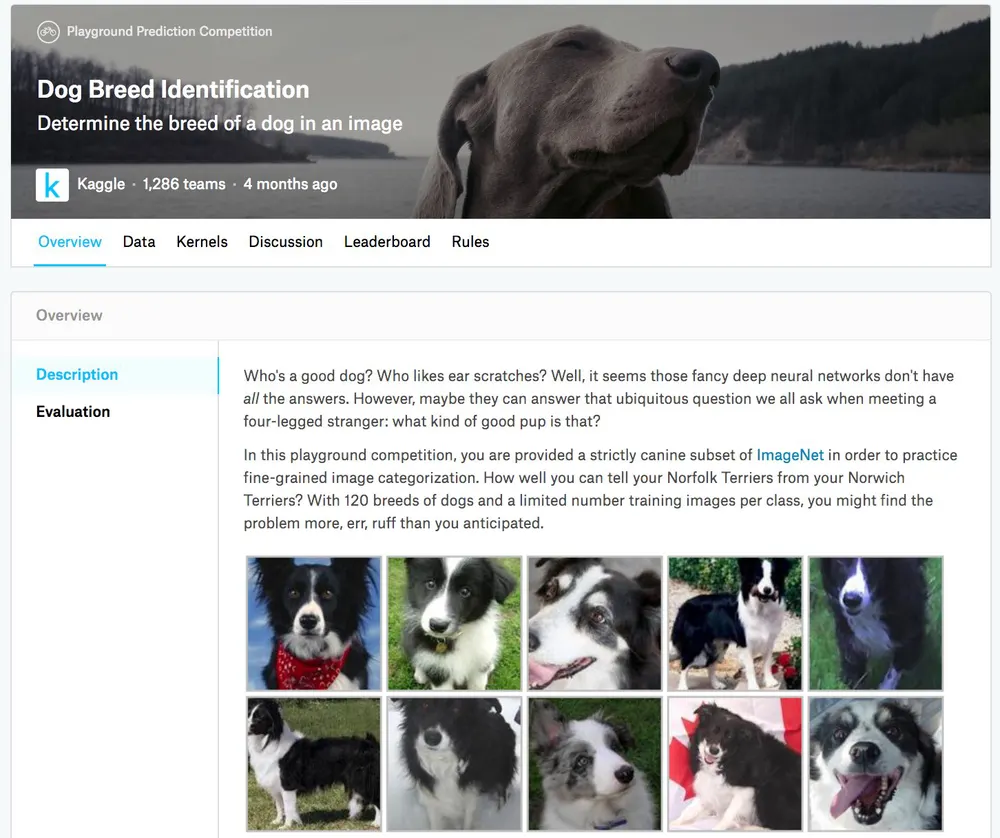
:width:400px
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
import os
获取和整理数据集
比赛数据集分为训练集和测试集,分别包含RGB(彩色)通道的10222张、10357张JPEG图像。
在训练数据集中,有120种犬类,如拉布拉多、贵宾、腊肠、萨摩耶、哈士奇、吉娃娃和约克夏等。
下载数据集
登录Kaggle后,可以点击 :numref:fig_kaggle_dog中显示的竞争网页上的“数据”选项卡,然后点击“全部下载”按钮下载数据集。在../data中解压下载的文件后,将在以下路径中找到整个数据集:
- ../data/dog-breed-identification/labels.csv
- ../data/dog-breed-identification/sample_submission.csv
- ../data/dog-breed-identification/train
- ../data/dog-breed-identification/test
上述结构与 :numref:sec_kaggle_cifar10的CIFAR-10类似,其中文件夹train/和test/分别包含训练和测试狗图像,labels.csv包含训练图像的标签。
同样,为了便于入门,[我们提供完整数据集的小规模样本]:train_valid_test_tiny.zip。
如果要在Kaggle比赛中使用完整的数据集,则需要将下面的demo变量更改为False。
[整理数据集]
我们可以像 :numref:sec_kaggle_cifar10中所做的那样整理数据集,即从原始训练集中拆分验证集,然后将图像移动到按标签分组的子文件夹中。
下面的reorg_dog_data函数读取训练数据标签、拆分验证集并整理训练集。
[图像增广]
回想一下,这个狗品种数据集是ImageNet数据集的子集,其图像大于 :numref:sec_kaggle_cifar10中CIFAR-10数据集的图像。
下面我们看一下如何在相对较大的图像上使用图像增广。
transform_train = torchvision.transforms.Compose([
    # 随机裁剪图像,所得图像为原始面积的0.08~1之间,高宽比在3/4和4/3之间。
    # 然后,缩放图像以创建224x224的新图像
    torchvision.transforms.RandomResizedCrop(224, scale=(0.08, 1.0),
                                             ratio=(3.0/4.0, 4.0/3.0)),
    torchvision.transforms.RandomHorizontalFlip(),
    # 随机更改亮度,对比度和饱和度
    torchvision.transforms.ColorJitter(brightness=0.4,
                                       contrast=0.4,
                                       saturation=0.4),
    # 添加随机噪声
    torchvision.transforms.ToTensor(),
    # 标准化图像的每个通道
    torchvision.transforms.Normalize([0.485, 0.456, 0.406],
                                     [0.229, 0.224, 0.225])])
测试时,我们只使用确定性的图像预处理操作。
transform_test = torchvision.transforms.Compose([
    torchvision.transforms.Resize(256),
    # 从图像中心裁切224x224大小的图片
    torchvision.transforms.CenterCrop(224),
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])[读取数据集]
与 :numref:sec_kaggle_cifar10一样,我们可以读取整理后的含原始图像文件的数据集。
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_train) for folder in ['train', 'train_valid']]

valid_ds, test_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_test) for folder in ['valid', 'test']]
下面我们创建数据加载器实例的方式与 :numref:sec_kaggle_cifar10相同。
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
    dataset, batch_size, shuffle=True, drop_last=True)
    for dataset in (train_ds, train_valid_ds)]

valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
                                         drop_last=True)

test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
drop_last=False)[微调预训练模型]
同样,本次比赛的数据集是ImageNet数据集的子集。
因此,我们可以使用 :numref:sec_fine_tuning中讨论的方法在完整ImageNet数据集上选择预训练的模型,然后使用该模型提取图像特征,以便将其输入到定制的小规模输出网络中。
深度学习框架的高级API提供了在ImageNet数据集上预训练的各种模型。
在这里,我们选择预训练的ResNet-34模型,我们只需重复使用此模型的输出层(即提取的特征)的输入。
然后,我们可以用一个可以训练的小型自定义输出网络替换原始输出层,例如堆叠两个完全连接的图层。
与 :numref:sec_fine_tuning中的实验不同,以下内容不重新训练用于特征提取的预训练模型,这节省了梯度下降的时间和内存空间。
回想一下,我们使用三个RGB通道的均值和标准差来对完整的ImageNet数据集进行图像标准化。
事实上,这也符合ImageNet上预训练模型的标准化操作。
def get_net(devices):
    finetune_net = nn.Sequential()
    finetune_net.features = torchvision.models.resnet34(pretrained=True)
    # 定义一个新的输出网络,共有120个输出类别
    finetune_net.output_new = nn.Sequential(nn.Linear(1000, 256),
                                            nn.ReLU(),
                                            nn.Linear(256, 120))
    # 将模型参数分配给用于计算的CPU或GPU
    finetune_net = finetune_net.to(devices[0])
    # 冻结参数
    for param in finetune_net.features.parameters():
        param.requires_grad = False
return finetune_net在[计算损失]之前,我们首先获取预训练模型的输出层的输入,即提取的特征。
然后我们使用此特征作为我们小型自定义输出网络的输入来计算损失。
loss = nn.CrossEntropyLoss(reduction='none')

def evaluate_loss(data_iter, net, devices):
    l_sum, n = 0.0, 0
    for features, labels in data_iter:
        features, labels = features.to(devices[0]), labels.to(devices[0])
        outputs = net(features)
        l = loss(outputs, labels)
        l_sum += l.sum()
        n += labels.numel()
return (l_sum / n).to('cpu')定义[训练函数]
我们将根据模型在验证集上的表现选择模型并调整超参数。
模型训练函数train只迭代小型自定义输出网络的参数。
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
          lr_decay):
    # 只训练小型自定义输出网络
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    trainer = torch.optim.SGD((param for param in net.parameters()
                               if param.requires_grad), lr=lr,
                              momentum=0.9, weight_decay=wd)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
    num_batches, timer = len(train_iter), d2l.Timer()
    legend = ['train loss']
    if valid_iter is not None:
        legend.append('valid loss')
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=legend)
    for epoch in range(num_epochs):
        metric = d2l.Accumulator(2)
        for i, (features, labels) in enumerate(train_iter):
            timer.start()
            features, labels = features.to(devices[0]), labels.to(devices[0])
            trainer.zero_grad()
            output = net(features)
            l = loss(output, labels).sum()
            l.backward()
            trainer.step()
            metric.add(l, labels.shape[0])
            timer.stop()
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (metric[0] / metric[1], None))
        measures = f'train loss {metric[0] / metric[1]:.3f}'
        if valid_iter is not None:
            valid_loss = evaluate_loss(valid_iter, net, devices)
            animator.add(epoch + 1, (None, valid_loss.detach().cpu()))
        scheduler.step()
    if valid_iter is not None:
        measures += f', valid loss {valid_loss:.3f}'
    print(measures + f'\n{metric[1] * num_epochs / timer.sum():.1f}'
f' examples/sec on {str(devices)}')[训练和验证模型]
现在我们可以训练和验证模型了,以下超参数都是可调的。
例如,我们可以增加迭代轮数。
另外,由于lr_period和lr_decay分别设置为2和0.9,
因此优化算法的学习速率将在每2个迭代后乘以0.9。
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 10, 1e-4, 1e-4
lr_period, lr_decay, net = 2, 0.9, get_net(devices)
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)[对测试集分类]并在Kaggle提交结果
与 :numref:sec_kaggle_cifar10中的最后一步类似,最终所有标记的数据(包括验证集)都用于训练模型和对测试集进行分类。
我们将使用训练好的自定义输出网络进行分类。
net = get_net(devices)
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
      lr_decay)

preds = []
for data, label in test_iter:
    output = torch.nn.functional.softmax(net(data.to(devices[0])), dim=1)
    preds.extend(output.cpu().detach().numpy())
ids = sorted(os.listdir(
    os.path.join(data_dir, 'train_valid_test', 'test', 'unknown')))
with open('submission.csv', 'w') as f:
    f.write('id,' + ','.join(train_valid_ds.classes) + '\n')
    for i, output in zip(ids, preds):
        f.write(i.split('.')[0] + ',' + ','.join(
[str(num) for num in output]) + '\n')上面的代码将生成一个submission.csv文件,以 :numref:sec_kaggle_house中描述的方式提在Kaggle上提交。
小结
- ImageNet数据集中的图像比CIFAR-10图像尺寸大,我们可能会修改不同数据集上任务的图像增广操作。
- 要对ImageNet数据集的子集进行分类,我们可以利用完整ImageNet数据集上的预训练模型来提取特征并仅训练小型自定义输出网络,这将减少计算时间和节省内存空间。
练习
- 试试使用完整Kaggle比赛数据集,增加
batch_size(批量大小)和num_epochs(迭代轮数),或者设计其它超参数为lr = 0.01,lr_period = 10,和lr_decay = 0.1时,能取得什么结果? - 如果使用更深的预训练模型,会得到更好的结果吗?如何调整超参数?能进一步改善结果吗?