13 / 19
注意力机制
灵长类动物的视觉系统接受了大量的感官输入,
这些感官输入远远超过了大脑能够完全处理的程度。
然而,并非所有刺激的影响都是相等的。
意识的聚集和专注使灵长类动物能够在复杂的视觉环境中将注意力引向感兴趣的物体,例如猎物和天敌。
只关注一小部分信息的能力对进化更加有意义,使人类得以生存和成功。
自19世纪以来,科学家们一直致力于研究认知神经科学领域的注意力。
本章的很多章节将涉及到一些研究。
首先回顾一个经典注意力框架,解释如何在视觉场景中展开注意力。
受此框架中的注意力提示(attention cues)的启发,
我们将设计能够利用这些注意力提示的模型。
1964年的Nadaraya-Waston核回归(kernel regression)正是具有
注意力机制(attention mechanism)的机器学习的简单演示。
然后继续介绍的是注意力函数,它们在深度学习的注意力模型设计中被广泛使用。
具体来说,我们将展示如何使用这些函数来设计Bahdanau注意力。
Bahdanau注意力是深度学习中的具有突破性价值的注意力模型,它双向对齐并且可以微分。
最后将描述仅仅基于注意力机制的Transformer架构,
该架构中使用了多头注意力(multi-head attention)
和自注意力(self-attention)。
自2017年横空出世,Transformer一直都普遍存在于现代的深度学习应用中,
例如语言、视觉、语音和强化学习领域。
:maxdepth: 2

attention-cues
nadaraya-waston
attention-scoring-functions
bahdanau-attention
multihead-attention
self-attention-and-positional-encoding
transformer
注意力提示
感谢读者对本书的关注,因为读者的注意力是一种稀缺的资源:
此刻读者正在阅读本书(而忽略了其他的书),
因此读者的注意力是用机会成本(与金钱类似)来支付的。
为了确保读者现在投入的注意力是值得的,
作者们尽全力(全部的注意力)创作一本好书。
自经济学研究稀缺资源分配以来,人们正处在“注意力经济”时代,
即人类的注意力被视为可以交换的、有限的、有价值的且稀缺的商品。
许多商业模式也被开发出来去利用这一点:
在音乐或视频流媒体服务上,人们要么消耗注意力在广告上,要么付钱来隐藏广告;
为了在网络游戏世界的成长,人们要么消耗注意力在游戏战斗中,
从而帮助吸引新的玩家,要么付钱立即变得强大。
总之,注意力不是免费的。
注意力是稀缺的,而环境中的干扰注意力的信息却并不少。
比如人类的视觉神经系统大约每秒收到位的信息,
这远远超过了大脑能够完全处理的水平。
幸运的是,人类的祖先已经从经验(也称为数据)中认识到
“并非感官的所有输入都是一样的”。
在整个人类历史中,这种只将注意力引向感兴趣的一小部分信息的能力,
使人类的大脑能够更明智地分配资源来生存、成长和社交,
例如发现天敌、找寻食物和伴侣。
生物学中的注意力提示
注意力是如何应用于视觉世界中的呢?
这要从当今十分普及的双组件(two-component)的框架开始讲起:
这个框架的出现可以追溯到19世纪90年代的威廉·詹姆斯,
他被认为是“美国心理学之父” (James.2007)。
在这个框架中,受试者基于非自主性提示和自主性提示
有选择地引导注意力的焦点。
非自主性提示是基于环境中物体的突出性和易见性。
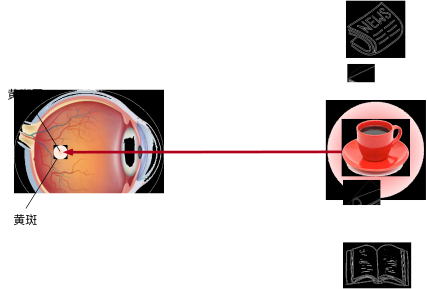
想象一下,假如我们面前有五个物品:
一份报纸、一篇研究论文、一杯咖啡、一本笔记本和一本书,
就像 :numref:fig_eye-coffee。
所有纸制品都是黑白印刷的,但咖啡杯是红色的。
换句话说,这个咖啡杯在这种视觉环境中是突出和显眼的,
不由自主地引起人们的注意。
所以我们会把视力最敏锐的地方放到咖啡上,
如 :numref:fig_eye-coffee所示。
:width:400px
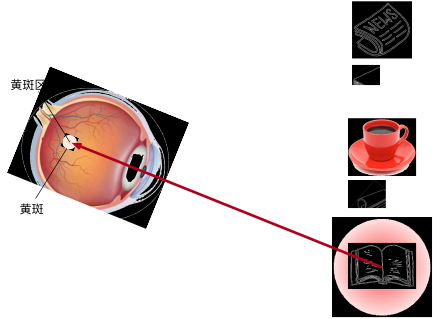
喝咖啡后,我们会变得兴奋并想读书,
所以转过头,重新聚焦眼睛,然后看看书,
就像 :numref:fig_eye-book中描述那样。
与 :numref:fig_eye-coffee中由于突出性导致的选择不同,
此时选择书是受到了认知和意识的控制,
因此注意力在基于自主性提示去辅助选择时将更为谨慎。
受试者的主观意愿推动,选择的力量也就更强大。
:width:400px
查询、键和值
自主性的与非自主性的注意力提示解释了人类的注意力的方式,
下面来看看如何通过这两种注意力提示,
用神经网络来设计注意力机制的框架,
首先,考虑一个相对简单的状况,
即只使用非自主性提示。
要想将选择偏向于感官输入,
则可以简单地使用参数化的全连接层,
甚至是非参数化的最大汇聚层或平均汇聚层。
因此,“是否包含自主性提示”将注意力机制与全连接层或汇聚层区别开来。
在注意力机制的背景下,自主性提示被称为查询(query)。
给定任何查询,注意力机制通过注意力汇聚(attention pooling)
将选择引导至感官输入(sensory inputs,例如中间特征表示)。
在注意力机制中,这些感官输入被称为值(value)。
更通俗的解释,每个值都与一个键(key)配对,
这可以想象为感官输入的非自主提示。
如 :numref:fig_qkv所示,可以通过设计注意力汇聚的方式,
便于给定的查询(自主性提示)与键(非自主性提示)进行匹配,
这将引导得出最匹配的值(感官输入)。
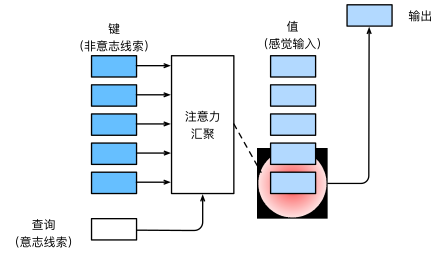
鉴于上面所提框架在 :numref:fig_qkv中的主导地位,
因此这个框架下的模型将成为本章的中心。
然而,注意力机制的设计有许多替代方案。
例如可以设计一个不可微的注意力模型,
该模型可以使用强化学习方法 (Mnih.Heess.Graves.ea.2014)进行训练。
注意力的可视化
平均汇聚层可以被视为输入的加权平均值,
其中各输入的权重是一样的。
实际上,注意力汇聚得到的是加权平均的总和值,
其中权重是在给定的查询和不同的键之间计算得出的。
from d2l import torch as d2l
import torch为了可视化注意力权重,需要定义一个show_heatmaps函数。
其输入matrices的形状是
(要显示的行数,要显示的列数,查询的数目,键的数目)。
下面使用一个简单的例子进行演示。
在本例子中,仅当查询和键相同时,注意力权重为1,否则为0。
后面的章节内容将经常调用show_heatmaps函数来显示注意力权重。
小结
- 人类的注意力是有限的、有价值和稀缺的资源。
- 受试者使用非自主性和自主性提示有选择性地引导注意力。前者基于突出性,后者则依赖于意识。
- 注意力机制与全连接层或者汇聚层的区别源于增加的自主提示。
- 由于包含了自主性提示,注意力机制与全连接的层或汇聚层不同。
- 注意力机制通过注意力汇聚使选择偏向于值(感官输入),其中包含查询(自主性提示)和键(非自主性提示)。键和值是成对的。
- 可视化查询和键之间的注意力权重是可行的。
练习
- 在机器翻译中通过解码序列词元时,其自主性提示可能是什么?非自主性提示和感官输入又是什么?
- 随机生成一个矩阵并使用
softmax运算来确保每行都是有效的概率分布,然后可视化输出注意力权重。
注意力汇聚:Nadaraya-Watson 核回归
上节介绍了框架下的注意力机制的主要成分 :numref:fig_qkv:
查询(自主提示)和键(非自主提示)之间的交互形成了注意力汇聚;
注意力汇聚有选择地聚合了值(感官输入)以生成最终的输出。
本节将介绍注意力汇聚的更多细节,
以便从宏观上了解注意力机制在实践中的运作方式。
具体来说,1964年提出的Nadaraya-Watson核回归模型
是一个简单但完整的例子,可以用于演示具有注意力机制的机器学习。
from d2l import torch as d2l
import torch
from torch import nn[生成数据集]
简单起见,考虑下面这个回归问题:
给定的成对的“输入-输出”数据集
,
如何学习来预测任意新输入的输出?
根据下面的非线性函数生成一个人工数据集,
其中加入的噪声项为:
其中服从均值为和标准差为的正态分布。
在这里生成了个训练样本和个测试样本。
为了更好地可视化之后的注意力模式,需要将训练样本进行排序。
n_train = 50  # 训练样本数
x_train, _ = torch.sort(d2l.rand(n_train) * 5)   # 排序后的训练样本
def f(x):
return 2 * d2l.sin(x) + x**0.8
y_train = f(x_train) + d2l.normal(0.0, 0.5, (n_train,)) # 训练样本的输出
x_test = d2l.arange(0, 5, 0.1) # 测试样本
y_truth = f(x_test) # 测试样本的真实输出
n_test = len(x_test) # 测试样本数
n_test下面的函数将绘制所有的训练样本(样本由圆圈表示),
不带噪声项的真实数据生成函数(标记为“Truth”),
以及学习得到的预测函数(标记为“Pred”)。
平均汇聚
先使用最简单的估计器来解决回归问题。
基于平均汇聚来计算所有训练样本输出值的平均值:
如下图所示,这个估计器确实不够聪明。
真实函数(“Truth”)和预测函数(“Pred”)相差很大。
y_hat = torch.repeat_interleave(y_train.mean(), n_test)
plot_kernel_reg(y_hat)[非参数注意力汇聚]
显然,平均汇聚忽略了输入。
于是Nadaraya (Nadaraya.1964)和
Watson (Watson.1964)提出了一个更好的想法,
根据输入的位置对输出进行加权:
其中是核(kernel)。
公式 :eqref:eq_nadaraya-watson所描述的估计器被称为
Nadaraya-Watson核回归(Nadaraya-Watson kernel regression)。
这里不会深入讨论核函数的细节,
但受此启发,
我们可以从 :numref:fig_qkv中的注意力机制框架的角度
重写 :eqref:eq_nadaraya-watson,
成为一个更加通用的注意力汇聚(attention pooling)公式:
其中是查询,是键值对。
比较 :eqref:eq_attn-pooling和 :eqref:eq_avg-pooling,
注意力汇聚是的加权平均。
将查询和键之间的关系建模为
注意力权重(attention weight),
如 :eqref:eq_attn-pooling所示,
这个权重将被分配给每一个对应值。
对于任何查询,模型在所有键值对注意力权重都是一个有效的概率分布:
它们是非负的,并且总和为1。
为了更好地理解注意力汇聚,
下面考虑一个高斯核(Gaussian kernel),其定义为:
将高斯核代入 :eqref:eq_attn-pooling和
:eqref:eq_nadaraya-watson可以得到:
在 :eqref:eq_nadaraya-watson-gaussian中,
如果一个键越是接近给定的查询,
那么分配给这个键对应值的注意力权重就会越大,
也就“获得了更多的注意力”。
值得注意的是,Nadaraya-Watson核回归是一个非参数模型。
因此, :eqref:eq_nadaraya-watson-gaussian是
非参数的注意力汇聚(nonparametric attention pooling)模型。
接下来,我们将基于这个非参数的注意力汇聚模型来绘制预测结果。
从绘制的结果会发现新的模型预测线是平滑的,并且比平均汇聚的预测更接近真实。
# X_repeat的形状:(n_test,n_train),
# 每一行都包含着相同的测试输入(例如:同样的查询)
X_repeat = d2l.reshape(x_test.repeat_interleave(n_train), (-1, n_train))
# x_train包含着键。attention_weights的形状:(n_test,n_train),
# 每一行都包含着要在给定的每个查询的值(y_train)之间分配的注意力权重
attention_weights = nn.functional.softmax(-(X_repeat - x_train)**2 / 2, dim=1)
# y_hat的每个元素都是值的加权平均值,其中的权重是注意力权重
y_hat = d2l.matmul(attention_weights, y_train)
plot_kernel_reg(y_hat)
现在来观察注意力的权重。
这里测试数据的输入相当于查询,而训练数据的输入相当于键。
因为两个输入都是经过排序的,因此由观察可知“查询-键”对越接近,
注意力汇聚的[注意力权重]就越高。
d2l.show_heatmaps(attention_weights.unsqueeze(0).unsqueeze(0),
                  xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')[带参数注意力汇聚]
非参数的Nadaraya-Watson核回归具有一致性(consistency)的优点:
如果有足够的数据,此模型会收敛到最优结果。
尽管如此,我们还是可以轻松地将可学习的参数集成到注意力汇聚中。
例如,与 :eqref:eq_nadaraya-watson-gaussian略有不同,
在下面的查询和键之间的距离乘以可学习参数:
本节的余下部分将通过训练这个模型
:eqref:eq_nadaraya-watson-gaussian-para来学习注意力汇聚的参数。
批量矩阵乘法
为了更有效地计算小批量数据的注意力,
我们可以利用深度学习开发框架中提供的批量矩阵乘法。
假设第一个小批量数据包含个矩阵,
形状为,
第二个小批量包含个矩阵,
形状为。
它们的批量矩阵乘法得到个矩阵
,
形状为。
因此,[假定两个张量的形状分别是和,
它们的批量矩阵乘法输出的形状为]。
X = d2l.ones((2, 1, 4))
Y = d2l.ones((2, 4, 6))
torch.bmm(X, Y).shape在注意力机制的背景中,我们可以[使用小批量矩阵乘法来计算小批量数据中的加权平均值]。
weights = d2l.ones((2, 10)) * 0.1
values = d2l.reshape(d2l.arange(20.0), (2, 10))
torch.bmm(weights.unsqueeze(1), values.unsqueeze(-1))
定义模型
基于 :eqref:eq_nadaraya-watson-gaussian-para中的
[带参数的注意力汇聚],使用小批量矩阵乘法,
定义Nadaraya-Watson核回归的带参数版本为:
class NWKernelRegression(nn.Module):
    def __init__(self, **kwargs):
        super().__init__(**kwargs)
        self.w = nn.Parameter(torch.rand((1,), requires_grad=True))

    def forward(self, queries, keys, values):
        # queries和attention_weights的形状为(查询个数,“键-值”对个数)
        queries = d2l.reshape(
            queries.repeat_interleave(keys.shape[1]), (-1, keys.shape[1]))
        self.attention_weights = nn.functional.softmax(
            -((queries - keys) * self.w)**2 / 2, dim=1)
        # values的形状为(查询个数,“键-值”对个数)
        return torch.bmm(self.attention_weights.unsqueeze(1),
                         values.unsqueeze(-1)).reshape(-1)
训练
接下来,[将训练数据集变换为键和值]用于训练注意力模型。
在带参数的注意力汇聚模型中,
任何一个训练样本的输入都会和除自己以外的所有训练样本的“键-值”对进行计算,
从而得到其对应的预测输出。
# X_tile的形状:(n_train,n_train),每一行都包含着相同的训练输入
X_tile = x_train.repeat((n_train, 1))
# Y_tile的形状:(n_train,n_train),每一行都包含着相同的训练输出
Y_tile = y_train.repeat((n_train, 1))
# keys的形状:('n_train','n_train'-1)
keys = d2l.reshape(X_tile[(1 - d2l.eye(n_train)).type(torch.bool)],
                   (n_train, -1))
# values的形状:('n_train','n_train'-1)
values = d2l.reshape(Y_tile[(1 - d2l.eye(n_train)).type(torch.bool)],
(n_train, -1))[训练带参数的注意力汇聚模型]时,使用平方损失函数和随机梯度下降。
net = NWKernelRegression()
loss = nn.MSELoss(reduction='none')
trainer = torch.optim.SGD(net.parameters(), lr=0.5)
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])

for epoch in range(5):
    trainer.zero_grad()
    l = loss(net(x_train, keys, values), y_train)
    l.sum().backward()
    trainer.step()
    print(f'epoch {epoch + 1}, loss {float(l.sum()):.6f}')
    animator.add(epoch + 1, float(l.sum()))
如下所示,训练完带参数的注意力汇聚模型后可以发现:
在尝试拟合带噪声的训练数据时,
[预测结果绘制]的线不如之前非参数模型的平滑。
# keys的形状:(n_test,n_train),每一行包含着相同的训练输入(例如,相同的键)
keys = x_train.repeat((n_test, 1))
# value的形状:(n_test,n_train)
values = y_train.repeat((n_test, 1))
y_hat = net(x_test, keys, values).unsqueeze(1).detach()
plot_kernel_reg(y_hat)
为什么新的模型更不平滑了呢?
下面看一下输出结果的绘制图:
与非参数的注意力汇聚模型相比,
带参数的模型加入可学习的参数后,
[曲线在注意力权重较大的区域变得更不平滑]。
d2l.show_heatmaps(net.attention_weights.unsqueeze(0).unsqueeze(0),
                  xlabel='Sorted training inputs',
                  ylabel='Sorted testing inputs')
小结
- Nadaraya-Watson核回归是具有注意力机制的机器学习范例。
- Nadaraya-Watson核回归的注意力汇聚是对训练数据中输出的加权平均。从注意力的角度来看,分配给每个值的注意力权重取决于将值所对应的键和查询作为输入的函数。
- 注意力汇聚可以分为非参数型和带参数型。
练习
- 增加训练数据的样本数量,能否得到更好的非参数的Nadaraya-Watson核回归模型?
- 在带参数的注意力汇聚的实验中学习得到的参数的价值是什么?为什么在可视化注意力权重时,它会使加权区域更加尖锐?
- 如何将超参数添加到非参数的Nadaraya-Watson核回归中以实现更好地预测结果?
- 为本节的核回归设计一个新的带参数的注意力汇聚模型。训练这个新模型并可视化其注意力权重。
注意力评分函数
:numref:sec_nadaraya-watson使用了高斯核来对查询和键之间的关系建模。
:eqref:eq_nadaraya-watson-gaussian中的
高斯核指数部分可以视为注意力评分函数(attention scoring function),
简称评分函数(scoring function),
然后把这个函数的输出结果输入到softmax函数中进行运算。
通过上述步骤,将得到与键对应的值的概率分布(即注意力权重)。
最后,注意力汇聚的输出就是基于这些注意力权重的值的加权和。
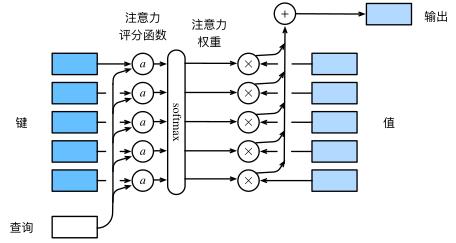
从宏观来看,上述算法可以用来实现
:numref:fig_qkv中的注意力机制框架。
:numref:fig_attention_output说明了
如何将注意力汇聚的输出计算成为值的加权和,
其中表示注意力评分函数。
由于注意力权重是概率分布,
因此加权和其本质上是加权平均值。
用数学语言描述,假设有一个查询
和
个“键-值”对
,
其中,。
注意力汇聚函数就被表示成值的加权和:
其中查询和键的注意力权重(标量)
是通过注意力评分函数将两个向量映射成标量,
再经过softmax运算得到的:
正如上图所示,选择不同的注意力评分函数会导致不同的注意力汇聚操作。
本节将介绍两个流行的评分函数,稍后将用他们来实现更复杂的注意力机制。
from d2l import torch as d2l
import math
import torch
from torch import nn[掩蔽softmax操作]
正如上面提到的,softmax操作用于输出一个概率分布作为注意力权重。
在某些情况下,并非所有的值都应该被纳入到注意力汇聚中。
例如,为了在 :numref:sec_machine_translation中高效处理小批量数据集,
某些文本序列被填充了没有意义的特殊词元。
为了仅将有意义的词元作为值来获取注意力汇聚,
可以指定一个有效序列长度(即词元的个数),
以便在计算softmax时过滤掉超出指定范围的位置。
下面的masked_softmax函数
实现了这样的掩蔽softmax操作(masked softmax operation),
其中任何超出有效长度的位置都被掩蔽并置为0。
#@save
def masked_softmax(X, valid_lens):
    """通过在最后一个轴上掩蔽元素来执行softmax操作"""
    # X:3D张量,valid_lens:1D或2D张量
    if valid_lens is None:
        return nn.functional.softmax(X, dim=-1)
    else:
        shape = X.shape
        if valid_lens.dim() == 1:
            valid_lens = torch.repeat_interleave(valid_lens, shape[1])
        else:
            valid_lens = valid_lens.reshape(-1)
        # 最后一轴上被掩蔽的元素使用一个非常大的负值替换,从而其softmax输出为0
        X = d2l.sequence_mask(X.reshape(-1, shape[-1]), valid_lens,
                              value=-1e6)
return nn.functional.softmax(X.reshape(shape), dim=-1)为了[演示此函数是如何工作]的,
考虑由两个矩阵表示的样本,
这两个样本的有效长度分别为和。
经过掩蔽softmax操作,超出有效长度的值都被掩蔽为0。
masked_softmax(torch.rand(2, 2, 4), torch.tensor([2, 3]))同样,也可以使用二维张量,为矩阵样本中的每一行指定有效长度。
masked_softmax(torch.rand(2, 2, 4), d2l.tensor([[1, 3], [2, 4]]))[加性注意力]
一般来说,当查询和键是不同长度的矢量时,可以使用加性注意力作为评分函数。
给定查询和
键,
加性注意力(additive attention)的评分函数为
其中可学习的参数是、
和
。
如 :eqref:eq_additive-attn所示,
将查询和键连结起来后输入到一个多层感知机(MLP)中,
感知机包含一个隐藏层,其隐藏单元数是一个超参数。
通过使用作为激活函数,并且禁用偏置项。
下面来实现加性注意力。
#@save
class AdditiveAttention(nn.Module):
    """加性注意力"""
    def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
        super(AdditiveAttention, self).__init__(**kwargs)
        self.W_k = nn.Linear(key_size, num_hiddens, bias=False)
        self.W_q = nn.Linear(query_size, num_hiddens, bias=False)
        self.w_v = nn.Linear(num_hiddens, 1, bias=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # 在维度扩展后,
        # queries的形状:(batch_size,查询的个数,1,num_hidden)
        # key的形状:(batch_size,1,“键-值”对的个数,num_hiddens)
        # 使用广播方式进行求和
        features = queries.unsqueeze(2) + keys.unsqueeze(1)
        features = torch.tanh(features)
        # self.w_v仅有一个输出,因此从形状中移除最后那个维度。
        # scores的形状:(batch_size,查询的个数,“键-值”对的个数)
        scores = self.w_v(features).squeeze(-1)
        self.attention_weights = masked_softmax(scores, valid_lens)
        # values的形状:(batch_size,“键-值”对的个数,值的维度)
return torch.bmm(self.dropout(self.attention_weights), values)用一个小例子来[演示上面的AdditiveAttention类],
其中查询、键和值的形状为(批量大小,步数或词元序列长度,特征大小),
实际输出为、和。
注意力汇聚输出的形状为(批量大小,查询的步数,值的维度)。
queries, keys = d2l.normal(0, 1, (2, 1, 20)), d2l.ones((2, 10, 2))
# values的小批量,两个值矩阵是相同的
values = torch.arange(40, dtype=torch.float32).reshape(1, 10, 4).repeat(
    2, 1, 1)
valid_lens = d2l.tensor([2, 6])

attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
                              dropout=0.1)
attention.eval()
attention(queries, keys, values, valid_lens)
尽管加性注意力包含了可学习的参数,但由于本例子中每个键都是相同的,
所以[注意力权重]是均匀的,由指定的有效长度决定。
[缩放点积注意力]
使用点积可以得到计算效率更高的评分函数,
但是点积操作要求查询和键具有相同的长度。
假设查询和键的所有元素都是独立的随机变量,
并且都满足零均值和单位方差,
那么两个向量的点积的均值为,方差为。
为确保无论向量长度如何,
点积的方差在不考虑向量长度的情况下仍然是,
我们再将点积除以,
则缩放点积注意力(scaled dot-product attention)评分函数为:
在实践中,我们通常从小批量的角度来考虑提高效率,
例如基于个查询和个键-值对计算注意力,
其中查询和键的长度为,值的长度为。
查询、
键和
值的缩放点积注意力是:
下面的缩放点积注意力的实现使用了暂退法进行模型正则化。
#@save
class DotProductAttention(nn.Module):
    """缩放点积注意力"""
    def __init__(self, dropout, **kwargs):
        super(DotProductAttention, self).__init__(**kwargs)
        self.dropout = nn.Dropout(dropout)

    # queries的形状:(batch_size,查询的个数,d)
    # keys的形状:(batch_size,“键-值”对的个数,d)
    # values的形状:(batch_size,“键-值”对的个数,值的维度)
    # valid_lens的形状:(batch_size,)或者(batch_size,查询的个数)
    def forward(self, queries, keys, values, valid_lens=None):
        d = queries.shape[-1]
        # 设置transpose_b=True为了交换keys的最后两个维度
        scores = torch.bmm(queries, keys.transpose(1,2)) / math.sqrt(d)
        self.attention_weights = masked_softmax(scores, valid_lens)
return torch.bmm(self.dropout(self.attention_weights), values)为了[演示上述的DotProductAttention类],
我们使用与先前加性注意力例子中相同的键、值和有效长度。
对于点积操作,我们令查询的特征维度与键的特征维度大小相同。
queries = d2l.normal(0, 1, (2, 1, 2))
attention = DotProductAttention(dropout=0.5)
attention.eval()
attention(queries, keys, values, valid_lens)
与加性注意力演示相同,由于键包含的是相同的元素,
而这些元素无法通过任何查询进行区分,因此获得了[均匀的注意力权重]。
小结
- 将注意力汇聚的输出计算可以作为值的加权平均,选择不同的注意力评分函数会带来不同的注意力汇聚操作。
- 当查询和键是不同长度的矢量时,可以使用可加性注意力评分函数。当它们的长度相同时,使用缩放的“点-积”注意力评分函数的计算效率更高。
练习
- 修改小例子中的键,并且可视化注意力权重。可加性注意力和缩放的“点-积”注意力是否仍然产生相同的结果?为什么?
- 只使用矩阵乘法,能否为具有不同矢量长度的查询和键设计新的评分函数?
- 当查询和键具有相同的矢量长度时,矢量求和作为评分函数是否比“点-积”更好?为什么?
Bahdanau 注意力
:numref:sec_seq2seq中探讨了机器翻译问题:
通过设计一个基于两个循环神经网络的编码器-解码器架构,
用于序列到序列学习。
具体来说,循环神经网络编码器将长度可变的序列转换为固定形状的上下文变量,
然后循环神经网络解码器根据生成的词元和上下文变量
按词元生成输出(目标)序列词元。
然而,即使并非所有输入(源)词元都对解码某个词元都有用,
在每个解码步骤中仍使用编码相同的上下文变量。
有什么方法能改变上下文变量呢?
我们试着从 (Graves.2013)中找到灵感:
在为给定文本序列生成手写的挑战中,
Graves设计了一种可微注意力模型,
将文本字符与更长的笔迹对齐,
其中对齐方式仅向一个方向移动。
受学习对齐想法的启发,Bahdanau等人提出了一个没有严格单向对齐限制的
可微注意力模型 (Bahdanau.Cho.Bengio.2014)。
在预测词元时,如果不是所有输入词元都相关,模型将仅对齐(或参与)输入序列中与当前预测相关的部分。这是通过将上下文变量视为注意力集中的输出来实现的。
模型
下面描述的Bahdanau注意力模型
将遵循 :numref:sec_seq2seq中的相同符号表达。
这个新的基于注意力的模型与 :numref:sec_seq2seq中的模型相同,
只不过 :eqref:eq_seq2seq_s_t中的上下文变量
在任何解码时间步都会被替换。
假设输入序列中有个词元,
解码时间步的上下文变量是注意力集中的输出:
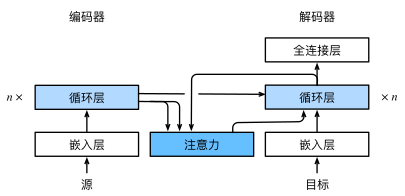
其中,时间步时的解码器隐状态是查询,
编码器隐状态既是键,也是值,
注意力权重是使用 :eqref:eq_attn-scoring-alpha
所定义的加性注意力打分函数计算的。
与 :numref:fig_seq2seq_details中的循环神经网络编码器-解码器架构略有不同,
:numref:fig_s2s_attention_details描述了Bahdanau注意力的架构。
from d2l import torch as d2l
import torch
from torch import nn
定义注意力解码器
下面看看如何定义Bahdanau注意力,实现循环神经网络编码器-解码器。
其实,我们只需重新定义解码器即可。
为了更方便地显示学习的注意力权重,
以下AttentionDecoder类定义了[带有注意力机制解码器的基本接口]。
接下来,让我们在接下来的Seq2SeqAttentionDecoder类中
[实现带有Bahdanau注意力的循环神经网络解码器]。
首先,初始化解码器的状态,需要下面的输入:
- 编码器在所有时间步的最终层隐状态,将作为注意力的键和值;
- 上一时间步的编码器全层隐状态,将作为初始化解码器的隐状态;
- 编码器有效长度(排除在注意力池中填充词元)。
在每个解码时间步骤中,解码器上一个时间步的最终层隐状态将用作查询。
因此,注意力输出和输入嵌入都连结为循环神经网络解码器的输入。
class Seq2SeqAttentionDecoder(AttentionDecoder):
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqAttentionDecoder, self).__init__(**kwargs)
        self.attention = d2l.AdditiveAttention(
            num_hiddens, num_hiddens, num_hiddens, dropout)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        self.rnn = nn.GRU(
            embed_size + num_hiddens, num_hiddens, num_layers,
            dropout=dropout)
        self.dense = nn.Linear(num_hiddens, vocab_size)

    def init_state(self, enc_outputs, enc_valid_lens, *args):
        # outputs的形状为(batch_size,num_steps,num_hiddens).
        # hidden_state的形状为(num_layers,batch_size,num_hiddens)
        outputs, hidden_state = enc_outputs
        return (outputs.permute(1, 0, 2), hidden_state, enc_valid_lens)

    def forward(self, X, state):
        # enc_outputs的形状为(batch_size,num_steps,num_hiddens).
        # hidden_state的形状为(num_layers,batch_size,
        # num_hiddens)
        enc_outputs, hidden_state, enc_valid_lens = state
        # 输出X的形状为(num_steps,batch_size,embed_size)
        X = self.embedding(X).permute(1, 0, 2)
        outputs, self._attention_weights = [], []
        for x in X:
            # query的形状为(batch_size,1,num_hiddens)
            query = torch.unsqueeze(hidden_state[-1], dim=1)
            # context的形状为(batch_size,1,num_hiddens)
            context = self.attention(
                query, enc_outputs, enc_outputs, enc_valid_lens)
            # 在特征维度上连结
            x = torch.cat((context, torch.unsqueeze(x, dim=1)), dim=-1)
            # 将x变形为(1,batch_size,embed_size+num_hiddens)
            out, hidden_state = self.rnn(x.permute(1, 0, 2), hidden_state)
            outputs.append(out)
            self._attention_weights.append(self.attention.attention_weights)
        # 全连接层变换后,outputs的形状为
        # (num_steps,batch_size,vocab_size)
        outputs = self.dense(torch.cat(outputs, dim=0))
        return outputs.permute(1, 0, 2), [enc_outputs, hidden_state,
                                          enc_valid_lens]

    @property
    def attention_weights(self):
return self._attention_weights接下来,使用包含7个时间步的4个序列输入的小批量[测试Bahdanau注意力解码器]。
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
                             num_layers=2)
encoder.eval()
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
                                  num_layers=2)
decoder.eval()
X = d2l.zeros((4, 7), dtype=torch.long)  # (batch_size,num_steps)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape[训练]
与 :numref:sec_seq2seq_training类似,
我们在这里指定超参数,实例化一个带有Bahdanau注意力的编码器和解码器,
并对这个模型进行机器翻译训练。
由于新增的注意力机制,训练要比没有注意力机制的
:numref:sec_seq2seq_training慢得多。
模型训练后,我们用它[将几个英语句子翻译成法语]并计算它们的BLEU分数。
训练结束后,下面通过[可视化注意力权重]
会发现,每个查询都会在键值对上分配不同的权重,这说明
在每个解码步中,输入序列的不同部分被选择性地聚集在注意力池中。
, paddle
# 加上一个包含序列结束词元
d2l.show_heatmaps(
    attention_weights[:, :, :, :len(engs[-1].split()) + 1].cpu(),
    xlabel='Key positions', ylabel='Query positions')
小结
- 在预测词元时,如果不是所有输入词元都是相关的,那么具有Bahdanau注意力的循环神经网络编码器-解码器会有选择地统计输入序列的不同部分。这是通过将上下文变量视为加性注意力池化的输出来实现的。
- 在循环神经网络编码器-解码器中,Bahdanau注意力将上一时间步的解码器隐状态视为查询,在所有时间步的编码器隐状态同时视为键和值。
练习
- 在实验中用LSTM替换GRU。
- 修改实验以将加性注意力打分函数替换为缩放点积注意力,它如何影响训练效率?
多头注意力
在实践中,当给定相同的查询、键和值的集合时,
我们希望模型可以基于相同的注意力机制学习到不同的行为,
然后将不同的行为作为知识组合起来,
捕获序列内各种范围的依赖关系
(例如,短距离依赖和长距离依赖关系)。
因此,允许注意力机制组合使用查询、键和值的不同
子空间表示(representation subspaces)可能是有益的。
为此,与其只使用单独一个注意力汇聚,
我们可以用独立学习得到的组不同的
线性投影(linear projections)来变换查询、键和值。
然后,这组变换后的查询、键和值将并行地送到注意力汇聚中。
最后,将这个注意力汇聚的输出拼接在一起,
并且通过另一个可以学习的线性投影进行变换,
以产生最终输出。
这种设计被称为多头注意力(multihead attention)
(Vaswani.Shazeer.Parmar.ea.2017)。
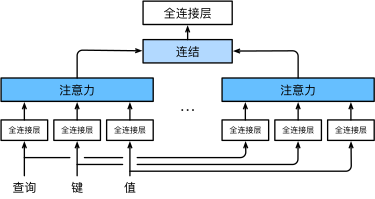
对于个注意力汇聚输出,每一个注意力汇聚都被称作一个头(head)。
:numref:fig_multi-head-attention
展示了使用全连接层来实现可学习的线性变换的多头注意力。
模型
在实现多头注意力之前,让我们用数学语言将这个模型形式化地描述出来。
给定查询、
键和
值,
每个注意力头()的计算方法为:
其中,可学习的参数包括
、
和
,
以及代表注意力汇聚的函数。
可以是 :numref:sec_attention-scoring-functions中的
加性注意力和缩放点积注意力。
多头注意力的输出需要经过另一个线性转换,
它对应着个头连结后的结果,因此其可学习参数是
:
基于这种设计,每个头都可能会关注输入的不同部分,
可以表示比简单加权平均值更复杂的函数。
from d2l import torch as d2l
import math
import torch
from torch import nn
实现
在实现过程中通常[选择缩放点积注意力作为每一个注意力头]。
为了避免计算代价和参数代价的大幅增长,
我们设定。
值得注意的是,如果将查询、键和值的线性变换的输出数量设置为
,
则可以并行计算个头。
在下面的实现中,是通过参数num_hiddens指定的。
#@save
class MultiHeadAttention(nn.Module):
    """多头注意力"""
    def __init__(self, key_size, query_size, value_size, num_hiddens,
                 num_heads, dropout, bias=False, **kwargs):
        super(MultiHeadAttention, self).__init__(**kwargs)
        self.num_heads = num_heads
        self.attention = d2l.DotProductAttention(dropout)
        self.W_q = nn.Linear(query_size, num_hiddens, bias=bias)
        self.W_k = nn.Linear(key_size, num_hiddens, bias=bias)
        self.W_v = nn.Linear(value_size, num_hiddens, bias=bias)
        self.W_o = nn.Linear(num_hiddens, num_hiddens, bias=bias)

    def forward(self, queries, keys, values, valid_lens):
        # queries,keys,values的形状:
        # (batch_size,查询或者“键-值”对的个数,num_hiddens)
        # valid_lens 的形状:
        # (batch_size,)或(batch_size,查询的个数)
        # 经过变换后,输出的queries,keys,values 的形状:
        # (batch_size*num_heads,查询或者“键-值”对的个数,
        # num_hiddens/num_heads)
        queries = transpose_qkv(self.W_q(queries), self.num_heads)
        keys = transpose_qkv(self.W_k(keys), self.num_heads)
        values = transpose_qkv(self.W_v(values), self.num_heads)

        if valid_lens is not None:
            # 在轴0,将第一项(标量或者矢量)复制num_heads次,
            # 然后如此复制第二项,然后诸如此类。
            valid_lens = torch.repeat_interleave(
                valid_lens, repeats=self.num_heads, dim=0)

        # output的形状:(batch_size*num_heads,查询的个数,
        # num_hiddens/num_heads)
        output = self.attention(queries, keys, values, valid_lens)

        # output_concat的形状:(batch_size,查询的个数,num_hiddens)
        output_concat = transpose_output(output, self.num_heads)
return self.W_o(output_concat)为了能够[使多个头并行计算],
上面的MultiHeadAttention类将使用下面定义的两个转置函数。
具体来说,transpose_output函数反转了transpose_qkv函数的操作。
#@save
def transpose_qkv(X, num_heads):
    """为了多注意力头的并行计算而变换形状"""
    # 输入X的形状:(batch_size,查询或者“键-值”对的个数,num_hiddens)
    # 输出X的形状:(batch_size,查询或者“键-值”对的个数,num_heads,
    # num_hiddens/num_heads)
    X = X.reshape(X.shape[0], X.shape[1], num_heads, -1)

    # 输出X的形状:(batch_size,num_heads,查询或者“键-值”对的个数,
    # num_hiddens/num_heads)
    X = X.permute(0, 2, 1, 3)

    # 最终输出的形状:(batch_size*num_heads,查询或者“键-值”对的个数,
    # num_hiddens/num_heads)
    return X.reshape(-1, X.shape[2], X.shape[3])

#@save
def transpose_output(X, num_heads):
    """逆转transpose_qkv函数的操作"""
    X = X.reshape(-1, num_heads, X.shape[1], X.shape[2])
    X = X.permute(0, 2, 1, 3)
return X.reshape(X.shape[0], X.shape[1], -1)下面使用键和值相同的小例子来[测试]我们编写的MultiHeadAttention类。
多头注意力输出的形状是(batch_size,num_queries,num_hiddens)。
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
                               num_hiddens, num_heads, 0.5)
attention.eval()
小结
- 多头注意力融合了来自于多个注意力汇聚的不同知识,这些知识的不同来源于相同的查询、键和值的不同的子空间表示。
- 基于适当的张量操作,可以实现多头注意力的并行计算。
练习
- 分别可视化这个实验中的多个头的注意力权重。
- 假设有一个完成训练的基于多头注意力的模型,现在希望修剪最不重要的注意力头以提高预测速度。如何设计实验来衡量注意力头的重要性呢?
自注意力和位置编码
在深度学习中,经常使用卷积神经网络(CNN)或循环神经网络(RNN)对序列进行编码。
想象一下,有了注意力机制之后,我们将词元序列输入注意力池化中,
以便同一组词元同时充当查询、键和值。
具体来说,每个查询都会关注所有的键-值对并生成一个注意力输出。
由于查询、键和值来自同一组输入,因此被称为
自注意力(self-attention)
(Lin.Feng.Santos.ea.2017;Vaswani.Shazeer.Parmar.ea.2017),
也被称为内部注意力(intra-attention) (Cheng.Dong.Lapata.2016;Parikh.Tackstrom.Das.ea.2016;Paulus.Xiong.Socher.2017)。
本节将使用自注意力进行序列编码,以及如何使用序列的顺序作为补充信息。
from d2l import torch as d2l
import math
import torch
from torch import nn[自注意力]
给定一个由词元组成的输入序列,
其中任意()。
该序列的自注意力输出为一个长度相同的序列
,其中:
根据 :eqref:eq_attn-pooling中定义的注意力汇聚函数。
下面的代码片段是基于多头注意力对一个张量完成自注意力的计算,
张量的形状为(批量大小,时间步的数目或词元序列的长度,)。
输出与输入的张量形状相同。
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
                                   num_hiddens, num_heads, 0.5)
attention.eval()
比较卷积神经网络、循环神经网络和自注意力
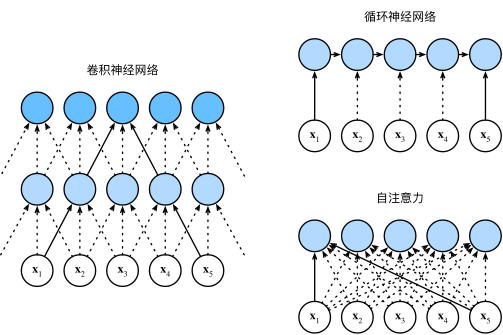
接下来比较下面几个架构,目标都是将由个词元组成的序列映射到另一个长度相等的序列,其中的每个输入词元或输出词元都由维向量表示。具体来说,将比较的是卷积神经网络、循环神经网络和自注意力这几个架构的计算复杂性、顺序操作和最大路径长度。请注意,顺序操作会妨碍并行计算,而任意的序列位置组合之间的路径越短,则能更轻松地学习序列中的远距离依赖关系 (Hochreiter.Bengio.Frasconi.ea.2001)。
考虑一个卷积核大小为的卷积层。
在后面的章节将提供关于使用卷积神经网络处理序列的更多详细信息。
目前只需要知道的是,由于序列长度是,输入和输出的通道数量都是,
所以卷积层的计算复杂度为。
如 :numref:fig_cnn-rnn-self-attention所示,
卷积神经网络是分层的,因此为有个顺序操作,
最大路径长度为。
例如,和处于
:numref:fig_cnn-rnn-self-attention中卷积核大小为3的双层卷积神经网络的感受野内。
当更新循环神经网络的隐状态时,
权重矩阵和维隐状态的乘法计算复杂度为。
由于序列长度为,因此循环神经网络层的计算复杂度为。
根据 :numref:fig_cnn-rnn-self-attention,
有个顺序操作无法并行化,最大路径长度也是。
在自注意力中,查询、键和值都是矩阵。
考虑 :eqref:eq_softmax_QK_V中缩放的”点-积“注意力,
其中矩阵乘以矩阵。
之后输出的矩阵乘以矩阵。
因此,自注意力具有计算复杂性。
正如在 :numref:fig_cnn-rnn-self-attention中所讲,
每个词元都通过自注意力直接连接到任何其他词元。
因此,有个顺序操作可以并行计算,
最大路径长度也是。
总而言之,卷积神经网络和自注意力都拥有并行计算的优势,
而且自注意力的最大路径长度最短。
但是因为其计算复杂度是关于序列长度的二次方,所以在很长的序列中计算会非常慢。
[位置编码]
在处理词元序列时,循环神经网络是逐个的重复地处理词元的,
而自注意力则因为并行计算而放弃了顺序操作。
为了使用序列的顺序信息,通过在输入表示中添加
位置编码(positional encoding)来注入绝对的或相对的位置信息。
位置编码可以通过学习得到也可以直接固定得到。
接下来描述的是基于正弦函数和余弦函数的固定位置编码
(Vaswani.Shazeer.Parmar.ea.2017)。
假设输入表示
包含一个序列中个词元的维嵌入表示。
位置编码使用相同形状的位置嵌入矩阵
输出,
矩阵第行、第列和列上的元素为:
乍一看,这种基于三角函数的设计看起来很奇怪。
在解释这个设计之前,让我们先在下面的PositionalEncoding类中实现它。
#@save
class PositionalEncoding(nn.Module):
    """位置编码"""
    def __init__(self, num_hiddens, dropout, max_len=1000):
        super(PositionalEncoding, self).__init__()
        self.dropout = nn.Dropout(dropout)
        # 创建一个足够长的P
        self.P = d2l.zeros((1, max_len, num_hiddens))
        X = d2l.arange(max_len, dtype=torch.float32).reshape(
            -1, 1) / torch.pow(10000, torch.arange(
            0, num_hiddens, 2, dtype=torch.float32) / num_hiddens)
        self.P[:, :, 0::2] = torch.sin(X)
        self.P[:, :, 1::2] = torch.cos(X)

    def forward(self, X):
        X = X + self.P[:, :X.shape[1], :].to(X.device)
return self.dropout(X)在位置嵌入矩阵中,
[行代表词元在序列中的位置,列代表位置编码的不同维度]。
从下面的例子中可以看到位置嵌入矩阵的第列和第列的频率高于第列和第列。
第列和第列之间的偏移量(第列和第列相同)是由于正弦函数和余弦函数的交替。
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
pos_encoding.eval()
X = pos_encoding(d2l.zeros((1, num_steps, encoding_dim)))
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(d2l.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
         figsize=(6, 2.5), legend=["Col %d" % d for d in d2l.arange(6, 10)])
绝对位置信息
为了明白沿着编码维度单调降低的频率与绝对位置信息的关系,
让我们打印出的[二进制表示]形式。
正如所看到的,每个数字、每两个数字和每四个数字上的比特值
在第一个最低位、第二个最低位和第三个最低位上分别交替。
在二进制表示中,较高比特位的交替频率低于较低比特位,
与下面的热图所示相似,只是位置编码通过使用三角函数[在编码维度上降低频率]。
由于输出是浮点数,因此此类连续表示比二进制表示法更节省空间。
P = P[0, :, :].unsqueeze(0).unsqueeze(0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
                  ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
相对位置信息
除了捕获绝对位置信息之外,上述的位置编码还允许模型学习得到输入序列中相对位置信息。
这是因为对于任何确定的位置偏移,位置处
的位置编码可以线性投影位置处的位置编码来表示。
这种投影的数学解释是,令,
对于任何确定的位置偏移,
:eqref:eq_positional-encoding-def中的任何一对
都可以线性投影到
:
投影矩阵不依赖于任何位置的索引。
小结
- 在自注意力中,查询、键和值都来自同一组输入。
- 卷积神经网络和自注意力都拥有并行计算的优势,而且自注意力的最大路径长度最短。但是因为其计算复杂度是关于序列长度的二次方,所以在很长的序列中计算会非常慢。
- 为了使用序列的顺序信息,可以通过在输入表示中添加位置编码,来注入绝对的或相对的位置信息。
练习
- 假设设计一个深度架构,通过堆叠基于位置编码的自注意力层来表示序列。可能会存在什么问题?
- 请设计一种可学习的位置编码方法。
Transformer
:numref:subsec_cnn-rnn-self-attention中比较了卷积神经网络(CNN)、循环神经网络(RNN)和自注意力(self-attention)。值得注意的是,自注意力同时具有并行计算和最短的最大路径长度这两个优势。因此,使用自注意力来设计深度架构是很有吸引力的。对比之前仍然依赖循环神经网络实现输入表示的自注意力模型 (Cheng.Dong.Lapata.2016;Lin.Feng.Santos.ea.2017;Paulus.Xiong.Socher.2017),Transformer模型完全基于注意力机制,没有任何卷积层或循环神经网络层 (Vaswani.Shazeer.Parmar.ea.2017)。尽管Transformer最初是应用于在文本数据上的序列到序列学习,但现在已经推广到各种现代的深度学习中,例如语言、视觉、语音和强化学习领域。
模型
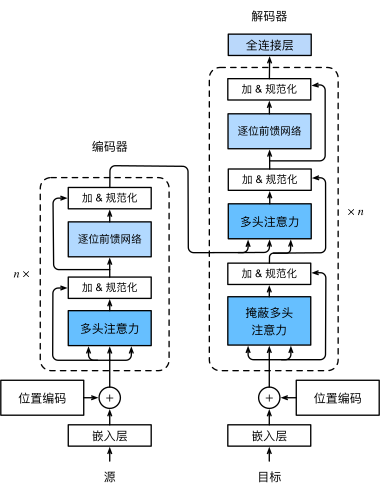
Transformer作为编码器-解码器架构的一个实例,其整体架构图在 :numref:fig_transformer中展示。正如所见到的,Transformer是由编码器和解码器组成的。与 :numref:fig_s2s_attention_details中基于Bahdanau注意力实现的序列到序列的学习相比,Transformer的编码器和解码器是基于自注意力的模块叠加而成的,源(输入)序列和目标(输出)序列的嵌入(embedding)表示将加上位置编码(positional encoding),再分别输入到编码器和解码器中。
:width:500px
图 :numref:fig_transformer中概述了Transformer的架构。从宏观角度来看,Transformer的编码器是由多个相同的层叠加而成的,每个层都有两个子层(子层表示为)。第一个子层是多头自注意力(multi-head self-attention)汇聚;第二个子层是基于位置的前馈网络(positionwise feed-forward network)。具体来说,在计算编码器的自注意力时,查询、键和值都来自前一个编码器层的输出。受 :numref:sec_resnet中残差网络的启发,每个子层都采用了残差连接(residual connection)。在Transformer中,对于序列中任何位置的任何输入,都要求满足,以便残差连接满足。在残差连接的加法计算之后,紧接着应用层规范化(layer normalization) (Ba.Kiros.Hinton.2016)。因此,输入序列对应的每个位置,Transformer编码器都将输出一个维表示向量。
Transformer解码器也是由多个相同的层叠加而成的,并且层中使用了残差连接和层规范化。除了编码器中描述的两个子层之外,解码器还在这两个子层之间插入了第三个子层,称为编码器-解码器注意力(encoder-decoder attention)层。在编码器-解码器注意力中,查询来自前一个解码器层的输出,而键和值来自整个编码器的输出。在解码器自注意力中,查询、键和值都来自上一个解码器层的输出。但是,解码器中的每个位置只能考虑该位置之前的所有位置。这种掩蔽(masked)注意力保留了自回归(auto-regressive)属性,确保预测仅依赖于已生成的输出词元。
在此之前已经描述并实现了基于缩放点积多头注意力 :numref:sec_multihead-attention和位置编码 :numref:subsec_positional-encoding。接下来将实现Transformer模型的剩余部分。
from d2l import torch as d2l
import math
import pandas as pd
import torch
from torch import nn[基于位置的前馈网络]
基于位置的前馈网络对序列中的所有位置的表示进行变换时使用的是同一个多层感知机(MLP),这就是称前馈网络是基于位置的(positionwise)的原因。在下面的实现中,输入X的形状(批量大小,时间步数或序列长度,隐单元数或特征维度)将被一个两层的感知机转换成形状为(批量大小,时间步数,ffn_num_outputs)的输出张量。
#@save
class PositionWiseFFN(nn.Module):
    """基于位置的前馈网络"""
    def __init__(self, ffn_num_input, ffn_num_hiddens, ffn_num_outputs,
                 **kwargs):
        super(PositionWiseFFN, self).__init__(**kwargs)
        self.dense1 = nn.Linear(ffn_num_input, ffn_num_hiddens)
        self.relu = nn.ReLU()
        self.dense2 = nn.Linear(ffn_num_hiddens, ffn_num_outputs)

    def forward(self, X):
return self.dense2(self.relu(self.dense1(X)))下面的例子显示,[改变张量的最里层维度的尺寸],会改变成基于位置的前馈网络的输出尺寸。因为用同一个多层感知机对所有位置上的输入进行变换,所以当所有这些位置的输入相同时,它们的输出也是相同的。
ffn = PositionWiseFFN(4, 4, 8)
ffn.eval()
ffn(d2l.ones((2, 3, 4)))[0]
残差连接和层规范化
现在让我们关注 :numref:fig_transformer中的加法和规范化(add&norm)组件。正如在本节开头所述,这是由残差连接和紧随其后的层规范化组成的。两者都是构建有效的深度架构的关键。
:numref:sec_batch_norm中解释了在一个小批量的样本内基于批量规范化对数据进行重新中心化和重新缩放的调整。层规范化和批量规范化的目标相同,但层规范化是基于特征维度进行规范化。尽管批量规范化在计算机视觉中被广泛应用,但在自然语言处理任务中(输入通常是变长序列)批量规范化通常不如层规范化的效果好。
以下代码[对比不同维度的层规范化和批量规范化的效果]。
ln = nn.LayerNorm(2)
bn = nn.BatchNorm1d(2)
X = d2l.tensor([[1, 2], [2, 3]], dtype=torch.float32)
# 在训练模式下计算X的均值和方差
print('layer norm:', ln(X), '\nbatch norm:', bn(X))现在可以[使用残差连接和层规范化]来实现AddNorm类。暂退法也被作为正则化方法使用。
#@save
class AddNorm(nn.Module):
    """残差连接后进行层规范化"""
    def __init__(self, normalized_shape, dropout, **kwargs):
        super(AddNorm, self).__init__(**kwargs)
        self.dropout = nn.Dropout(dropout)
        self.ln = nn.LayerNorm(normalized_shape)

    def forward(self, X, Y):
return self.ln(self.dropout(Y) + X)残差连接要求两个输入的形状相同,以便[加法操作后输出张量的形状相同]。
, paddle
add_norm = AddNorm([3, 4], 0.5)
add_norm.eval()
add_norm(d2l.ones((2, 3, 4)), d2l.ones((2, 3, 4))).shape
编码器
有了组成Transformer编码器的基础组件,现在可以先[实现编码器中的一个层]。下面的EncoderBlock类包含两个子层:多头自注意力和基于位置的前馈网络,这两个子层都使用了残差连接和紧随的层规范化。
#@save
class EncoderBlock(nn.Module):
    """Transformer编码器块"""
    def __init__(self, key_size, query_size, value_size, num_hiddens,
                 norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
                 dropout, use_bias=False, **kwargs):
        super(EncoderBlock, self).__init__(**kwargs)
        self.attention = d2l.MultiHeadAttention(
            key_size, query_size, value_size, num_hiddens, num_heads, dropout,
            use_bias)
        self.addnorm1 = AddNorm(norm_shape, dropout)
        self.ffn = PositionWiseFFN(
            ffn_num_input, ffn_num_hiddens, num_hiddens)
        self.addnorm2 = AddNorm(norm_shape, dropout)

    def forward(self, X, valid_lens):
        Y = self.addnorm1(X, self.attention(X, X, X, valid_lens))
return self.addnorm2(Y, self.ffn(Y))正如从代码中所看到的,[Transformer编码器中的任何层都不会改变其输入的形状]。
, paddle
X = d2l.ones((2, 100, 24))
valid_lens = d2l.tensor([3, 2])
encoder_blk = EncoderBlock(24, 24, 24, 24, [100, 24], 24, 48, 8, 0.5)
encoder_blk.eval()
encoder_blk(X, valid_lens).shape下面实现的[Transformer编码器]的代码中,堆叠了num_layers个EncoderBlock类的实例。由于这里使用的是值范围在和之间的固定位置编码,因此通过学习得到的输入的嵌入表示的值需要先乘以嵌入维度的平方根进行重新缩放,然后再与位置编码相加。
#@save
class TransformerEncoder(d2l.Encoder):
    """Transformer编码器"""
    def __init__(self, vocab_size, key_size, query_size, value_size,
                 num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
                 num_heads, num_layers, dropout, use_bias=False, **kwargs):
        super(TransformerEncoder, self).__init__(**kwargs)
        self.num_hiddens = num_hiddens
        self.embedding = nn.Embedding(vocab_size, num_hiddens)
        self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
        self.blks = nn.Sequential()
        for i in range(num_layers):
            self.blks.add_module("block"+str(i),
                EncoderBlock(key_size, query_size, value_size, num_hiddens,
                             norm_shape, ffn_num_input, ffn_num_hiddens,
                             num_heads, dropout, use_bias))

    def forward(self, X, valid_lens, *args):
        # 因为位置编码值在-1和1之间,
        # 因此嵌入值乘以嵌入维度的平方根进行缩放,
        # 然后再与位置编码相加。
        X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
        self.attention_weights = [None] * len(self.blks)
        for i, blk in enumerate(self.blks):
            X = blk(X, valid_lens)
            self.attention_weights[
                i] = blk.attention.attention.attention_weights
return X下面我们指定了超参数来[创建一个两层的Transformer编码器]。
Transformer编码器输出的形状是(批量大小,时间步数目,num_hiddens)。
encoder = TransformerEncoder(
    200, 24, 24, 24, 24, [100, 24], 24, 48, 8, 2, 0.5)
encoder.eval()
encoder(d2l.ones((2, 100), dtype=torch.long), valid_lens).shape
解码器
如 :numref:fig_transformer所示,[Transformer解码器也是由多个相同的层组成]。在DecoderBlock类中实现的每个层包含了三个子层:解码器自注意力、“编码器-解码器”注意力和基于位置的前馈网络。这些子层也都被残差连接和紧随的层规范化围绕。
正如在本节前面所述,在掩蔽多头解码器自注意力层(第一个子层)中,查询、键和值都来自上一个解码器层的输出。关于序列到序列模型(sequence-to-sequence model),在训练阶段,其输出序列的所有位置(时间步)的词元都是已知的;然而,在预测阶段,其输出序列的词元是逐个生成的。因此,在任何解码器时间步中,只有生成的词元才能用于解码器的自注意力计算中。为了在解码器中保留自回归的属性,其掩蔽自注意力设定了参数dec_valid_lens,以便任何查询都只会与解码器中所有已经生成词元的位置(即直到该查询位置为止)进行注意力计算。
class DecoderBlock(nn.Module):
    """解码器中第i个块"""
    def __init__(self, key_size, query_size, value_size, num_hiddens,
                 norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
                 dropout, i, **kwargs):
        super(DecoderBlock, self).__init__(**kwargs)
        self.i = i
        self.attention1 = d2l.MultiHeadAttention(
            key_size, query_size, value_size, num_hiddens, num_heads, dropout)
        self.addnorm1 = AddNorm(norm_shape, dropout)
        self.attention2 = d2l.MultiHeadAttention(
            key_size, query_size, value_size, num_hiddens, num_heads, dropout)
        self.addnorm2 = AddNorm(norm_shape, dropout)
        self.ffn = PositionWiseFFN(ffn_num_input, ffn_num_hiddens,
                                   num_hiddens)
        self.addnorm3 = AddNorm(norm_shape, dropout)

    def forward(self, X, state):
        enc_outputs, enc_valid_lens = state[0], state[1]
        # 训练阶段,输出序列的所有词元都在同一时间处理,
        # 因此state[2][self.i]初始化为None。
        # 预测阶段,输出序列是通过词元一个接着一个解码的,
        # 因此state[2][self.i]包含着直到当前时间步第i个块解码的输出表示
        if state[2][self.i] is None:
            key_values = X
        else:
            key_values = torch.cat((state[2][self.i], X), axis=1)
        state[2][self.i] = key_values
        if self.training:
            batch_size, num_steps, _ = X.shape
            # dec_valid_lens的开头:(batch_size,num_steps),
            # 其中每一行是[1,2,...,num_steps]
            dec_valid_lens = torch.arange(
                1, num_steps + 1, device=X.device).repeat(batch_size, 1)
        else:
            dec_valid_lens = None

        # 自注意力
        X2 = self.attention1(X, key_values, key_values, dec_valid_lens)
        Y = self.addnorm1(X, X2)
        # 编码器-解码器注意力。
        # enc_outputs的开头:(batch_size,num_steps,num_hiddens)
        Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens)
        Z = self.addnorm2(Y, Y2)
return self.addnorm3(Z, self.ffn(Z)), state为了便于在“编码器-解码器”注意力中进行缩放点积计算和残差连接中进行加法计算,[编码器和解码器的特征维度都是num_hiddens。]
, paddle
decoder_blk = DecoderBlock(24, 24, 24, 24, [100, 24], 24, 48, 8, 0.5, 0)
decoder_blk.eval()
X = d2l.ones((2, 100, 24))
state = [encoder_blk(X, valid_lens), valid_lens, [None]]
decoder_blk(X, state)[0].shape现在我们构建了由num_layers个DecoderBlock实例组成的完整的[Transformer解码器]。最后,通过一个全连接层计算所有vocab_size个可能的输出词元的预测值。解码器的自注意力权重和编码器解码器注意力权重都被存储下来,方便日后可视化的需要。
class TransformerDecoder(d2l.AttentionDecoder):
    def __init__(self, vocab_size, key_size, query_size, value_size,
                 num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
                 num_heads, num_layers, dropout, **kwargs):
        super(TransformerDecoder, self).__init__(**kwargs)
        self.num_hiddens = num_hiddens
        self.num_layers = num_layers
        self.embedding = nn.Embedding(vocab_size, num_hiddens)
        self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
        self.blks = nn.Sequential()
        for i in range(num_layers):
            self.blks.add_module("block"+str(i),
                DecoderBlock(key_size, query_size, value_size, num_hiddens,
                             norm_shape, ffn_num_input, ffn_num_hiddens,
                             num_heads, dropout, i))
        self.dense = nn.Linear(num_hiddens, vocab_size)

    def init_state(self, enc_outputs, enc_valid_lens, *args):
        return [enc_outputs, enc_valid_lens, [None] * self.num_layers]

    def forward(self, X, state):
        X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
        self._attention_weights = [[None] * len(self.blks) for _ in range (2)]
        for i, blk in enumerate(self.blks):
            X, state = blk(X, state)
            # 解码器自注意力权重
            self._attention_weights[0][
                i] = blk.attention1.attention.attention_weights
            # “编码器-解码器”自注意力权重
            self._attention_weights[1][
                i] = blk.attention2.attention.attention_weights
        return self.dense(X), state

    @property
    def attention_weights(self):
return self._attention_weights[训练]
依照Transformer架构来实例化编码器-解码器模型。在这里,指定Transformer的编码器和解码器都是2层,都使用4头注意力。与 :numref:sec_seq2seq_training类似,为了进行序列到序列的学习,下面在“英语-法语”机器翻译数据集上训练Transformer模型。
num_hiddens, num_layers, dropout, batch_size, num_steps = 32, 2, 0.1, 64, 10
lr, num_epochs, device = 0.005, 200, d2l.try_gpu()
ffn_num_input, ffn_num_hiddens, num_heads = 32, 64, 4
key_size, query_size, value_size = 32, 32, 32
norm_shape = [32]

train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)

encoder = TransformerEncoder(
    len(src_vocab), key_size, query_size, value_size, num_hiddens,
    norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
    num_layers, dropout)
decoder = TransformerDecoder(
    len(tgt_vocab), key_size, query_size, value_size, num_hiddens,
    norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
    num_layers, dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)训练结束后,使用Transformer模型[将一些英语句子翻译成法语],并且计算它们的BLEU分数。
当进行最后一个英语到法语的句子翻译工作时,让我们[可视化Transformer的注意力权重]。编码器自注意力权重的形状为(编码器层数,注意力头数,num_steps或查询的数目,num_steps或“键-值”对的数目)。
在编码器的自注意力中,查询和键都来自相同的输入序列。因为填充词元是不携带信息的,因此通过指定输入序列的有效长度可以避免查询与使用填充词元的位置计算注意力。接下来,将逐行呈现两层多头注意力的权重。每个注意力头都根据查询、键和值的不同的表示子空间来表示不同的注意力。
, paddle
d2l.show_heatmaps(
    enc_attention_weights.cpu(), xlabel='Key positions',
    ylabel='Query positions', titles=['Head %d' % i for i in range(1, 5)],
figsize=(7, 3.5))[为了可视化解码器的自注意力权重和“编码器-解码器”的注意力权重,我们需要完成更多的数据操作工作。]例如用零填充被掩蔽住的注意力权重。值得注意的是,解码器的自注意力权重和“编码器-解码器”的注意力权重都有相同的查询:即以序列开始词元(beginning-of-sequence,BOS)打头,再与后续输出的词元共同组成序列。
dec_attention_weights_2d = [head[0].tolist()
                            for step in dec_attention_weight_seq
                            for attn in step for blk in attn for head in blk]
dec_attention_weights_filled = d2l.tensor(
    pd.DataFrame(dec_attention_weights_2d).fillna(0.0).values)
dec_attention_weights = d2l.reshape(dec_attention_weights_filled,
                                (-1, 2, num_layers, num_heads, num_steps))
dec_self_attention_weights, dec_inter_attention_weights = \
    dec_attention_weights.permute(1, 2, 3, 0, 4)
dec_self_attention_weights.shape, dec_inter_attention_weights.shape
由于解码器自注意力的自回归属性,查询不会对当前位置之后的“键-值”对进行注意力计算。
与编码器的自注意力的情况类似,通过指定输入序列的有效长度,[输出序列的查询不会与输入序列中填充位置的词元进行注意力计算]。
尽管Transformer架构是为了序列到序列的学习而提出的,但正如本书后面将提及的那样,Transformer编码器或Transformer解码器通常被单独用于不同的深度学习任务中。
小结
- Transformer是编码器-解码器架构的一个实践,尽管在实际情况中编码器或解码器可以单独使用。
- 在Transformer中,多头自注意力用于表示输入序列和输出序列,不过解码器必须通过掩蔽机制来保留自回归属性。
- Transformer中的残差连接和层规范化是训练非常深度模型的重要工具。
- Transformer模型中基于位置的前馈网络使用同一个多层感知机,作用是对所有序列位置的表示进行转换。
练习
- 在实验中训练更深的Transformer将如何影响训练速度和翻译效果?
- 在Transformer中使用加性注意力取代缩放点积注意力是不是个好办法?为什么?
- 对于语言模型,应该使用Transformer的编码器还是解码器,或者两者都用?如何设计?
- 如果输入序列很长,Transformer会面临什么挑战?为什么?
- 如何提高Transformer的计算速度和内存使用效率?提示:可以参考论文 (Tay.Dehghani.Bahri.ea.2020)。
- 如果不使用卷积神经网络,如何设计基于Transformer模型的图像分类任务?提示:可以参考Vision Transformer (Dosovitskiy.Beyer.Kolesnikov.ea.2021)。