18 / 19
自然语言处理:应用
前面我们学习了如何在文本序列中表示词元,
并在 :numref:chap_nlp_pretrain中训练了词元的表示。
这样的预训练文本表示可以通过不同模型架构,放入不同的下游自然语言处理任务。
前一章我们提及到一些自然语言处理应用,这些应用没有预训练,只是为了解释深度学习架构。
例如,在 :numref:chap_rnn中,
我们依赖循环神经网络设计语言模型来生成类似中篇小说的文本。
在 :numref:chap_modern_rnn和 :numref:chap_attention中,
我们还设计了基于循环神经网络和注意力机制的机器翻译模型。
然而,本书并不打算全面涵盖所有此类应用。
相反,我们的重点是如何应用深度语言表征学习来解决自然语言处理问题。
在给定预训练的文本表示的情况下,
本章将探讨两种流行且具有代表性的下游自然语言处理任务:
情感分析和自然语言推断,它们分别分析单个文本和文本对之间的关系。
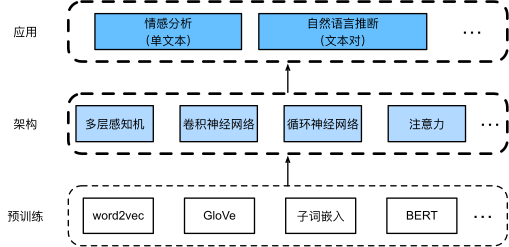
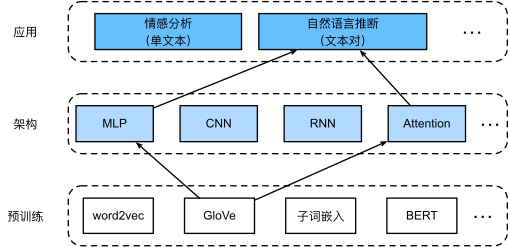
如 :numref:fig_nlp-map-app所述,
本章将重点描述然后使用不同类型的深度学习架构
(如多层感知机、卷积神经网络、循环神经网络和注意力)
设计自然语言处理模型。
尽管在 :numref:fig_nlp-map-app中,
可以将任何预训练的文本表示与任何应用的架构相结合,
但我们选择了一些具有代表性的组合。
具体来说,我们将探索基于循环神经网络和卷积神经网络的流行架构进行情感分析。
对于自然语言推断,我们选择注意力和多层感知机来演示如何分析文本对。
最后,我们介绍了如何为广泛的自然语言处理应用,
如在序列级(单文本分类和文本对分类)和词元级(文本标注和问答)上
对预训练BERT模型进行微调。
作为一个具体的经验案例,我们将针对自然语言推断对BERT进行微调。
正如我们在 :numref:sec_bert中介绍的那样,
对于广泛的自然语言处理应用,BERT只需要最少的架构更改。
然而,这一好处是以微调下游应用的大量BERT参数为代价的。
当空间或时间有限时,基于多层感知机、卷积神经网络、循环神经网络
和注意力的精心构建的模型更具可行性。
下面,我们从情感分析应用开始,分别解读基于循环神经网络和卷积神经网络的模型设计。
:maxdepth: 2

sentiment-analysis-and-dataset
sentiment-analysis-rnn
sentiment-analysis-cnn
natural-language-inference-and-dataset
natural-language-inference-attention
finetuning-bert
natural-language-inference-bert
情感分析及数据集
随着在线社交媒体和评论平台的快速发展,大量评论的数据被记录下来。这些数据具有支持决策过程的巨大潜力。
情感分析(sentiment analysis)研究人们在文本中
(如产品评论、博客评论和论坛讨论等)“隐藏”的情绪。
它在广泛应用于政治(如公众对政策的情绪分析)、
金融(如市场情绪分析)和营销(如产品研究和品牌管理)等领域。
由于情感可以被分类为离散的极性或尺度(例如,积极的和消极的),我们可以将情感分析看作一项文本分类任务,它将可变长度的文本序列转换为固定长度的文本类别。在本章中,我们将使用斯坦福大学的大型电影评论数据集(large movie review dataset)进行情感分析。它由一个训练集和一个测试集组成,其中包含从IMDb下载的25000个电影评论。在这两个数据集中,“积极”和“消极”标签的数量相同,表示不同的情感极性。
from d2l import torch as d2l
import torch
from torch import nn
import os
读取数据集
首先,下载并提取路径../data/aclImdb中的IMDb评论数据集。
接下来,读取训练和测试数据集。每个样本都是一个评论及其标签:1表示“积极”,0表示“消极”。
预处理数据集
将每个单词作为一个词元,过滤掉出现不到5次的单词,我们从训练数据集中创建一个词表。
在词元化之后,让我们绘制评论词元长度的直方图。
正如我们所料,评论的长度各不相同。为了每次处理一小批量这样的评论,我们通过截断和填充将每个评论的长度设置为500。这类似于 :numref:sec_machine_translation中对机器翻译数据集的预处理步骤。
创建数据迭代器
现在我们可以创建数据迭代器了。在每次迭代中,都会返回一小批量样本。
train_iter = d2l.load_array((train_features,
    torch.tensor(train_data[1])), 64)

for X, y in train_iter:
    print('X:', X.shape, ', y:', y.shape)
    break
print('小批量数目:', len(train_iter))
整合代码
最后,我们将上述步骤封装到load_data_imdb函数中。它返回训练和测试数据迭代器以及IMDb评论数据集的词表。
#@save
def load_data_imdb(batch_size, num_steps=500):
    """返回数据迭代器和IMDb评论数据集的词表"""
    data_dir = d2l.download_extract('aclImdb', 'aclImdb')
    train_data = read_imdb(data_dir, True)
    test_data = read_imdb(data_dir, False)
    train_tokens = d2l.tokenize(train_data[0], token='word')
    test_tokens = d2l.tokenize(test_data[0], token='word')
    vocab = d2l.Vocab(train_tokens, min_freq=5)
    train_features = torch.tensor([d2l.truncate_pad(
        vocab[line], num_steps, vocab['<pad>']) for line in train_tokens])
    test_features = torch.tensor([d2l.truncate_pad(
        vocab[line], num_steps, vocab['<pad>']) for line in test_tokens])
    train_iter = d2l.load_array((train_features, torch.tensor(train_data[1])),
                                batch_size)
    test_iter = d2l.load_array((test_features, torch.tensor(test_data[1])),
                               batch_size,
                               is_train=False)
    return train_iter, test_iter, vocab
小结
- 情感分析研究人们在文本中的情感,这被认为是一个文本分类问题,它将可变长度的文本序列进行转换转换为固定长度的文本类别。
- 经过预处理后,我们可以使用词表将IMDb评论数据集加载到数据迭代器中。
练习
- 我们可以修改本节中的哪些超参数来加速训练情感分析模型?
- 请实现一个函数来将Amazon reviews的数据集加载到数据迭代器中进行情感分析。
情感分析:使用循环神经网络
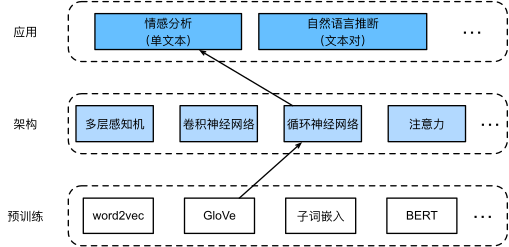
与词相似度和类比任务一样,我们也可以将预先训练的词向量应用于情感分析。由于 :numref:sec_sentiment中的IMDb评论数据集不是很大,使用在大规模语料库上预训练的文本表示可以减少模型的过拟合。作为 :numref:fig_nlp-map-sa-rnn中所示的具体示例,我们将使用预训练的GloVe模型来表示每个词元,并将这些词元表示送入多层双向循环神经网络以获得文本序列表示,该文本序列表示将被转换为情感分析输出 (Maas.Daly.Pham.ea.2011)。对于相同的下游应用,我们稍后将考虑不同的架构选择。
from d2l import torch as d2l
import torch
from torch import nn

batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
使用循环神经网络表示单个文本
在文本分类任务(如情感分析)中,可变长度的文本序列将被转换为固定长度的类别。在下面的BiRNN类中,虽然文本序列的每个词元经由嵌入层(self.embedding)获得其单独的预训练GloVe表示,但是整个序列由双向循环神经网络(self.encoder)编码。更具体地说,双向长短期记忆网络在初始和最终时间步的隐状态(在最后一层)被连结起来作为文本序列的表示。然后,通过一个具有两个输出(“积极”和“消极”)的全连接层(self.decoder),将此单一文本表示转换为输出类别。
class BiRNN(nn.Module):
    def __init__(self, vocab_size, embed_size, num_hiddens,
                 num_layers, **kwargs):
        super(BiRNN, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # 将bidirectional设置为True以获取双向循环神经网络
        self.encoder = nn.LSTM(embed_size, num_hiddens, num_layers=num_layers,
                                bidirectional=True)
        self.decoder = nn.Linear(4 * num_hiddens, 2)

    def forward(self, inputs):
        # inputs的形状是(批量大小,时间步数)
        # 因为长短期记忆网络要求其输入的第一个维度是时间维,
        # 所以在获得词元表示之前,输入会被转置。
        # 输出形状为(时间步数,批量大小,词向量维度)
        embeddings = self.embedding(inputs.T)
        self.encoder.flatten_parameters()
        # 返回上一个隐藏层在不同时间步的隐状态,
        # outputs的形状是(时间步数,批量大小,2*隐藏单元数)
        outputs, _ = self.encoder(embeddings)
        # 连结初始和最终时间步的隐状态,作为全连接层的输入,
        # 其形状为(批量大小,4*隐藏单元数)
        encoding = torch.cat((outputs[0], outputs[-1]), dim=1)
        outs = self.decoder(encoding)
        return outs
让我们构造一个具有两个隐藏层的双向循环神经网络来表示单个文本以进行情感分析。
def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.xavier_uniform_(m.weight)
    if type(m) == nn.LSTM:
        for param in m._flat_weights_names:
            if "weight" in param:
                nn.init.xavier_uniform_(m._parameters[param])
net.apply(init_weights);
加载预训练的词向量
下面,我们为词表中的单词加载预训练的100维(需要与embed_size一致)的GloVe嵌入。
打印词表中所有词元向量的形状。
我们使用这些预训练的词向量来表示评论中的词元,并且在训练期间不要更新这些向量。
net.embedding.weight.data.copy_(embeds)
net.embedding.weight.requires_grad = False
训练和评估模型
现在我们可以训练双向循环神经网络进行情感分析。
lr, num_epochs = 0.01, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)我们定义以下函数来使用训练好的模型net预测文本序列的情感。
#@save
def predict_sentiment(net, vocab, sequence):
    """预测文本序列的情感"""
    sequence = torch.tensor(vocab[sequence.split()], device=d2l.try_gpu())
    label = torch.argmax(net(sequence.reshape(1, -1)), dim=1)
    return 'positive' if label == 1 else 'negative'
最后,让我们使用训练好的模型对两个简单的句子进行情感预测。
小结
- 预训练的词向量可以表示文本序列中的各个词元。
- 双向循环神经网络可以表示文本序列。例如通过连结初始和最终时间步的隐状态,可以使用全连接的层将该单个文本表示转换为类别。
练习
- 增加迭代轮数可以提高训练和测试的准确性吗?调优其他超参数怎么样?
- 使用较大的预训练词向量,例如300维的GloVe嵌入。它是否提高了分类精度?
- 是否可以通过spaCy词元化来提高分类精度?需要安装Spacy(
pip install spacy)和英语语言包(python -m spacy download en)。在代码中,首先导入Spacy(import spacy)。然后,加载Spacy英语软件包(spacy_en = spacy.load('en'))。最后,定义函数def tokenizer(text): return [tok.text for tok in spacy_en.tokenizer(text)]并替换原来的tokenizer函数。请注意GloVe和spaCy中短语标记的不同形式。例如,短语标记“new york”在GloVe中的形式是“new-york”,而在spaCy词元化之后的形式是“new york”。
情感分析:使用卷积神经网络
在 :numref:chap_cnn中,我们探讨了使用二维卷积神经网络处理二维图像数据的机制,并将其应用于局部特征,如相邻像素。虽然卷积神经网络最初是为计算机视觉设计的,但它也被广泛用于自然语言处理。简单地说,只要将任何文本序列想象成一维图像即可。通过这种方式,一维卷积神经网络可以处理文本中的局部特征,例如元语法。
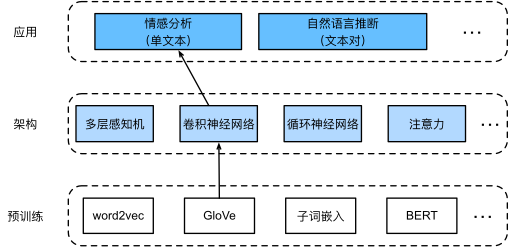
本节将使用textCNN模型来演示如何设计一个表示单个文本 (Kim.2014)的卷积神经网络架构。与 :numref:fig_nlp-map-sa-rnn中使用带有GloVe预训练的循环神经网络架构进行情感分析相比, :numref:fig_nlp-map-sa-cnn中唯一的区别在于架构的选择。
from d2l import torch as d2l
import torch
from torch import nn

batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
一维卷积
在介绍该模型之前,让我们先看看一维卷积是如何工作的。请记住,这只是基于互相关运算的二维卷积的特例。
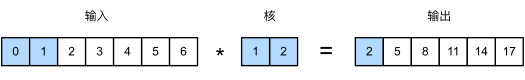 " />
如 :numref:fig_conv1d中所示,在一维情况下,卷积窗口在输入张量上从左向右滑动。在滑动期间,卷积窗口中某个位置包含的输入子张量(例如, :numref:fig_conv1d中的和)和核张量(例如, :numref:fig_conv1d中的和)按元素相乘。这些乘法的总和在输出张量的相应位置给出单个标量值(例如, :numref:fig_conv1d中的)。
我们在下面的corr1d函数中实现了一维互相关。给定输入张量X和核张量K,它返回输出张量Y。
我们可以从 :numref:fig_conv1d构造输入张量X和核张量K来验证上述一维互相关实现的输出。
对于任何具有多个通道的一维输入,卷积核需要具有相同数量的输入通道。然后,对于每个通道,对输入的一维张量和卷积核的一维张量执行互相关运算,将所有通道上的结果相加以产生一维输出张量。 :numref:fig_conv1d_channel演示了具有3个输入通道的一维互相关操作。
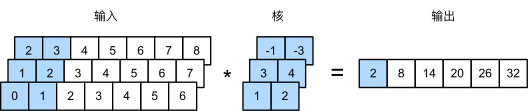 " />
我们可以实现多个输入通道的一维互相关运算,并在 :numref:fig_conv1d_channel中验证结果。
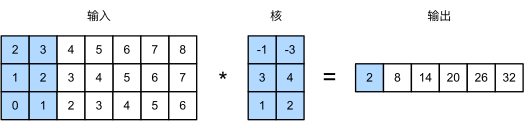
注意,多输入通道的一维互相关等同于单输入通道的二维互相关。举例说明, :numref:fig_conv1d_channel中的多输入通道一维互相关的等价形式是 :numref:fig_conv1d_2d中的单输入通道二维互相关,其中卷积核的高度必须与输入张量的高度相同。
 " />
:numref:fig_conv1d和 :numref:fig_conv1d_channel中的输出都只有一个通道。与 :numref:subsec_multi-output-channels中描述的具有多个输出通道的二维卷积相同,我们也可以为一维卷积指定多个输出通道。
最大时间汇聚层
类似地,我们可以使用汇聚层从序列表示中提取最大值,作为跨时间步的最重要特征。textCNN中使用的最大时间汇聚层的工作原理类似于一维全局汇聚 (Collobert.Weston.Bottou.ea.2011)。对于每个通道在不同时间步存储值的多通道输入,每个通道的输出是该通道的最大值。请注意,最大时间汇聚允许在不同通道上使用不同数量的时间步。
textCNN模型
使用一维卷积和最大时间汇聚,textCNN模型将单个预训练的词元表示作为输入,然后获得并转换用于下游应用的序列表示。
对于具有由维向量表示的个词元的单个文本序列,输入张量的宽度、高度和通道数分别为、和。textCNN模型将输入转换为输出,如下所示:
- 定义多个一维卷积核,并分别对输入执行卷积运算。具有不同宽度的卷积核可以捕获不同数目的相邻词元之间的局部特征。
- 在所有输出通道上执行最大时间汇聚层,然后将所有标量汇聚输出连结为向量。
- 使用全连接层将连结后的向量转换为输出类别。Dropout可以用来减少过拟合。
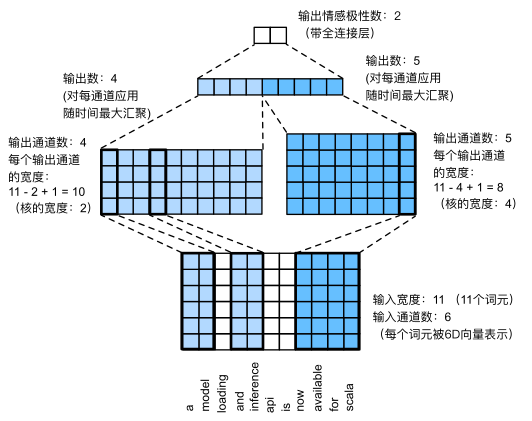
:numref:fig_conv1d_textcnn通过一个具体的例子说明了textCNN的模型架构。输入是具有11个词元的句子,其中每个词元由6维向量表示。因此,我们有一个宽度为11的6通道输入。定义两个宽度为2和4的一维卷积核,分别具有4个和5个输出通道。它们产生4个宽度为的输出通道和5个宽度为的输出通道。尽管这9个通道的宽度不同,但最大时间汇聚层给出了一个连结的9维向量,该向量最终被转换为用于二元情感预测的2维输出向量。
定义模型
我们在下面的类中实现textCNN模型。与 :numref:sec_sentiment_rnn的双向循环神经网络模型相比,除了用卷积层代替循环神经网络层外,我们还使用了两个嵌入层:一个是可训练权重,另一个是固定权重。
class TextCNN(nn.Module):
    def __init__(self, vocab_size, embed_size, kernel_sizes, num_channels,
                 **kwargs):
        super(TextCNN, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # 这个嵌入层不需要训练
        self.constant_embedding = nn.Embedding(vocab_size, embed_size)
        self.dropout = nn.Dropout(0.5)
        self.decoder = nn.Linear(sum(num_channels), 2)
        # 最大时间汇聚层没有参数,因此可以共享此实例
        self.pool = nn.AdaptiveAvgPool1d(1)
        self.relu = nn.ReLU()
        # 创建多个一维卷积层
        self.convs = nn.ModuleList()
        for c, k in zip(num_channels, kernel_sizes):
            self.convs.append(nn.Conv1d(2 * embed_size, c, k))

    def forward(self, inputs):
        # 沿着向量维度将两个嵌入层连结起来,
        # 每个嵌入层的输出形状都是(批量大小,词元数量,词元向量维度)连结起来
        embeddings = torch.cat((
            self.embedding(inputs), self.constant_embedding(inputs)), dim=2)
        # 根据一维卷积层的输入格式,重新排列张量,以便通道作为第2维
        embeddings = embeddings.permute(0, 2, 1)
        # 每个一维卷积层在最大时间汇聚层合并后,获得的张量形状是(批量大小,通道数,1)
        # 删除最后一个维度并沿通道维度连结
        encoding = torch.cat([
            torch.squeeze(self.relu(self.pool(conv(embeddings))), dim=-1)
            for conv in self.convs], dim=1)
        outputs = self.decoder(self.dropout(encoding))
        return outputs
让我们创建一个textCNN实例。它有3个卷积层,卷积核宽度分别为3、4和5,均有100个输出通道。
embed_size, kernel_sizes, nums_channels = 100, [3, 4, 5], [100, 100, 100]
devices = d2l.try_all_gpus()
net = TextCNN(len(vocab), embed_size, kernel_sizes, nums_channels)

def init_weights(m):
    if type(m) in (nn.Linear, nn.Conv1d):
        nn.init.xavier_uniform_(m.weight)

net.apply(init_weights);
加载预训练词向量
与 :numref:sec_sentiment_rnn相同,我们加载预训练的100维GloVe嵌入作为初始化的词元表示。这些词元表示(嵌入权重)在embedding中将被训练,在constant_embedding中将被固定。
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.requires_grad = False
训练和评估模型
现在我们可以训练textCNN模型进行情感分析。
lr, num_epochs = 0.001, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
下面,我们使用训练好的模型来预测两个简单句子的情感。
小结
- 一维卷积神经网络可以处理文本中的局部特征,例如元语法。
- 多输入通道的一维互相关等价于单输入通道的二维互相关。
- 最大时间汇聚层允许在不同通道上使用不同数量的时间步长。
- textCNN模型使用一维卷积层和最大时间汇聚层将单个词元表示转换为下游应用输出。
练习
- 调整超参数,并比较 :numref:
sec_sentiment_rnn中用于情感分析的架构和本节中用于情感分析的架构,例如在分类精度和计算效率方面。 - 请试着用 :numref:
sec_sentiment_rnn练习中介绍的方法进一步提高模型的分类精度。 - 在输入表示中添加位置编码。它是否提高了分类的精度?
自然语言推断与数据集
在 :numref:sec_sentiment中,我们讨论了情感分析问题。这个任务的目的是将单个文本序列分类到预定义的类别中,例如一组情感极性中。然而,当需要决定一个句子是否可以从另一个句子推断出来,或者需要通过识别语义等价的句子来消除句子间冗余时,知道如何对一个文本序列进行分类是不够的。相反,我们需要能够对成对的文本序列进行推断。
自然语言推断
自然语言推断(natural language inference)主要研究
假设(hypothesis)是否可以从前提(premise)中推断出来,
其中两者都是文本序列。
换言之,自然语言推断决定了一对文本序列之间的逻辑关系。这类关系通常分为三种类型:
- 蕴涵(entailment):假设可以从前提中推断出来。
- 矛盾(contradiction):假设的否定可以从前提中推断出来。
- 中性(neutral):所有其他情况。
自然语言推断也被称为识别文本蕴涵任务。
例如,下面的一个文本对将被贴上“蕴涵”的标签,因为假设中的“表白”可以从前提中的“拥抱”中推断出来。
前提:两个女人拥抱在一起。
假设:两个女人在示爱。
下面是一个“矛盾”的例子,因为“运行编码示例”表示“不睡觉”,而不是“睡觉”。
前提:一名男子正在运行Dive Into Deep Learning的编码示例。
假设:该男子正在睡觉。
第三个例子显示了一种“中性”关系,因为“正在为我们表演”这一事实无法推断出“出名”或“不出名”。
前提:音乐家们正在为我们表演。
假设:音乐家很有名。
自然语言推断一直是理解自然语言的中心话题。它有着广泛的应用,从信息检索到开放领域的问答。为了研究这个问题,我们将首先研究一个流行的自然语言推断基准数据集。
斯坦福自然语言推断(SNLI)数据集
[斯坦福自然语言推断语料库(Stanford Natural Language Inference,SNLI)]是由500000多个带标签的英语句子对组成的集合 (Bowman.Angeli.Potts.ea.2015)。我们在路径../data/snli_1.0中下载并存储提取的SNLI数据集。
from d2l import torch as d2l
import torch
from torch import nn
import os
import re

#@save
d2l.DATA_HUB['SNLI'] = (
    'https://nlp.stanford.edu/projects/snli/snli_1.0.zip',
    '9fcde07509c7e87ec61c640c1b2753d9041758e4')

data_dir = d2l.download_extract('SNLI')[读取数据集]
原始的SNLI数据集包含的信息比我们在实验中真正需要的信息丰富得多。因此,我们定义函数read_snli以仅提取数据集的一部分,然后返回前提、假设及其标签的列表。
现在让我们[打印前3对]前提和假设,以及它们的标签(“0”“1”和“2”分别对应于“蕴涵”“矛盾”和“中性”)。
训练集约有550000对,测试集约有10000对。下面显示了训练集和测试集中的三个[标签“蕴涵”“矛盾”和“中性”是平衡的]。
[定义用于加载数据集的类]
下面我们来定义一个用于加载SNLI数据集的类。类构造函数中的变量num_steps指定文本序列的长度,使得每个小批量序列将具有相同的形状。换句话说,在较长序列中的前num_steps个标记之后的标记被截断,而特殊标记“<pad>”将被附加到较短的序列后,直到它们的长度变为num_steps。通过实现__getitem__功能,我们可以任意访问带有索引idx的前提、假设和标签。
#@save
class SNLIDataset(torch.utils.data.Dataset):
    """用于加载SNLI数据集的自定义数据集"""
    def __init__(self, dataset, num_steps, vocab=None):
        self.num_steps = num_steps
        all_premise_tokens = d2l.tokenize(dataset[0])
        all_hypothesis_tokens = d2l.tokenize(dataset[1])
        if vocab is None:
            self.vocab = d2l.Vocab(all_premise_tokens + \
                all_hypothesis_tokens, min_freq=5, reserved_tokens=['<pad>'])
        else:
            self.vocab = vocab
        self.premises = self._pad(all_premise_tokens)
        self.hypotheses = self._pad(all_hypothesis_tokens)
        self.labels = torch.tensor(dataset[2])
        print('read ' + str(len(self.premises)) + ' examples')

    def _pad(self, lines):
        return torch.tensor([d2l.truncate_pad(
            self.vocab[line], self.num_steps, self.vocab['<pad>'])
                         for line in lines])

    def __getitem__(self, idx):
        return (self.premises[idx], self.hypotheses[idx]), self.labels[idx]

    def __len__(self):
return len(self.premises)[整合代码]
现在,我们可以调用read_snli函数和SNLIDataset类来下载SNLI数据集,并返回训练集和测试集的DataLoader实例,以及训练集的词表。值得注意的是,我们必须使用从训练集构造的词表作为测试集的词表。因此,在训练集中训练的模型将不知道来自测试集的任何新词元。
#@save
def load_data_snli(batch_size, num_steps=50):
    """下载SNLI数据集并返回数据迭代器和词表"""
    num_workers = d2l.get_dataloader_workers()
    data_dir = d2l.download_extract('SNLI')
    train_data = read_snli(data_dir, True)
    test_data = read_snli(data_dir, False)
    train_set = SNLIDataset(train_data, num_steps)
    test_set = SNLIDataset(test_data, num_steps, train_set.vocab)
    train_iter = torch.utils.data.DataLoader(train_set, batch_size,
                                             shuffle=True,
                                             num_workers=num_workers)
    test_iter = torch.utils.data.DataLoader(test_set, batch_size,
                                            shuffle=False,
                                            num_workers=num_workers)
return train_iter, test_iter, train_set.vocab在这里,我们将批量大小设置为128时,将序列长度设置为50,并调用load_data_snli函数来获取数据迭代器和词表。然后我们打印词表大小。
现在我们打印第一个小批量的形状。与情感分析相反,我们有分别代表前提和假设的两个输入X[0]和X[1]。
小结
- 自然语言推断研究“假设”是否可以从“前提”推断出来,其中两者都是文本序列。
- 在自然语言推断中,前提和假设之间的关系包括蕴涵关系、矛盾关系和中性关系。
- 斯坦福自然语言推断(SNLI)语料库是一个比较流行的自然语言推断基准数据集。
练习
- 机器翻译长期以来一直是基于翻译输出和翻译真实值之间的表面元语法匹配来进行评估的。可以设计一种用自然语言推断来评价机器翻译结果的方法吗?
- 我们如何更改超参数以减小词表大小?
自然语言推断:使用注意力
我们在 :numref:sec_natural-language-inference-and-dataset中介绍了自然语言推断任务和SNLI数据集。鉴于许多模型都是基于复杂而深度的架构,Parikh等人提出用注意力机制解决自然语言推断问题,并称之为“可分解注意力模型” (Parikh.Tackstrom.Das.ea.2016)。这使得模型没有循环层或卷积层,在SNLI数据集上以更少的参数实现了当时的最佳结果。本节将描述并实现这种基于注意力的自然语言推断方法(使用MLP),如 :numref:fig_nlp-map-nli-attention中所述。
模型
与保留前提和假设中词元的顺序相比,我们可以将一个文本序列中的词元与另一个文本序列中的每个词元对齐,然后比较和聚合这些信息,以预测前提和假设之间的逻辑关系。与机器翻译中源句和目标句之间的词元对齐类似,前提和假设之间的词元对齐可以通过注意力机制灵活地完成。
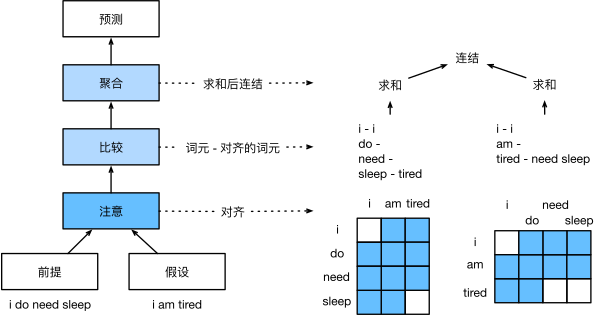
:numref:fig_nli_attention描述了使用注意力机制的自然语言推断方法。从高层次上讲,它由三个联合训练的步骤组成:对齐、比较和汇总。我们将在下面一步一步地对它们进行说明。
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
注意(Attending)
第一步是将一个文本序列中的词元与另一个序列中的每个词元对齐。假设前提是“我确实需要睡眠”,假设是“我累了”。由于语义上的相似性,我们不妨将假设中的“我”与前提中的“我”对齐,将假设中的“累”与前提中的“睡眠”对齐。同样,我们可能希望将前提中的“我”与假设中的“我”对齐,将前提中的“需要”和“睡眠”与假设中的“累”对齐。请注意,这种对齐是使用加权平均的“软”对齐,其中理想情况下较大的权重与要对齐的词元相关联。为了便于演示, :numref:fig_nli_attention以“硬”对齐的方式显示了这种对齐方式。
现在,我们更详细地描述使用注意力机制的软对齐。用和表示前提和假设,其词元数量分别为和,其中()是维的词向量。对于软对齐,我们将注意力权重计算为:
其中函数是在下面的mlp函数中定义的多层感知机。输出维度由mlp的num_hiddens参数指定。
def mlp(num_inputs, num_hiddens, flatten):
    net = []
    net.append(nn.Dropout(0.2))
    net.append(nn.Linear(num_inputs, num_hiddens))
    net.append(nn.ReLU())
    if flatten:
        net.append(nn.Flatten(start_dim=1))
    net.append(nn.Dropout(0.2))
    net.append(nn.Linear(num_hiddens, num_hiddens))
    net.append(nn.ReLU())
    if flatten:
        net.append(nn.Flatten(start_dim=1))
    return nn.Sequential(*net)
值得注意的是,在 :eqref:eq_nli_e中,分别输入和,而不是将它们一对放在一起作为输入。这种分解技巧导致只有个次计算(线性复杂度),而不是次计算(二次复杂度)
对 :eqref:eq_nli_e中的注意力权重进行规范化,我们计算假设中所有词元向量的加权平均值,以获得假设的表示,该假设与前提中索引的词元进行软对齐:
同样,我们计算假设中索引为的每个词元与前提词元的软对齐:
下面,我们定义Attend类来计算假设(beta)与输入前提A的软对齐以及前提(alpha)与输入假设B的软对齐。
class Attend(nn.Module):
    def __init__(self, num_inputs, num_hiddens, **kwargs):
        super(Attend, self).__init__(**kwargs)
        self.f = mlp(num_inputs, num_hiddens, flatten=False)

    def forward(self, A, B):
        # A/B的形状:(批量大小,序列A/B的词元数,embed_size)
        # f_A/f_B的形状:(批量大小,序列A/B的词元数,num_hiddens)
        f_A = self.f(A)
        f_B = self.f(B)
        # e的形状:(批量大小,序列A的词元数,序列B的词元数)
        e = torch.bmm(f_A, f_B.permute(0, 2, 1))
        # beta的形状:(批量大小,序列A的词元数,embed_size),
        # 意味着序列B被软对齐到序列A的每个词元(beta的第1个维度)
        beta = torch.bmm(F.softmax(e, dim=-1), B)
        # beta的形状:(批量大小,序列B的词元数,embed_size),
        # 意味着序列A被软对齐到序列B的每个词元(alpha的第1个维度)
        alpha = torch.bmm(F.softmax(e.permute(0, 2, 1), dim=-1), A)
        return beta, alpha
比较
在下一步中,我们将一个序列中的词元与与该词元软对齐的另一个序列进行比较。请注意,在软对齐中,一个序列中的所有词元(尽管可能具有不同的注意力权重)将与另一个序列中的词元进行比较。为便于演示, :numref:fig_nli_attention对词元以硬的方式对齐。例如,上述的注意(attending)步骤确定前提中的“need”和“sleep”都与假设中的“tired”对齐,则将对“疲倦-需要睡眠”进行比较。
在比较步骤中,我们将来自一个序列的词元的连结(运算符)和来自另一序列的对齐的词元送入函数(一个多层感知机):
在 :eqref:eq_nli_v_ab中,是指,所有假设中的词元与前提中词元软对齐,再与词元的比较;而是指,所有前提中的词元与假设中词元软对齐,再与词元的比较。下面的Compare个类定义了比较步骤。
class Compare(nn.Module):
    def __init__(self, num_inputs, num_hiddens, **kwargs):
        super(Compare, self).__init__(**kwargs)
        self.g = mlp(num_inputs, num_hiddens, flatten=False)

    def forward(self, A, B, beta, alpha):
        V_A = self.g(torch.cat([A, beta], dim=2))
        V_B = self.g(torch.cat([B, alpha], dim=2))
        return V_A, V_B
聚合
现在我们有两组比较向量()和()。在最后一步中,我们将聚合这些信息以推断逻辑关系。我们首先求和这两组比较向量:
接下来,我们将两个求和结果的连结提供给函数(一个多层感知机),以获得逻辑关系的分类结果:
聚合步骤在以下Aggregate类中定义。
class Aggregate(nn.Module):
    def __init__(self, num_inputs, num_hiddens, num_outputs, **kwargs):
        super(Aggregate, self).__init__(**kwargs)
        self.h = mlp(num_inputs, num_hiddens, flatten=True)
        self.linear = nn.Linear(num_hiddens, num_outputs)

    def forward(self, V_A, V_B):
        # 对两组比较向量分别求和
        V_A = V_A.sum(dim=1)
        V_B = V_B.sum(dim=1)
        # 将两个求和结果的连结送到多层感知机中
        Y_hat = self.linear(self.h(torch.cat([V_A, V_B], dim=1)))
        return Y_hat
整合代码
通过将注意步骤、比较步骤和聚合步骤组合在一起,我们定义了可分解注意力模型来联合训练这三个步骤。
class DecomposableAttention(nn.Module):
    def __init__(self, vocab, embed_size, num_hiddens, num_inputs_attend=100,
                 num_inputs_compare=200, num_inputs_agg=400, **kwargs):
        super(DecomposableAttention, self).__init__(**kwargs)
        self.embedding = nn.Embedding(len(vocab), embed_size)
        self.attend = Attend(num_inputs_attend, num_hiddens)
        self.compare = Compare(num_inputs_compare, num_hiddens)
        # 有3种可能的输出:蕴涵、矛盾和中性
        self.aggregate = Aggregate(num_inputs_agg, num_hiddens, num_outputs=3)

    def forward(self, X):
        premises, hypotheses = X
        A = self.embedding(premises)
        B = self.embedding(hypotheses)
        beta, alpha = self.attend(A, B)
        V_A, V_B = self.compare(A, B, beta, alpha)
        Y_hat = self.aggregate(V_A, V_B)
        return Y_hat
训练和评估模型
现在,我们将在SNLI数据集上对定义好的可分解注意力模型进行训练和评估。我们从读取数据集开始。
读取数据集
我们使用 :numref:sec_natural-language-inference-and-dataset中定义的函数下载并读取SNLI数据集。批量大小和序列长度分别设置为和。
创建模型
我们使用预训练好的100维GloVe嵌入来表示输入词元。我们将向量和在 :eqref:eq_nli_e中的维数预定义为100。 :eqref:eq_nli_e中的函数和 :eqref:eq_nli_v_ab中的函数的输出维度被设置为200.然后我们创建一个模型实例,初始化它的参数,并加载GloVe嵌入来初始化输入词元的向量。
embed_size, num_hiddens, devices = 100, 200, d2l.try_all_gpus()
net = DecomposableAttention(vocab, embed_size, num_hiddens)
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds);
训练和评估模型
与 :numref:sec_multi_gpu中接受单一输入(如文本序列或图像)的split_batch函数不同,我们定义了一个split_batch_multi_inputs函数以小批量接受多个输入,如前提和假设。
现在我们可以在SNLI数据集上训练和评估模型。
lr, num_epochs = 0.001, 4
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
    devices)
使用模型
最后,定义预测函数,输出一对前提和假设之间的逻辑关系。
#@save
def predict_snli(net, vocab, premise, hypothesis):
    """预测前提和假设之间的逻辑关系"""
    net.eval()
    premise = torch.tensor(vocab[premise], device=d2l.try_gpu())
    hypothesis = torch.tensor(vocab[hypothesis], device=d2l.try_gpu())
    label = torch.argmax(net([premise.reshape((1, -1)),
                           hypothesis.reshape((1, -1))]), dim=1)
    return 'entailment' if label == 0 else 'contradiction' if label == 1 \
            else 'neutral'
我们可以使用训练好的模型来获得对示例句子的自然语言推断结果。
小结
- 可分解注意模型包括三个步骤来预测前提和假设之间的逻辑关系:注意、比较和聚合。
- 通过注意力机制,我们可以将一个文本序列中的词元与另一个文本序列中的每个词元对齐,反之亦然。这种对齐是使用加权平均的软对齐,其中理想情况下较大的权重与要对齐的词元相关联。
- 在计算注意力权重时,分解技巧会带来比二次复杂度更理想的线性复杂度。
- 我们可以使用预训练好的词向量作为下游自然语言处理任务(如自然语言推断)的输入表示。
练习
- 使用其他超参数组合训练模型,能在测试集上获得更高的准确度吗?
- 自然语言推断的可分解注意模型的主要缺点是什么?
- 假设我们想要获得任何一对句子的语义相似级别(例如,0~1之间的连续值)。我们应该如何收集和标注数据集?请尝试设计一个有注意力机制的模型。
针对序列级和词元级应用微调BERT
在本章的前几节中,我们为自然语言处理应用设计了不同的模型,例如基于循环神经网络、卷积神经网络、注意力和多层感知机。这些模型在有空间或时间限制的情况下是有帮助的,但是,为每个自然语言处理任务精心设计一个特定的模型实际上是不可行的。在 :numref:sec_bert中,我们介绍了一个名为BERT的预训练模型,该模型可以对广泛的自然语言处理任务进行最少的架构更改。一方面,在提出时,BERT改进了各种自然语言处理任务的技术水平。另一方面,正如在 :numref:sec_bert-pretraining中指出的那样,原始BERT模型的两个版本分别带有1.1亿和3.4亿个参数。因此,当有足够的计算资源时,我们可以考虑为下游自然语言处理应用微调BERT。
下面,我们将自然语言处理应用的子集概括为序列级和词元级。在序列层次上,介绍了在单文本分类任务和文本对分类(或回归)任务中,如何将文本输入的BERT表示转换为输出标签。在词元级别,我们将简要介绍新的应用,如文本标注和问答,并说明BERT如何表示它们的输入并转换为输出标签。在微调期间,不同应用之间的BERT所需的“最小架构更改”是额外的全连接层。在下游应用的监督学习期间,额外层的参数是从零开始学习的,而预训练BERT模型中的所有参数都是微调的。
单文本分类
单文本分类将单个文本序列作为输入,并输出其分类结果。
除了我们在这一章中探讨的情感分析之外,语言可接受性语料库(Corpus of Linguistic Acceptability,COLA)也是一个单文本分类的数据集,它的要求判断给定的句子在语法上是否可以接受。 (Warstadt.Singh.Bowman.2019)。例如,“I should study.”是可以接受的,但是“I should studying.”不是可以接受的。
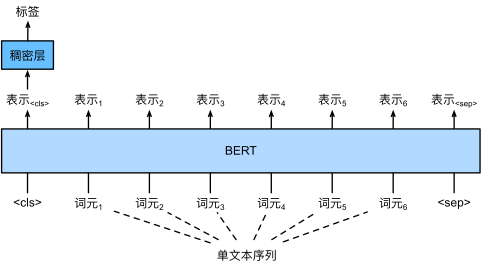
:numref:sec_bert描述了BERT的输入表示。BERT输入序列明确地表示单个文本和文本对,其中特殊分类标记“<cls>”用于序列分类,而特殊分类标记“<sep>”标记单个文本的结束或分隔成对文本。如 :numref:fig_bert-one-seq所示,在单文本分类应用中,特殊分类标记“<cls>”的BERT表示对整个输入文本序列的信息进行编码。作为输入单个文本的表示,它将被送入到由全连接(稠密)层组成的小多层感知机中,以输出所有离散标签值的分布。
文本对分类或回归
在本章中,我们还研究了自然语言推断。它属于文本对分类,这是一种对文本进行分类的应用类型。
以一对文本作为输入但输出连续值,语义文本相似度是一个流行的“文本对回归”任务。
这项任务评估句子的语义相似度。例如,在语义文本相似度基准数据集(Semantic Textual Similarity Benchmark)中,句子对的相似度得分是从0(无语义重叠)到5(语义等价)的分数区间 (Cer.Diab.Agirre.ea.2017)。我们的目标是预测这些分数。来自语义文本相似性基准数据集的样本包括(句子1,句子2,相似性得分):
- "A plane is taking off."(“一架飞机正在起飞。”),"An air plane is taking off."(“一架飞机正在起飞。”),5.000分;
- "A woman is eating something."(“一个女人在吃东西。”),"A woman is eating meat."(“一个女人在吃肉。”),3.000分;
- "A woman is dancing."(一个女人在跳舞。),"A man is talking."(“一个人在说话。”),0.000分。
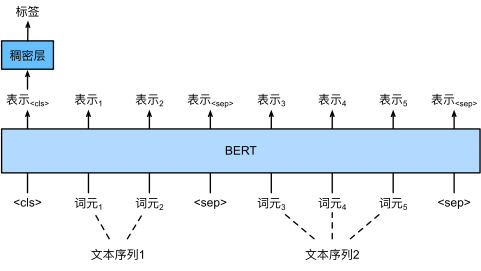
与 :numref:fig_bert-one-seq中的单文本分类相比, :numref:fig_bert-two-seqs中的文本对分类的BERT微调在输入表示上有所不同。对于文本对回归任务(如语义文本相似性),可以应用细微的更改,例如输出连续的标签值和使用均方损失:它们在回归中很常见。
文本标注
现在让我们考虑词元级任务,比如文本标注(text tagging),其中每个词元都被分配了一个标签。在文本标注任务中,词性标注为每个单词分配词性标记(例如,形容词和限定词)。
根据单词在句子中的作用。如,在Penn树库II标注集中,句子“John Smith‘s car is new”应该被标记为“NNP(名词,专有单数)NNP POS(所有格结尾)NN(名词,单数或质量)VB(动词,基本形式)JJ(形容词)”。
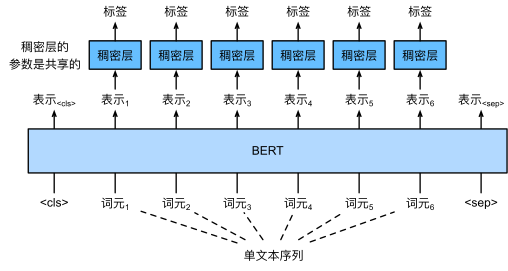
:numref:fig_bert-tagging中说明了文本标记应用的BERT微调。与 :numref:fig_bert-one-seq相比,唯一的区别在于,在文本标注中,输入文本的每个词元的BERT表示被送到相同的额外全连接层中,以输出词元的标签,例如词性标签。
问答
作为另一个词元级应用,问答反映阅读理解能力。
例如,斯坦福问答数据集(Stanford Question Answering Dataset,SQuAD v1.1)由阅读段落和问题组成,其中每个问题的答案只是段落中的一段文本(文本片段) (Rajpurkar.Zhang.Lopyrev.ea.2016)。举个例子,考虑一段话:“Some experts report that a mask's efficacy is inconclusive.However,mask makers insist that their products,such as N95 respirator masks,can guard against the virus.”(“一些专家报告说面罩的功效是不确定的。然而,口罩制造商坚持他们的产品,如N95口罩,可以预防病毒。”)还有一个问题“Who say that N95 respirator masks can guard against the virus?”(“谁说N95口罩可以预防病毒?”)。答案应该是文章中的文本片段“mask makers”(“口罩制造商”)。因此,SQuAD v1.1的目标是在给定问题和段落的情况下预测段落中文本片段的开始和结束。
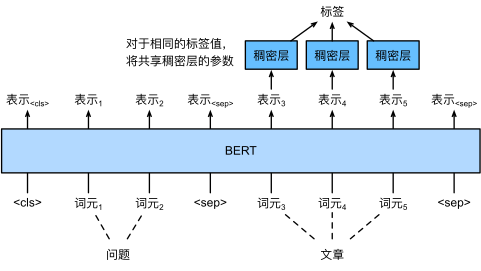
为了微调BERT进行问答,在BERT的输入中,将问题和段落分别作为第一个和第二个文本序列。为了预测文本片段开始的位置,相同的额外的全连接层将把来自位置的任何词元的BERT表示转换成标量分数。文章中所有词元的分数还通过softmax转换成概率分布,从而为文章中的每个词元位置分配作为文本片段开始的概率。预测文本片段的结束与上面相同,只是其额外的全连接层中的参数与用于预测开始位置的参数无关。当预测结束时,位置的词元由相同的全连接层变换成标量分数。 :numref:fig_bert-qa描述了用于问答的微调BERT。
对于问答,监督学习的训练目标就像最大化真实值的开始和结束位置的对数似然一样简单。当预测片段时,我们可以计算从位置到位置的有效片段的分数(),并输出分数最高的跨度。
小结
- 对于序列级和词元级自然语言处理应用,BERT只需要最小的架构改变(额外的全连接层),如单个文本分类(例如,情感分析和测试语言可接受性)、文本对分类或回归(例如,自然语言推断和语义文本相似性)、文本标记(例如,词性标记)和问答。
- 在下游应用的监督学习期间,额外层的参数是从零开始学习的,而预训练BERT模型中的所有参数都是微调的。
练习
- 让我们为新闻文章设计一个搜索引擎算法。当系统接收到查询(例如,“冠状病毒爆发期间的石油行业”)时,它应该返回与该查询最相关的新闻文章的排序列表。假设我们有一个巨大的新闻文章池和大量的查询。为了简化问题,假设为每个查询标记了最相关的文章。如何在算法设计中应用负采样(见 :numref:
subsec_negative-sampling)和BERT? - 我们如何利用BERT来训练语言模型?
- 我们能在机器翻译中利用BERT吗?
自然语言推断:微调BERT
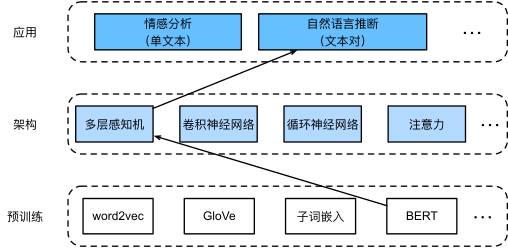
在本章的前面几节中,我们已经为SNLI数据集( :numref:sec_natural-language-inference-and-dataset)上的自然语言推断任务设计了一个基于注意力的结构( :numref:sec_natural-language-inference-attention)。现在,我们通过微调BERT来重新审视这项任务。正如在 :numref:sec_finetuning-bert中讨论的那样,自然语言推断是一个序列级别的文本对分类问题,而微调BERT只需要一个额外的基于多层感知机的架构,如 :numref:fig_nlp-map-nli-bert中所示。
本节将下载一个预训练好的小版本的BERT,然后对其进行微调,以便在SNLI数据集上进行自然语言推断。
from d2l import torch as d2l
import json
import multiprocessing
import torch
from torch import nn
import os[加载预训练的BERT]
我们已经在 :numref:sec_bert-dataset和 :numref:sec_bert-pretrainingWikiText-2数据集上预训练BERT(请注意,原始的BERT模型是在更大的语料库上预训练的)。正如在 :numref:sec_bert-pretraining中所讨论的,原始的BERT模型有数以亿计的参数。在下面,我们提供了两个版本的预训练的BERT:“bert.base”与原始的BERT基础模型一样大,需要大量的计算资源才能进行微调,而“bert.small”是一个小版本,以便于演示。
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.torch.zip',
                             '225d66f04cae318b841a13d32af3acc165f253ac')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.torch.zip',
'c72329e68a732bef0452e4b96a1c341c8910f81f')两个预训练好的BERT模型都包含一个定义词表的“vocab.json”文件和一个预训练参数的“pretrained.params”文件。我们实现了以下load_pretrained_model函数来[加载预先训练好的BERT参数]。
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
                          num_heads, num_layers, dropout, max_len, devices):
    data_dir = d2l.download_extract(pretrained_model)
    # 定义空词表以加载预定义词表
    vocab = d2l.Vocab()
    vocab.idx_to_token = json.load(open(os.path.join(data_dir,
        'vocab.json')))
    vocab.token_to_idx = {token: idx for idx, token in enumerate(
        vocab.idx_to_token)}
    bert = d2l.BERTModel(len(vocab), num_hiddens, norm_shape=[256],
                         ffn_num_input=256, ffn_num_hiddens=ffn_num_hiddens,
                         num_heads=4, num_layers=2, dropout=0.2,
                         max_len=max_len, key_size=256, query_size=256,
                         value_size=256, hid_in_features=256,
                         mlm_in_features=256, nsp_in_features=256)
    # 加载预训练BERT参数
    bert.load_state_dict(torch.load(os.path.join(data_dir,
                                                 'pretrained.params')))
    return bert, vocab
为了便于在大多数机器上演示,我们将在本节中加载和微调经过预训练BERT的小版本(“bert.small”)。在练习中,我们将展示如何微调大得多的“bert.base”以显著提高测试精度。
[微调BERT的数据集]
对于SNLI数据集的下游任务自然语言推断,我们定义了一个定制的数据集类SNLIBERTDataset。在每个样本中,前提和假设形成一对文本序列,并被打包成一个BERT输入序列,如 :numref:fig_bert-two-seqs所示。回想 :numref:subsec_bert_input_rep,片段索引用于区分BERT输入序列中的前提和假设。利用预定义的BERT输入序列的最大长度(max_len),持续移除输入文本对中较长文本的最后一个标记,直到满足max_len。为了加速生成用于微调BERT的SNLI数据集,我们使用4个工作进程并行生成训练或测试样本。
class SNLIBERTDataset(torch.utils.data.Dataset):
    def __init__(self, dataset, max_len, vocab=None):
        all_premise_hypothesis_tokens = [[
            p_tokens, h_tokens] for p_tokens, h_tokens in zip(
            *[d2l.tokenize([s.lower() for s in sentences])
              for sentences in dataset[:2]])]

        self.labels = torch.tensor(dataset[2])
        self.vocab = vocab
        self.max_len = max_len
        (self.all_token_ids, self.all_segments,
         self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
        print('read ' + str(len(self.all_token_ids)) + ' examples')

    def _preprocess(self, all_premise_hypothesis_tokens):
        pool = multiprocessing.Pool(4)  # 使用4个进程
        out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
        all_token_ids = [
            token_ids for token_ids, segments, valid_len in out]
        all_segments = [segments for token_ids, segments, valid_len in out]
        valid_lens = [valid_len for token_ids, segments, valid_len in out]
        return (torch.tensor(all_token_ids, dtype=torch.long),
                torch.tensor(all_segments, dtype=torch.long),
                torch.tensor(valid_lens))

    def _mp_worker(self, premise_hypothesis_tokens):
        p_tokens, h_tokens = premise_hypothesis_tokens
        self._truncate_pair_of_tokens(p_tokens, h_tokens)
        tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
        token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
                             * (self.max_len - len(tokens))
        segments = segments + [0] * (self.max_len - len(segments))
        valid_len = len(tokens)
        return token_ids, segments, valid_len

    def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
        # 为BERT输入中的'<CLS>'、'<SEP>'和'<SEP>'词元保留位置
        while len(p_tokens) + len(h_tokens) > self.max_len - 3:
            if len(p_tokens) > len(h_tokens):
                p_tokens.pop()
            else:
                h_tokens.pop()

    def __getitem__(self, idx):
        return (self.all_token_ids[idx], self.all_segments[idx],
                self.valid_lens[idx]), self.labels[idx]

    def __len__(self):
return len(self.all_token_ids)下载完SNLI数据集后,我们通过实例化SNLIBERTDataset类来[生成训练和测试样本]。这些样本将在自然语言推断的训练和测试期间进行小批量读取。
# 如果出现显存不足错误,请减少“batch_size”。在原始的BERT模型中,max_len=512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = torch.utils.data.DataLoader(train_set, batch_size, shuffle=True,
                                   num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(test_set, batch_size,
                                  num_workers=num_workers)
微调BERT
如 :numref:fig_bert-two-seqs所示,用于自然语言推断的微调BERT只需要一个额外的多层感知机,该多层感知机由两个全连接层组成(请参见下面BERTClassifier类中的self.hidden和self.output)。[这个多层感知机将特殊的“<cls>”词元]的BERT表示进行了转换,该词元同时编码前提和假设的信息(为自然语言推断的三个输出):蕴涵、矛盾和中性。
class BERTClassifier(nn.Module):
    def __init__(self, bert):
        super(BERTClassifier, self).__init__()
        self.encoder = bert.encoder
        self.hidden = bert.hidden
        self.output = nn.Linear(256, 3)

    def forward(self, inputs):
        tokens_X, segments_X, valid_lens_x = inputs
        encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x)
return self.output(self.hidden(encoded_X[:, 0, :]))在下文中,预训练的BERT模型bert被送到用于下游应用的BERTClassifier实例net中。在BERT微调的常见实现中,只有额外的多层感知机(net.output)的输出层的参数将从零开始学习。预训练BERT编码器(net.encoder)和额外的多层感知机的隐藏层(net.hidden)的所有参数都将进行微调。
, paddle
net = BERTClassifier(bert)
回想一下,在 :numref:sec_bert中,MaskLM类和NextSentencePred类在其使用的多层感知机中都有一些参数。这些参数是预训练BERT模型bert中参数的一部分,因此是net中的参数的一部分。然而,这些参数仅用于计算预训练过程中的遮蔽语言模型损失和下一句预测损失。这两个损失函数与微调下游应用无关,因此当BERT微调时,MaskLM和NextSentencePred中采用的多层感知机的参数不会更新(陈旧的,staled)。
为了允许具有陈旧梯度的参数,标志ignore_stale_grad=True在step函数d2l.train_batch_ch13中被设置。我们通过该函数使用SNLI的训练集(train_iter)和测试集(test_iter)对net模型进行训练和评估。由于计算资源有限,[训练]和测试精度可以进一步提高:我们把对它的讨论留在练习中。
lr, num_epochs = 1e-4, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction='none')
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
    devices)
小结
- 我们可以针对下游应用对预训练的BERT模型进行微调,例如在SNLI数据集上进行自然语言推断。
- 在微调过程中,BERT模型成为下游应用模型的一部分。仅与训练前损失相关的参数在微调期间不会更新。
练习
- 如果您的计算资源允许,请微调一个更大的预训练BERT模型,该模型与原始的BERT基础模型一样大。修改
load_pretrained_model函数中的参数设置:将“bert.small”替换为“bert.base”,将num_hiddens=256、ffn_num_hiddens=512、num_heads=4和num_layers=2的值分别增加到768、3072、12和12。通过增加微调迭代轮数(可能还会调优其他超参数),你可以获得高于0.86的测试精度吗? - 如何根据一对序列的长度比值截断它们?将此对截断方法与
SNLIBERTDataset类中使用的方法进行比较。它们的利弊是什么?