15 / 20
第 13 章 回溯
摘要
我们如同迷宫中的探索者,在前进的道路上可能会遇到困难。
回溯的力量让我们能够重新开始,不断尝试,最终找到通往光明的出口。
回溯算法
回溯算法(backtracking algorithm)是一种通过穷举来解决问题的方法,它的核心思想是从一个初始状态出发,暴力搜索所有可能的解决方案,当遇到正确的解则将其记录,直到找到解或者尝试了所有可能的选择都无法找到解为止。
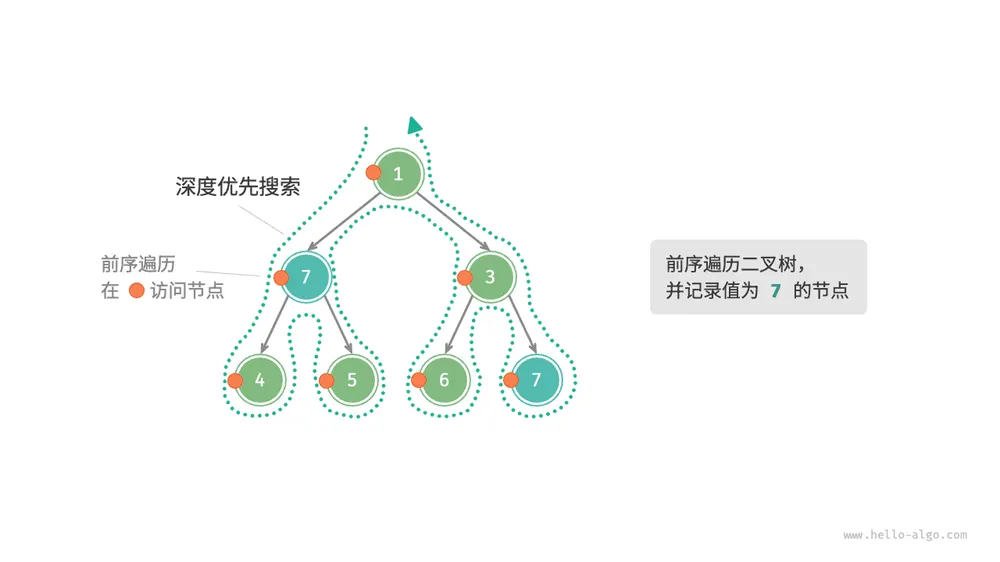
回溯算法通常采用“深度优先搜索”来遍历解空间。在“二叉树”章节中,我们提到前序、中序和后序遍历都属于深度优先搜索。接下来,我们利用前序遍历构造一个回溯问题,逐步了解回溯算法的工作原理。
例题一
给定一棵二叉树,搜索并记录所有值为 的节点,请返回节点列表。
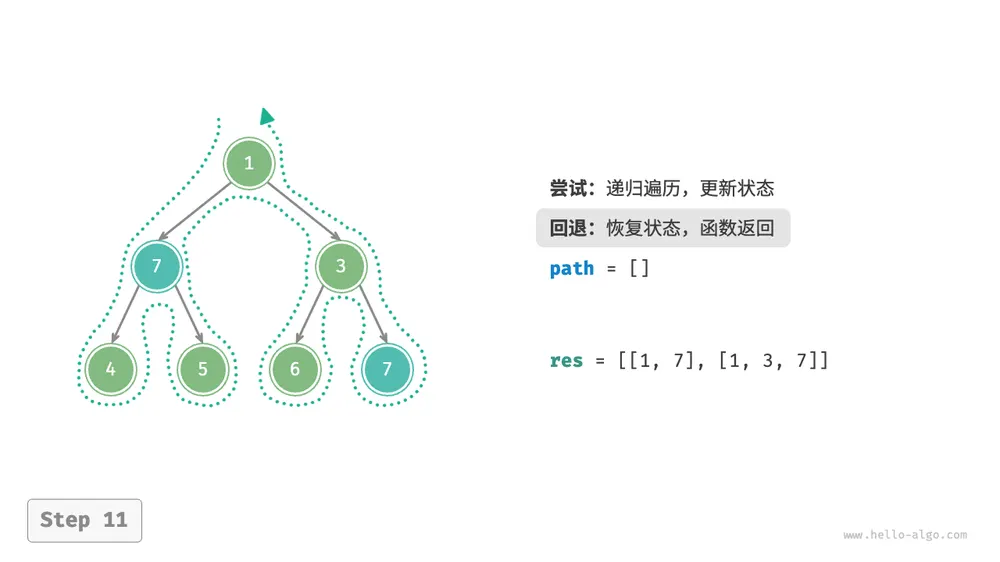
对于此题,我们前序遍历这棵树,并判断当前节点的值是否为 ,若是,则将该节点的值加入结果列表 res 之中。相关过程实现如下图和以下代码所示:
/* 前序遍历:例题一 */
static void preOrder(TreeNode root) {
    if (root == null) {
        return;
    }
    if (root.val == 7) {
        // 记录解
        res.add(root);
    }
    preOrder(root.left);
    preOrder(root.right);
}
尝试与回退
之所以称之为回溯算法,是因为该算法在搜索解空间时会采用“尝试”与“回退”的策略。当算法在搜索过程中遇到某个状态无法继续前进或无法得到满足条件的解时,它会撤销上一步的选择,退回到之前的状态,并尝试其他可能的选择。
对于例题一,访问每个节点都代表一次“尝试”,而越过叶节点或返回父节点的 return 则表示“回退”。
值得说明的是,回退并不仅仅包括函数返回。为解释这一点,我们对例题一稍作拓展。
例题二
在二叉树中搜索所有值为 的节点,请返回根节点到这些节点的路径。
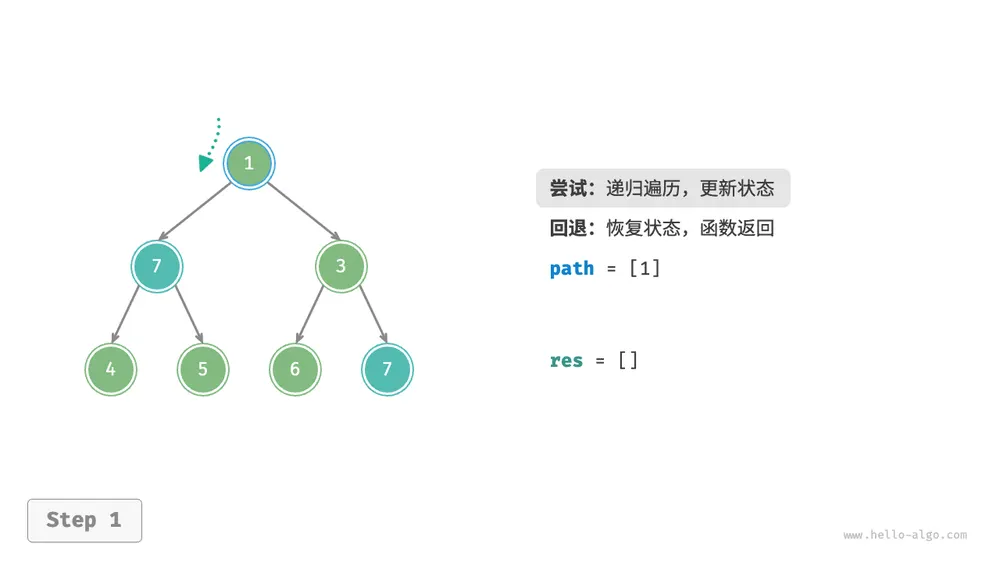
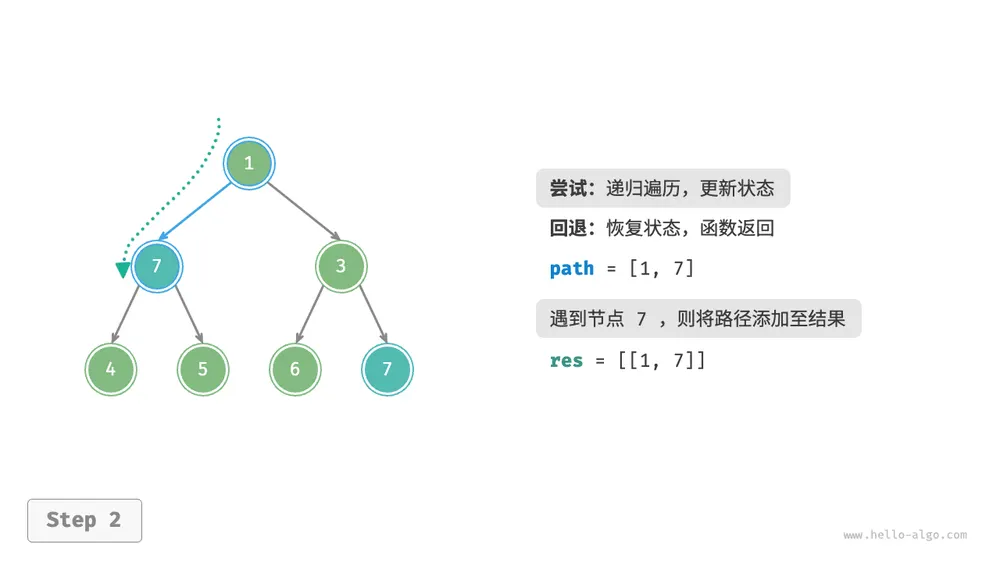
在例题一代码的基础上,我们需要借助一个列表 path 记录访问过的节点路径。当访问到值为 的节点时,则复制 path 并添加进结果列表 res 。遍历完成后,res 中保存的就是所有的解。代码如下所示:
/* 前序遍历:例题二 */
static void preOrder(TreeNode root) {
    if (root == null) {
        return;
    }
    // 尝试
    path.add(root);
    if (root.val == 7) {
        // 记录解
        res.add(new ArrayList<>(path));
    }
    preOrder(root.left);
    preOrder(root.right);
    // 回退
    path.remove(path.size() - 1);
}
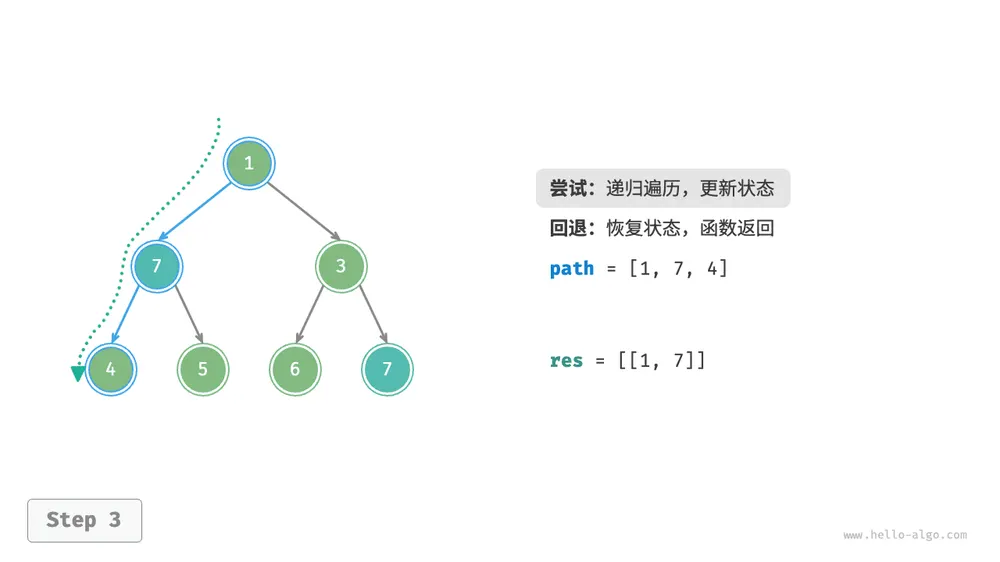
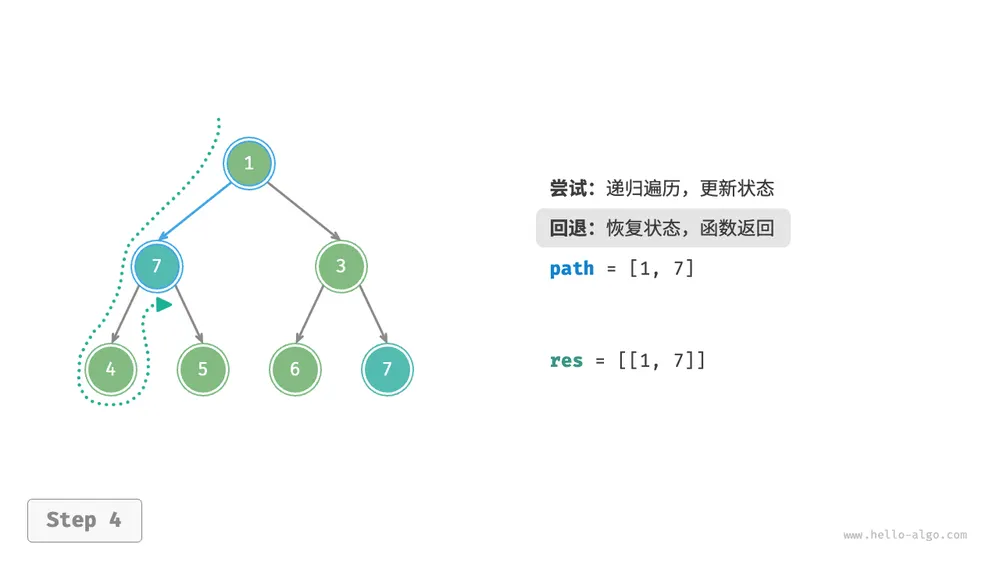
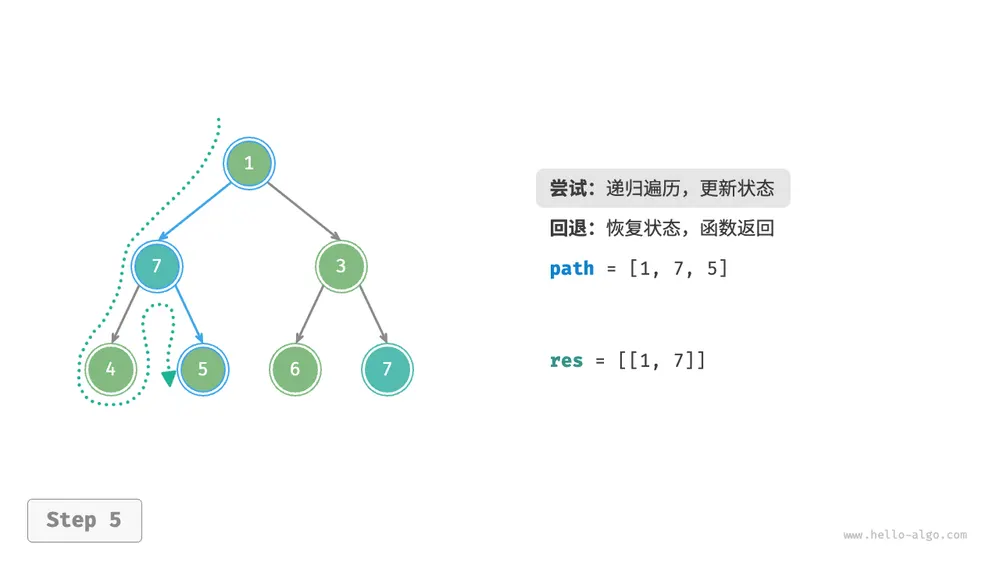
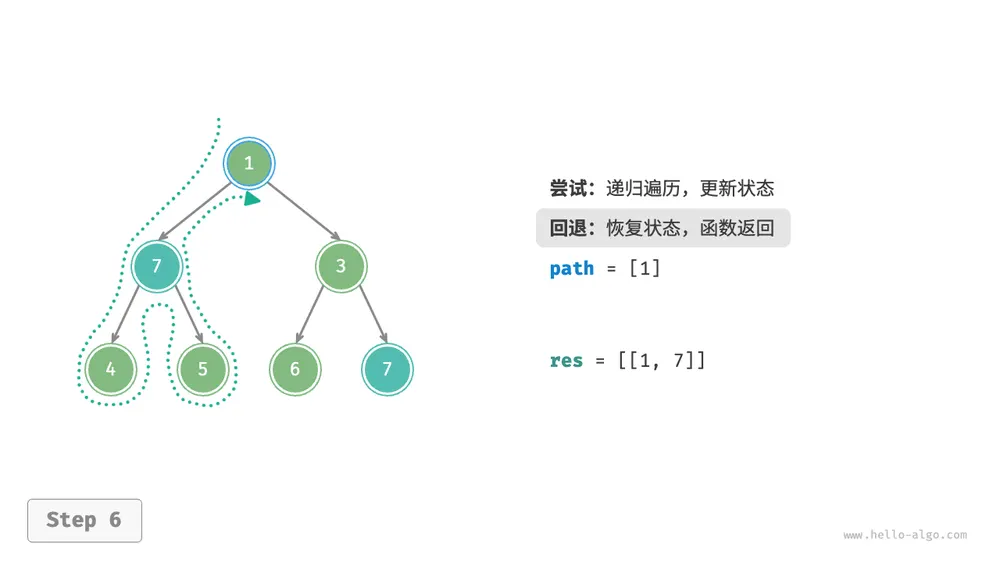
在每次“尝试”中,我们通过将当前节点添加进 path 来记录路径;而在“回退”前,我们需要将该节点从 path 中弹出,以恢复本次尝试之前的状态。
观察下图所示的过程,我们可以将尝试和回退理解为“前进”与“撤销”,两个操作互为逆向。
第 1 步
第 2 步
第 3 步
第 4 步
第 5 步
第 6 步
第 7 步
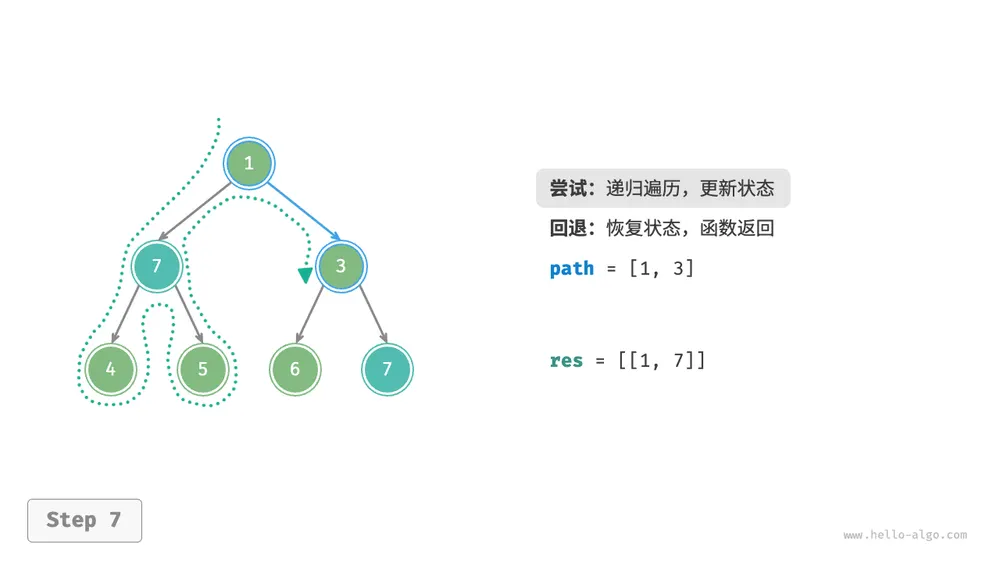
第 8 步
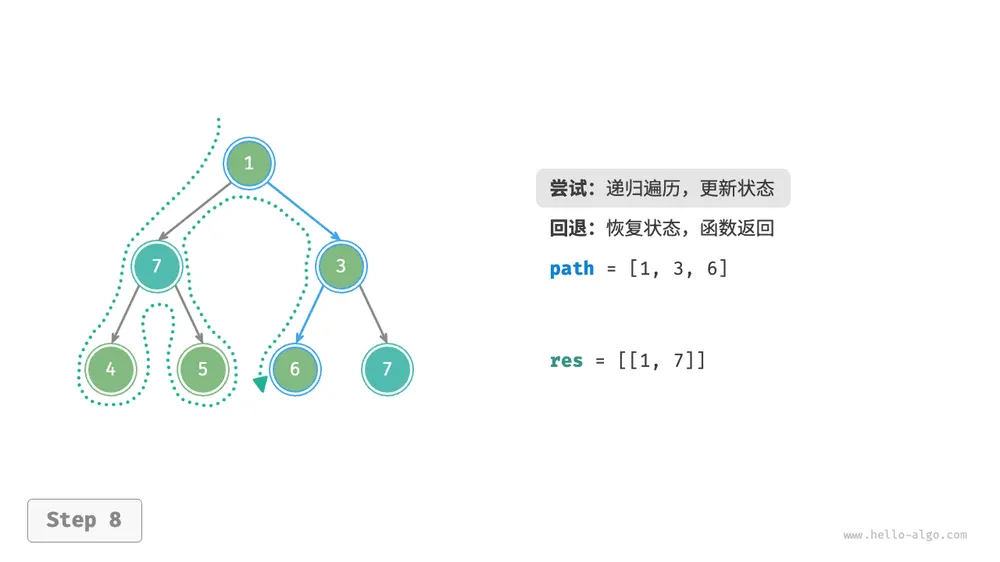
第 9 步
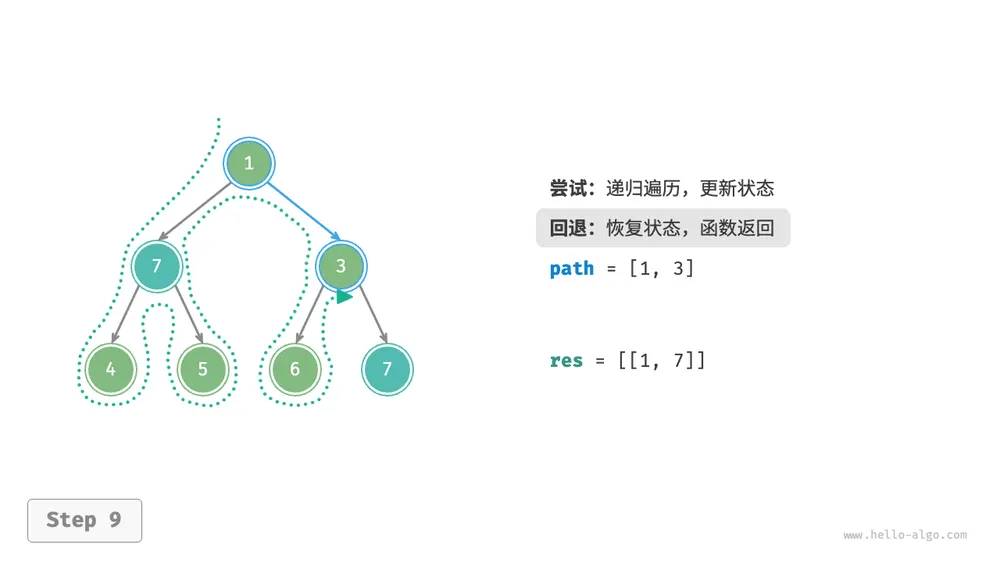
第 10 步
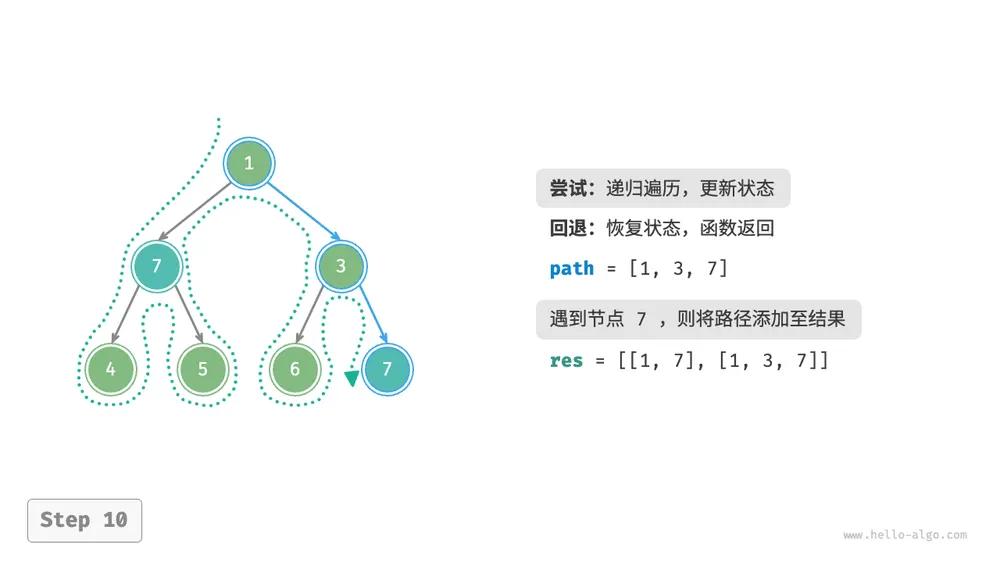
第 11 步
剪枝
复杂的回溯问题通常包含一个或多个约束条件,约束条件通常可用于“剪枝”。
例题三
在二叉树中搜索所有值为 的节点,请返回根节点到这些节点的路径,并要求路径中不包含值为 的节点。
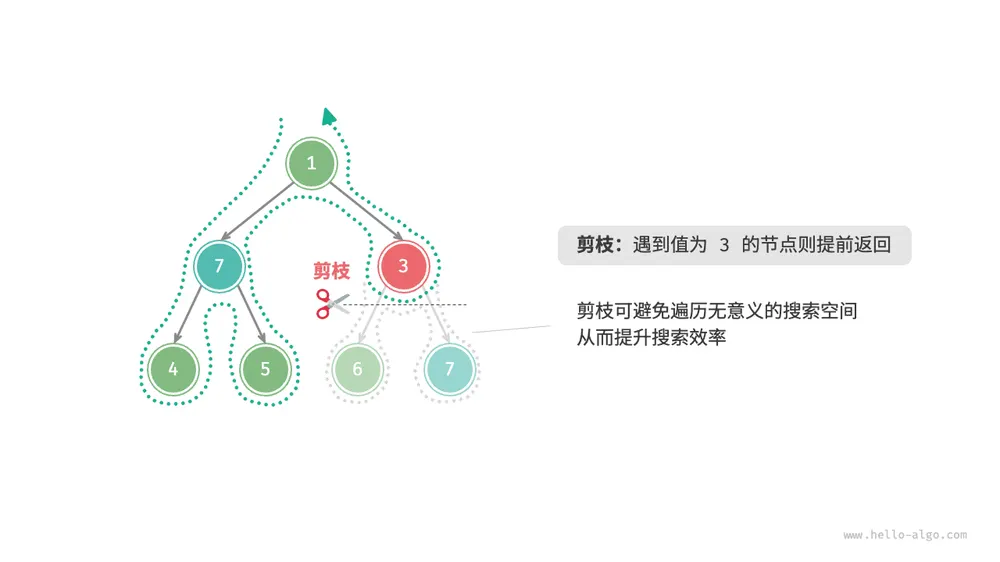
为了满足以上约束条件,我们需要添加剪枝操作:在搜索过程中,若遇到值为 的节点,则提前返回,不再继续搜索。代码如下所示:
/* 前序遍历:例题三 */
static void preOrder(TreeNode root) {
    // 剪枝
    if (root == null || root.val == 3) {
        return;
    }
    // 尝试
    path.add(root);
    if (root.val == 7) {
        // 记录解
        res.add(new ArrayList<>(path));
    }
    preOrder(root.left);
    preOrder(root.right);
    // 回退
    path.remove(path.size() - 1);
}“剪枝”是一个非常形象的名词。如下图所示,在搜索过程中,我们“剪掉”了不满足约束条件的搜索分支,避免许多无意义的尝试,从而提高了搜索效率。
框架代码
接下来,我们尝试将回溯的“尝试、回退、剪枝”的主体框架提炼出来,提升代码的通用性。
在以下框架代码中,state 表示问题的当前状态,choices 表示当前状态下可以做出的选择:
/* 回溯算法框架 */
void backtrack(State state, List<Choice> choices, List<State> res) {
    // 判断是否为解
    if (isSolution(state)) {
        // 记录解
        recordSolution(state, res);
        // 不再继续搜索
        return;
    }
    // 遍历所有选择
    for (Choice choice : choices) {
        // 剪枝:判断选择是否合法
        if (isValid(state, choice)) {
            // 尝试:做出选择,更新状态
            makeChoice(state, choice);
            backtrack(state, choices, res);
            // 回退:撤销选择,恢复到之前的状态
            undoChoice(state, choice);
        }
    }
}
接下来,我们基于框架代码来解决例题三。状态 state 为节点遍历路径,选择 choices 为当前节点的左子节点和右子节点,结果 res 是路径列表:
/* 回溯算法:例题三 */
static void backtrack(List<TreeNode> state, List<TreeNode> choices, List<List<TreeNode>> res) {
    // 检查是否为解
    if (isSolution(state)) {
        // 记录解
        recordSolution(state, res);
    }
    // 遍历所有选择
    for (TreeNode choice : choices) {
        // 剪枝:检查选择是否合法
        if (isValid(state, choice)) {
            // 尝试:做出选择,更新状态
            makeChoice(state, choice);
            // 进行下一轮选择
            backtrack(state, Arrays.asList(choice.left, choice.right), res);
            // 回退:撤销选择,恢复到之前的状态
            undoChoice(state, choice);
        }
    }
}
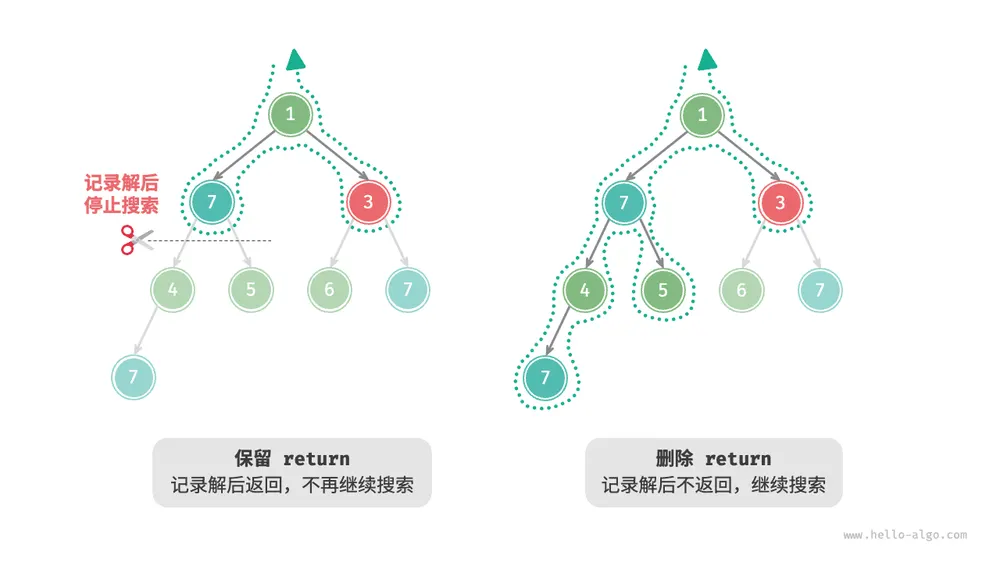
根据题意,我们在找到值为 的节点后应该继续搜索,因此需要将记录解之后的 return 语句删除。下图对比了保留或删除 return 语句的搜索过程。
相比基于前序遍历的代码实现,基于回溯算法框架的代码实现虽然显得啰唆,但通用性更好。实际上,许多回溯问题可以在该框架下解决。我们只需根据具体问题来定义 state 和 choices ,并实现框架中的各个方法即可。
常用术语
为了更清晰地分析算法问题,我们总结一下回溯算法中常用术语的含义,并对照例题三给出对应示例,如下表所示。
表
| 名词 | 定义 | 例题三 |
|---|---|---|
| 解(solution) | 解是满足问题特定条件的答案,可能有一个或多个 | 根节点到节点 的满足约束条件的所有路径 |
| 约束条件(constraint) | 约束条件是问题中限制解的可行性的条件,通常用于剪枝 | 路径中不包含节点 |
| 状态(state) | 状态表示问题在某一时刻的情况,包括已经做出的选择 | 当前已访问的节点路径,即 path 节点列表 |
| 尝试(attempt) | 尝试是根据可用选择来探索解空间的过程,包括做出选择,更新状态,检查是否为解 | 递归访问左(右)子节点,将节点添加进 path ,判断节点的值是否为 |
| 回退(backtracking) | 回退指遇到不满足约束条件的状态时,撤销前面做出的选择,回到上一个状态 | 当越过叶节点、结束节点访问、遇到值为 的节点时终止搜索,函数返回 |
| 剪枝(pruning) | 剪枝是根据问题特性和约束条件避免无意义的搜索路径的方法,可提高搜索效率 | 当遇到值为 的节点时,则不再继续搜索 |
提示
问题、解、状态等概念是通用的,在分治、回溯、动态规划、贪心等算法中都有涉及。
优点与局限性
回溯算法本质上是一种深度优先搜索算法,它尝试所有可能的解决方案直到找到满足条件的解。这种方法的优点在于能够找到所有可能的解决方案,而且在合理的剪枝操作下,具有很高的效率。
然而,在处理大规模或者复杂问题时,回溯算法的运行效率可能难以接受。
- 时间:回溯算法通常需要遍历状态空间的所有可能,时间复杂度可以达到指数阶或阶乘阶。
- 空间:在递归调用中需要保存当前的状态(例如路径、用于剪枝的辅助变量等),当深度很大时,空间需求可能会变得很大。
即便如此,回溯算法仍然是某些搜索问题和约束满足问题的最佳解决方案。对于这些问题,由于无法预测哪些选择可生成有效的解,因此我们必须对所有可能的选择进行遍历。在这种情况下,关键是如何优化效率,常见的效率优化方法有两种。
- 剪枝:避免搜索那些肯定不会产生解的路径,从而节省时间和空间。
- 启发式搜索:在搜索过程中引入一些策略或者估计值,从而优先搜索最有可能产生有效解的路径。
回溯典型例题
回溯算法可用于解决许多搜索问题、约束满足问题和组合优化问题。
搜索问题:这类问题的目标是找到满足特定条件的解决方案。
- 全排列问题:给定一个集合,求出其所有可能的排列组合。
- 子集和问题:给定一个集合和一个目标和,找到集合中所有和为目标和的子集。
- 汉诺塔问题:给定三根柱子和一系列大小不同的圆盘,要求将所有圆盘从一根柱子移动到另一根柱子,每次只能移动一个圆盘,且不能将大圆盘放在小圆盘上。
约束满足问题:这类问题的目标是找到满足所有约束条件的解。
- 皇后:在 的棋盘上放置 个皇后,使得它们互不攻击。
- 数独:在 的网格中填入数字 ~ ,使得每行、每列和每个 子网格中的数字不重复。
- 图着色问题:给定一个无向图,用最少的颜色给图的每个顶点着色,使得相邻顶点颜色不同。
组合优化问题:这类问题的目标是在一个组合空间中找到满足某些条件的最优解。
- 0-1 背包问题:给定一组物品和一个背包,每个物品有一定的价值和重量,要求在背包容量限制内,选择物品使得总价值最大。
- 旅行商问题:在一个图中,从一个点出发,访问所有其他点恰好一次后返回起点,求最短路径。
- 最大团问题:给定一个无向图,找到最大的完全子图,即子图中的任意两个顶点之间都有边相连。
请注意,对于许多组合优化问题,回溯不是最优解决方案。
- 0-1 背包问题通常使用动态规划解决,以达到更高的时间效率。
- 旅行商是一个著名的 NP-Hard 问题,常用解法有遗传算法和蚁群算法等。
- 最大团问题是图论中的一个经典问题,可用贪心算法等启发式算法来解决。
全排列问题
全排列问题是回溯算法的一个典型应用。它的定义是在给定一个集合(如一个数组或字符串)的情况下,找出其中元素的所有可能的排列。
下表列举了几个示例数据,包括输入数组和对应的所有排列。
表
| 输入数组 | 所有排列 |
|---|---|
无相等元素的情况
提问
输入一个整数数组,其中不包含重复元素,返回所有可能的排列。
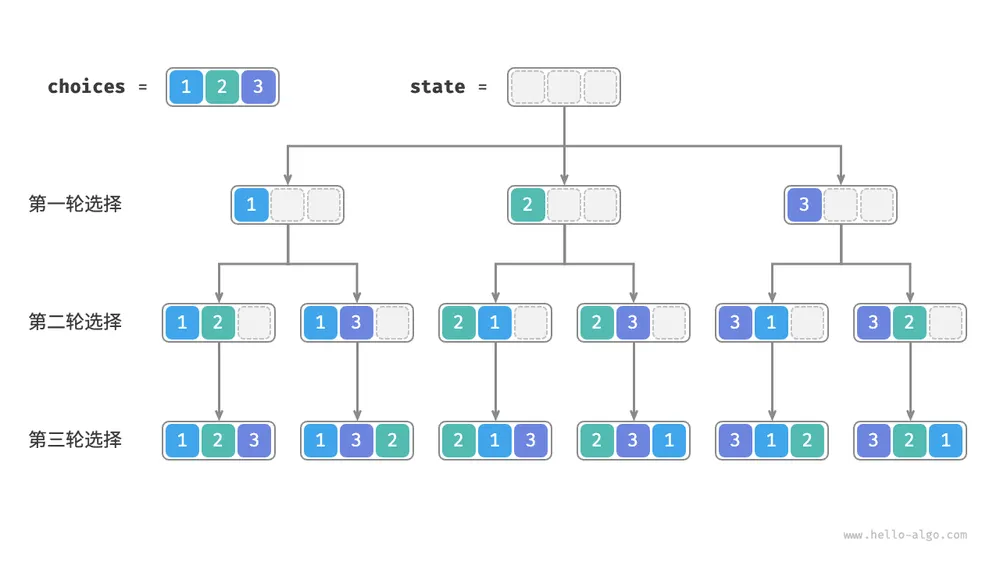
从回溯算法的角度看,我们可以把生成排列的过程想象成一系列选择的结果。假设输入数组为 ,如果我们先选择 ,再选择 ,最后选择 ,则获得排列 。回退表示撤销一个选择,之后继续尝试其他选择。
从回溯代码的角度看,候选集合 choices 是输入数组中的所有元素,状态 state 是直至目前已被选择的元素。请注意,每个元素只允许被选择一次,因此 state 中的所有元素都应该是唯一的。
如下图所示,我们可以将搜索过程展开成一棵递归树,树中的每个节点代表当前状态 state 。从根节点开始,经过三轮选择后到达叶节点,每个叶节点都对应一个排列。
重复选择剪枝
为了实现每个元素只被选择一次,我们考虑引入一个布尔型数组 selected ,其中 selected[i] 表示 choices[i] 是否已被选择,并基于它实现以下剪枝操作。
- 在做出选择
choices[i]后,我们就将selected[i]赋值为 ,代表它已被选择。 - 遍历选择列表
choices时,跳过所有已被选择的节点,即剪枝。
如下图所示,假设我们第一轮选择 1 ,第二轮选择 3 ,第三轮选择 2 ,则需要在第二轮剪掉元素 1 的分支,在第三轮剪掉元素 1 和元素 3 的分支。
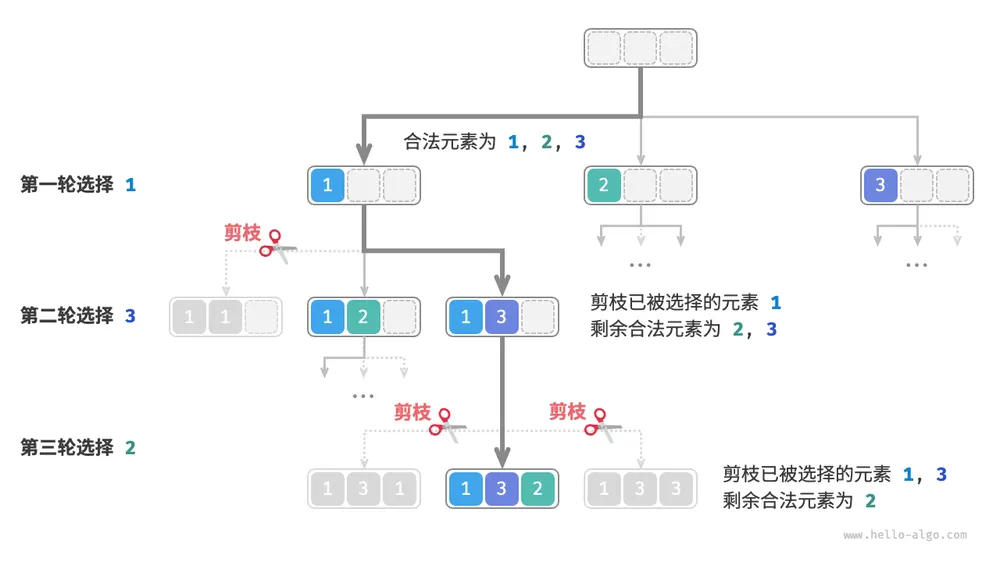
观察上图发现,该剪枝操作将搜索空间大小从 减小至 。
代码实现
想清楚以上信息之后,我们就可以在框架代码中做“完形填空”了。为了缩短整体代码,我们不单独实现框架代码中的各个函数,而是将它们展开在 backtrack() 函数中:
/* 全排列 I */
static List<List<Integer>> permutationsI(int[] nums) {
    List<List<Integer>> res = new ArrayList<List<Integer>>();
    backtrack(new ArrayList<Integer>(), nums, new boolean[nums.length], res);
    return res;
}
考虑相等元素的情况
提问
输入一个整数数组,数组中可能包含重复元素,返回所有不重复的排列。
假设输入数组为 。为了方便区分两个重复元素 ,我们将第二个 记为 。
如下图所示,上述方法生成的排列有一半是重复的。
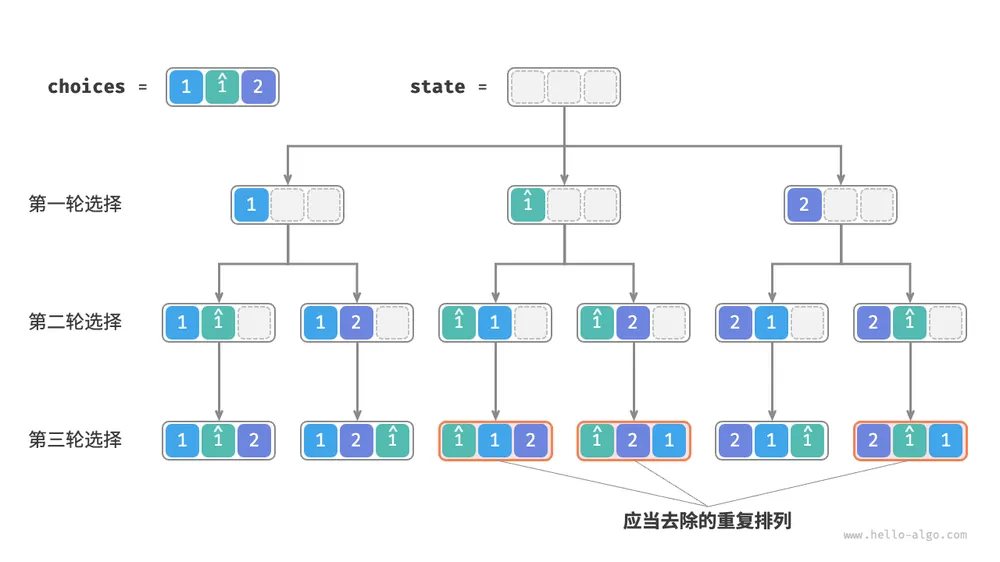
那么如何去除重复的排列呢?最直接地,考虑借助一个哈希集合,直接对排列结果进行去重。然而这样做不够优雅,因为生成重复排列的搜索分支没有必要,应当提前识别并剪枝,这样可以进一步提升算法效率。
相等元素剪枝
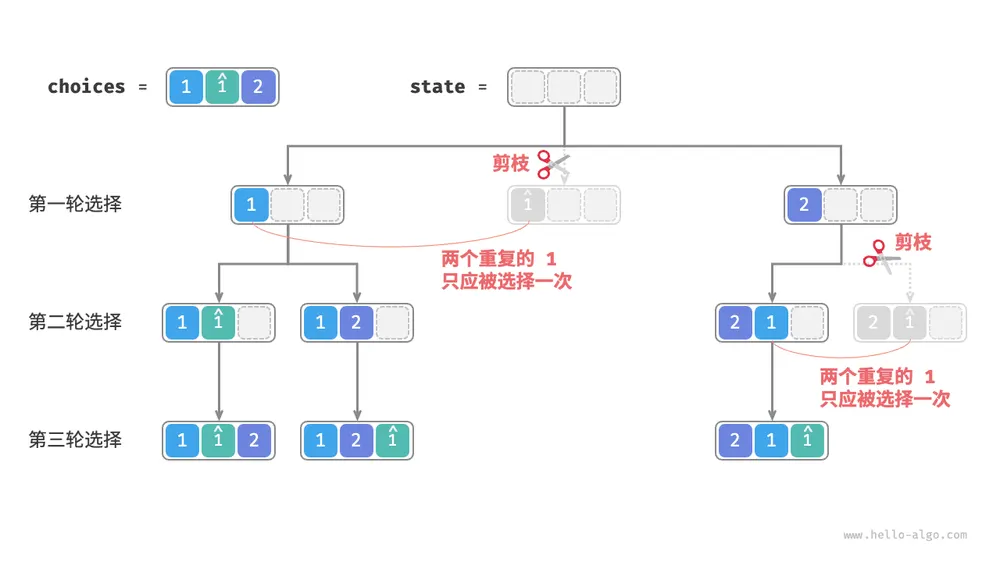
观察下图,在第一轮中,选择 或选择 是等价的,在这两个选择之下生成的所有排列都是重复的。因此应该把 剪枝。
同理,在第一轮选择 之后,第二轮选择中的 和 也会产生重复分支,因此也应将第二轮的 剪枝。
从本质上看,我们的目标是在某一轮选择中,保证多个相等的元素仅被选择一次。
代码实现
在上一题的代码的基础上,我们考虑在每一轮选择中开启一个哈希集合 duplicated ,用于记录该轮中已经尝试过的元素,并将重复元素剪枝:
/* 全排列 II */
static List<List<Integer>> permutationsII(int[] nums) {
    List<List<Integer>> res = new ArrayList<List<Integer>>();
    backtrack(new ArrayList<Integer>(), nums, new boolean[nums.length], res);
    return res;
}
假设元素两两之间互不相同,则 个元素共有 种排列(阶乘);在记录结果时,需要复制长度为 的列表,使用 时间。因此时间复杂度为 。
最大递归深度为 ,使用 栈帧空间。selected 使用 空间。同一时刻最多共有 个 duplicated ,使用 空间。因此空间复杂度为 。
两种剪枝对比
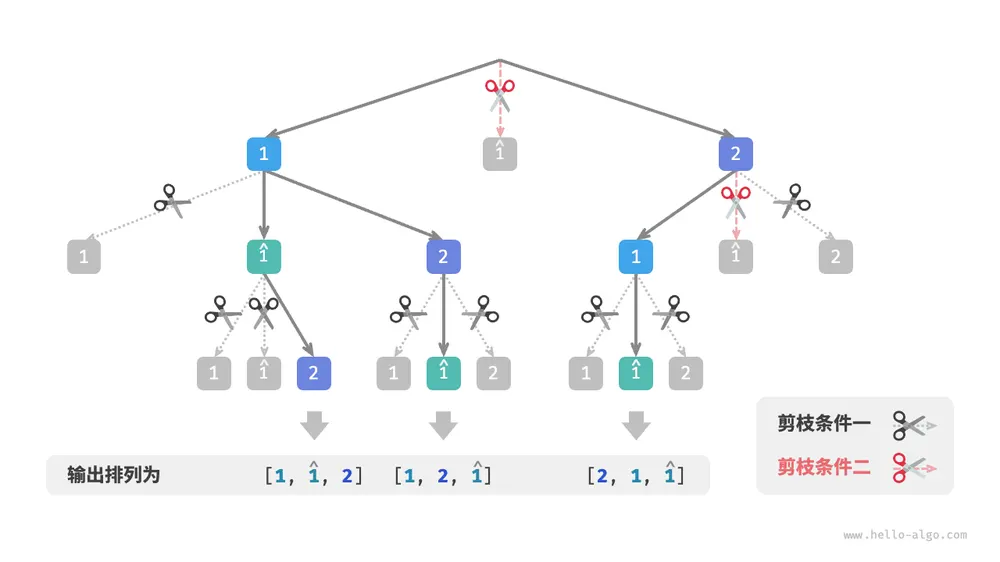
请注意,虽然 selected 和 duplicated 都用于剪枝,但两者的目标不同。
- 重复选择剪枝:整个搜索过程中只有一个
selected。它记录的是当前状态中包含哪些元素,其作用是避免某个元素在state中重复出现。 - 相等元素剪枝:每轮选择(每个调用的
backtrack函数)都包含一个duplicated。它记录的是在本轮遍历(for循环)中哪些元素已被选择过,其作用是保证相等元素只被选择一次。
下图展示了两个剪枝条件的生效范围。注意,树中的每个节点代表一个选择,从根节点到叶节点的路径上的各个节点构成一个排列。
子集和问题
无重复元素的情况
提问
给定一个正整数数组
nums和一个目标正整数target,请找出所有可能的组合,使得组合中的元素和等于target。给定数组无重复元素,每个元素可以被选取多次。请以列表形式返回这些组合,列表中不应包含重复组合。
例如,输入集合 和目标整数 ,解为 。需要注意以下两点。
- 输入集合中的元素可以被无限次重复选取。
- 子集不区分元素顺序,比如 和 是同一个子集。
参考全排列解法
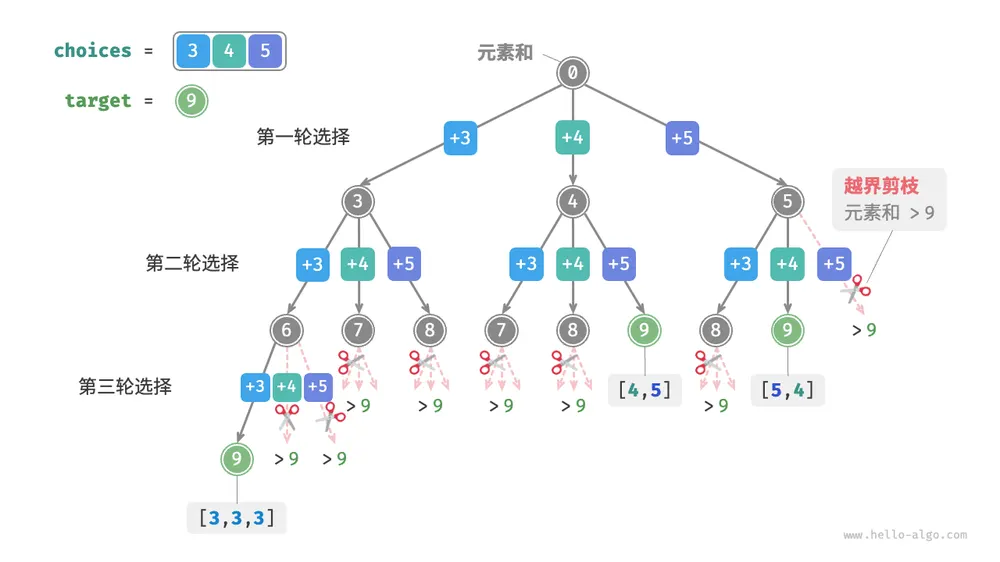
类似于全排列问题,我们可以把子集的生成过程想象成一系列选择的结果,并在选择过程中实时更新“元素和”,当元素和等于 target 时,就将子集记录至结果列表。
而与全排列问题不同的是,本题集合中的元素可以被无限次选取,因此无须借助 selected 布尔列表来记录元素是否已被选择。我们可以对全排列代码进行小幅修改,初步得到解题代码:
/* 求解子集和 I(包含重复子集) */
static List<List<Integer>> subsetSumINaive(int[] nums, int target) {
    List<Integer> state = new ArrayList<>(); // 状态(子集)
    int total = 0; // 子集和
    List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表)
    backtrack(state, target, total, nums, res);
    return res;
}
向以上代码输入数组 和目标元素 ,输出结果为 。虽然成功找出了所有和为 的子集,但其中存在重复的子集 和 。
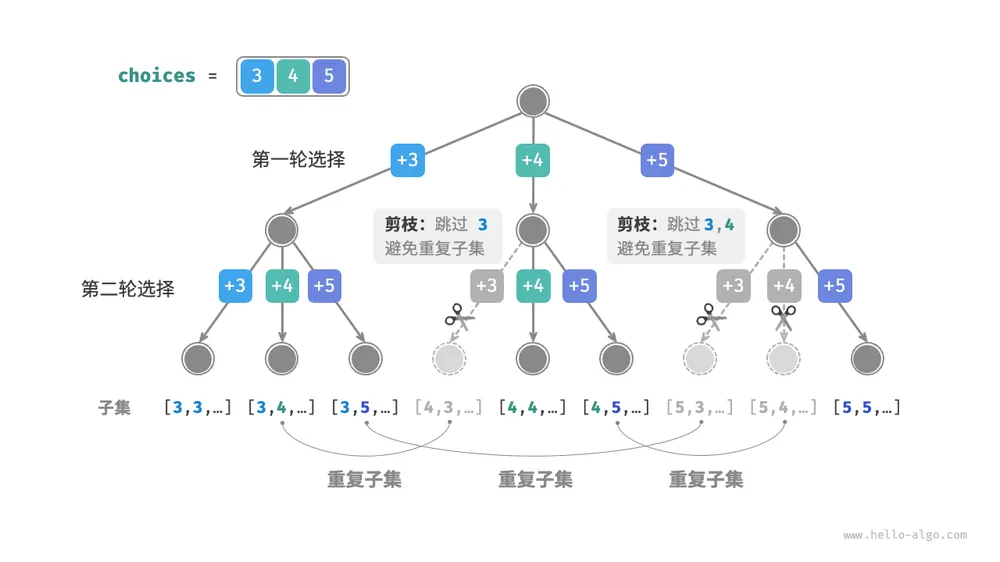
这是因为搜索过程是区分选择顺序的,然而子集不区分选择顺序。如下图所示,先选 后选 与先选 后选 是不同的分支,但对应同一个子集。
为了去除重复子集,一种直接的思路是对结果列表进行去重。但这个方法效率很低,有两方面原因。
- 当数组元素较多,尤其是当
target较大时,搜索过程会产生大量的重复子集。 - 比较子集(数组)的异同非常耗时,需要先排序数组,再比较数组中每个元素的异同。
重复子集剪枝
我们考虑在搜索过程中通过剪枝进行去重。观察下图,重复子集是在以不同顺序选择数组元素时产生的,例如以下情况。
- 当第一轮和第二轮分别选择 和 时,会生成包含这两个元素的所有子集,记为 。
- 之后,当第一轮选择 时,则第二轮应该跳过 ,因为该选择产生的子集 和第
1.步中生成的子集完全重复。
在搜索过程中,每一层的选择都是从左到右被逐个尝试的,因此越靠右的分支被剪掉的越多。
- 前两轮选择 和 ,生成子集 。
- 前两轮选择 和 ,生成子集 。
- 若第一轮选择 ,则第二轮应该跳过 和 ,因为子集 和 与第
1.步和第2.步中描述的子集完全重复。
总结来看,给定输入数组 ,设搜索过程中的选择序列为 ,则该选择序列需要满足 ,不满足该条件的选择序列都会造成重复,应当剪枝。
代码实现
为实现该剪枝,我们初始化变量 start ,用于指示遍历起始点。当做出选择 后,设定下一轮从索引 开始遍历。这样做就可以让选择序列满足 ,从而保证子集唯一。
除此之外,我们还对代码进行了以下两项优化。
- 在开启搜索前,先将数组
nums排序。在遍历所有选择时,当子集和超过target时直接结束循环,因为后边的元素更大,其子集和一定超过target。 - 省去元素和变量
total,通过在target上执行减法来统计元素和,当target等于 时记录解。
/* 求解子集和 I */
static List<List<Integer>> subsetSumI(int[] nums, int target) {
    List<Integer> state = new ArrayList<>(); // 状态(子集)
    Arrays.sort(nums); // 对 nums 进行排序
    int start = 0; // 遍历起始点
    List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表)
    backtrack(state, target, nums, start, res);
    return res;
}
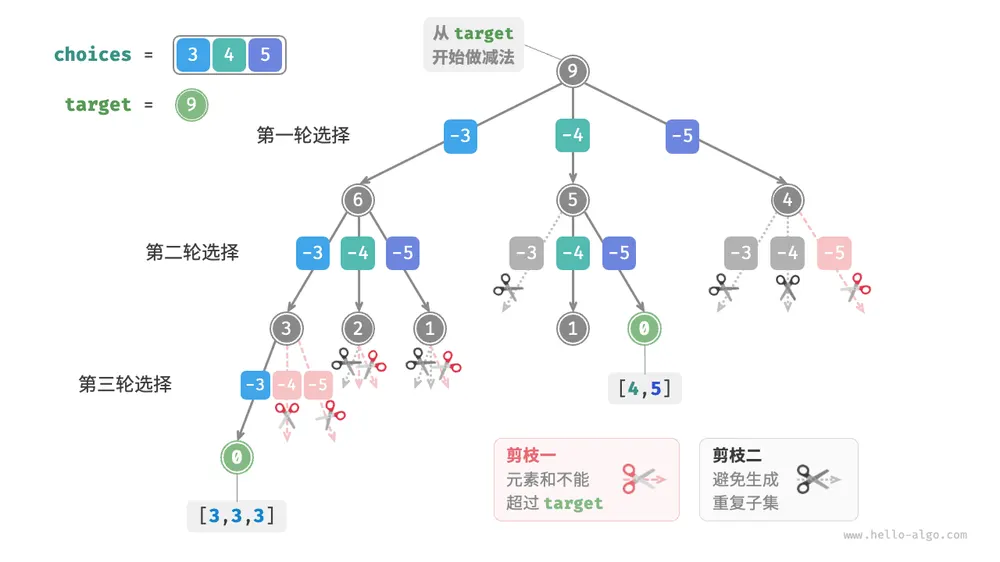
下图所示为将数组 和目标元素 输入以上代码后的整体回溯过程。
考虑重复元素的情况
提问
给定一个正整数数组
nums和一个目标正整数target,请找出所有可能的组合,使得组合中的元素和等于target。给定数组可能包含重复元素,每个元素只可被选择一次。请以列表形式返回这些组合,列表中不应包含重复组合。
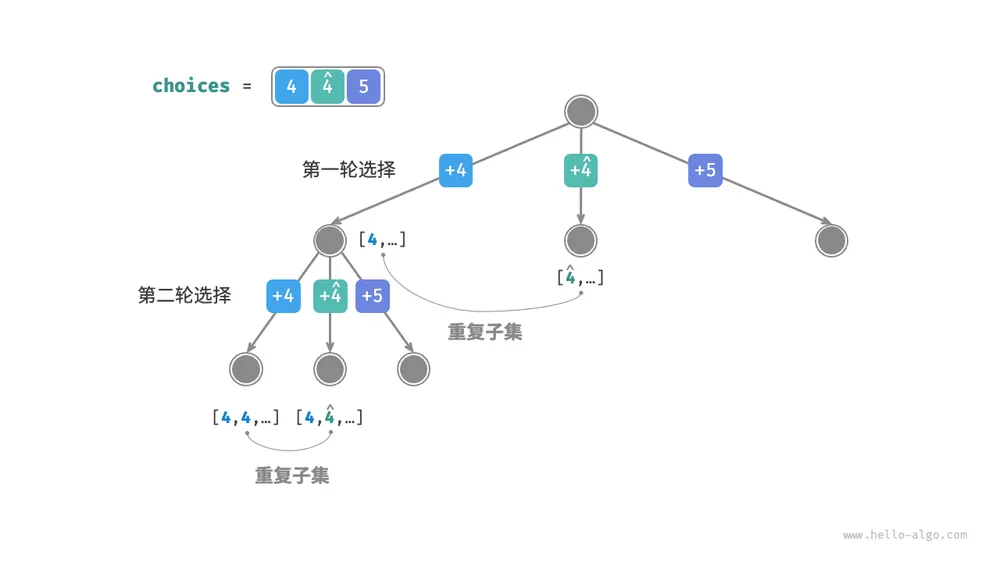
相比于上题,本题的输入数组可能包含重复元素,这引入了新的问题。例如,给定数组 和目标元素 ,则现有代码的输出结果为 ,出现了重复子集。
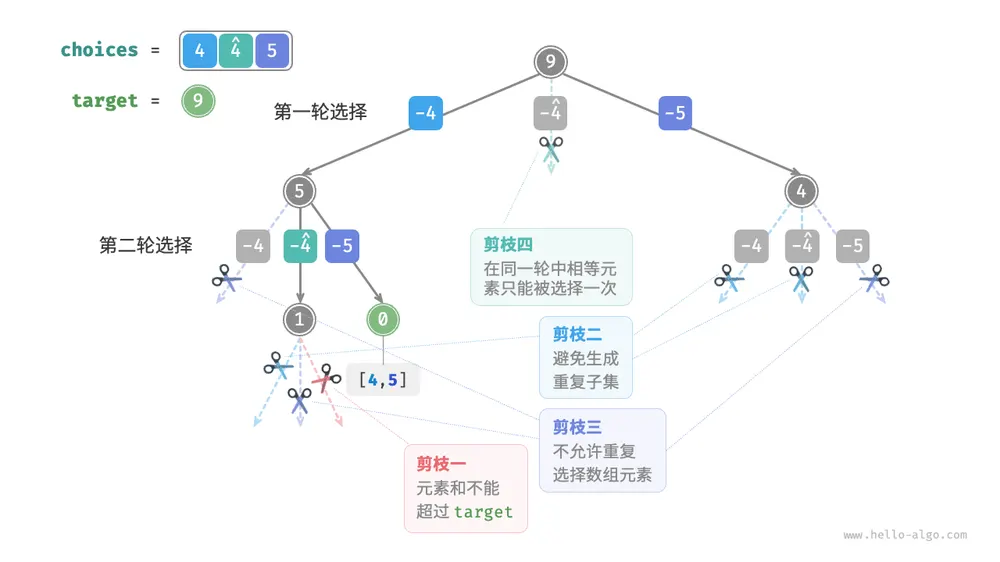
造成这种重复的原因是相等元素在某轮中被多次选择。在下图中,第一轮共有三个选择,其中两个都为 ,会产生两个重复的搜索分支,从而输出重复子集;同理,第二轮的两个 也会产生重复子集。
相等元素剪枝
为解决此问题,我们需要限制相等元素在每一轮中只能被选择一次。实现方式比较巧妙:由于数组是已排序的,因此相等元素都是相邻的。这意味着在某轮选择中,若当前元素与其左边元素相等,则说明它已经被选择过,因此直接跳过当前元素。
与此同时,本题规定每个数组元素只能被选择一次。幸运的是,我们也可以利用变量 start 来满足该约束:当做出选择 后,设定下一轮从索引 开始向后遍历。这样既能去除重复子集,也能避免重复选择元素。
代码实现
/* 求解子集和 II */
static List<List<Integer>> subsetSumII(int[] nums, int target) {
    List<Integer> state = new ArrayList<>(); // 状态(子集)
    Arrays.sort(nums); // 对 nums 进行排序
    int start = 0; // 遍历起始点
    List<List<Integer>> res = new ArrayList<>(); // 结果列表(子集列表)
    backtrack(state, target, nums, start, res);
    return res;
}
下图展示了数组 和目标元素 的回溯过程,共包含四种剪枝操作。请你将图示与代码注释相结合,理解整个搜索过程,以及每种剪枝操作是如何工作的。
n 皇后问题
提问
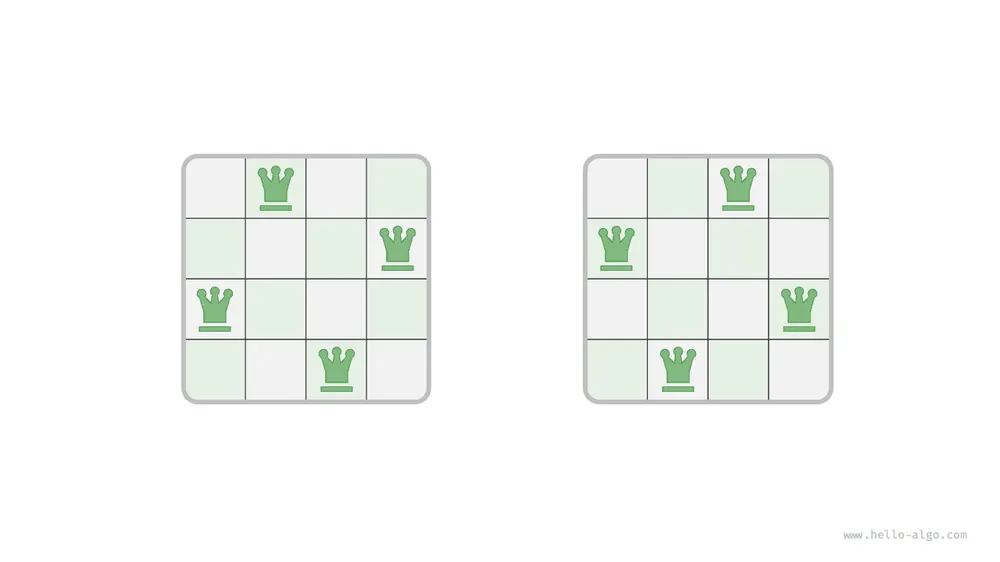
根据国际象棋的规则,皇后可以攻击与同处一行、一列或一条斜线上的棋子。给定 个皇后和一个 大小的棋盘,寻找使得所有皇后之间无法相互攻击的摆放方案。
如下图所示,当 时,共可以找到两个解。从回溯算法的角度看, 大小的棋盘共有 个格子,给出了所有的选择 choices 。在逐个放置皇后的过程中,棋盘状态在不断地变化,每个时刻的棋盘就是状态 state 。
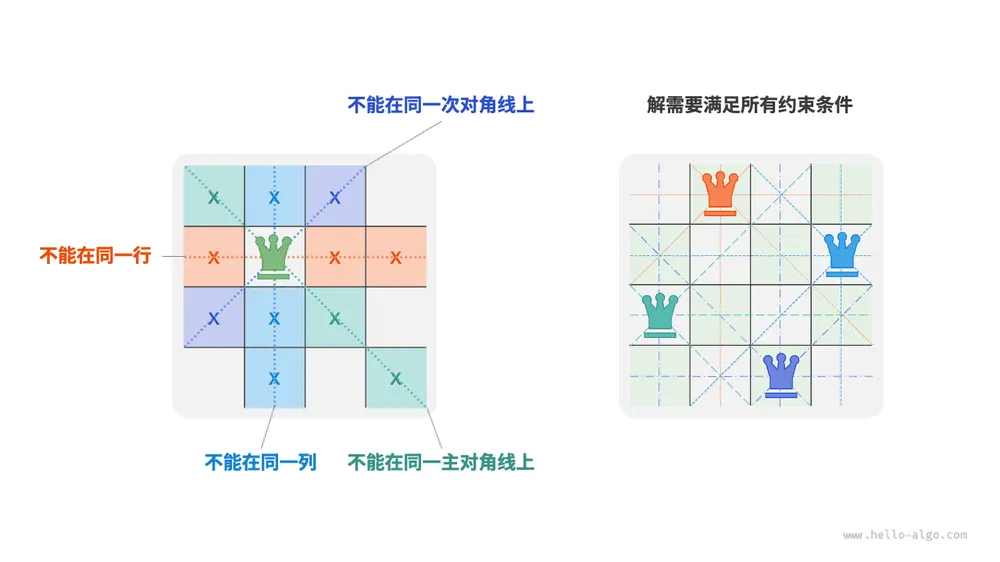
下图展示了本题的三个约束条件:多个皇后不能在同一行、同一列、同一条对角线上。值得注意的是,对角线分为主对角线 \ 和次对角线 / 两种。
逐行放置策略
皇后的数量和棋盘的行数都为 ,因此我们容易得到一个推论:棋盘每行都允许且只允许放置一个皇后。
也就是说,我们可以采取逐行放置策略:从第一行开始,在每行放置一个皇后,直至最后一行结束。
下图所示为 4 皇后问题的逐行放置过程。受画幅限制,下图仅展开了第一行的其中一个搜索分支,并且将不满足列约束和对角线约束的方案都进行了剪枝。
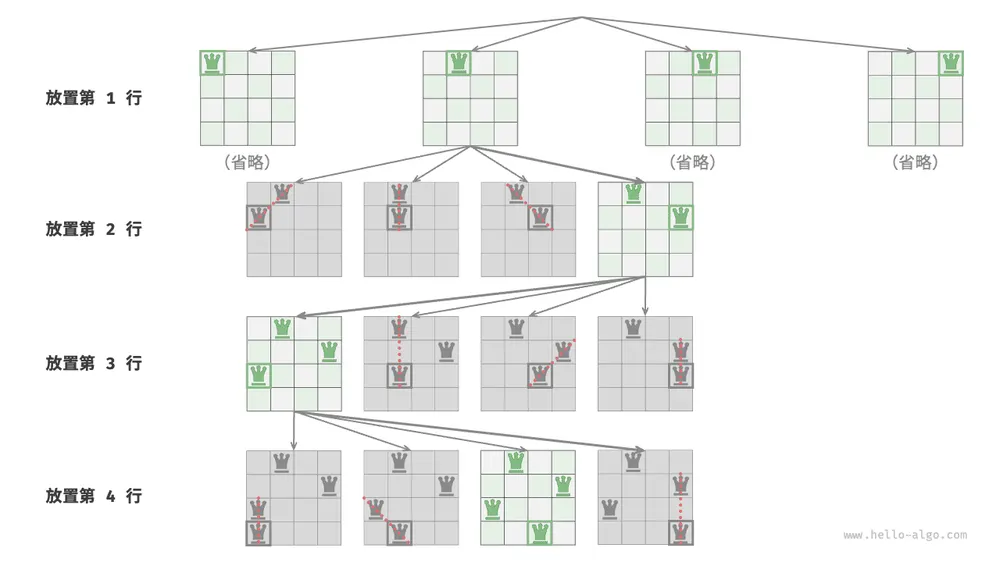
从本质上看,逐行放置策略起到了剪枝的作用,它避免了同一行出现多个皇后的所有搜索分支。
列与对角线剪枝
为了满足列约束,我们可以利用一个长度为 的布尔型数组 cols 记录每一列是否有皇后。在每次决定放置前,我们通过 cols 将已有皇后的列进行剪枝,并在回溯中动态更新 cols 的状态。
提示
请注意,矩阵的起点位于左上角,其中行索引从上到下增加,列索引从左到右增加。
那么,如何处理对角线约束呢?设棋盘中某个格子的行列索引为 ,选定矩阵中的某条主对角线,我们发现该对角线上所有格子的行索引减列索引都相等,即主对角线上所有格子的 为恒定值。
也就是说,如果两个格子满足 ,则它们一定处在同一条主对角线上。利用该规律,我们可以借助下图所示的数组 diags1 记录每条主对角线上是否有皇后。
同理,次对角线上的所有格子的 是恒定值。我们同样也可以借助数组 diags2 来处理次对角线约束。
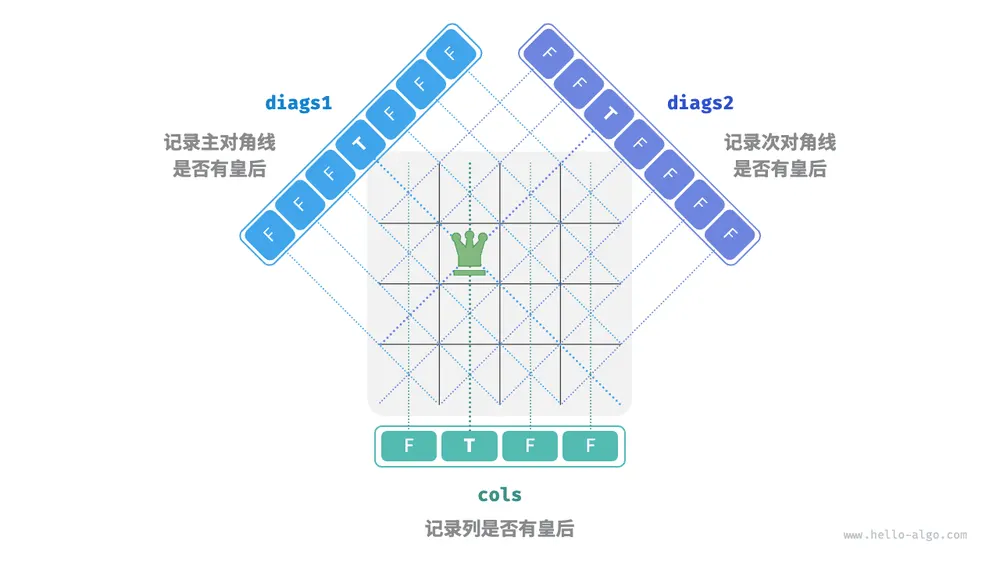
代码实现
请注意, 维方阵中 的范围是 , 的范围是 ,所以主对角线和次对角线的数量都为 ,即数组 diags1 和 diags2 的长度都为 。
/* 求解 n 皇后 */
public static List<List<List<String>>> nQueens(int n) {
    // 初始化 n*n 大小的棋盘,其中 'Q' 代表皇后,'#' 代表空位
    List<List<String>> state = new ArrayList<>();
    for (int i = 0; i < n; i++) {
        List<String> row = new ArrayList<>();
        for (int j = 0; j < n; j++) {
            row.add("#");
        }
        state.add(row);
    }
    boolean[] cols = new boolean[n]; // 记录列是否有皇后
    boolean[] diags1 = new boolean[2 * n - 1]; // 记录主对角线上是否有皇后
    boolean[] diags2 = new boolean[2 * n - 1]; // 记录次对角线上是否有皇后
    List<List<List<String>>> res = new ArrayList<>();

    backtrack(0, n, state, res, cols, diags1, diags2);

    return res;
}
逐行放置 次,考虑列约束,则从第一行到最后一行分别有 、、、、 个选择,使用 时间。当记录解时,需要复制矩阵 state 并添加进 res ,复制操作使用 时间。因此,总体时间复杂度为 。实际上,根据对角线约束的剪枝也能够大幅缩小搜索空间,因而搜索效率往往优于以上时间复杂度。
数组 state 使用 空间,数组 cols、diags1 和 diags2 皆使用 空间。最大递归深度为 ,使用 栈帧空间。因此,空间复杂度为 。
小结
重点回顾
- 回溯算法本质是穷举法,通过对解空间进行深度优先遍历来寻找符合条件的解。在搜索过程中,遇到满足条件的解则记录,直至找到所有解或遍历完成后结束。
- 回溯算法的搜索过程包括尝试与回退两个部分。它通过深度优先搜索来尝试各种选择,当遇到不满足约束条件的情况时,则撤销上一步的选择,退回到之前的状态,并继续尝试其他选择。尝试与回退是两个方向相反的操作。
- 回溯问题通常包含多个约束条件,它们可用于实现剪枝操作。剪枝可以提前结束不必要的搜索分支,大幅提升搜索效率。
- 回溯算法主要可用于解决搜索问题和约束满足问题。组合优化问题虽然可以用回溯算法解决,但往往存在效率更高或效果更好的解法。
- 全排列问题旨在搜索给定集合元素的所有可能的排列。我们借助一个数组来记录每个元素是否被选择,剪掉重复选择同一元素的搜索分支,确保每个元素只被选择一次。
- 在全排列问题中,如果集合中存在重复元素,则最终结果会出现重复排列。我们需要约束相等元素在每轮中只能被选择一次,这通常借助一个哈希集合来实现。
- 子集和问题的目标是在给定集合中找到和为目标值的所有子集。集合不区分元素顺序,而搜索过程会输出所有顺序的结果,产生重复子集。我们在回溯前将数据进行排序,并设置一个变量来指示每一轮的遍历起始点,从而将生成重复子集的搜索分支进行剪枝。
- 对于子集和问题,数组中的相等元素会产生重复集合。我们利用数组已排序的前置条件,通过判断相邻元素是否相等实现剪枝,从而确保相等元素在每轮中只能被选中一次。
- 皇后问题旨在寻找将 个皇后放置到 尺寸棋盘上的方案,要求所有皇后两两之间无法攻击对方。该问题的约束条件有行约束、列约束、主对角线和次对角线约束。为满足行约束,我们采用按行放置的策略,保证每一行放置一个皇后。
- 列约束和对角线约束的处理方式类似。对于列约束,我们利用一个数组来记录每一列是否有皇后,从而指示选中的格子是否合法。对于对角线约束,我们借助两个数组来分别记录该主、次对角线上是否存在皇后;难点在于找出处在同一主(副)对角线上的格子所满足的行列索引规律。
Q & A
Q:怎么理解回溯和递归的关系?
总的来看,回溯是一种“算法策略”,而递归更像是一个“工具”。
- 回溯算法通常基于递归实现。然而,回溯是递归的应用场景之一,是递归在搜索问题中的应用。
- 递归的结构体现了“子问题分解”的解题范式,常用于解决分治、回溯、动态规划(记忆化递归)等问题。
练习
知识巩固
这段排列算法会漏掉结果吗
一个回溯算法按 1、2、3 的顺序尝试生成全部排列。每次选择数字 x 时,它会:
- 把
x加到当前路径末尾; - 把
x标记为“已使用”; - 递归填写下一个位置。
递归返回后,同学只从路径末尾删除了 x,然后继续尝试下一个数字。
- 算法首先得到哪个排列?它还能得到全部 6 个排列吗?
- 递归返回上一层前,只删除路径末尾的数字是否足够?如果不够,还需要做什么?说明理由。
参考答案
它首先得到
[1, 2, 3],但无法得到全部排列。虽然返回时路径变短了,
数字 1、2、3 的标记仍都是“已使用”,后续分支便没有可选数字。不够。删除路径末尾的
x后,还必须把x重新标记为“未使用”。
当前路径和已使用标记共同描述搜索状态;选择时修改了两处,回退时也必须把两处都恢复,
其他分支才能再次选择x。
数字的选择顺序重要吗
给定排好序的数组 [2, 3, 5] 和目标值 5,每个数可以重复选择。
算法规定每条搜索路径中的数字只能按从小到大的顺序出现。
- 能得到哪些不同的组合?
- 为什么同一组数字不需要按不同顺序重复搜索?“从小到大”的限制起到了什么作用?
- 当前路径为
[3]、还差 2 时,下一个候选数是 3。为什么此时可以停止检查这一层后面的所有候选数?
参考答案
不同的组合为
[2, 3]和[5]。本题把
[2, 3]和[3, 2]看作同一种组合,数字的选择顺序不计入答案。
规定路径中的数字从小到大出现,就能在搜索时直接跳过[3, 2]这类重复组合。当前还差 2,而候选数 3 已经大于 2。因为数组已经排好序,
3 后面的候选数只会更大,也都不可能加入当前组合,所以可以直接结束这一层的检查。
下一枚皇后可以放在哪些位置
在一个 4 × 4 棋盘上按行放置皇后,行、列下标都从 0 开始。
目前已经在 (0, 1) 和 (1, 3) 放置了皇后,现在要在第 2 行放置下一个皇后。
- 哪些列会因为“同列”而被排除?
- 在剩余列中,哪些位置会因为“同一条对角线”而被排除?
- 第 2 行还剩哪些位置可以尝试?
参考答案
第 1 列和第 3 列已经有皇后,因此位置
(2, 1)和(2, 3)被排除。在剩余位置中,
(2, 2)与(1, 3)位于同一条对角线上,因此也被排除。
位置(2, 0)与已有两个皇后都不在同列或同一条对角线上。第 2 行可以尝试的位置只有
(2, 0)。这一步只说明当前放置合法;之后若无法完成棋盘,仍需回退并尝试更早的其他选择。
编程练习
无重复元素的全排列
整数数组 nums 至少包含一个元素,并且其中各元素互不相同。
请列出把这些元素各使用一次所能形成的全部顺序,并将每一种顺序作为一个数组返回。
结果中各排列的先后次序不作要求。
请使用回溯,并用布尔数组记录每个位置的元素是否已经选入当前排列。
解题提示
- 递归深度表示正在填写排列中的第几个位置
- 每一层只尝试尚未使用的元素
- 路径长度达到
nums的长度时,把它的副本加入答案
LeetCode{ .rounded-button .exercise-button target="_blank" rel="noopener noreferrer" } 题目解析{ .rounded-button .exercise-button target="_blank" rel="noopener noreferrer" }
说明: 链接题解通过交换数组元素,把已选元素依次放到数组前部;本练习使用布尔数组记录每个元素是否已选。两种方法都能避免同一元素被重复选择,但代码结构不同