10 / 20
第 8 章 堆
摘要
堆就像是山岳峰峦,层叠起伏、形态各异。
座座山峰高低错落,而最高的山峰总是最先映入眼帘。
堆
堆(heap)是一种满足特定条件的完全二叉树,主要可分为两种类型,如下图所示。
- 小顶堆(min heap):任意节点的值 其子节点的值。
- 大顶堆(max heap):任意节点的值 其子节点的值。
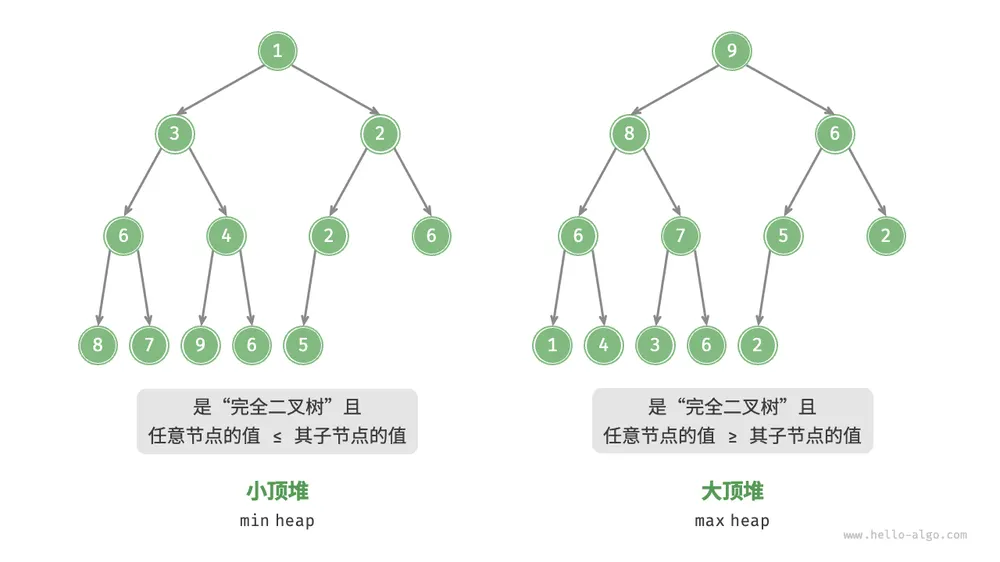
堆作为完全二叉树的一个特例,具有以下特性。
- 最底层节点靠左填充,其他层的节点都被填满。
- 我们将二叉树的根节点称为“堆顶”,将底层最靠右的节点称为“堆底”。
- 对于大顶堆(小顶堆),堆顶元素(根节点)的值是最大(最小)的。
堆的常用操作
需要指出的是,许多编程语言提供的是优先队列(priority queue),这是一种抽象的数据结构,定义为具有优先级排序的队列。
实际上,堆通常用于实现优先队列,大顶堆相当于元素按从大到小的顺序出队的优先队列。从使用角度来看,我们可以将“优先队列”和“堆”看作等价的数据结构。因此,本书对两者不做特别区分,统一称作“堆”。
堆的常用操作见下表,方法名需要根据编程语言来确定。
表
| 方法名 | 描述 | 时间复杂度 |
|---|---|---|
push() |
元素入堆 | |
pop() |
堆顶元素出堆 | |
peek() |
访问堆顶元素(对于大 / 小顶堆分别为最大 / 小值) | |
size() |
获取堆的元素数量 | |
isEmpty() |
判断堆是否为空 |
在实际应用中,我们可以直接使用编程语言提供的堆类(或优先队列类)。
类似于排序算法中的“从小到大排列”和“从大到小排列”,我们可以通过设置一个 flag 或修改 Comparator 实现“小顶堆”与“大顶堆”之间的转换。代码如下所示:
/* 初始化堆 */
// 初始化小顶堆
Queue<Integer> minHeap = new PriorityQueue<>();
// 初始化大顶堆(使用 lambda 表达式修改 Comparator 即可)
Queue<Integer> maxHeap = new PriorityQueue<>((a, b) -> b - a);

/* 元素入堆 */
maxHeap.offer(1);
maxHeap.offer(3);
maxHeap.offer(2);
maxHeap.offer(5);
maxHeap.offer(4);

/* 获取堆顶元素 */
int peek = maxHeap.peek(); // 5

/* 堆顶元素出堆 */
// 出堆元素会形成一个从大到小的序列
peek = maxHeap.poll(); // 5
peek = maxHeap.poll(); // 4
peek = maxHeap.poll(); // 3
peek = maxHeap.poll(); // 2
peek = maxHeap.poll(); // 1

/* 获取堆大小 */
int size = maxHeap.size();

/* 判断堆是否为空 */
boolean isEmpty = maxHeap.isEmpty();

/* 输入列表并建堆 */
minHeap = new PriorityQueue<>(Arrays.asList(1, 3, 2, 5, 4));
堆的实现
下文实现的是大顶堆。若要将其转换为小顶堆,只需将所有大小逻辑判断进行逆转(例如,将 替换为 )。感兴趣的读者可以自行实现。
堆的存储与表示
“二叉树”章节讲过,完全二叉树非常适合用数组来表示。由于堆正是一种完全二叉树,因此我们将采用数组来存储堆。
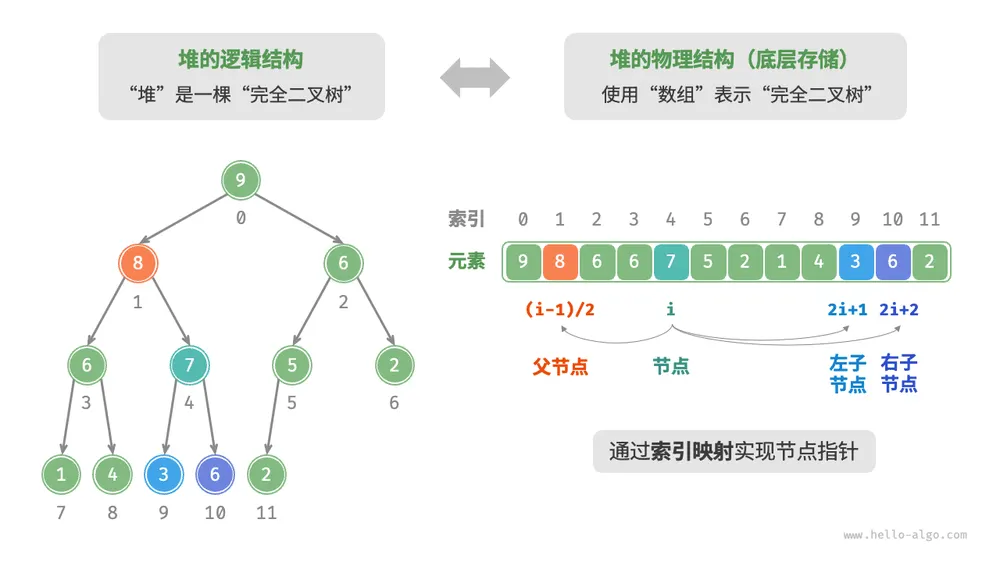
当使用数组表示二叉树时,元素代表节点值,索引代表节点在二叉树中的位置。节点指针通过索引映射公式来实现。
如下图所示,给定索引 ,其左子节点的索引为 ,右子节点的索引为 ,父节点的索引为 (向下整除)。当索引越界时,表示空节点或节点不存在。
我们可以将索引映射公式封装成函数,方便后续使用:
for (int i = parent(size() - 1); i >= 0; i--) {
    siftDown(i);
}
访问堆顶元素
堆顶元素即为二叉树的根节点,也就是列表的首个元素:
/* 访问堆顶元素 */
public int peek() {
    return maxHeap.get(0);
}
元素入堆
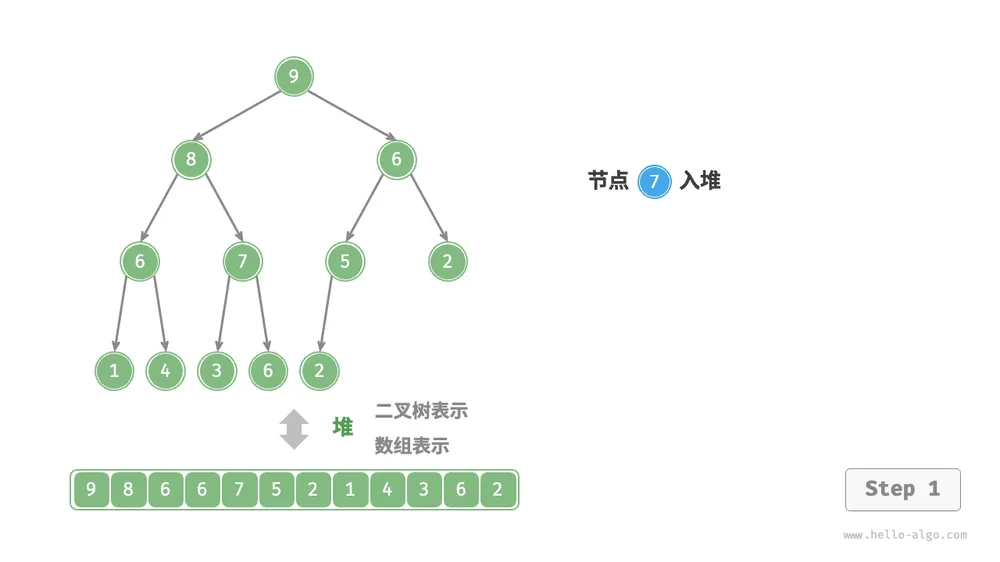
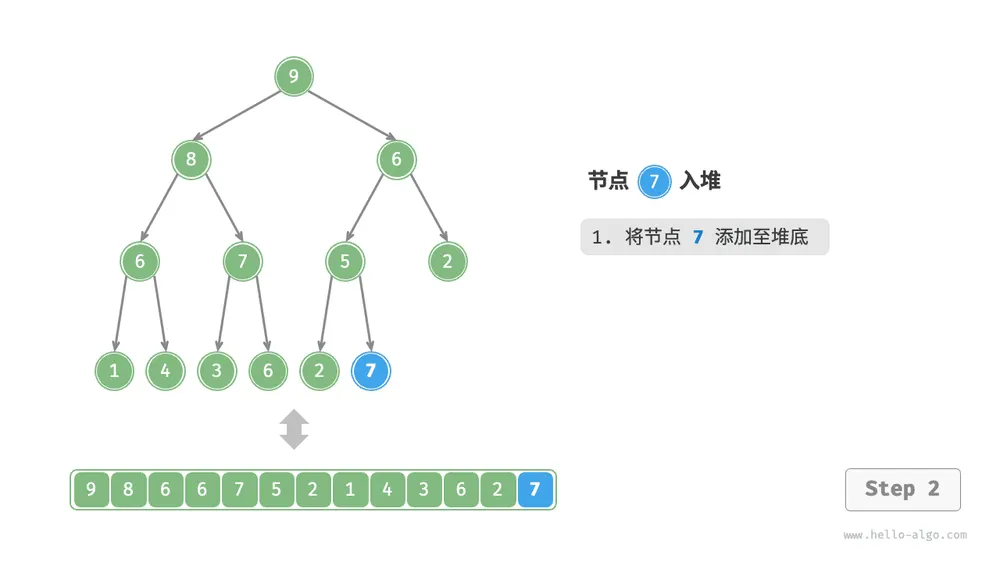
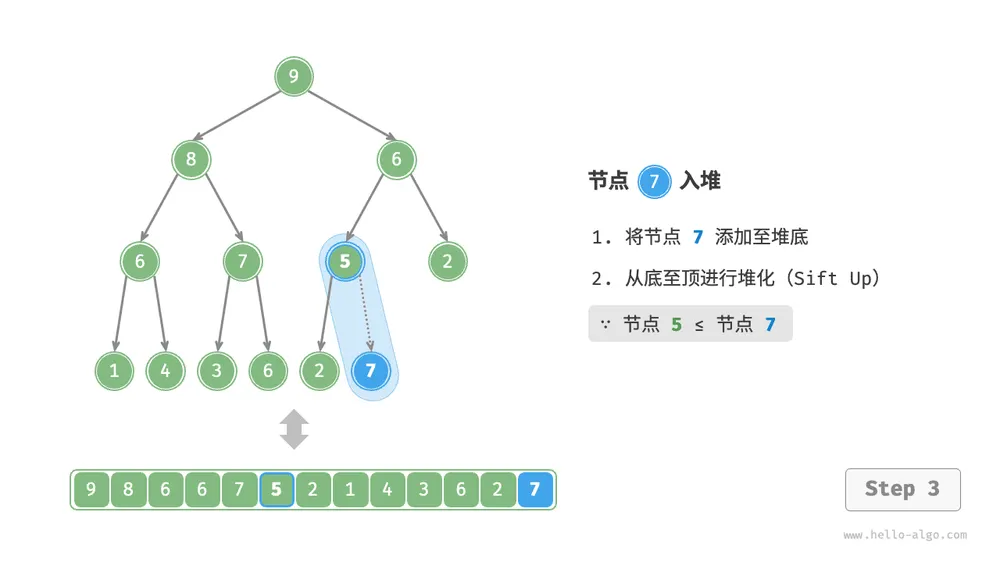
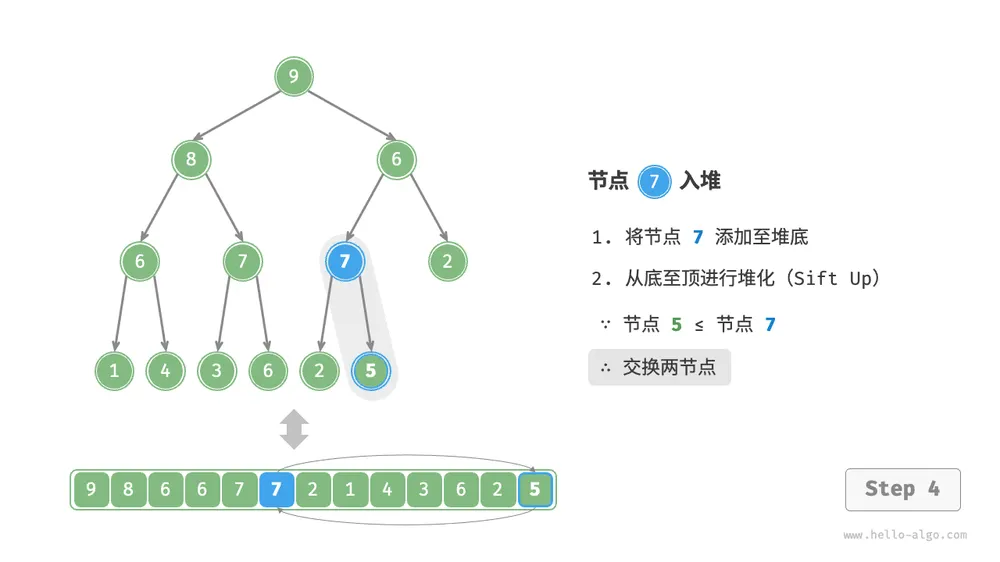
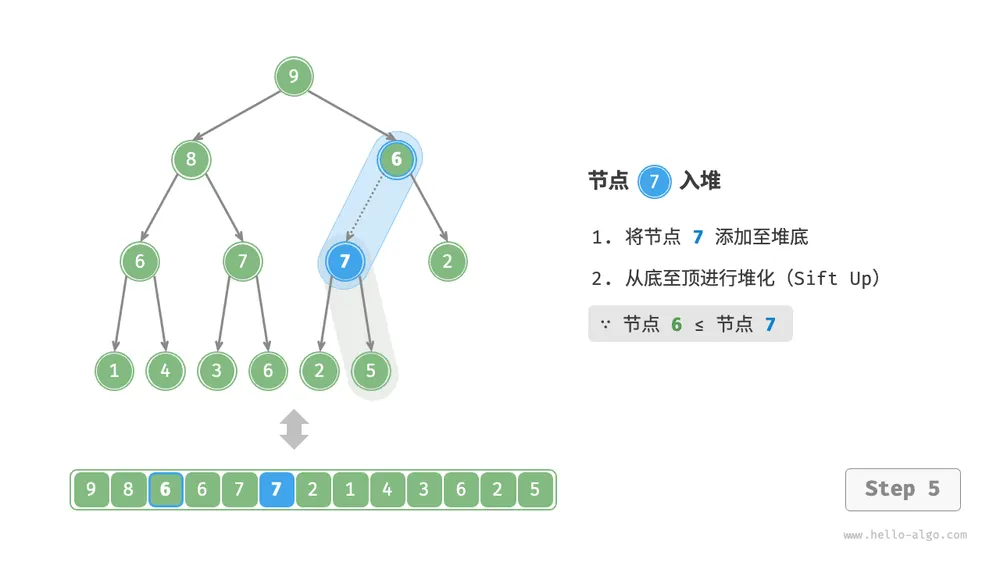
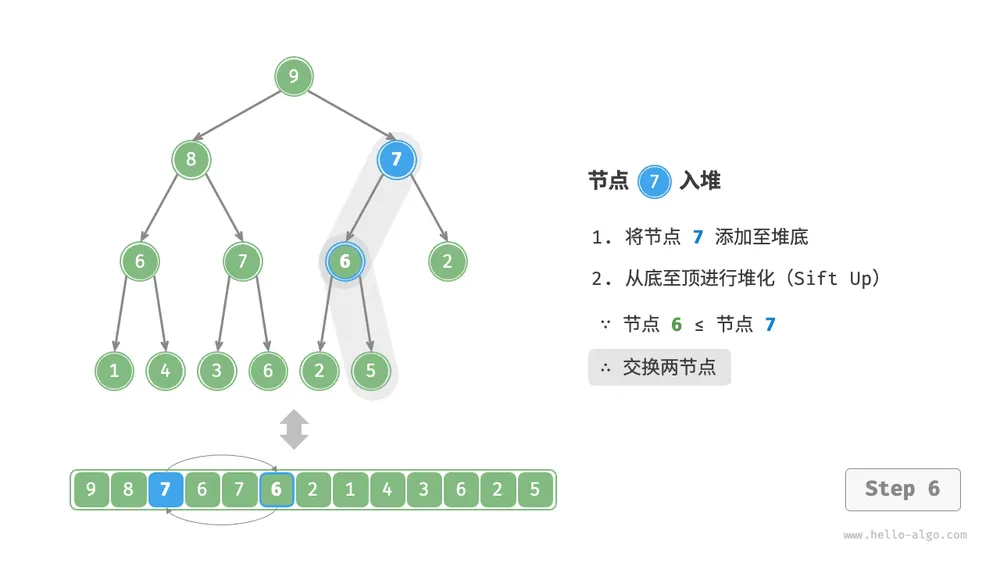
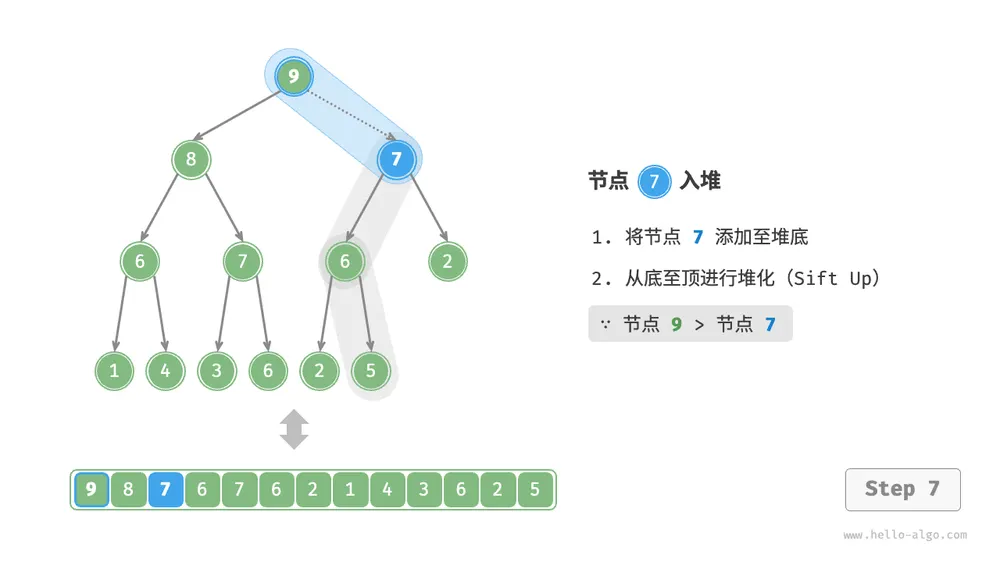
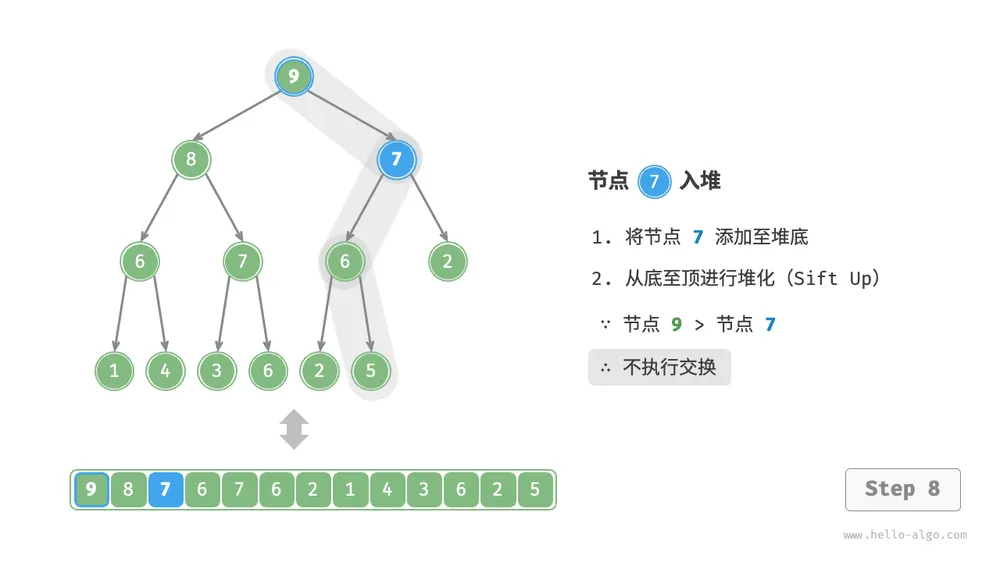
给定元素 val ,我们首先将其添加到堆底。添加之后,由于 val 可能大于堆中其他元素,堆的成立条件可能已被破坏,因此需要修复从插入节点到根节点的路径上的各个节点,这个操作被称为堆化(heapify)。
考虑从入堆节点开始,从底至顶执行堆化。如下图所示,我们比较插入节点与其父节点的值,如果插入节点更大,则将它们交换。然后继续执行此操作,从底至顶修复堆中的各个节点,直至越过根节点或遇到无须交换的节点时结束。
第 1 步
第 2 步
第 3 步
第 4 步
第 5 步
第 6 步
第 7 步
第 8 步
第 9 步
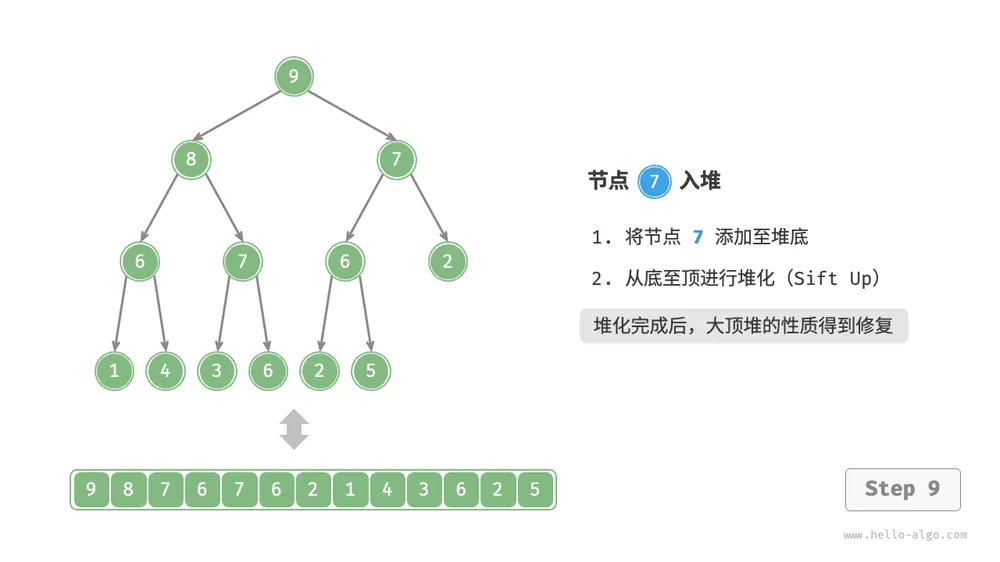
设节点总数为 ,则树的高度为 。由此可知,堆化操作的循环轮数最多为 ,元素入堆操作的时间复杂度为 。代码如下所示:
siftUp(size() - 1);堆顶元素出堆
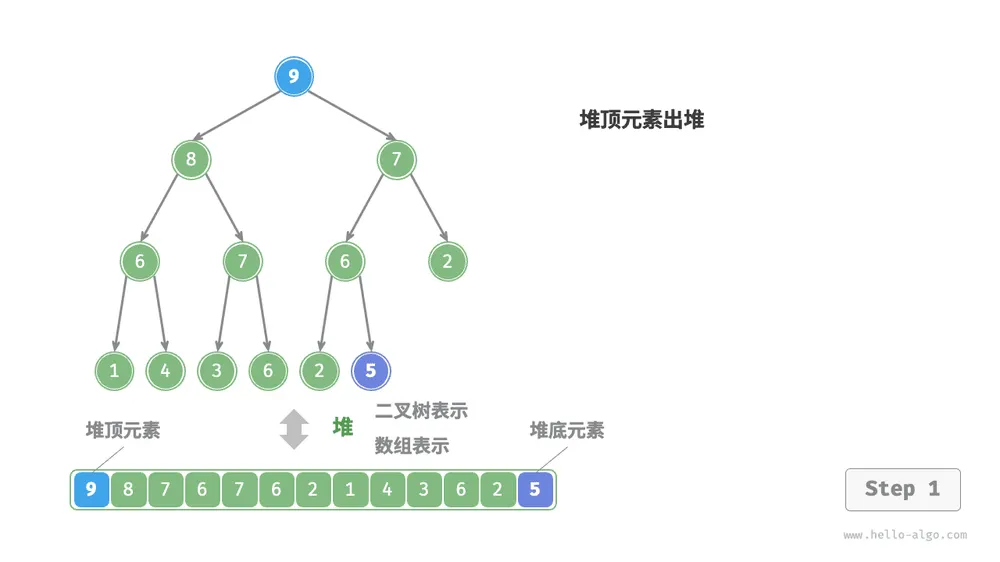
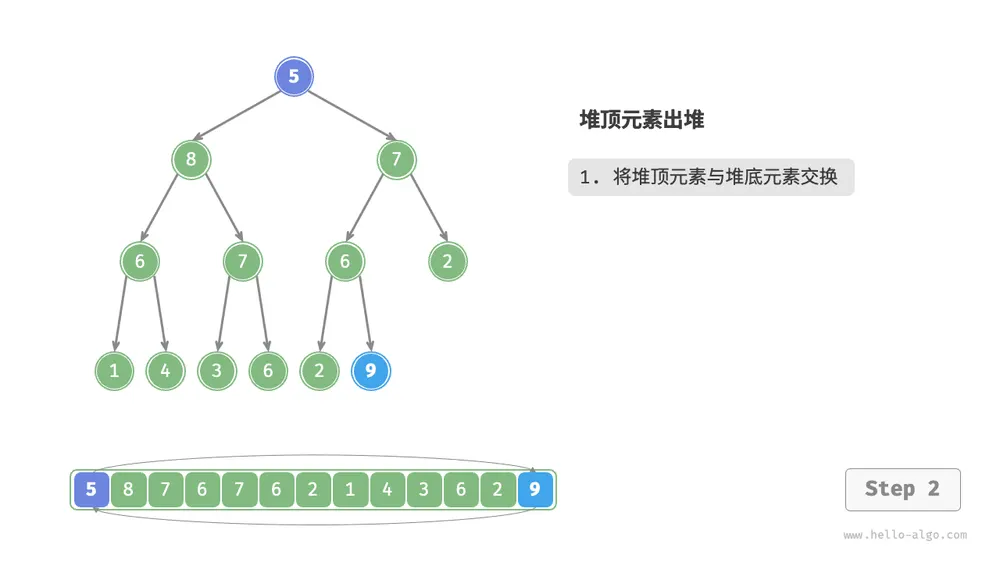
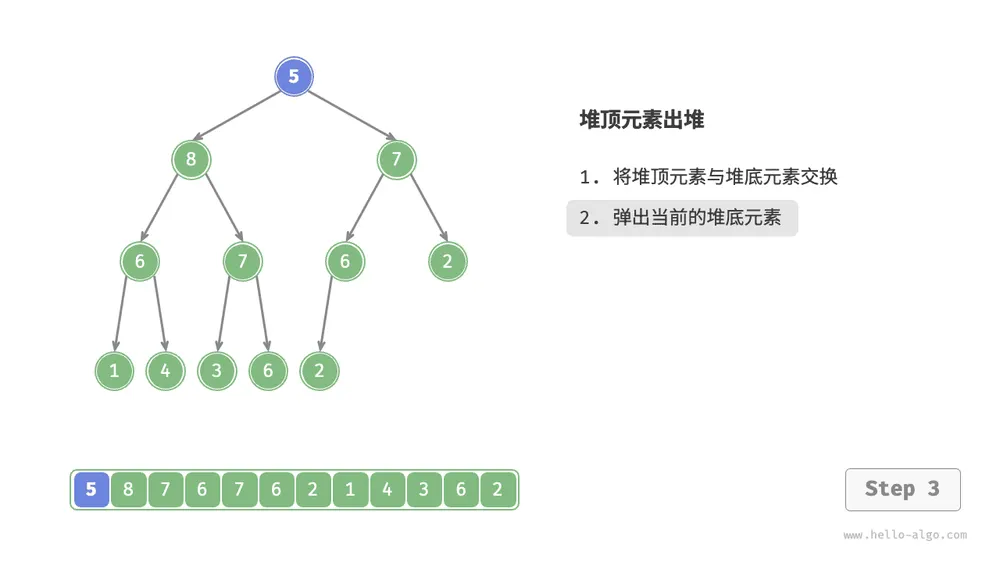
堆顶元素是二叉树的根节点,即列表首元素。如果我们直接从列表中删除首元素,那么二叉树中所有节点的索引都会发生变化,这将使得后续使用堆化进行修复变得困难。为了尽量减少元素索引的变动,我们采用以下操作步骤。
- 交换堆顶元素与堆底元素(交换根节点与最右叶节点)。
- 交换完成后,将堆底从列表中删除(注意,由于已经交换,因此实际上删除的是原来的堆顶元素)。
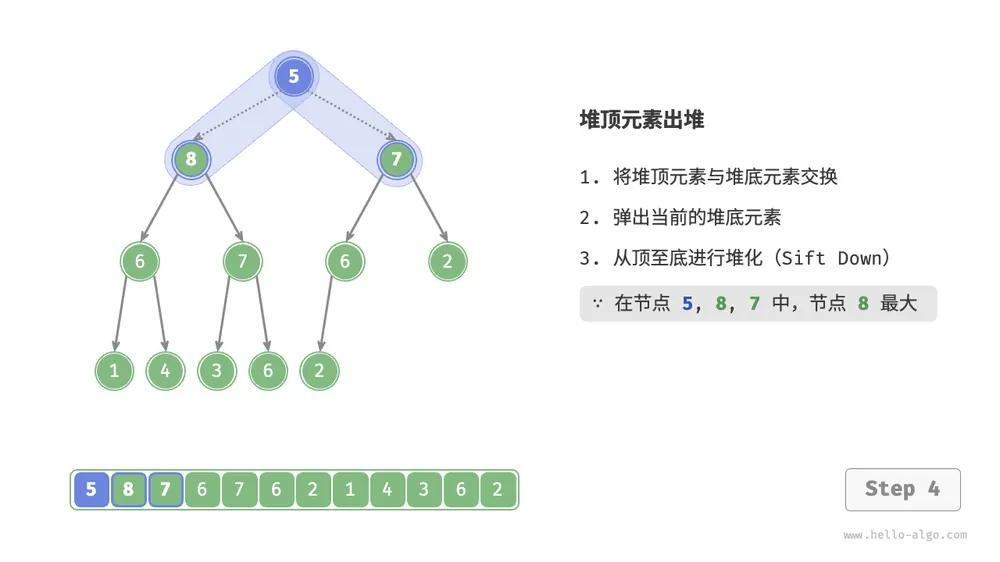
- 从根节点开始,从顶至底执行堆化。
如下图所示,“从顶至底堆化”的操作方向与“从底至顶堆化”相反,我们将根节点的值与其两个子节点的值进行比较,将最大的子节点与根节点交换。然后循环执行此操作,直到越过叶节点或遇到无须交换的节点时结束。
第 1 步
第 2 步
第 3 步
第 4 步
第 5 步
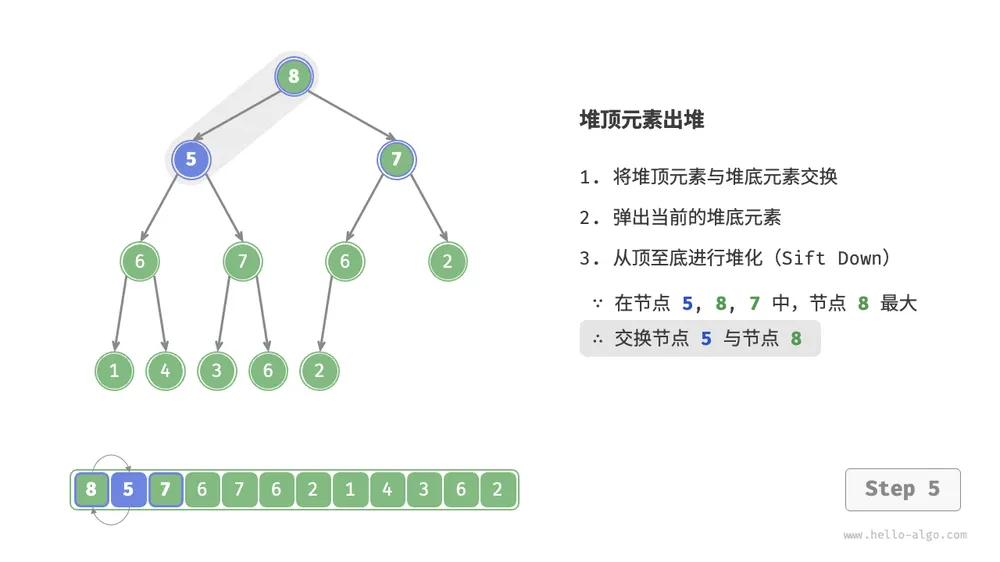
第 6 步
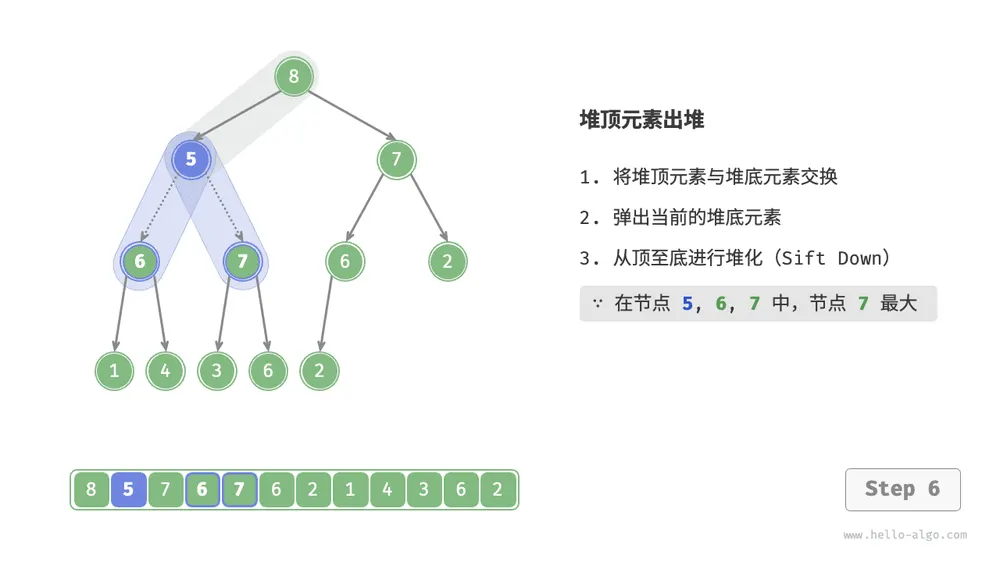
第 7 步
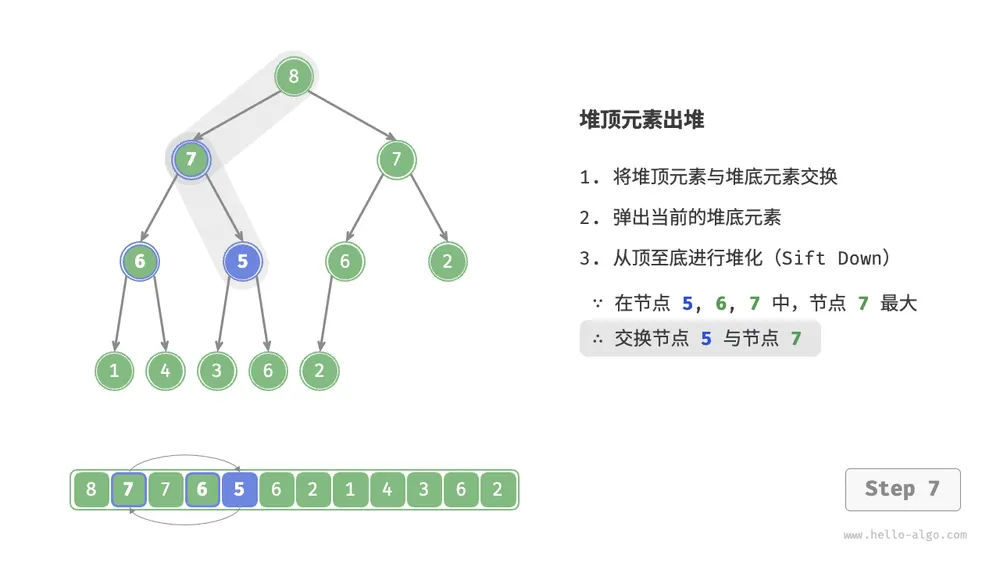
第 8 步
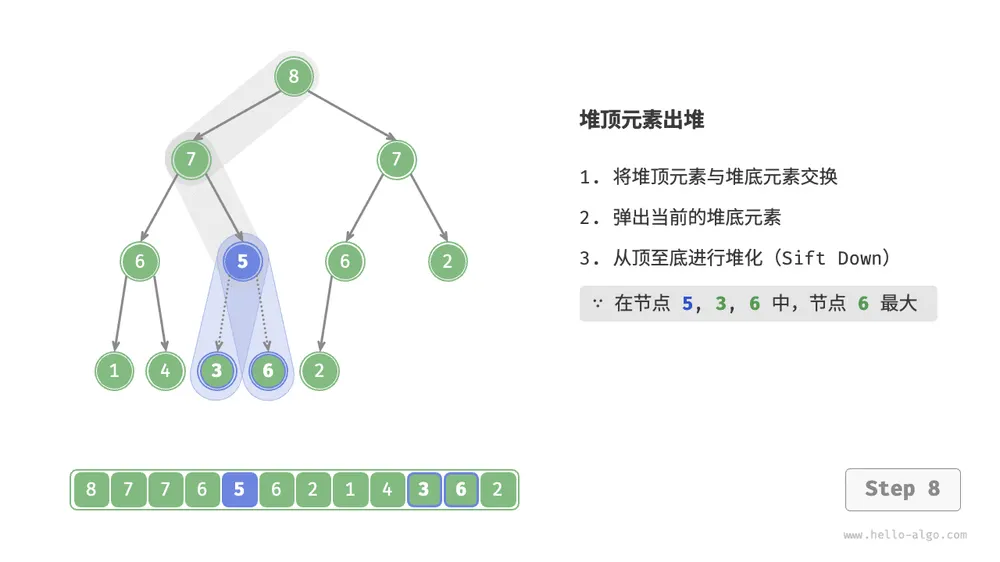
第 9 步
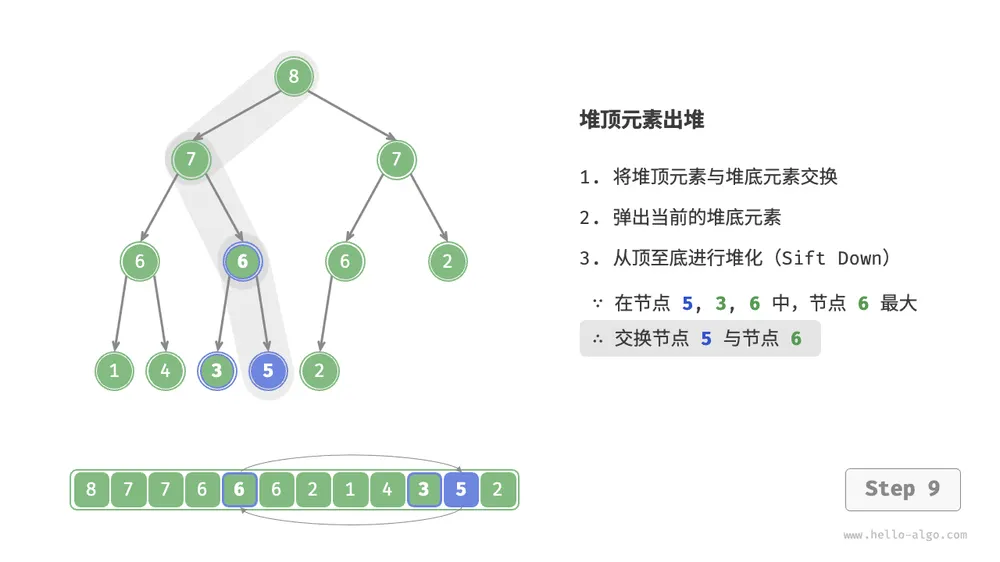
第 10 步
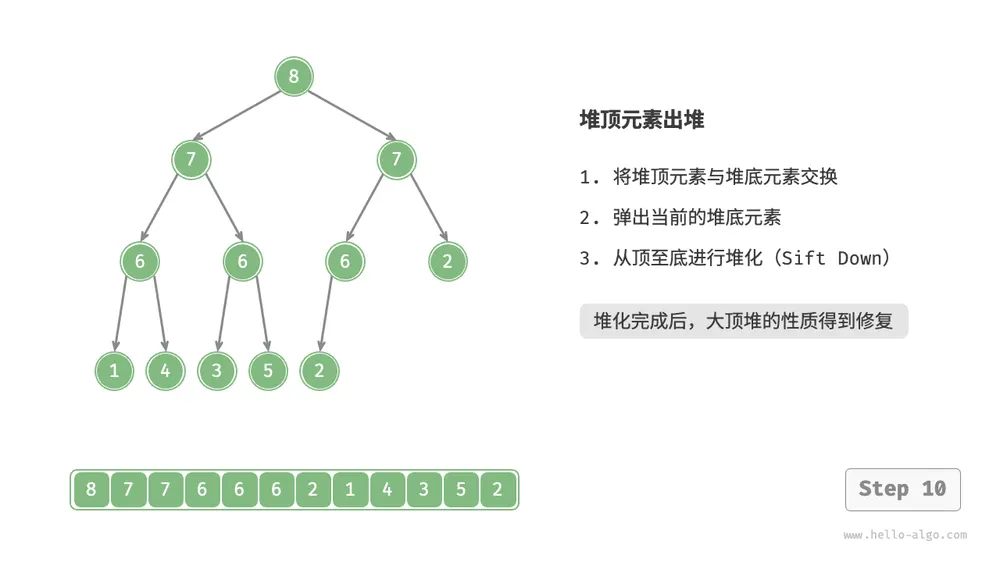
与元素入堆操作相似,堆顶元素出堆操作的时间复杂度也为 。代码如下所示:
siftDown(i);堆的常见应用
- 优先队列:堆通常作为实现优先队列的首选数据结构,其入队和出队操作的时间复杂度均为 ,而建堆操作为 ,这些操作都非常高效。
- 堆排序:给定一组数据,我们可以用它们建立一个堆,然后不断地执行元素出堆操作,从而得到有序数据。然而,我们通常会使用一种更优雅的方式实现堆排序,详见“堆排序”章节。
- 获取最大的 个元素:这是一个经典的算法问题,同时也是一种典型应用,例如选择热度前 10 的新闻作为微博热搜,选取销量前 10 的商品等。
建堆操作
在某些情况下,我们希望使用一个列表的所有元素来构建一个堆,这个过程被称为“建堆操作”。
借助入堆操作实现
我们首先创建一个空堆,然后遍历列表,依次对每个元素执行“入堆操作”,即先将元素添加至堆的尾部,再对该元素执行“从底至顶”堆化。
每当一个元素入堆,堆的长度就加一。由于节点是从顶到底依次被添加进二叉树的,因此堆是“自上而下”构建的。
设元素数量为 ,每个元素的入堆操作使用 时间,因此该建堆方法的时间复杂度为 。
通过遍历堆化实现
实际上,我们可以实现一种更为高效的建堆方法,共分为两步。
- 将列表所有元素原封不动地添加到堆中,此时堆的性质尚未得到满足。
- 倒序遍历堆(层序遍历的倒序),依次对每个非叶节点执行“从顶至底堆化”。
每当堆化一个节点后,以该节点为根节点的子树就形成一个合法的子堆。而由于是倒序遍历,因此堆是“自下而上”构建的。
之所以选择倒序遍历,是因为这样能够保证当前节点之下的子树已经是合法的子堆,这样堆化当前节点才是有效的。
值得说明的是,由于叶节点没有子节点,因此它们天然就是合法的子堆,无须堆化。如以下代码所示,最后一个非叶节点是最后一个节点的父节点,我们从它开始倒序遍历并执行堆化:
/* 构造方法,根据输入列表建堆 */
public MaxHeap(List<Integer> nums) {
    // 将列表元素原封不动添加进堆
    maxHeap = new ArrayList<>(nums);
    // 堆化除叶节点以外的其他所有节点
    for (int i = parent(size() - 1); i >= 0; i--) {
        siftDown(i);
    }
}
复杂度分析
下面,我们来尝试推算第二种建堆方法的时间复杂度。
- 假设完全二叉树的节点数量为 ,则叶节点数量为 ,其中 为向下整除。因此需要堆化的节点数量为 。
- 在从顶至底堆化的过程中,每个节点最多堆化到叶节点,因此最大迭代次数为二叉树高度 。
将上述两者相乘,可得到建堆过程的时间复杂度为 。但这个估算结果并不准确,因为我们没有考虑到二叉树底层节点数量远多于顶层节点的性质。
接下来我们来进行更为准确的计算。为了降低计算难度,假设给定一个节点数量为 、高度为 的“完美二叉树”,该假设不会影响计算结果的正确性。
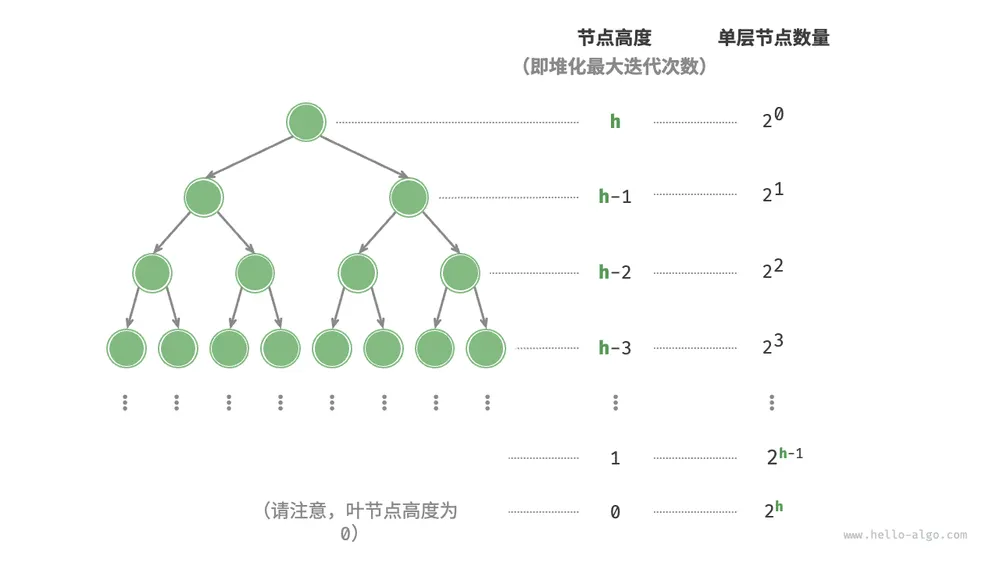
如上图所示,节点“从顶至底堆化”的最大迭代次数等于该节点到叶节点的距离,而该距离正是“节点高度”。因此,我们可以对各层的“节点数量 节点高度”求和,得到所有节点的堆化迭代次数的总和。
化简上式需要借助中学的数列知识,先将 乘以 ,得到:
使用错位相减法,用下式 减去上式 ,可得:
观察上式,发现 是一个等比数列,可直接使用求和公式,得到时间复杂度为:
进一步,高度为 的完美二叉树的节点数量为 ,易得复杂度为 。以上推算表明,输入列表并建堆的时间复杂度为 ,非常高效。
Top-k 问题
提问
给定一个长度为 的无序数组
nums,请返回数组中最大的 个元素。
对于该问题,我们先介绍两种思路比较直接的解法,再介绍效率更高的堆解法。
方法一:遍历选择
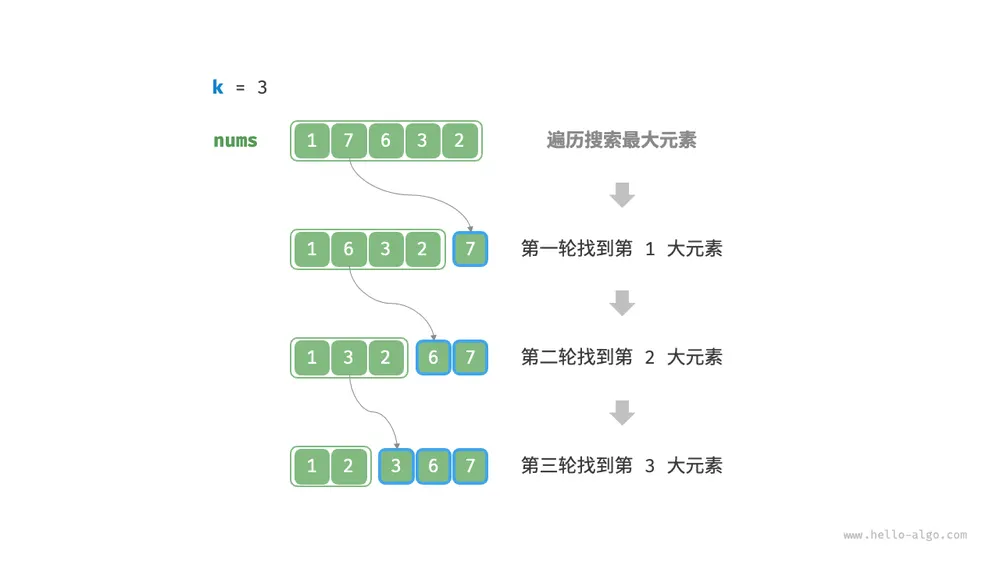
我们可以进行下图所示的 轮遍历,分别在每轮中提取第 、、、 大的元素,时间复杂度为 。
此方法只适用于 的情况,因为当 与 比较接近时,其时间复杂度趋向于 ,非常耗时。
提示
当 时,我们可以得到完整的有序序列,此时等价于“选择排序”算法。
方法二:排序
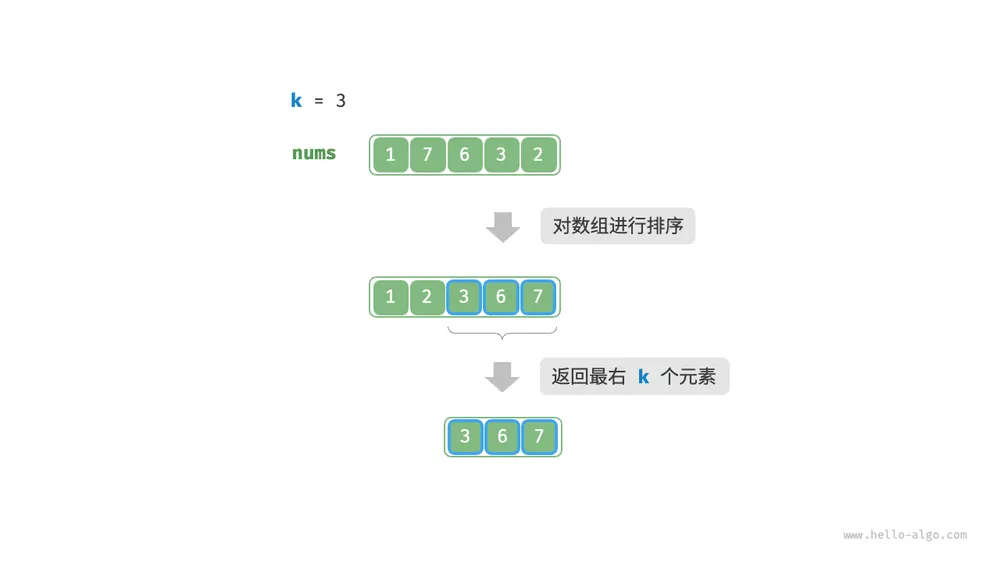
如下图所示,我们可以先对数组 nums 进行排序,再返回最右边的 个元素,时间复杂度为 。
显然,该方法“超额”完成任务了,因为我们只需找出最大的 个元素即可,而不需要排序其他元素。
方法三:堆
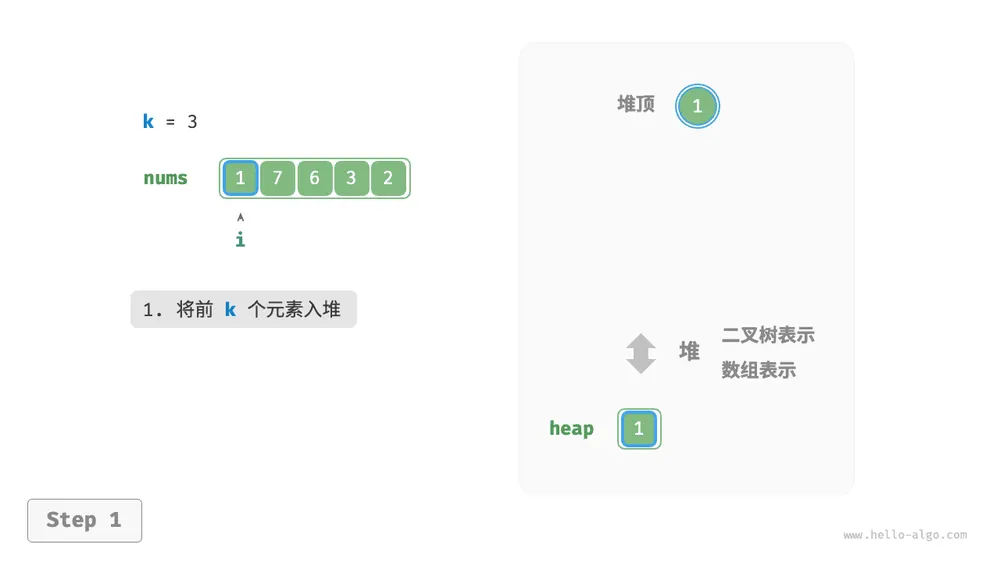
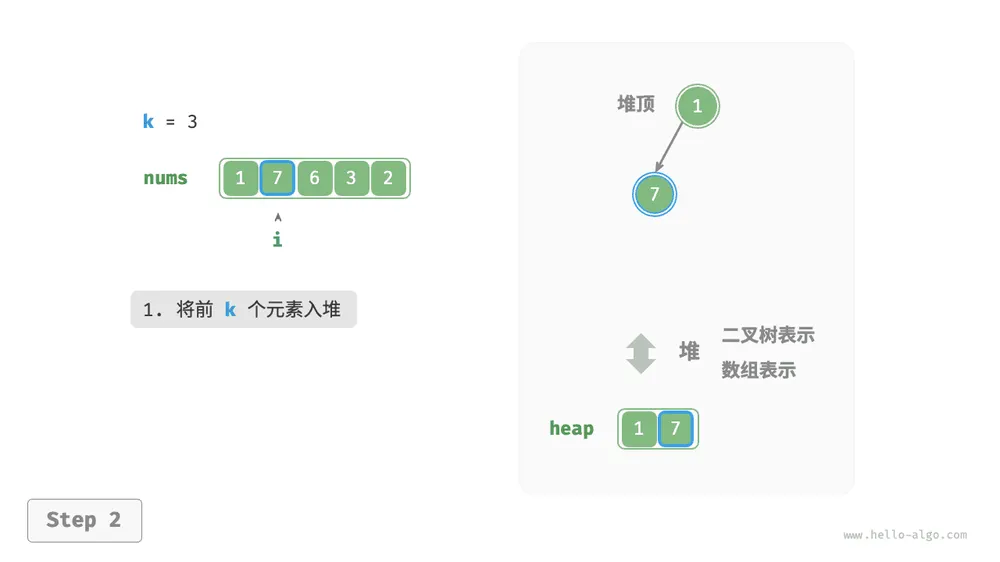
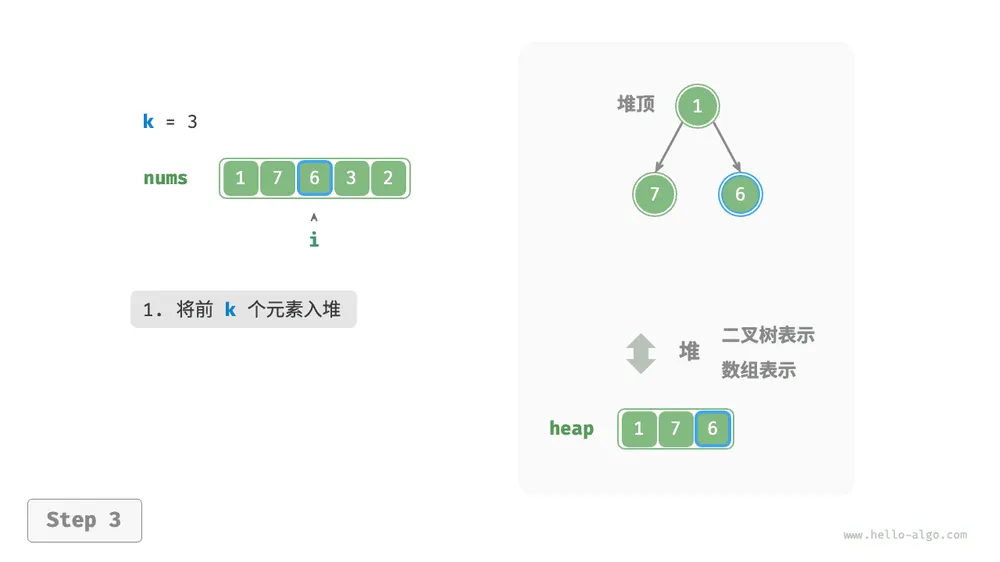
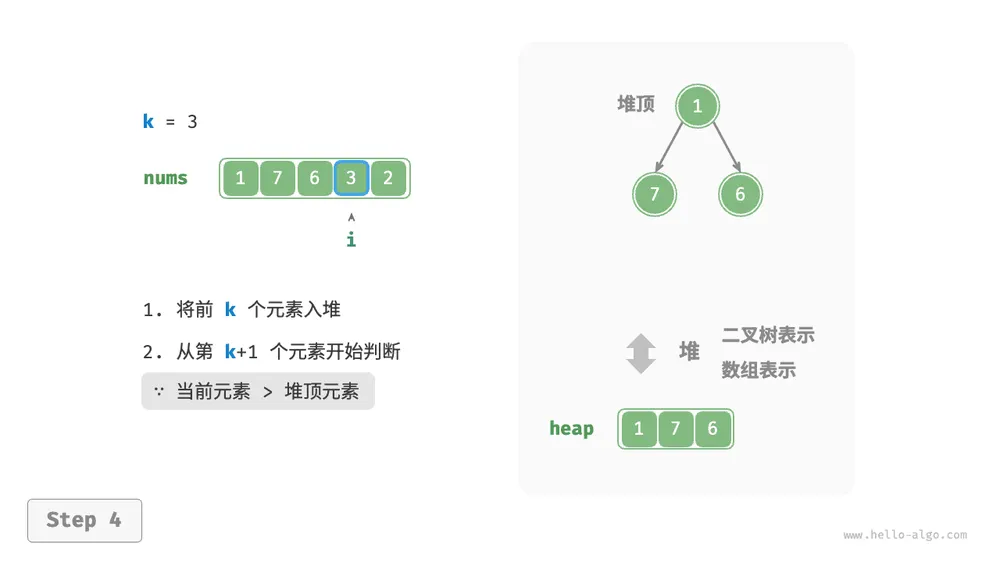
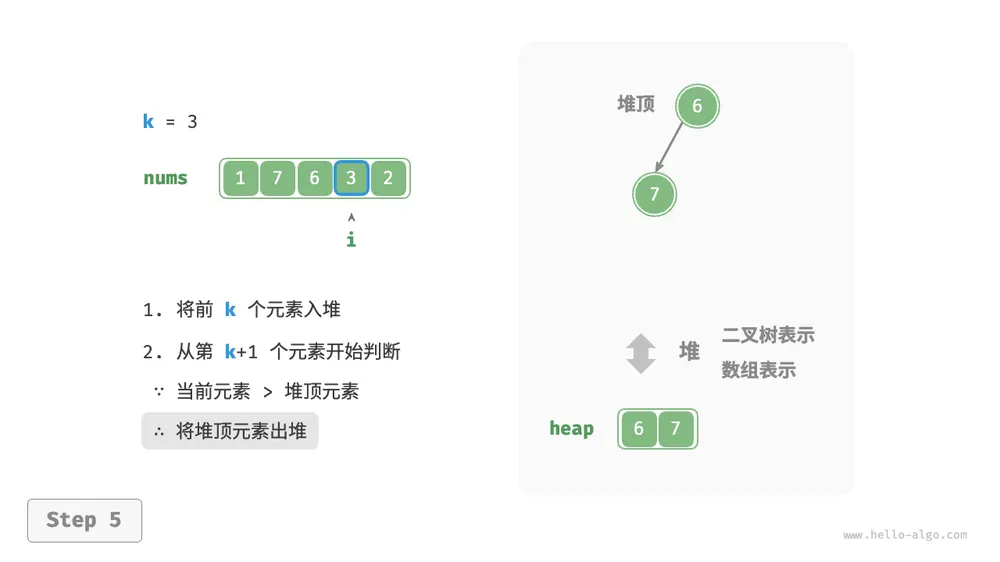
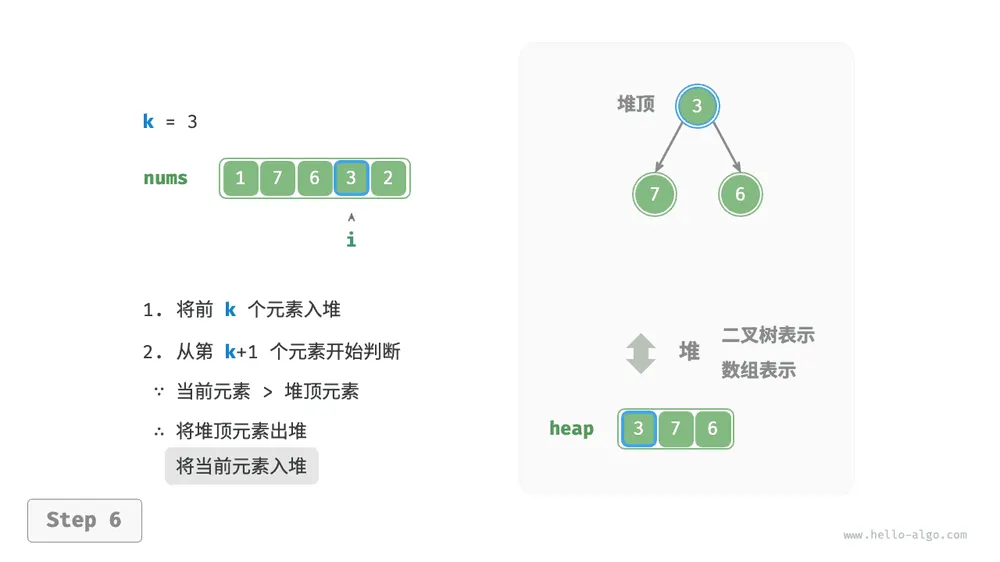
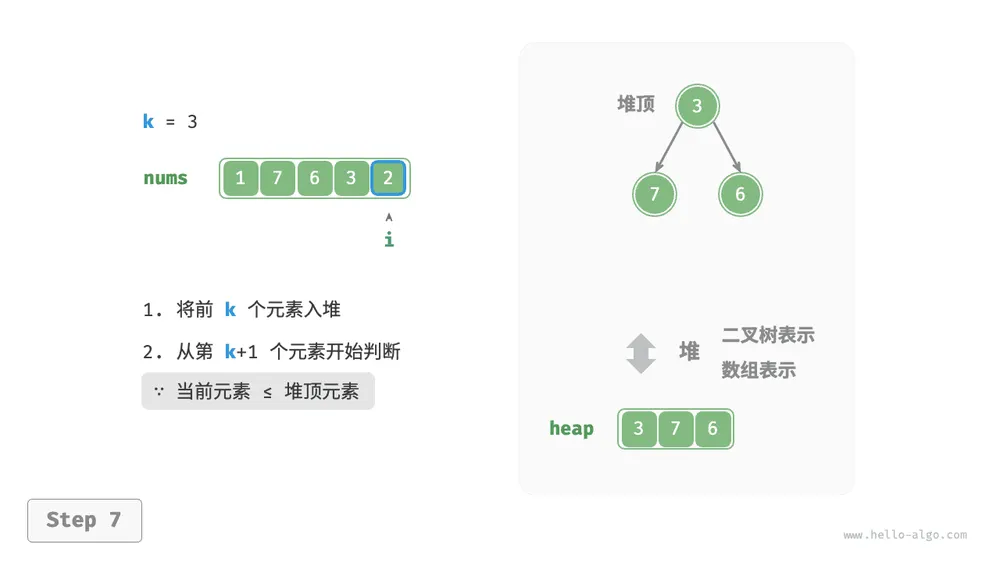
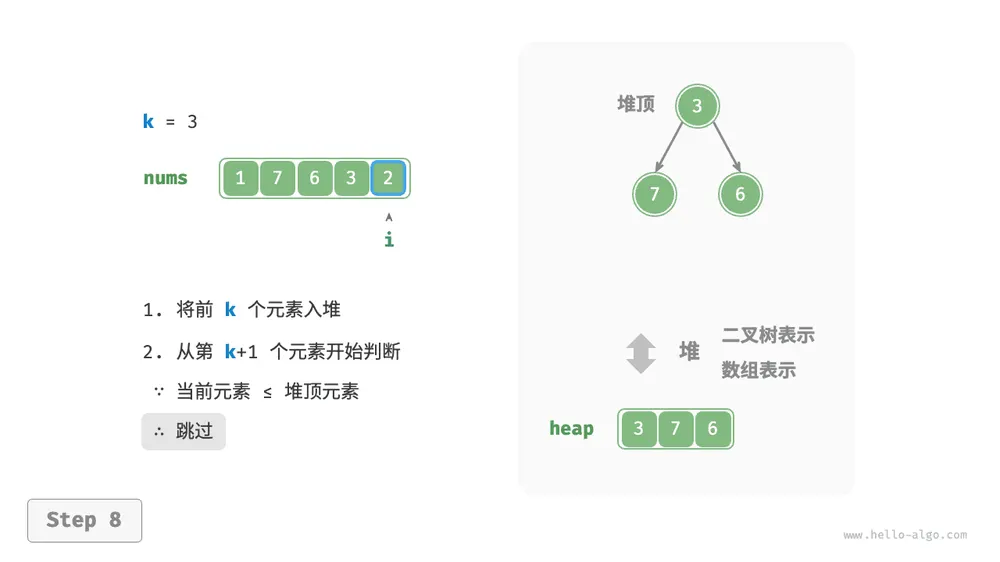
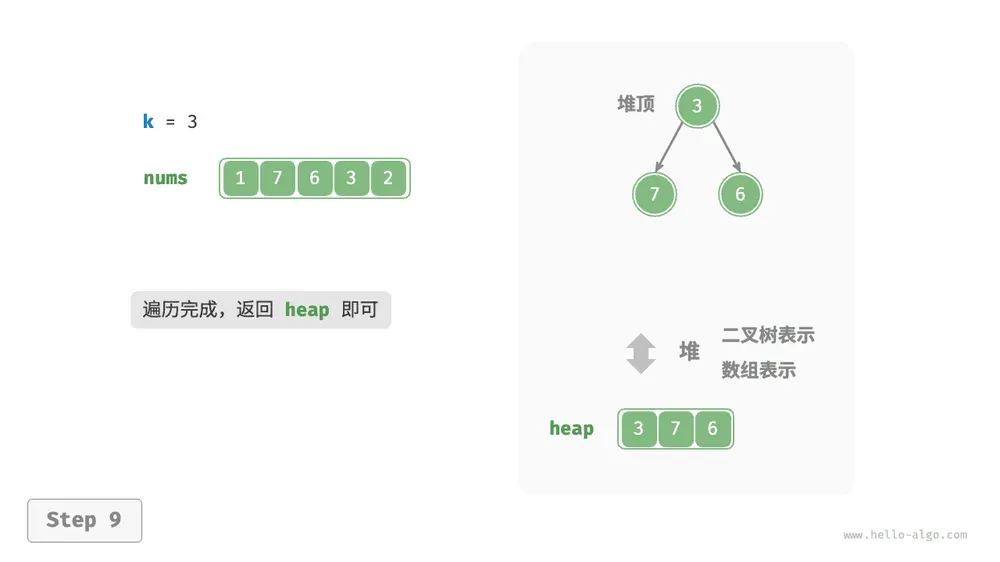
我们可以基于堆更加高效地解决 Top-k 问题,流程如下图所示。
- 初始化一个小顶堆,其堆顶元素最小。
- 先将数组的前 个元素依次入堆。
- 从第 个元素开始,若当前元素大于堆顶元素,则将堆顶元素出堆,并将当前元素入堆。
- 遍历完成后,堆中保存的就是最大的 个元素。
第 1 步
第 2 步
第 3 步
第 4 步
第 5 步
第 6 步
第 7 步
第 8 步
第 9 步
示例代码如下:
/* 基于堆查找数组中最大的 k 个元素 */
static Queue<Integer> topKHeap(int[] nums, int k) {
    // 初始化小顶堆
    Queue<Integer> heap = new PriorityQueue<Integer>();
    // 将数组的前 k 个元素入堆
    for (int i = 0; i < k; i++) {
        heap.offer(nums[i]);
    }
    // 从第 k+1 个元素开始,保持堆的长度为 k
    for (int i = k; i < nums.length; i++) {
        // 若当前元素大于堆顶元素,则将堆顶元素出堆、当前元素入堆
        if (nums[i] > heap.peek()) {
            heap.poll();
            heap.offer(nums[i]);
        }
    }
    return heap;
}
总共执行了 轮入堆和出堆,堆的最大长度为 ,因此时间复杂度为 。该方法的效率很高,当 较小时,时间复杂度趋向 ;当 较大时,时间复杂度不会超过 。
另外,该方法适用于动态数据流的使用场景。在不断加入数据时,我们可以持续维护堆内的元素,从而实现最大的 个元素的动态更新。
小结
重点回顾
- 堆是一棵完全二叉树,根据成立条件可分为大顶堆和小顶堆。大(小)顶堆的堆顶元素是最大(小)的。
- 优先队列的定义是具有出队优先级的队列,通常使用堆来实现。
- 堆的常用操作及其对应的时间复杂度包括:元素入堆 、堆顶元素出堆 和访问堆顶元素 等。
- 完全二叉树非常适合用数组表示,因此我们通常使用数组来存储堆。
- 堆化操作用于维护堆的性质,在入堆和出堆操作中都会用到。
- 输入 个元素并建堆的时间复杂度可以优化至 ,非常高效。
- Top-k 是一个经典算法问题,可以使用堆数据结构高效解决,时间复杂度为 。
Q & A
Q:数据结构的“堆”与内存管理的“堆”是同一个概念吗?
两者不是同一个概念,只是碰巧都叫“堆”。计算机系统内存中的堆是动态内存分配的一部分,程序在运行时可以使用它来存储数据。程序可以请求一定量的堆内存,用于存储如对象和数组等复杂结构。当这些数据不再需要时,程序需要释放这些内存,以防止内存泄漏。相较于栈内存,堆内存的管理和使用需要更谨慎,使用不当可能会导致内存泄漏和野指针等问题。
练习
知识巩固
数字 10 入堆后怎样调整
数组 [9, 7, 8, 3, 5] 表示一个大顶堆。现在将数字 10 入堆。
- 先把 10 添加到数组末尾,它的父节点值是多少?
- 从新节点开始向上堆化,写出每次交换后的数组。
- 最终的堆顶元素是什么?一共交换了几次?
参考答案
10 添加后的索引为 5,其父节点索引为
,父节点值为 8。10 大于 8,第一次交换后为
[9, 7, 10, 3, 5, 8];
10 又大于父节点 9,第二次交换后为[10, 7, 9, 3, 5, 8]。
此时 10 已到达根节点,堆化结束。最终堆顶为 10,共交换 2 次。
检查小顶堆的父子关系
数组 [1, 4, 3, 7, 6, 2] 表示一棵完全二叉树。小顶堆要求每个父节点都不大于它的孩子。
对索引 ,左、右孩子索引分别为 和 。
- 索引 2 的孩子索引和值分别是什么?
- 索引 2 处的节点值为 3,它与孩子节点之间是否违反小顶堆规则?如果违反,应交换哪两个元素?
- 根据第 2 问的判断:若违反规则,写出交换后的数组;若不违反,说明无须交换。最后检查其余父子关系。
参考答案
索引 2 的左孩子索引是 5、值为 2;右孩子索引是 6,但数组长度为 6,因此右孩子不存在。
父节点值 3 大于孩子值 2,违反小顶堆规则,应交换索引 2 和索引 5 的元素。
交换后得到
[1, 4, 2, 7, 6, 3]。逐一检查:
1 ≤ 4、1 ≤ 2;4 ≤ 7、4 ≤ 6;2 ≤ 3。
所有父节点都不大于自己的孩子,因此现在满足小顶堆规则。
用小顶堆保留最大的三个数
要从数据流 [4, 1, 7, 3, 8] 中保留最大的 3 个数,可以维护一个大小不超过 3 的小顶堆。
先把前 3 个数依次放入小顶堆。堆满后,每读入一个新数:
如果它大于堆顶,就删除堆顶并放入新数;否则堆保持不变。
请写出每次读入数字后堆中保留的数字和堆顶。
只需把保留的数字写成集合,不要求写出它们在堆数组中的排列。
参考答案
每次读入数字后的结果如下:
读入数字 保留的数字 堆顶 4 {4}4 1 {1, 4}1 7 {1, 4, 7}1 3 {3, 4, 7}3 8 {4, 7, 8}4 堆满后,堆顶是当前保留数字中最小的一个。只有新数字大于堆顶时,
才用新数字替换堆顶。最终保留的{4, 7, 8}正是最大的 3 个数。
编程练习
寻找数组中的第 k 大元素
给定整数数组 nums 和整数 ,其中 , 是数组长度。把数组按从大到小排列后,请返回第 个位置上的元素。
重复元素需要分别计数。例如,[5, 5, 2] 的第 2 大元素仍是 5。请使用一个大小不超过 的小顶堆完成。
解题提示
- 第 k 大元素是最大的 k 个数中最小的那个
- 每个数先入小顶堆,大小超过 k 时弹出最小值
- 遍历结束时堆中保留最大的 k 个数,堆顶就是答案
LeetCode{ .rounded-button .exercise-button target="_blank" rel="noopener noreferrer" } 题目解析{ .rounded-button .exercise-button target="_blank" rel="noopener noreferrer" }
说明: 链接中的题解讲解了快速排序和快速选择,没有使用堆;本练习请按照正文 8.3 节使用大小不超过 k 的小顶堆完成