6 / 7
分布式系统
分布式 id 生成器
有时我们需要能够生成类似 MySQL 自增 ID 这样不断增大,同时又不会重复的 id。以支持业务中的高并发场景。比较典型的,电商促销时,短时间内会有大量的订单涌入到系统,比如每秒 10w+。明星出轨时,会有大量热情的粉丝发微博以表心意,同样会在短时间内产生大量的消息。
在插入数据库之前,我们需要给这些消息、订单先打上一个 ID,然后再插入到我们的数据库。对这个 id 的要求是希望其中能带有一些时间信息,这样即使我们后端的系统对消息进行了分库分表,也能够以时间顺序对这些消息进行排序。
Twitter 的 snowflake 算法是这种场景下的一个典型解法。先来看看 snowflake 是怎么一回事,见 图 6-1:
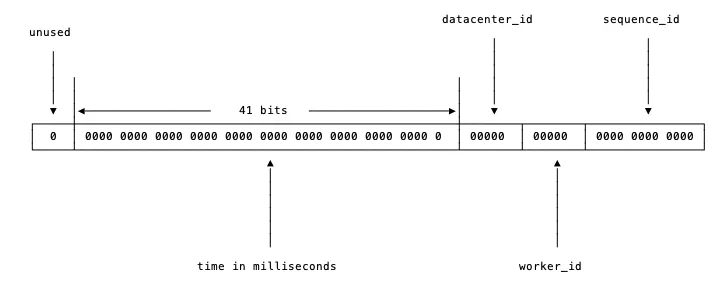
图 6-1 snowflake 中的比特位分布
首先确定我们的数值是 64 位,int64 类型,被划分为四部分,不含开头的第一个 bit,因为这个 bit 是符号位。用 41 位来表示收到请求时的时间戳,单位为毫秒,然后五位来表示数据中心的 id,然后再五位来表示机器的实例 id,最后是 12 位的循环自增 id(到达 1111,1111,1111 后会归 0)。
这样的机制可以支持我们在同一台机器上,同一毫秒内产生 2 ^ 12 = 4096 条消息。一秒共 409.6 万条消息。从值域上来讲完全够用了。
数据中心加上实例 id 共有 10 位,可以支持我们每数据中心部署 32 台机器,所有数据中心共 1024 台实例。
表示 timestamp 的 41 位,可以支持我们使用 69 年。当然,我们的时间毫秒计数不会真的从 1970 年开始记,那样我们的系统跑到 2039/9/7 23:47:35 就不能用了,所以这里的 timestamp 只是相对于某个时间的增量,比如我们的系统上线是 2018-08-01,那么我们可以把这个 timestamp 当作是从 2018-08-01 00:00:00.000 的偏移量。
6.1.1 worker_id 分配
timestamp,datacenter_id,worker_id 和 sequence_id 这四个字段中,timestamp 和 sequence_id 是由程序在运行期生成的。但 datacenter_id 和 worker_id 需要我们在部署阶段就能够获取得到,并且一旦程序启动之后,就是不可更改的了(想想,如果可以随意更改,可能被不慎修改,造成最终生成的 id 有冲突)。
一般不同数据中心的机器,会提供对应的获取数据中心 id 的 API,所以 datacenter_id 我们可以在部署阶段轻松地获取到。而 worker_id 是我们逻辑上给机器分配的一个 id,这个要怎么办呢?比较简单的想法是由能够提供这种自增 id 功能的工具来支持,比如 MySQL:
mysql> insert into a (ip) values("10.1.2.101");
Query OK, 1 row affected (0.00 sec)

mysql> select last_insert_id();
+------------------+
| last_insert_id() |
+------------------+
|                2 |
+------------------+
1 row in set (0.00 sec)
从 MySQL 中获取到 worker_id 之后,就把这个 worker_id 直接持久化到本地,以避免每次上线时都需要获取新的 worker_id。让单实例的 worker_id 可以始终保持不变。
当然,使用 MySQL 相当于给我们简单的 id 生成服务增加了一个外部依赖。依赖越多,我们的服务的可运维性就越差。
考虑到集群中即使有单个 id 生成服务的实例挂了,也就是损失一段时间的一部分 id,所以我们也可以更简单暴力一些,把 worker_id 直接写在 worker 的配置中,上线时,由部署脚本完成 worker_id 字段替换。
6.1.2 开源实例
6.1.2.1 标准 snowflake 实现
github.com/bwmarrin/snowflake 是一个相当轻量化的 snowflake 的 Go 实现。其文档对各位使用的定义见 图 6-2 所示。
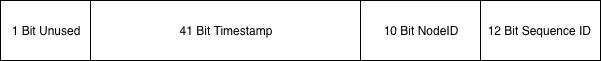
图 6-2 snowflake 库
和标准的 snowflake 完全一致。使用上比较简单:
package main

import (
    "fmt"
    "os"

    "github.com/bwmarrin/snowflake"
)

func main() {
    n, err := snowflake.NewNode(1)
    if err != nil {
        println(err)
        os.Exit(1)
    }

    for i := 0; i < 3; i++ {
        id := n.Generate()
        fmt.Println("id", id)
        fmt.Println(
            "node:", id.Node(),
            "step:", id.Step(),
            "time:", id.Time(),
            "\n",
        )
    }
}
当然,这个库也给我们留好了定制的后路,其中预留了一些可定制字段:
    // Epoch is set to the twitter snowflake epoch of Nov 04 2010 01:42:54 UTC
    // You may customize this to set a different epoch for your application.
    Epoch int64 = 1288834974657

    // Number of bits to use for Node
    // Remember, you have a total 22 bits to share between Node/Step
    NodeBits uint8 = 10

    // Number of bits to use for Step
    // Remember, you have a total 22 bits to share between Node/Step
    StepBits uint8 = 12
Epoch 就是本节开头讲的起始时间,NodeBits 指的是机器编号的位长,StepBits 指的是自增序列的位长。
6.1.2.2 sonyflake
sonyflake 是 Sony 公司的一个开源项目,基本思路和 snowflake 差不多,不过位分配上稍有不同,见 图 6-3:

图 6-3 sonyflake
这里的时间只用了 39 个 bit,但时间的单位变成了 10ms,所以理论上比 41 位表示的时间还要久 (174 年)。
Sequence ID 和之前的定义一致,Machine ID 其实就是节点 id。sonyflake 与众不同的地方在于其在启动阶段的配置参数:
func NewSonyflake(st Settings) *SonyflakeSettings 数据结构如下:
type Settings struct {
    StartTime      time.Time
    MachineID      func() (uint16, error)
    CheckMachineID func(uint16) bool
}
StartTime 选项和我们之前的 Epoch 差不多,如果不设置的话,默认是从 2014-09-01 00:00:00 +0000 UTC 开始。
MachineID 可以由用户自定义的函数,如果用户不定义的话,会默认将本机 IP 的低 16 位作为 machine id。
CheckMachineID 是由用户提供的检查 MachineID 是否冲突的函数。这里的设计还是比较巧妙的,如果有另外的中心化存储并支持检查重复的存储,那我们就可以按照自己的想法随意定制这个检查 MachineID 是否冲突的逻辑。如果公司有现成的 Redis 集群,那么我们可以很轻松地用 Redis 的集合类型来检查冲突。
redis 127.0.0.1:6379> SADD base64_encoding_of_last16bits MzI0Mgo=
(integer) 1
redis 127.0.0.1:6379> SADD base64_encoding_of_last16bits MzI0Mgo=
(integer) 0
使用起来也比较简单,有一些逻辑简单的函数就略去实现了:
package main

import (
    "fmt"
    "os"
    "time"

    "github.com/sony/sonyflake"
)

func getMachineID() (uint16, error) {
    var machineID uint16
    var err error
    machineID = readMachineIDFromLocalFile()
    if machineID == 0 {
        machineID, err = generateMachineID()
        if err != nil {
            return 0, err
        }
    }

    return machineID, nil
}

func checkMachineID(machineID uint16) bool {
    saddResult, err := saddMachineIDToRedisSet()
    if err != nil || saddResult == 0 {
        return true
    }

    err := saveMachineIDToLocalFile(machineID)
    if err != nil {
        return true
    }

    return false
}

func main() {
    t, _ := time.Parse("2006-01-02", "2018-01-01")
    settings := sonyflake.Settings{
        StartTime:      t,
        MachineID:      getMachineID,
        CheckMachineID: checkMachineID,
    }

    sf := sonyflake.NewSonyflake(settings)
    id, err := sf.NextID()
    if err != nil {
        fmt.Println(err)
        os.Exit(1)
    }

    fmt.Println(id)
}
分布式锁
在单机程序并发或并行修改全局变量时,需要对修改行为加锁以创造临界区。为什么需要加锁呢?我们看看在不加锁的情况下并发计数会发生什么情况:
package main

import (
    "sync"
)

// 全局变量
var counter int

func main() {
    var wg sync.WaitGroup
    for i := 0; i < 1000; i++ {
        wg.Add(1)
        go func() {
        defer wg.Done()
            counter++
        }()
    }

    wg.Wait()
    println(counter)
}
多次运行会得到不同的结果:
❯❯❯ go run local_lock.go
945
❯❯❯ go run local_lock.go
937
❯❯❯ go run local_lock.go
959
6.2.1 进程内加锁
想要得到正确的结果的话,要把对计数器(counter)的操作代码部分加上锁:
// ... 省略之前部分
var wg sync.WaitGroup
var l sync.Mutex
for i := 0; i < 1000; i++ {
    wg.Add(1)
    go func() {
        defer wg.Done()
        l.Lock()
        counter++
        l.Unlock()
    }()
}

wg.Wait()
println(counter)
// ... 省略之后部分
这样就可以稳定地得到计算结果了:
❯❯❯ go run local_lock.go
1000
6.2.2 trylock
在某些场景,我们只是希望一个任务有单一的执行者。而不像计数器场景一样,所有 goroutine 都执行成功。后来的 goroutine 在抢锁失败后,需要放弃其流程。这时候就需要 trylock 了。
trylock 顾名思义,尝试加锁,加锁成功执行后续流程,如果加锁失败的话也不会阻塞,而会直接返回加锁的结果。在 Go 语言中我们可以用大小为 1 的 Channel 来模拟 trylock:
package main

import (
    "sync"
)

// Lock try lock
type Lock struct {
    c chan struct{}
}

// NewLock generate a try lock
func NewLock() Lock {
    var l Lock
    l.c = make(chan struct{}, 1)
    l.c <- struct{}{}
    return l
}

// Lock try lock, return lock result
func (l Lock) Lock() bool {
    lockResult := false
    select {
    case <-l.c:
        lockResult = true
    default:
    }
    return lockResult
}

// Unlock , Unlock the try lock
func (l Lock) Unlock() {
    l.c <- struct{}{}
}

var counter int

func main() {
    var l = NewLock()
    var wg sync.WaitGroup
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            if !l.Lock() {
                // log error
                println("lock failed")
                return
            }
            counter++
            println("current counter", counter)
            l.Unlock()
        }()
    }
    wg.Wait()
}
因为我们的逻辑限定每个 goroutine 只有成功执行了 Lock 才会继续执行后续逻辑,因此在 Unlock 时可以保证 Lock 结构体中的 channel 一定是空,从而不会阻塞,也不会失败。上面的代码使用了大小为 1 的 channel 来模拟 trylock,理论上还可以使用标准库中的 CAS 来实现相同的功能且成本更低,读者可以自行尝试。
在单机系统中,trylock 并不是一个好选择。因为大量的 goroutine 抢锁可能会导致 CPU 无意义的资源浪费。有一个专有名词用来描述这种抢锁的场景:活锁。
活锁指的是程序看起来在正常执行,但 CPU 周期被浪费在抢锁,而非执行任务上,从而程序整体的执行效率低下。活锁的问题定位起来要麻烦很多。所以在单机场景下,不建议使用这种锁。
6.2.3 基于 Redis 的 setnx
在分布式场景下,我们也需要这种 “抢占” 的逻辑,这时候怎么办呢?我们可以使用 Redis 提供的 setnx 命令:
package main

import (
    "fmt"
    "sync"
    "time"

    "github.com/go-redis/redis"
)

func incr() {
    client := redis.NewClient(&redis.Options{
        Addr:     "localhost:6379",
        Password: "", // no password set
        DB:       0,  // use default DB
    })

    var lockKey = "counter_lock"
    var counterKey = "counter"

    // lock
    resp := client.SetNX(lockKey, 1, time.Second*5)
    lockSuccess, err := resp.Result()

    if err != nil || !lockSuccess {
        fmt.Println(err, "lock result:", lockSuccess)
        return
    }

    // counter ++
    getResp := client.Get(counterKey)
    cntValue, err := getResp.Int64()
    if err == nil || err == redis.Nil {
        cntValue++
        resp := client.Set(counterKey, cntValue, 0)
        _, err := resp.Result()
        if err != nil {
            // log err
            println("set value error!")
        }
    }
    println("current counter is", cntValue)

    delResp := client.Del(lockKey)
    unlockSuccess, err := delResp.Result()
    if err == nil && unlockSuccess > 0 {
        println("unlock success!")
    } else {
        println("unlock failed", err)
    }
}

func main() {
    var wg sync.WaitGroup
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            incr()
        }()
    }
    wg.Wait()
}
看看运行结果:
❯❯❯ go run redis_setnx.go
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
<nil> lock result:  false
current counter is  2028
unlock success!
通过代码和执行结果可以看到,我们远程调用 setnx 运行流程上和单机的 trylock 非常相似,如果获取锁失败,那么相关的任务逻辑就不应该继续向前执行。
setnx 很适合在高并发场景下,用来争抢一些 “唯一” 的资源。比如交易撮合系统中卖家发起订单,而多个买家会对其进行并发争抢。这种场景我们没有办法依赖具体的时间来判断先后,因为不管是用户设备的时间,还是分布式场景下的各台机器的时间,都是没有办法在合并后保证正确的时序的。哪怕是我们同一个机房的集群,不同的机器的系统时间可能也会有细微的差别。
所以,我们需要依赖于这些请求到达 Redis 节点的顺序来做正确的抢锁操作。如果用户的网络环境比较差,那也只能自求多福了。
6.2.4 基于 ZooKeeper
package main

import (
    "time"

    "github.com/samuel/go-zookeeper/zk"
)

func main() {
    c, _, err := zk.Connect([]string{"127.0.0.1"}, time.Second) //*10)
    if err != nil {
        panic(err)
    }
    l := zk.NewLock(c, "/lock", zk.WorldACL(zk.PermAll))
    err = l.Lock()
    if err != nil {
        panic(err)
    }
    println("lock succ, do your business logic")

    time.Sleep(time.Second * 10)

    // do some thing
    l.Unlock()
    println("unlock succ, finish business logic")
}
基于 ZooKeeper 的锁与基于 Redis 的锁的不同之处在于 Lock 成功之前会一直阻塞,这与我们单机场景中的 mutex.Lock 很相似。
其原理也是基于临时 Sequence 节点和 watch API,例如我们这里使用的是 /lock 节点。Lock 会在该节点下的节点列表中插入自己的值,只要节点下的子节点发生变化,就会通知所有 watch 该节点的程序。这时候程序会检查当前节点下最小的子节点的 id 是否与自己的一致。如果一致,说明加锁成功了。
这种分布式的阻塞锁比较适合分布式任务调度场景,但不适合高频次持锁时间短的抢锁场景。按照 Google 的 Chubby 论文里的阐述,基于强一致协议的锁适用于 粗粒度 的加锁操作。这里的粗粒度指锁占用时间较长。我们在使用时也应思考在自己的业务场景中使用是否合适。
6.2.5 基于 etcd
etcd 是分布式系统中,功能上与 ZooKeeper 类似的组件,这两年越来越火了。上面基于 ZooKeeper 我们实现了分布式阻塞锁,基于 etcd,也可以实现类似的功能:
package main

import (
    "log"

    "github.com/zieckey/etcdsync"
)

func main() {
    m, err := etcdsync.New("/lock", 10, []string{"http://127.0.0.1:2379"})
    if m == nil || err != nil {
        log.Printf("etcdsync.New failed")
        return
    }
    err = m.Lock()
    if err != nil {
        log.Printf("etcdsync.Lock failed")
        return
    }

    log.Printf("etcdsync.Lock OK")
    log.Printf("Get the lock. Do something here.")

    err = m.Unlock()
    if err != nil {
        log.Printf("etcdsync.Unlock failed")
    } else {
        log.Printf("etcdsync.Unlock OK")
    }
}
etcd 中没有像 ZooKeeper 那样的 Sequence 节点。所以其锁实现和基于 ZooKeeper 实现的有所不同。在上述示例代码中使用的 etcdsync 的 Lock 流程是:
- 先检查
/lock路径下是否有值,如果有值,说明锁已经被别人抢了 - 如果没有值,那么写入自己的值。写入成功返回,说明加锁成功。写入时如果节点被其它节点写入过了,那么会导致加锁失败,这时候到 3
- watch
/lock下的事件,此时陷入阻塞 - 当
/lock路径下发生事件时,当前进程被唤醒。检查发生的事件是否是删除事件(说明锁被持有者主动 unlock),或者过期事件(说明锁过期失效)。如果是的话,那么回到 1,走抢锁流程。
值得一提的是,在 etcdv3 的 API 中官方已经提供了可以直接使用的锁 API,读者可以查阅 etcd 的文档做进一步的学习。
6.2.7 如何选择合适的锁
业务还在单机就可以搞定的量级时,那么按照需求使用任意的单机锁方案就可以。
如果发展到了分布式服务阶段,但业务规模不大,qps 很小的情况下,使用哪种锁方案都差不多。如果公司内已有可以使用的 ZooKeeper、etcd 或者 Redis 集群,那么就尽量在不引入新的技术栈的情况下满足业务需求。
业务发展到一定量级的话,就需要从多方面来考虑了。首先是你的锁是否在任何恶劣的条件下都不允许数据丢失,如果不允许,那么就不要使用 Redis 的 setnx 的简单锁。
对锁数据的可靠性要求极高的话,那只能使用 etcd 或者 ZooKeeper 这种通过一致性协议保证数据可靠性的锁方案。但可靠的背面往往都是较低的吞吐量和较高的延迟。需要根据业务的量级对其进行压力测试,以确保分布式锁所使用的 etcd 或 ZooKeeper 集群可以承受得住实际的业务请求压力。需要注意的是,etcd 和 Zookeeper 集群是没有办法通过增加节点来提高其性能的。要对其进行横向扩展,只能增加搭建多个集群来支持更多的请求。这会进一步提高对运维和监控的要求。多个集群可能需要引入 proxy,没有 proxy 那就需要业务去根据某个业务 id 来做分片。如果业务已经上线的情况下做扩展,还要考虑数据的动态迁移。这些都不是容易的事情。
在选择具体的方案时,还是需要多加思考,对风险早做预估。
延时任务系统
我们在做系统时,很多时候是处理实时的任务,请求来了马上就处理,然后立刻给用户以反馈。但有时也会遇到非实时的任务,比如确定的时间点发布重要公告。或者需要在用户做了一件事情的 X 分钟 / Y 小时后,对其特定动作,比如通知、发券等等。
如果业务规模比较小,有时我们也可以通过数据库配合轮询来对这种任务进行简单处理,但上了规模的公司,自然会寻找更为普适的解决方案来解决这一类问题。
一般有两种思路来解决这个问题:
- 实现一套类似 crontab 的分布式定时任务管理系统。
- 实现一个支持定时发送消息的消息队列。
两种思路进而衍生出了一些不同的系统,但其本质是差不多的。都是需要实现一个定时器(timer)。在单机的场景下定时器其实并不少见,例如我们在和网络库打交道的时候经常会调用 SetReadDeadline() 函数,就是在本地创建了一个定时器,在到达指定的时间后,我们会收到定时器的通知,告诉我们时间已到。这时候如果读取还没有完成的话,就可以认为发生了网络问题,从而中断读取。
下面我们从定时器开始,探究延时任务系统的实现。
6.3.1 定时器的实现
定时器(timer)的实现在工业界已经是有解的问题了。常见的就是时间堆和时间轮。
6.3.1.1 时间堆
最常见的时间堆一般用小顶堆实现,小顶堆其实就是一种特殊的二叉树,见 图 6-4
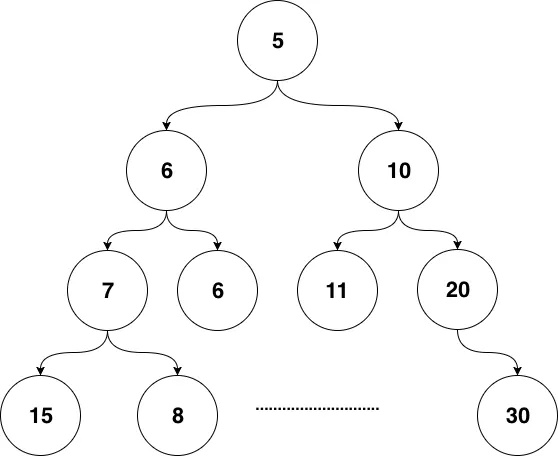
图 6-4 二叉堆结构
小顶堆的好处是什么呢?对于定时器来说,如果堆顶元素比当前的时间还要大,那么说明堆内所有元素都比当前时间大。进而说明这个时刻我们还没有必要对时间堆进行任何处理。定时检查的时间复杂度是 O(1)。
当我们发现堆顶的元素小于当前时间时,那么说明可能已经有一批事件已经开始过期了,这时进行正常的弹出和堆调整操作就好。每一次堆调整的时间复杂度都是 O(LgN)。
Go 自身的内置定时器就是用时间堆来实现的,不过并没有使用二叉堆,而是使用了扁平一些的四叉堆。在最近的版本中,还加了一些优化,我们先不说优化,先来看看四叉的小顶堆长什么样:
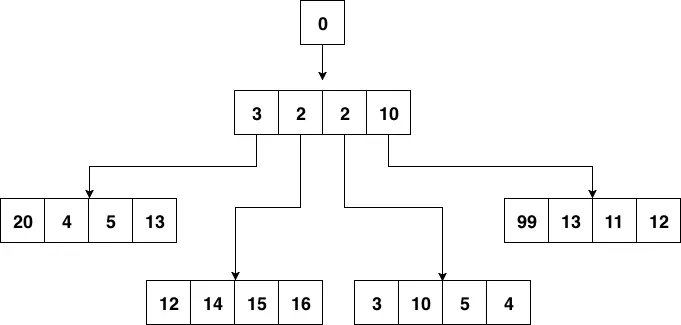
图 6-5 四叉堆结构
小顶堆的性质,父节点比其 4 个子节点都小,子节点之间没有特别的大小关系要求。
四叉堆中元素超时和堆调整与二叉堆没有什么本质区别。
6.3.1.2 时间轮
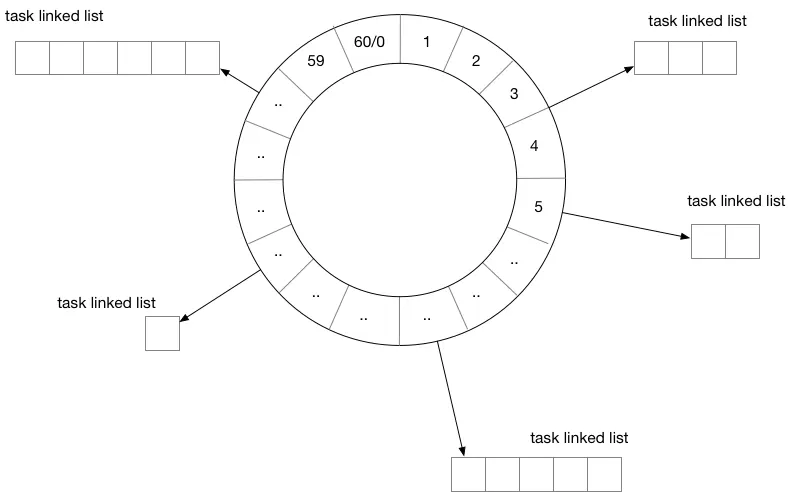
图 6-6 时间轮
用时间轮来实现定时器时,我们需要定义每一个格子的 “刻度”,可以将时间轮想像成一个时钟,中心有秒针顺时针转动。每次转动到一个刻度时,我们就需要去查看该刻度挂载的任务列表是否有已经到期的任务。
从结构上来讲,时间轮和哈希表很相似,如果我们把哈希算法定义为:触发时间 % 时间轮元素大小。那么这就是一个简单的哈希表。在哈希冲突时,采用链表挂载哈希冲突的定时器。
除了这种单层时间轮,业界也有一些时间轮采用多层实现,这里就不再赘述了。
6.3.2 任务分发
有了基本的定时器实现方案,如果我们开发的是单机系统,那么就可以撸起袖子开干了,不过本章我们讨论的是分布式,距离 “分布式” 还稍微有一些距离。
我们还需要把这些 “定时” 或是“延时”(本质也是定时)任务分发出去。下面是一种思路:
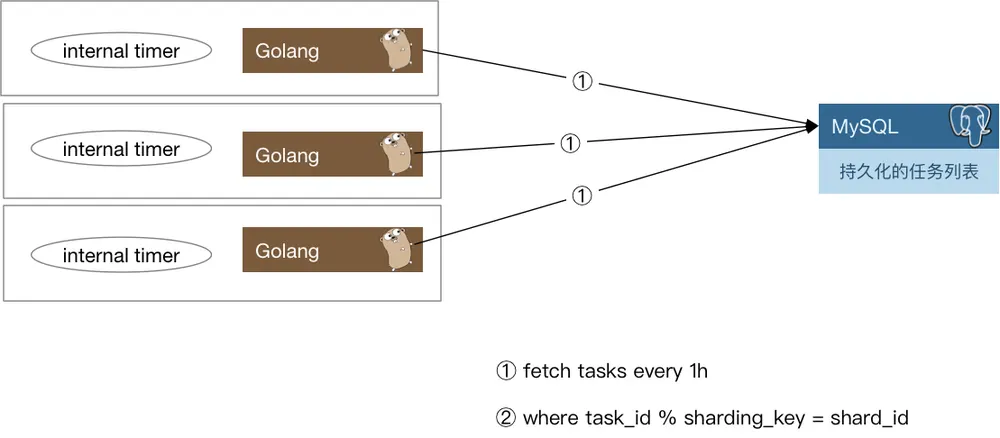
图 6-7 分布式任务分发
每一个实例每隔一小时,会去数据库里把下一个小时需要处理的定时任务捞出来,捞取的时候只要取那些 task_id % shard_count = shard_id 的那些任务即可。
当这些定时任务被触发之后需要通知用户侧,有两种思路:
- 将任务被触发的信息封装为一条消息,发往消息队列,由用户侧对消息队列进行监听。
- 对用户预先配置的回调函数进行调用。
两种方案各有优缺点,如果采用 1,那么如果消息队列出故障会导致整个系统不可用,当然,现在的消息队列一般也会有自身的高可用方案,大多数时候我们不用担心这个问题。其次一般业务流程中间走消息队列的话会导致延时增加,定时任务若必须在触发后的几十毫秒到几百毫秒内完成,那么采用消息队列就会有一定的风险。如果采用 2,会加重定时任务系统的负担。我们知道,单机的定时器执行时最害怕的就是回调函数执行时间过长,这样会阻塞后续的任务执行。在分布式场景下,这种忧虑依然是适用的。一个不负责任的业务回调可能就会直接拖垮整个定时任务系统。所以我们还要考虑在回调的基础上增加经过测试的超时时间设置,并且对由用户填入的超时时间做慎重的审核。
6.3.3 数据再平衡和幂等考量
当我们的任务执行集群有机器故障时,需要对任务进行重新分配。按照之前的求模策略,对这台机器还没有处理的任务进行重新分配就比较麻烦了。如果是实际运行的线上系统,还要在故障时的任务平衡方面花更多的心思。
下面给出一种思路:
我们可以参考 Elasticsearch 的数据分布设计,每份任务数据都有多个副本,这里假设两副本,如 图 6-8 所示:
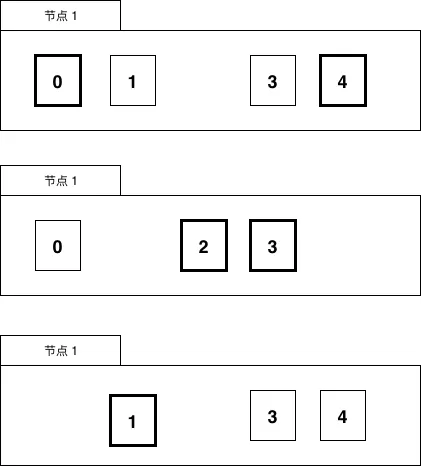
图 6-8 任务数据分布
一份数据虽然有两个持有者,但持有者持有的副本会进行区分,比如持有的是主副本还是非主副本,主副本在图中为摸黑部分,非主副本为正常线条。
一个任务只会在持有主副本的节点上被执行。
当有机器故障时,任务数据需要进行数据再平衡的工作,比如节点 1 挂了,见 图 6-9。
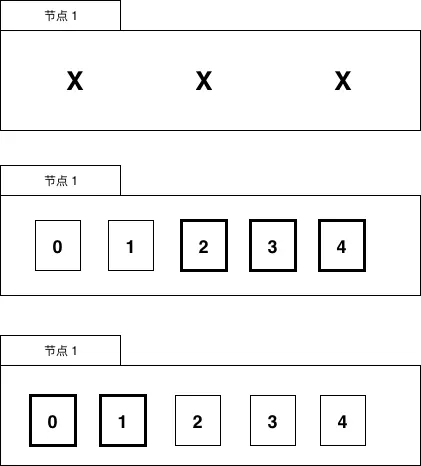
图 6-9 故障时数据分布
节点 1 的数据会被迁移到节点 2 和节点 3 上。
当然,也可以用稍微复杂一些的思路,比如对集群中的节点进行角色划分,由协调节点来做这种故障时的任务重新分配工作,考虑到高可用,协调节点可能也需要有 1 至 2 个备用节点以防不测。
之前提到我们会用消息队列触发对用户的通知,在使用消息队列时,很多队列是不支持 exactly once 的语义的,这种情况下我们需要让用户自己来负责消息的去重或者消费的幂等处理。
分布式搜索引擎
在 Web 一章中,我们提到 MySQL 很脆弱。数据库系统本身要保证实时和强一致性,所以其功能设计上都是为了满足这种一致性需求。比如 write ahead log 的设计,基于 B + 树实现的索引和数据组织,以及基于 MVCC 实现的事务等等。
关系型数据库一般被用于实现 OLTP 系统,所谓 OLTP,援引 wikipedia:
在线交易处理(OLTP, Online transaction processing)是指透过信息系统、电脑网络及数据库,以线上交易的方式处理一般即时性的作业数据,和更早期传统数据库系统大量批量的作业方式并不相同。OLTP 通常被运用于自动化的数据处理工作,如订单输入、金融业务… 等反复性的日常性交易活动。和其相对的是属于决策分析层次的联机分析处理(OLAP)。
在互联网的业务场景中,也有一些实时性要求不高 (可以接受多秒的延迟),但是查询复杂性却很高的场景。举个例子,在电商的 WMS 系统中,或者在大多数业务场景丰富的 CRM 或者客服系统中,可能需要提供几十个字段的随意组合查询功能。这种系统的数据维度天生众多,比如一个电商的 WMS 中对一件货物的描述,可能有下面这些字段:
仓库 id,入库时间,库位分区 id,储存货架 id,入库操作员 id,出库操作员 id,库存数量,过期时间,SKU 类型,产品品牌,产品分类,内件数量
除了上述信息,如果商品在仓库内有流转。可能还有有关联的流程 id,当前的流转状态等等。
想像一下,如果我们所经营的是一个大型电商,每天有千万级别的订单,那么在这个数据库中查询和建立合适的索引都是一件非常难的事情。
在 CRM 或客服类系统中,常常有根据关键字进行搜索的需求,大型互联网公司每天会接收数以万计的用户投诉。而考虑到事件溯源,用户的投诉至少要存 2~3 年。又是千万级甚至上亿的数据。根据关键字进行一次 like 查询,可能整个 MySQL 就直接挂掉了。
这时候我们就需要搜索引擎来救场了。
搜索引擎
Elasticsearch 是开源分布式搜索引擎的霸主,其依赖于 Lucene 实现,在部署和运维方面做了很多优化。当今搭建一个分布式搜索引擎比起 Sphinx 的时代已经是容易很多很多了。只要简单配置客户端 IP 和端口就可以了。
倒排列表
虽然 es 是针对搜索场景来定制的,但如前文所言,实际应用中常常用 es 来作为 database 来使用,就是因为倒排列表的特性。可以用比较朴素的观点来理解倒排索引:
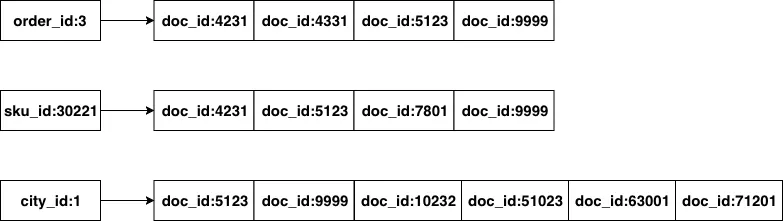
图 6-10 倒排列表
对 Elasticsearch 中的数据进行查询时,本质就是求多个排好序的序列求交集。非数值类型字段涉及到分词问题,大多数内部使用场景下,我们可以直接使用默认的 bi-gram 分词。什么是 bi-gram 分词呢:
即将所有 Ti 和 T(i+1) 组成一个词(在 Elasticsearch 中叫 term),然后再编排其倒排列表,这样我们的倒排列表大概就是这样的:
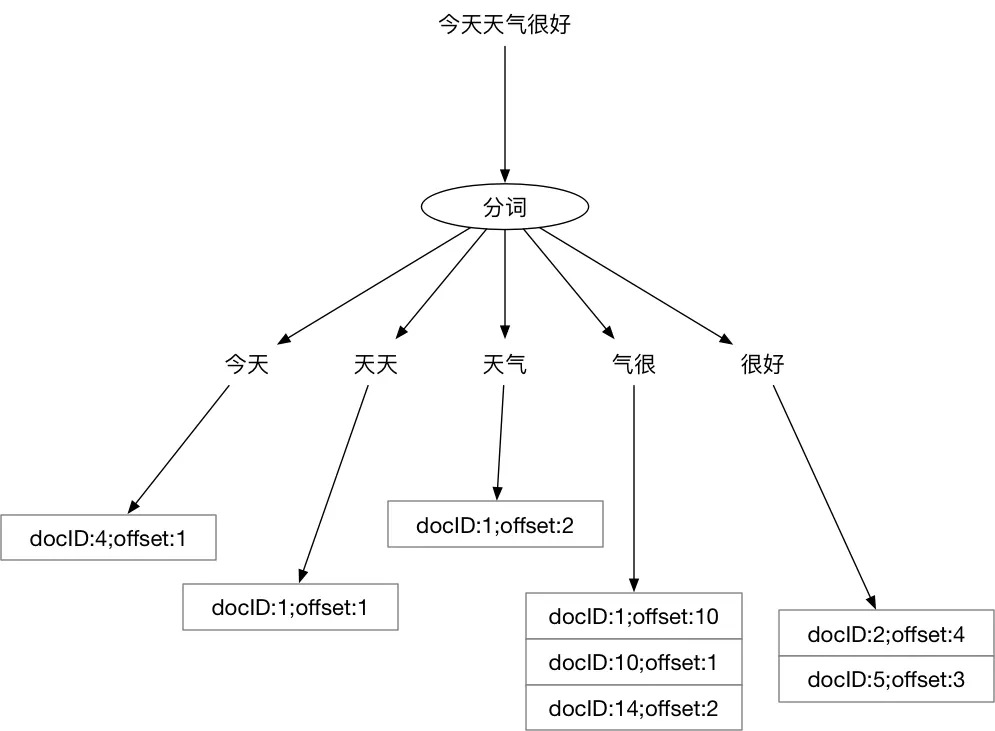
图 6-11 “今天天气很好” 的分词结果
当用户搜索'天气很好'时,其实就是求:天气、气很、很好三组倒排列表的交集,但这里的相等判断逻辑有些特殊,用伪代码表示一下:
func equal() {
    if postEntry.docID of '天气' == postEntry.docID of '气很' &&
        postEntry.offset + 1 of '天气' == postEntry.offset of '气很' {
            return true
    }

    if postEntry.docID of '气很' == postEntry.docID of '很好' &&
        postEntry.offset + 1 of '气很' == postEntry.offset of '很好' {
        return true
    }

    if postEntry.docID of '天气' == postEntry.docID of '很好' &&
        postEntry.offset + 2 of '天气' == postEntry.offset of '很好' {
        return true
    }

    return false
}多个有序列表求交集的时间复杂度是:O(N*M),N 为给定列表当中元素数最小的集合,M 为给定列表的个数。
在整个算法中起决定作用的一是最短的倒排列表的长度,其次是词数总和,一般词数不会很大(想像一下,你会在搜索引擎里输入几百字来搜索么?),所以起决定性作用的,一般是所有倒排列表中,最短的那一个的长度。
因此,文档总数很多的情况下,搜索词的倒排列表最短的那一个不长时,搜索速度也是很快的。如果用关系型数据库,那就需要按照索引(如果有的话)来慢慢扫描了。
查询 DSL
es 定义了一套查询 DSL,当我们把 es 当数据库使用时,需要用到其 bool 查询。举个例子:
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "field_1": {
              "query": "1",
              "type": "phrase"
            }
          }
        },
        {
          "match": {
            "field_2": {
              "query": "2",
              "type": "phrase"
            }
          }
        },
        {
          "match": {
            "field_3": {
              "query": "3",
              "type": "phrase"
            }
          }
        },
        {
          "match": {
            "field_4": {
              "query": "4",
              "type": "phrase"
            }
          }
        }
      ]
    }
  },
  "from": 0,
  "size": 1
}
看起来比较麻烦,但表达的意思很简单:
if field_1 == 1 && field_2 == 2 && field_3 == 3 && field_4 == 4 {
    return true
}
用 bool should query 可以表示 or 的逻辑:
{
  "query": {
    "bool": {
      "should": [
        {
          "match": {
            "field_1": {
              "query": "1",
              "type": "phrase"
            }
          }
        },
        {
          "match": {
            "field_2": {
              "query": "2",
              "type": "phrase"
            }
          }
        }
      ]
    }
  },
  "from": 0,
  "size": 1
}
这里表示的是类似:
if field_1 == 1 || field_2 == 2 {
    return true
}
这些 Go 代码里 if 后面跟着的表达式在编程语言中有专有名词来表达 Boolean Expression:
4 > 1
5 == 2
3 <i && x> 10
es 的 Bool Query 方案,就是用 json 来表达了这种程序语言中的 Boolean Expression,为什么可以这么做呢?因为 json 本身是可以表达树形结构的,我们的程序代码在被编译器 parse 之后,也会变成 AST,而 AST 抽象语法树,顾名思义,就是树形结构。理论上 json 能够完备地表达一段程序代码被 parse 之后的结果。这里的 Boolean Expression 被编译器 Parse 之后也会生成差不多的树形结构,而且只是整个编译器实现的一个很小的子集。
基于 client SDK 做开发
初始化:
// 选用 elastic 版本时
// 注意与自己使用的 elasticsearch 要对应
import (
    elastic "gopkg.in/olivere/elastic.v3"
)

var esClient *elastic.Client

func initElasticsearchClient(host string, port string) {
    var err error
    esClient, err = elastic.NewClient(
        elastic.SetURL(fmt.Sprintf("http://%s:%s", host, port)),
        elastic.SetMaxRetries(3),
    )

    if err != nil {
        // log error
    }
}
插入:
func insertDocument(db string, table string, obj map[string]interface{}) {

    id := obj["id"]

    var indexName, typeName string
    // 数据库中的 database/table 概念,可以简单映射到 es 的 index 和 type
    // 不过需要注意,因为 es 中的 _type 本质上只是 document 的一个字段
    // 所以单个 index 内容过多会导致性能问题
    // 在新版本中 type 已经废弃
    // 为了让不同表的数据落入不同的 index,这里我们用 table+name 作为 index 的名字
    indexName = fmt.Sprintf("%v_%v", db, table)
    typeName = table

    // 正常情况
    res, err := esClient.Index().Index(indexName).Type(typeName).Id(id).BodyJson(obj).Do()
    if err != nil {
        // handle error
    } else {
        // insert success
    }
}
获取:
func query(indexName string, typeName string) (*elastic.SearchResult, error) {
    // 通过 bool must 和 bool should 添加 bool 查询条件
    q := elastic.NewBoolQuery().Must(elastic.NewMatchPhraseQuery("id", 1),
    elastic.NewBoolQuery().Must(elastic.NewMatchPhraseQuery("male", "m")))

    q = q.Should(
        elastic.NewMatchPhraseQuery("name", "alex"),
        elastic.NewMatchPhraseQuery("name", "xargin"),
    )

    searchService := esClient.Search(indexName).Type(typeName)
    res, err := searchService.Query(q).Do()
    if err != nil {
        // log error
        return nil, err
    }

    return res, nil
}
删除:
func deleteDocument(
    indexName string, typeName string, obj map[string]interface{},
) {
    id := obj["id"]

    res, err := esClient.Delete().Index(indexName).Type(typeName).Id(id).Do()
    if err != nil {
        // handle error
    } else {
        // delete success
    }
}
因为 Lucene 的性质,本质上搜索引擎内的数据是不可变的,所以如果要对文档进行更新,Lucene 内部是按照 id 进行完全覆盖 (本质是取同一 id 最新的 segment 中的数据) 的操作,所以与插入的情况是一样的。
使用 es 作为数据库使用时,需要注意,因为 es 有索引合并的操作,所以数据插入到 es 中到可以查询的到需要一段时间(由 es 的 refresh_interval 决定)。所以千万不要把 es 当成强一致的关系型数据库来使用。
将 sql 转换为 DSL
比如我们有一段 bool 表达式,user_id = 1 and (product_id = 1 and (star_num = 4 or star_num = 5) and banned = 1),写成 SQL 是如下形式:
select * from xxx where user_id = 1 and (
    product_id = 1 and (star_num = 4 or star_num = 5) and banned = 1
)
写成 es 的 DSL 是如下形式:
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "user_id": {
              "query": "1",
              "type": "phrase"
            }
          }
        },
        {
          "match": {
            "product_id": {
              "query": "1",
              "type": "phrase"
            }
          }
        },
        {
          "bool": {
            "should": [
              {
                "match": {
                  "star_num": {
                    "query": "4",
                    "type": "phrase"
                  }
                }
              },
              {
                "match": {
                  "star_num": {
                    "query": "5",
                    "type": "phrase"
                  }
                }
              }
            ]
          }
        },
        {
          "match": {
            "banned": {
              "query": "1",
              "type": "phrase"
            }
          }
        }
      ]
    }
  },
  "from": 0,
  "size": 1
}
es 的 DSL 虽然很好理解,但是手写起来非常费劲。前面提供了基于 SDK 的方式来写,但也不足够灵活。
SQL 的 where 部分就是 boolean expression。我们之前提到过,这种 bool 表达式在被解析之后,和 es 的 DSL 的结构长得差不多,我们能不能直接通过这种 “差不多” 的猜测来直接帮我们把 SQL 转换成 DSL 呢?
当然可以,我们把 SQL 的 where 被 Parse 之后的结构和 es 的 DSL 的结构做个对比:
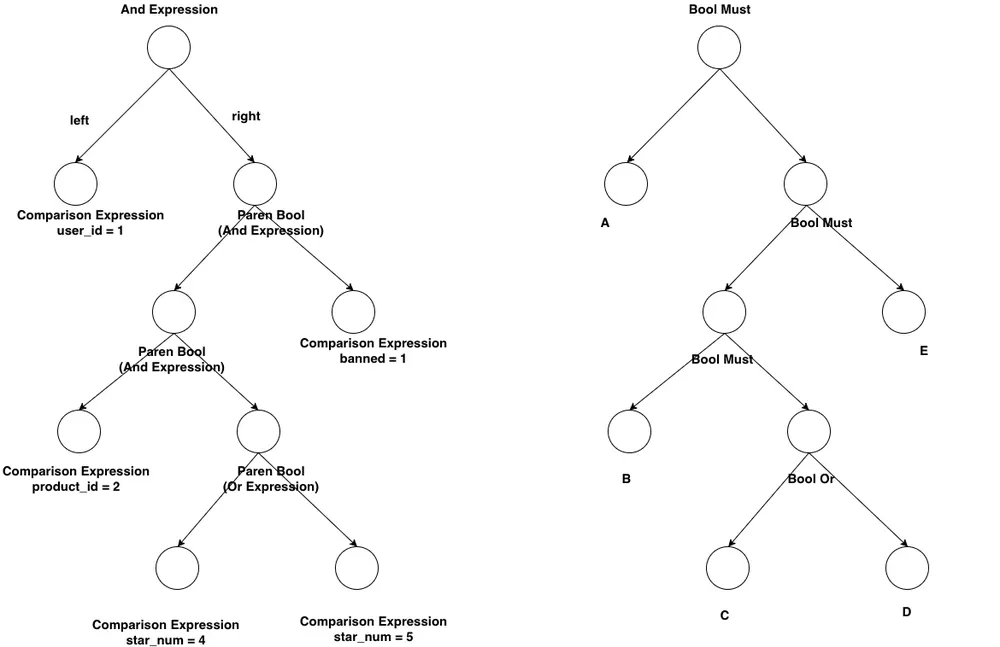
图 6-12 AST 和 DSL 之间的对应关系
既然结构上完全一致,逻辑上我们就可以相互转换。我们以广度优先对 AST 树进行遍历,然后将二元表达式转换成 json 字符串,再拼装起来就可以了,限于篇幅,本文中就不给出示例了,读者朋友可以查看:
github.com/cch123/elasticsql
来学习具体的实现。
异构数据同步
在实际应用中,我们很少直接向搜索引擎中写入数据。更为常见的方式是,将 MySQL 或其它关系型数据中的数据同步到搜索引擎中。而搜索引擎的使用方只能对数据进行查询,无法进行修改和删除。
常见的同步方案有两种:
通过时间戳进行增量数据同步
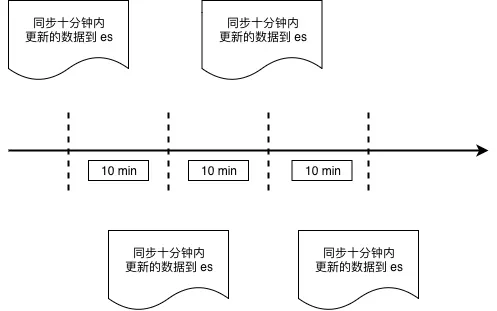
图 6-13 基于时间戳的数据同步
这种同步方式与业务强绑定,例如 WMS 系统中的出库单,我们并不需要非常实时,稍微有延迟也可以接受,那么我们可以每分钟从 MySQL 的出库单表中,把最近十分钟创建的所有出库单取出,批量存入 es 中,取数据的操作需要执行的逻辑可以表达为下面的 SQL:
select * from wms_orders where update_time >= date_sub(now(), interval 10 minute);当然,考虑到边界情况,我们可以让这个时间段的数据与前一次的有一些重叠:
select * from wms_orders where update_time >= date_sub(
    now(), interval 11 minute
);
取最近 11 分钟有变动的数据覆盖更新到 es 中。这种方案的缺点显而易见,我们必须要求业务数据严格遵守一定的规范。比如这里的,必须要有 update_time 字段,并且每次创建和更新都要保证该字段有正确的时间值。否则我们的同步逻辑就会丢失数据。
通过 binlog 进行数据同步
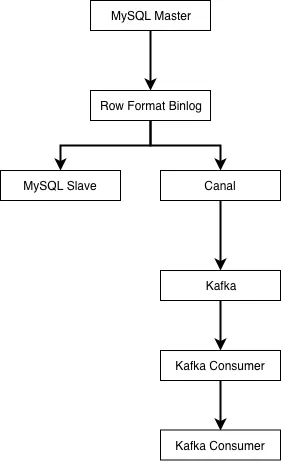
图 6-13 基于 binlog 的数据同步
业界使用较多的是阿里开源的 Canal,来进行 binlog 解析与同步。canal 会伪装成 MySQL 的从库,然后解析好行格式的 binlog,再以更容易解析的格式(例如 json)发送到消息队列。
由下游的 Kafka 消费者负责把上游数据表的自增主键作为 es 的文档的 id 进行写入,这样可以保证每次接收到 binlog 时,对应 id 的数据都被覆盖更新为最新。MySQL 的 Row 格式的 binlog 会将每条记录的所有字段都提供给下游,所以在向异构数据目标同步数据时,不需要考虑数据是插入还是更新,只要一律按 id 进行覆盖即可。
这种模式同样需要业务遵守一条数据表规范,即表中必须有唯一主键 id 来保证我们进入 es 的数据不会发生重复。一旦不遵守该规范,那么就会在同步时导致数据重复。当然,你也可以为每一张需要的表去定制消费者的逻辑,这就不是通用系统讨论的范畴了。
负载均衡
本节将会讨论常见的分布式系统负载均衡手段。
6.5.1 常见的负载均衡思路
如果我们不考虑均衡的话,现在有 n 个服务节点,我们完成业务流程只需要从这 n 个中挑出其中的一个。有几种思路:
- 按顺序挑: 例如上次选了第一台,那么这次就选第二台,下次第三台,如果已经到了最后一台,那么下一次从第一台开始。这种情况下我们可以把服务节点信息都存储在数组中,每次请求完成下游之后,将一个索引后移即可。在移到尽头时再移回数组开头处。
- 随机挑一个: 每次都随机挑,真随机伪随机均可。假设选择第 x 台机器,那么 x 可描述为
rand.Intn()%n。 - 根据某种权重,对下游节点进行排序,选择权重最大或最小的那一个。
当然了,实际场景我们不可能无脑轮询或者无脑随机,如果对下游请求失败了,我们还需要某种机制来进行重试,如果纯粹的随机算法,存在一定的可能性使你在下一次仍然随机到这次的问题节点。
我们来看一个生产环境的负载均衡案例。
6.5.2 基于洗牌算法的负载均衡
考虑到我们需要随机选取每次发送请求的节点,同时在遇到下游返回错误时换其它节点重试。所以我们设计一个大小和节点数组大小一致的索引数组,每次来新的请求,我们对索引数组做洗牌,然后取第一个元素作为选中的服务节点,如果请求失败,那么选择下一个节点重试,以此类推:
var endpoints = []string {
    "100.69.62.1:3232",
    "100.69.62.32:3232",
    "100.69.62.42:3232",
    "100.69.62.81:3232",
    "100.69.62.11:3232",
    "100.69.62.113:3232",
    "100.69.62.101:3232",
}

// 重点在这个 shuffle
func shuffle(slice []int) {
    for i := 0; i <len(slice); i++ {
        a := rand.Intn(len(slice))
        b := rand.Intn(len(slice))
        slice[a], slice[b] = slice[b], slice[a]
    }
}

func request(params map[string]interface{}) error {
    var indexes = []int {0,1,2,3,4,5,6}
    var err error

    shuffle(indexes)
    maxRetryTimes := 3

    idx := 0
    for i := 0; i < maxRetryTimes; i++ {
        err = apiRequest(params, endpoints[idx])
        if err == nil {
            break
        }
        idx++
    }

    if err != nil {
        // logging
        return err
    }

    return nil
}
我们循环一遍 slice,两两交换,这个和我们平常打牌时常用的洗牌方法类似。看起来没有什么问题。
6.5.2.1 错误的洗牌导致的负载不均衡
真的没有问题么?还是有问题的。这段简短的程序里有两个隐藏的隐患:
- 没有随机种子。在没有随机种子的情况下,
rand.Intn()返回的伪随机数序列是固定的。 - 洗牌不均匀,会导致整个数组第一个节点有大概率被选中,并且多个节点的负载分布不均衡。
第一点比较简单,应该不用在这里给出证明了。关于第二点,我们可以用概率知识来简单证明一下。假设每次挑选都是真随机,我们假设第一个位置的节点在 len(slice) 次交换中都不被选中的概率是 ((6/7)*(6/7))^7≈0.34。而分布均匀的情况下,我们肯定希望被第一个元素在任意位置上分布的概率均等,所以其被随机选到的概率应该约等于 1/7≈0.14。
显然,这里给出的洗牌算法对于任意位置的元素来说,有 30% 的概率不对其进行交换操作。所以所有元素都倾向于留在原来的位置。因为我们每次对 shuffle 数组输入的都是同一个序列,所以第一个元素有更大的概率会被选中。在负载均衡的场景下,也就意味着节点数组中的第一台机器负载会比其它机器高不少 (这里至少是 3 倍以上)。
6.5.2.2 修正洗牌算法
从数学上得到过证明的还是经典的 fisher-yates 算法,主要思路为每次随机挑选一个值,放在数组末尾。然后在 n-1 个元素的数组中再随机挑选一个值,放在数组末尾,以此类推。
func shuffle(indexes []int) {
    for i:=len(indexes); i>0; i-- {
        lastIdx := i - 1
        idx := rand.Int(i)
        indexes[lastIdx], indexes[idx] = indexes[idx], indexes[lastIdx]
    }
}
在 Go 的标准库中已经为我们内置了该算法:
func shuffle(n int) []int {
    b := rand.Perm(n)
    return b
}
在当前的场景下,我们只要用 rand.Perm 就可以得到我们想要的索引数组了。
6.5.3 ZooKeeper 集群的随机节点挑选问题
本节中的场景是从 N 个节点中选择一个节点发送请求,初始请求结束之后,后续的请求会重新对数组洗牌,所以每两个请求之间没有什么关联关系。因此我们上面的洗牌算法,理论上不初始化随机库的种子也是不会出什么问题的。
但在一些特殊的场景下,例如使用 ZooKeeper 时,客户端初始化从多个服务节点中挑选一个节点后,是会向该节点建立长连接的。之后客户端请求都会发往该节点去。直到该节点不可用,才会在节点列表中挑选下一个节点。在这种场景下,我们的初始连接节点选择就要求必须是 “真” 随机了。否则,所有客户端起动时,都会去连接同一个 ZooKeeper 的实例,根本无法起到负载均衡的目的。如果在日常开发中,你的业务也是类似的场景,也务必考虑一下是否会发生类似的情况。为 rand 库设置种子的方法:
rand.Seed(time.Now().UnixNano())之所以会有上面这些结论,是因为某个使用较广泛的开源 ZooKeeper 库的早期版本就犯了上述错误,直到 2016 年早些时候,这个问题才被修正。
6.5.4 负载均衡算法效果验证
我们这里不考虑加权负载均衡的情况,既然名字是负载 “均衡”。那么最重要的就是均衡。我们把开篇中的 shuffle 算法,和之后的 fisher yates 算法的结果进行简单地对比:
package main

import (
    "fmt"
    "math/rand"
    "time"
)

func init() {
    rand.Seed(time.Now().UnixNano())
}

func shuffle1(slice []int) {
    for i := 0; i <len(slice); i++ {
        a := rand.Intn(len(slice))
        b := rand.Intn(len(slice))
        slice[a], slice[b] = slice[b], slice[a]
    }
}

func shuffle2(indexes []int) {
    for i := len(indexes); i > 0; i-- {
        lastIdx := i - 1
        idx := rand.Intn(i)
        indexes[lastIdx], indexes[idx] = indexes[idx], indexes[lastIdx]
    }
}

func main() {
    var cnt1 = map[int]int{}
    for i := 0; i < 1000000; i++ {
        var sl = []int{0, 1, 2, 3, 4, 5, 6}
        shuffle1(sl)
        cnt1[sl[0]]++
    }

    var cnt2 = map[int]int{}
    for i := 0; i < 1000000; i++ {
        var sl = []int{0, 1, 2, 3, 4, 5, 6}
        shuffle2(sl)
        cnt2[sl[0]]++
    }

    fmt.Println(cnt1, "\n", cnt2)
}
输出:
map[0:224436 1:128780 5:129310 6:129194 2:129643 3:129384 4:129253]
map[6:143275 5:143054 3:143584 2:143031 1:141898 0:142631 4:142527]
分布结果和我们推导出的结论是一致的。
分布式配置管理
在分布式系统中,常困扰我们的还有上线问题。虽然目前有一些优雅重启方案,但实际应用中可能受限于我们系统内部的运行情况而没有办法做到真正的 “优雅”。比如我们为了对去下游的流量进行限制,在内存中堆积一些数据,并对堆积设定时间或总量的阈值。在任意阈值达到之后将数据统一发送给下游,以避免频繁的请求超出下游的承载能力而将下游打垮。这种情况下重启要做到优雅就比较难了。
所以我们的目标还是尽量避免采用或者绕过上线的方式,对线上程序做一些修改。比较典型的修改内容就是程序的配置项。
6.6.1 场景举例
6.6.1.1 报表系统
在一些偏 OLAP 或者离线的数据平台中,经过长期的迭代开发,整个系统的功能模块已经渐渐稳定。可变动的项只出现在数据层,而数据层的变动大多可以认为是 SQL 的变动,架构师们自然而然地会想着把这些变动项抽离到系统外部。比如本节所述的配置管理系统。
当业务提出了新的需求时,我们的需求是将新的 SQL 录入到系统内部,或者简单修改一下老的 SQL。不对系统进行上线,就可以直接完成这些修改。
6.6.1.2 业务配置
大公司的平台部门服务众多业务线,在平台内为各业务线分配唯一 id。平台本身也由多个模块构成,这些模块需要共享相同的业务线定义(要不然就乱套了)。当公司新开产品线时,需要能够在短时间内打通所有平台系统的流程。这时候每个系统都走上线流程肯定是来不及的。另外需要对这种公共配置进行统一管理,同时对其增减逻辑也做统一管理。这些信息变更时,需要自动通知到业务方的系统,而不需要人力介入(或者只需要很简单的介入,比如点击审核通过)。
除业务线管理之外,很多互联网公司会按照城市来铺展自己的业务。在某个城市未开城之前,理论上所有模块都应该认为带有该城市 id 的数据是脏数据并自动过滤掉。而如果业务开城,在系统中就应该自己把这个新的城市 id 自动加入到白名单中。这样业务流程便可以自动运转。
再举个例子,互联网公司的运营系统中会有各种类型的运营活动,有些运营活动推出后可能出现了超出预期的事件(比如公关危机),需要紧急将系统下线。这时候会用到一些开关来快速关闭相应的功能。或者快速将想要剔除的活动 id 从白名单中剔除。在 Web 章节中的 AB 测试一节中,我们也提到,有时需要有这样的系统来告诉我们当前需要放多少流量到相应的功能代码上。我们可以像那一节中,使用远程 RPC 来获知这些信息,但同时,也可以结合分布式配置系统,主动地拉取到这些信息。
6.6.2 使用 etcd 实现配置更新
我们使用 etcd 实现一个简单的配置读取和动态更新流程,以此来了解线上的配置更新流程。
6.6.2.1 配置定义
简单的配置,可以将内容完全存储在 etcd 中。比如:
etcdctl get /configs/remote_config.json
{
    "addr" : "127.0.0.1:1080",
    "aes_key" : "01B345B7A9ABC00F0123456789ABCDAF",
    "https" : false,
    "secret" : "",
    "private_key_path" : "",
    "cert_file_path" : ""
}
6.6.2.2 新建 etcd client
cfg := client.Config{
    Endpoints:               []string{"http://127.0.0.1:2379"},
    Transport:               client.DefaultTransport,
    HeaderTimeoutPerRequest: time.Second,
}
直接用 etcd client 包中的结构体初始化,没什么可说的。
6.6.2.3 配置获取
resp, err = kapi.Get(context.Background(), "/path/to/your/config", nil)
if err != nil {
    log.Fatal(err)
} else {
    log.Printf("Get is done. Metadata is %q\n", resp)
    log.Printf("%q key has %q value\n", resp.Node.Key, resp.Node.Value)
}
获取配置使用 etcd KeysAPI 的 Get() 方法,比较简单。
6.6.2.4 配置更新订阅
kapi := client.NewKeysAPI(c)
w := kapi.Watcher("/path/to/your/config", nil)
go func() {
    for {
        resp, err := w.Next(context.Background())
        log.Println(resp, err)
        log.Println("new values is", resp.Node.Value)
    }
}()
通过订阅 config 路径的变动事件,在该路径下内容发生变化时,客户端侧可以收到变动通知,并收到变动后的字符串值。
6.6.2.5 整合起来
package main

import (
    "log"
    "time"

    "golang.org/x/net/context"
    "github.com/coreos/etcd/client"
)

var configPath =  `/configs/remote_config.json`
var kapi client.KeysAPI

type ConfigStruct struct {
    Addr           string `json:"addr"`
    AesKey         string `json:"aes_key"`
    HTTPS          bool   `json:"https"`
    Secret         string `json:"secret"`
    PrivateKeyPath string `json:"private_key_path"`
    CertFilePath   string `json:"cert_file_path"`
}

var appConfig ConfigStruct

func init() {
    cfg := client.Config{
        Endpoints:               []string{"http://127.0.0.1:2379"},
        Transport:               client.DefaultTransport,
        HeaderTimeoutPerRequest: time.Second,
    }

    c, err := client.New(cfg)
    if err != nil {
        log.Fatal(err)
    }
    kapi = client.NewKeysAPI(c)
    initConfig()
}

func watchAndUpdate() {
    w := kapi.Watcher(configPath, nil)
    go func() {
        // watch 该节点下的每次变化
        for {
            resp, err := w.Next(context.Background())
            if err != nil {
                log.Fatal(err)
            }
            log.Println("new values is", resp.Node.Value)

            err = json.Unmarshal([]byte(resp.Node.Value), &appConfig)
            if err != nil {
                log.Fatal(err)
            }
        }
    }()
}

func initConfig() {
    resp, err = kapi.Get(context.Background(), configPath, nil)
    if err != nil {
        log.Fatal(err)
    }

    err := json.Unmarshal(resp.Node.Value, &appConfig)
    if err != nil {
        log.Fatal(err)
    }
}

func getConfig() ConfigStruct {
    return appConfig
}

func main() {
    // init your app
}
如果业务规模不大,使用本节中的例子就可以实现功能了。
这里只需要注意一点,我们在更新配置时,进行了一系列操作:watch 响应,json 解析,这些操作都不具备原子性。当单个业务请求流程中多次获取 config 时,有可能因为中途 config 发生变化而导致单个请求前后逻辑不一致。因此,在使用类似这样的方式来更新配置时,需要在单个请求的生命周期内使用同样的配置。具体实现方式可以是只在请求开始的时候获取一次配置,然后依次向下透传等等,具体情况具体分析。
6.6.3 配置膨胀
随着业务的发展,配置系统本身所承载的压力可能也会越来越大,配置文件可能成千上万。客户端同样上万,将配置内容存储在 etcd 内部便不再合适了。随着配置文件数量的膨胀,除了存储系统本身的吞吐量问题,还有配置信息的管理问题。我们需要对相应的配置进行权限管理,需要根据业务量进行配置存储的集群划分。如果客户端太多,导致了配置存储系统无法承受瞬时大量的 QPS,那可能还需要在客户端侧进行缓存优化,等等。
这也就是为什么大公司都会针对自己的业务额外开发一套复杂配置系统的原因。
6.6.4 配置版本管理
在配置管理过程中,难免出现用户误操作的情况,例如在更新配置时,输入了无法解析的配置。这种情况下我们可以通过配置校验来解决。
有时错误的配置可能不是格式上有问题,而是在逻辑上有问题。比如我们写 SQL 时少 select 了一个字段,更新配置时,不小心丢掉了 json 字符串中的一个 field 而导致程序无法理解新的配置而进入诡异的逻辑。为了快速止损,最快且最有效的办法就是进行版本管理,并支持按版本回滚。
在配置进行更新时,我们要为每份配置的新内容赋予一个版本号,并将修改前的内容和版本号记录下来,当发现新配置出问题时,能够及时地回滚回来。
常见的做法是,使用 MySQL 来存储配置文件或配置字符串的不同版本内容,在需要回滚时,只要进行简单的查询即可。
6.6.5 客户端容错
在业务系统的配置被剥离到配置中心之后,并不意味着我们的系统可以高枕无忧了。当配置中心本身宕机时,我们也需要一定的容错能力,至少保证在其宕机期间,业务依然可以运转。这要求我们的系统能够在配置中心宕机时,也能拿到需要的配置信息。哪怕这些信息不够新。
具体来讲,在给业务提供配置读取的 SDK 时,最好能够将拿到的配置在业务机器的磁盘上也缓存一份。这样远程配置中心不可用时,可以直接用硬盘上的内容来做兜底。当重新连接上配置中心时,再把相应的内容进行更新。
加入缓存之后务必需要考虑的是数据一致性问题,当个别业务机器因为网络错误而与其它机器配置不一致时,我们也应该能够从监控系统中知晓。
我们使用一种手段解决了我们配置更新痛点,但同时可能因为使用的手段而带给我们新的问题。实际开发中,我们要对每一步决策多多思考,以使自己不在问题到来时手足无措。
分布式爬虫
互联网时代的信息爆炸是很多人倍感头痛的问题,应接不暇的新闻、信息、视频,无孔不入地侵占着我们的碎片时间。但另一方面,在我们真正需要数据的时候,却感觉数据并不是那么容易获取的。比如我们想要分析现在人在讨论些什么,关心些什么。甚至有时候,可能我们只是暂时没有时间去一一阅览心仪的小说,但又想能用技术手段把它们存在自己的资料库里。哪怕是几个月或一年后再来回顾。再或者我们想要把互联网上这些稍纵即逝的有用信息保存起来,例如某个非常小的论坛中聚集的同好们的高质量讨论,在未来某个时刻,即使这些小众的聚集区无以为继时,依然能让我们从硬盘中翻出当初珍贵的观点来。
除去情怀需求,互联网上有大量珍贵的开放资料,近年来深度学习如雨后春笋一般火热起来,但机器学习很多时候并不是苦于我的模型是否建立得合适,我的参数是否调整得正确,而是苦于最初的起步阶段:没有数据。
作为收集数据的前置工作,有能力去写一个简单的或者复杂的爬虫,对于我们来说依然非常重要。
6.7.1 基于 colly 的单机爬虫
《Go 语言编程》一书给出了简单的爬虫示例,经过了多年的发展,现在使用 Go 语言写一个网站的爬虫要更加方便,比如用 colly 来实现爬取某网站(虚拟站点,这里用 abcdefg 作为占位符)在 Go 语言标签下的前十页内容:
package main

import (
    "fmt"
    "regexp"
    "time"

    "github.com/gocolly/colly"
)

var visited = map[string]bool{}

func main() {
    // Instantiate default collector
    c := colly.NewCollector(
        colly.AllowedDomains("www.abcdefg.com"),
        colly.MaxDepth(1),
    )

    // 我们认为匹配该模式的是该网站的详情页
    detailRegex, _ := regexp.Compile(`/go/go\?p=\d+$`)
    // 匹配下面模式的是该网站的列表页
    listRegex, _ := regexp.Compile(`/t/\d+#\w+`)

    // 所有 a 标签,上设置回调函数
    c.OnHTML("a[href]", func(e *colly.HTMLElement) {
        link := e.Attr("href")

        // 已访问过的详情页或列表页,跳过
        if visited[link] && (detailRegex.Match([]byte(link)) || listRegex.Match([]byte(link))) {
            return
        }

        // 既不是列表页,也不是详情页
        // 那么不是我们关心的内容,要跳过
        if !detailRegex.Match([]byte(link)) && !listRegex.Match([]byte(link)) {
            println("not match", link)
            return
        }

        // 因为大多数网站有反爬虫策略
        // 所以爬虫逻辑中应该有 sleep 逻辑以避免被封杀
        time.Sleep(time.Second)
        println("match", link)

        visited[link] = true

        time.Sleep(time.Millisecond * 2)
        c.Visit(e.Request.AbsoluteURL(link))
    })

    err := c.Visit("https://www.abcdefg.com/go/go")
    if err != nil {fmt.Println(err)}
}
6.7.2 分布式爬虫
想像一下,你们的信息分析系统运行非常之快。获取信息的速度成为了瓶颈,虽然可以用上 Go 语言所有优秀的并发特性,将单机的 CPU 和网络带宽都用满,但还是希望能够加快爬虫的爬取速度。在很多场景下,速度是有意义的:
- 对于价格战期间的电商们来说,希望能够在对手价格变动后第一时间获取到其最新价格,再靠机器自动调整本家的商品价格。
- 对于类似头条之类的 Feed 流业务,信息的时效性也非常重要。如果我们慢吞吞地爬到的新闻是昨天的新闻,那对于用户来说就没有任何意义。
所以我们需要分布式爬虫。从本质上来讲,分布式爬虫是一套任务分发和执行系统。而常见的任务分发,因为上下游存在速度不匹配问题,必然要借助消息队列。
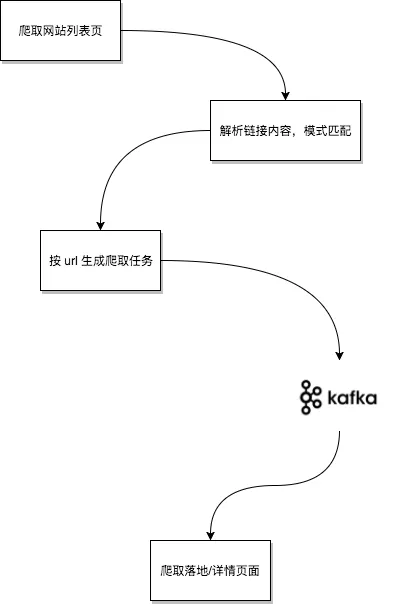
图 6-14 爬虫工作流程
上游的主要工作是根据预先配置好的起点来爬取所有的目标 “列表页”,列表页的 html 内容中会包含有所有详情页的链接。详情页的数量一般是列表页的 10 到 100 倍,所以我们将这些详情页链接作为“任务” 内容,通过消息队列分发出去。
针对页面爬取来说,在执行时是否偶尔会有重复其实不太重要,因为任务结果是幂等的(这里我们只爬页面内容,不考虑评论部分)。
本节我们来简单实现一个基于消息队列的爬虫,本节我们使用 nats 来做任务分发。实际开发中,应该针对自己的业务对消息本身的可靠性要求和公司的基础架构组件情况进行选型。
6.7.2.1 nats 简介
nats 是 Go 实现的一个高性能分布式消息队列,适用于高并发高吞吐量的消息分发场景。早期的 nats 以速度为重,没有支持持久化。从 16 年开始,nats 通过 nats-streaming 支持基于日志的持久化,以及可靠的消息传输。为了演示方便,我们本节中只使用 nats。
nats 的服务端项目是 gnatsd,客户端与 gnatsd 的通信方式为基于 tcp 的文本协议,非常简单:
向 subject 为 task 发消息:
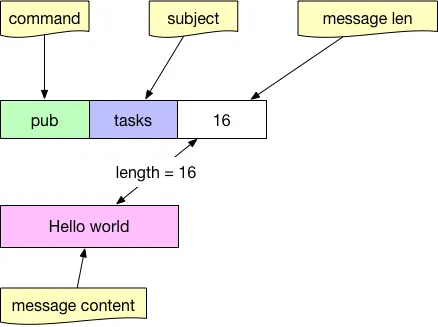
图 6-15 nats 协议中的 pub
以 workers 的 queue 从 tasks subject 订阅消息:
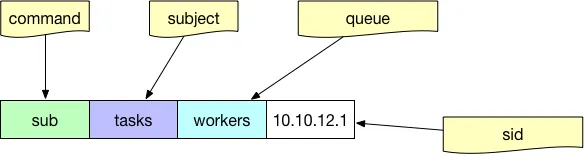
图 6-16 nats 协议中的 sub
其中的 queue 参数是可选的,如果希望在分布式的消费端进行任务的负载均衡,而不是所有人都收到同样的消息,那么就要给消费端指定相同的 queue 名字。
基本消息生产
生产消息只要指定 subject 即可:
nc, err := nats.Connect(nats.DefaultURL)
if err != nil {return}

// 指定 subject 为 tasks,消息内容随意
err = nc.Publish("tasks", []byte("your task content"))

nc.Flush()
基本消息消费
直接使用 nats 的 subscribe API 并不能达到任务分发的目的,因为 pub sub 本身是广播性质的。所有消费者都会收到完全一样的所有消息。
除了普通的 subscribe 之外,nats 还提供了 queue subscribe 的功能。只要提供一个 queue group 名字(类似 Kafka 中的 consumer group),即可均衡地将任务分发给消费者。
nc, err := nats.Connect(nats.DefaultURL)
if err != nil {return}

// queue subscribe 相当于在消费者之间进行任务分发的分支均衡
// 前提是所有消费者都使用 workers 这个 queue
// nats 中的 queue 概念上类似于 Kafka 中的 consumer group
sub, err := nc.QueueSubscribeSync("tasks", "workers")
if err != nil {return}

var msg *nats.Msg
for {
    msg, err = sub.NextMsg(time.Hour * 10000)
    if err != nil {break}
    // 正确地消费到了消息
    // 可用 nats.Msg 对象处理任务
}
6.7.3 结合 nats 和 colly 的消息生产
我们为每一个网站定制一个对应的 collector,并设置相应的规则,比如 abcdefg,hijklmn(虚构的),再用简单的工厂方法来将该 collector 和其 host 对应起来,每个站点爬到列表页之后,需要在当前程序中把所有链接解析出来,并把落地页的 URL 发往消息队列。
package main

import (
    "fmt"
    "net/url"

    "github.com/gocolly/colly"
)

var domain2Collector = map[string]*colly.Collector{}
var nc *nats.Conn
var maxDepth = 10
var natsURL = "nats://localhost:4222"

func factory(urlStr string) *colly.Collector {
    u, _ := url.Parse(urlStr)
    return domain2Collector[u.Host]
}

func initABCDECollector() *colly.Collector {
    c := colly.NewCollector(
        colly.AllowedDomains("www.abcdefg.com"),
        colly.MaxDepth(maxDepth),
    )

    c.OnResponse(func(resp *colly.Response) {
        // 做一些爬完之后的善后工作
        // 比如页面已爬完的确认存进 MySQL
    })

    c.OnHTML("a[href]", func(e *colly.HTMLElement) {
        // 基本的反爬虫策略
        link := e.Attr("href")
        time.Sleep(time.Second * 2)

        // 正则 match 列表页的话,就 visit
        if listRegex.Match([]byte(link)) {
            c.Visit(e.Request.AbsoluteURL(link))
        }
        // 正则 match 落地页的话,就发消息队列
        if detailRegex.Match([]byte(link)) {
            err = nc.Publish("tasks", []byte(link))
            nc.Flush()
        }
    })
    return c
}

func initHIJKLCollector() *colly.Collector {
    c := colly.NewCollector(
        colly.AllowedDomains("www.hijklmn.com"),
        colly.MaxDepth(maxDepth),
    )

    c.OnHTML("a[href]", func(e *colly.HTMLElement) {
    })

    return c
}

func init() {
    domain2Collector["www.abcdefg.com"] = initABCDECollector()
    domain2Collector["www.hijklmn.com"] = initHIJKLCollector()
    var err error
    nc, err = nats.Connect(natsURL)
    if err != nil {os.Exit(1)}
}

func main() {
    urls := []string{"https://www.abcdefg.com", "https://www.hijklmn.com"}
    for _, url := range urls {
        instance := factory(url)
        instance.Visit(url)
    }
}
6.7.4 结合 colly 的消息消费
消费端就简单一些了,我们只需要订阅对应的主题,并直接访问网站的详情页 (落地页) 即可。
package main

import (
    "fmt"
    "net/url"

    "github.com/gocolly/colly"
)

var domain2Collector = map[string]*colly.Collector{}
var nc *nats.Conn
var maxDepth = 10
var natsURL = "nats://localhost:4222"

func factory(urlStr string) *colly.Collector {
    u, _ := url.Parse(urlStr)
    return domain2Collector[u.Host]
}

func initV2exCollector() *colly.Collector {
    c := colly.NewCollector(
        colly.AllowedDomains("www.abcdefg.com"),
        colly.MaxDepth(maxDepth),
    )
    return c
}

func initV2fxCollector() *colly.Collector {
    c := colly.NewCollector(
        colly.AllowedDomains("www.hijklmn.com"),
        colly.MaxDepth(maxDepth),
    )
    return c
}

func init() {
    domain2Collector["www.abcdefg.com"] = initV2exCollector()
    domain2Collector["www.hijklmn.com"] = initV2fxCollector()

    var err error
    nc, err = nats.Connect(natsURL)
    if err != nil {os.Exit(1)}
}

func startConsumer() {
    nc, err := nats.Connect(nats.DefaultURL)
    if err != nil {return}

    sub, err := nc.QueueSubscribeSync("tasks", "workers")
    if err != nil {return}

    var msg *nats.Msg
    for {
        msg, err = sub.NextMsg(time.Hour * 10000)
        if err != nil {break}

        urlStr := string(msg.Data)
        ins := factory(urlStr)
        // 因为最下游拿到的一定是对应网站的落地页
        // 所以不用进行多余的判断了,直接爬内容即可
        ins.Visit(urlStr)
        // 防止被封杀
        time.Sleep(time.Second)
    }
}

func main() {
    startConsumer()
}
从代码层面上来讲,这里的生产者和消费者其实本质上差不多。如果日后我们要灵活地支持增加、减少各种网站的爬取的话,应该思考如何将这些爬虫的策略、参数尽量地配置化。
在本章的分布式配置一节中已经讲了一些配置系统的使用,读者可以自行进行尝试,这里就不再赘述了。
补充说明
分布式是很大的领域,本章中的介绍只能算是对领域的管中窥豹。因为大型系统流量大,并发高,所以往往很多朴素的方案会变得难以满足需求。人们为了解决大型系统场景中的各种问题,而开发出了各式各样的分布式系统。有些系统非常简单,比如本章中介绍的分布式 id 生成器,而有一些系统则可能非常复杂,比如本章中的分布式搜索引擎(当然,本章中提到的 es 不是 Go 实现)。
无论简单的或是复杂的系统,都会在特定的场景中体现出它们重要的价值,希望读者朋友可以多多接触开源,积累自己的工具箱,从而站在巨人们的肩膀之上。