1 / 7
语言基础
Go语言创世纪
Go 语言最初由 Google 公司的 Robert Griesemer、Ken Thompson 和 Rob Pike 三个大牛于 2007 年开始设计发明,设计新语言的最初的洪荒之力来自于对超级复杂的 C++11 特性的吹捧报告的鄙视,最终的目标是设计网络和多核时代的 C 语言。到 2008 年中期,语言的大部分特性设计已经完成,并开始着手实现编译器和运行时,大约在这一年 Russ Cox 作为主力开发者加入。到了 2009 年,Go 语言已经逐步趋于稳定。同年 9 月,Go 语言正式发布并开源了代码。
Go 语言很多时候被描述为“类 C 语言”,或者是“21 世纪的 C 语言”。从各种角度看,Go 语言确实是从 C 语言继承了相似的表达式语法、控制流结构、基础数据类型、调用参数传值、指针等诸多编程思想,还有彻底继承和发扬了 C 语言简单直接的暴力编程哲学等。图1-1是《Go语言圣经》中给出的 Go 语言的基因图谱,我们可以从中看到有哪些编程语言对 Go 语言产生了影响。
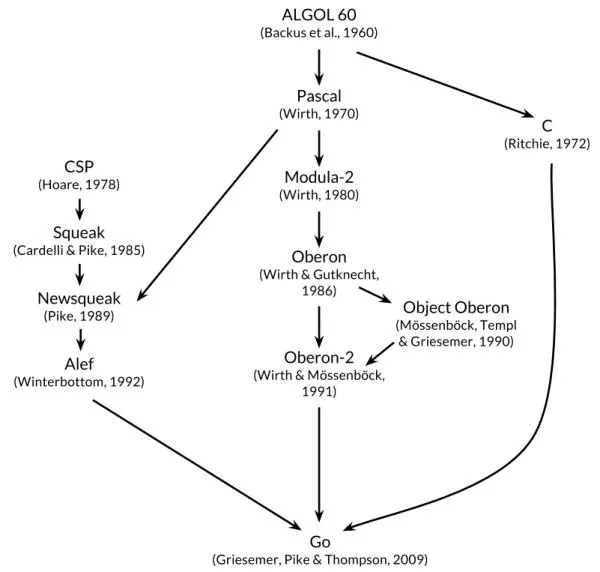
图 1-1 Go 语言基因族谱
首先看基因图谱的左边一支。可以明确看出 Go 语言的并发特性是由贝尔实验室的 Hoare 于 1978 年发布的 CSP 理论演化而来。其后,CSP 并发模型在 Squeak/NewSqueak 和 Alef 等编程语言中逐步完善并走向实际应用,最终这些设计经验被消化并吸收到了 Go 语言中。业界比较熟悉的 Erlang 编程语言的并发编程模型也是 CSP 理论的另一种实现。
再看基因图谱的中间一支。中间一支主要包含了 Go 语言中面向对象和包特性的演化历程。Go 语言中包和接口以及面向对象等特性则继承自 Niklaus Wirth 所设计的 Pascal 语言以及其后所衍生的相关编程语言。其中包的概念、包的导入和声明等语法主要来自于 Modula-2 编程语言,面向对象特性所提供的方法的声明语法等则来自于 Oberon 编程语言。最终 Go 语言演化出了自己特有的支持鸭子面向对象模型的隐式接口等诸多特性。
最后是基因图谱的右边一支,这是对 C 语言的致敬。Go 语言是对 C 语言最彻底的一次扬弃,不仅仅是语法和 C 语言有着很多差异,最重要的是舍弃了 C 语言中灵活但是危险的指针运算。而且,Go 语言还重新设计了 C 语言中部分不太合理运算符的优先级,并在很多细微的地方都做了必要的打磨和改变。当然,C 语言中少即是多、简单直接的暴力编程哲学则被 Go 语言更彻底地发扬光大了(Go 语言居然只有 25 个关键字,sepc 语言规范还不到 50 页)。
Go 语言其它的一些特性零散地来自于其他一些编程语言;比如 iota 语法是从 APL 语言借鉴,词法作用域与嵌套函数等特性来自于 Scheme 语言(和其他很多编程语言)。Go 语言中也有很多自己发明创新的设计。比如 Go 语言的切片为轻量级动态数组提供了有效的随机存取的性能,这可能会让人联想到链表的底层的共享机制。还有 Go 语言新发明的 defer 语句(Ken 发明)也是神来之笔。
1.1.1 来自贝尔实验室特有基因
作为 Go 语言标志性的并发编程特性则来自于贝尔实验室的 Tony Hoare 于 1978 年发表的鲜为外界所知的关于并发研究的基础文献:顺序通信进程(communicating sequential processes ,缩写为 CSP)。在最初的 CSP 论文中,程序只是一组没有中间共享状态的平行运行的处理过程,它们之间使用管道进行通信和控制同步。Tony Hoare 的 CSP 并发模型只是一个用于描述并发性基本概念的描述语言,它并不是一个可以编写可执行程序的通用编程语言。
CSP 并发模型最经典的实际应用是来自爱立信发明的 Erlang 编程语言。不过在 Erlang 将 CSP 理论作为并发编程模型的同时,同样来自贝尔实验室的 Rob Pike 以及其同事也在不断尝试将 CSP 并发模型引入当时的新发明的编程语言中。他们第一次尝试引入 CSP 并发特性的编程语言叫 Squeak(老鼠的叫声),是一个用于提供鼠标和键盘事件处理的编程语言,在这个语言中管道是静态创建的。然后是改进版的 Newsqueak 语言(新版老鼠的叫声),新提供了类似 C 语言语句和表达式的语法,还有类似 Pascal 语言的推导语法。Newsqueak 是一个带垃圾回收的纯函数式语言,它再次针对键盘、鼠标和窗口事件管理。但是在 Newsqueak 语言中管道已经是动态创建的,管道属于第一类值、可以保存到变量中。然后是 Alef 编程语言(Alef 也是 C 语言之父 Ritchie 比较喜爱的编程语言),Alef 语言试图将 Newsqueak 语言改造为系统编程语言,但是因为缺少垃圾回收机制而导致并发编程很痛苦(这也是继承 C 语言手工管理内存的代价)。在 Aelf 语言之后还有一个叫 Limbo 的编程语言(地狱的意思),这是一个运行在虚拟机中的脚本语言。Limbo 语言是 Go 语言最接近的祖先,它和 Go 语言有着最接近的语法。到设计 Go 语言时,Rob Pike 在 CSP 并发编程模型的实践道路上已经积累了几十年的经验,关于 Go 语言并发编程的特性完全是信手拈来,新编程语言的到来也是水到渠成了。
图1-2展示了 Go 语言库早期代码库日志可以看出最直接的演化历程(Git 用 git log --before={2008-03-03} --reverse 命令查看)。
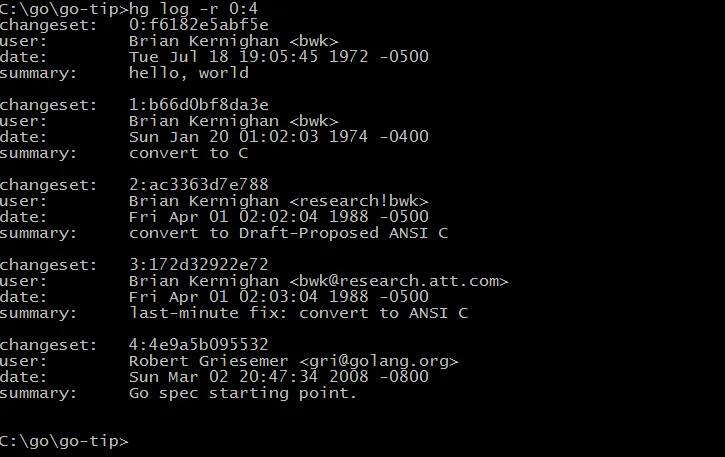
图 1-2 Go 语言开发日志
从早期提交日志中也可以看出,Go 语言是从 Ken Thompson 发明的 B 语言、Dennis M. Ritchie 发明的 C 语言逐步演化过来的,它首先是 C 语言家族的成员,因此很多人将 Go 语言称为 21 世纪的 C 语言。
图1-3是 Go 语言中来自贝尔实验室特有并发编程基因的演化过程:
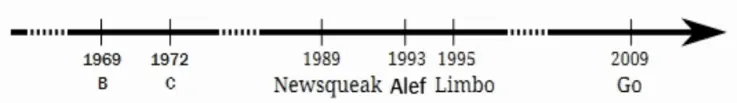
图 1-3 Go 语言并发演化历史
纵观整个贝尔实验室的编程语言的发展进程,从 B 语言、C 语言、Newsqueak、Alef、Limbo 语言一路走来,Go 语言继承了来着贝尔实验室的半个世纪的软件设计基因,终于完成了 C 语言革新的使命。纵观这几年来的发展趋势,Go 语言已经成为云计算、云存储时代最重要的基础编程语言。
1.1.2 你好, 世界
按照惯例,介绍所有编程语言的第一个程序都是“Hello, World!”。虽然本教假设读者已经了解了 Go 语言,但是我们还是不想打破这个惯例(因为这个传统正是从 Go 语言的前辈 C 语言传承而来的)。下面的代码展示的 Go 语言程序输出的是中文“你好, 世界!”。
package main

import "fmt"

func main() {
    fmt.Println("你好, 世界!")
}
将以上代码保存到 hello.go 文件中。因为代码中有非 ASCII 的中文字符,我们需要将文件的编码显式指定为无 BOM 的 UTF8 编码格式(源文件采用 UTF8 编码是 Go 语言规范所要求的)。然后进入命令行并切换到 hello.go 文件所在的目录。目前我们可以将 Go 语言当作脚本语言,在命令行中直接输入 go run hello.go 来运行程序。如果一切正常的话。应该可以在命令行看到输出 你好, 世界! 的结果。
现在,让我们简单介绍一下程序。所有的 Go 程序,都是由最基本的函数和变量构成,函数和变量被组织到一个个单独的 Go 源文件中,这些源文件再按照作者的意图组织成合适的 package,最终这些 package 再有机地组成一个完整的 Go 语言程序。其中,函数用于包含一系列的语句(指明要执行的操作序列),以及执行操作时存放数据的变量。我们这个程序中函数的名字是 main。虽然Go语言中,函数的名字没有太多的限制,但是 main 包中的 main 函数默认是每一个可执行程序的入口。而 package 则用于包装和组织相关的函数、变量和常量。在使用一个 package 之前,我们需要使用 import 语句导入包。例如,我们这个程序中导入了 fmt 包(fmt 是 format 单词的缩写,表示格式化相关的包),然后我们才可以使用 fmt 包中的 Println 函数。
而双引号包含的“你好, 世界!”则是 Go 语言的字符串面值常量。和 C 语言中的字符串不同,Go 语言中的字符串内容是不可变更的。在以字符串作为参数传递给 fmt.Println 函数时,字符串的内容并没有被复制——传递的仅仅是字符串的地址和长度(字符串的结构在 reflect.StringHeader 中定义)。在 Go 语言中,函数参数都是以复制的方式(不支持以引用的方式)传递(比较特殊的是,Go 语言闭包函数对外部变量是以引用的方式使用)。
Hello, World 的革命
在创世纪章节中我们简单介绍了 Go 语言的演化基因族谱,对其中来自于贝尔实验室的特有并发编程基因做了重点介绍,最后引出了 Go 语言版的“Hello, World”程序。其实“Hello, World”程序是展示各种语言特性的最好的例子,是通向该语言的一个窗口。这一节我们将沿着各个编程语言演化的时间轴,简单回顾下“Hello, World”程序是如何逐步演化到目前的 Go 语言形式、最终完成它的革命使命的。
图 1-4 Go 语言并发演化历史
1.2.1 B 语言 - Ken Thompson, 1972
首先是 B 语言,B 语言是 Go 语言之父贝尔实验室的 Ken Thompson 早年间开发的一种通用的程序设计语言,设计目的是为了用于辅助 UNIX 系统的开发。但是因为B语言缺乏灵活的类型系统导致使用比较困难。后来,Ken Thompson 的同事 Dennis Ritchie 以 B 语言为基础开发出了 C 语言,C 语言提供了丰富的类型,极大地增加了语言的表达能力。到目前为止它依然是世界上最常用的程序语言之一。而B语言自从被它取代之后,则就只存在于各种文献之中,成为了历史。
目前见到的 B 语言版本的“Hello World”,一般认为是来自于 Brian W. Kernighan 编写的 B 语言入门教程(Go 核心代码库中的第一个提交者名字正是 Brian W. Kernighan),程序如下:
main() {
    extrn a, b, c;
    putchar(a); putchar(b); putchar(c);
    putchar('!*n');
}
a 'hell';
b 'o, w';
c 'orld';
由于 B 语言缺乏灵活的数据类型,只能分别以 a、b、c 全局变量来定义要输出的内容,并且每个变量的长度必须对齐到了 4 个字节(有一种写汇编语言的感觉)。然后通过多次调用 putchar 函数输出字符,最后的 '!*n' 表示输出一个换行的意思。
总体来说,B 语言简单,功能也比较简陋。
1.2.2 C 语言 - Dennis Ritchie, 1974 ~ 1989
C 语言是由 Dennis Ritchie 在 B 语言的基础上改进而来,它增加了丰富的数据类型,并最终实现了用它重写 UNIX 的伟大目标。C 语言可以说是现代 IT 行业最重要的软件基石,目前主流的操作系统几乎全部是由 C 语言开发的,许多基础系统软件也是 C 语言开发的。C 系家族的编程语言占据统治地位达几十年之久,半个多世纪以来依然充满活力。
在 Brian W. Kernighan 于 1974 年左右编写的 C 语言入门教程中,出现了第一个 C 语言版本的“Hello World”程序。这给后来大部分编程语言教程都以“Hello World”为第一个程序提供了惯例。第一个 C 语言版本的“Hello World”程序如下:
main()
{
    printf("hello, world");
}
关于这个程序,有几点需要说明的:首先是 main 函数因为没有明确返回值类型,默认返回 int 类型;其次 printf 函数默认不需要导入函数声明即可以使用;最后 main 没有明确返回语句,但默认返回 0 值。在这个程序出现时,C 语言还远未标准化,我们看到的是上古时代的 C 语言语法:函数不用写返回值,函数参数也可以忽略,使用 printf 时不需要包含头文件等。
这个例子同样出现在了 1978 年出版的《C 程序设计语言》第一版中,作者正是 Brian W. Kernighan 和 Dennis M. Ritchie(简称 K&R)。书中的“Hello World”末尾增加了一个换行输出:
main()
{
    printf("hello, world\n");
}
这个例子在字符串末尾增加了一个换行,C 语言的 \n 换行比 B 语言的 '!*n' 换行看起来要简洁了一些。
在 K&R 的教程面世 10 年之后的 1988 年,《C 程序设计语言》第二版终于出版了。此时 ANSI C 语言的标准化草案已经初步完成,但正式版本的文档尚未发布。不过书中的“Hello World”程序根据新的规范增加了 #include <stdio.h> 头文件包含语句,用于包含printf函数的声明(新的 C89 标准中,仅仅是针对printf函数而言,依然可以不用声明函数而直接使用)。
#include <stdio.h>

main()
{
    printf("hello, world\n");
}
然后到了 1989 年,ANSI C 语言第一个国际标准发布,一般被称为 C89。C89 是流行最广泛的一个 C 语言标准,目前依然被大量使用。《C 程序设计语言》第二版的也再次印刷新版本,并针对新发布的 C89 规范建议,给 main 函数的参数增加了 void 输入参数说明,表示没有输入参数的意思。
#include <stdio.h>

main(void)
{
    printf("hello, world\n");
}
至此,C 语言本身的进化基本完成。后面的 C92、C99、C11 都只是针对一些语言细节做了完善。因为各种历史因素, C89 依然是使用最广泛的标准。
1.2.3 Newsqueak - Rob Pike, 1989
Newsqueak 是 Rob Pike 发明的老鼠语言的第二代,是他用于实践 CSP 并发编程模型的战场。Newsqueak 是新的 squeak 语言的意思,其中 squeak 是老鼠吱吱吱的叫声,也可以看作是类似鼠标点击的声音。Squeak 是一个提供鼠标和键盘事件处理的编程语言,Squeak语言的管道是静态创建的。改进版的 Newsqueak 语言则提供了类似 C 语言语句和表达式的语法和类似 Pascal 语言的推导语法。Newsqueak 是一个带自动垃圾回收的纯函数式语言,它再次针对键盘、鼠标和窗口事件管理。但是在 Newsqueak 语言中管道是动态创建的,属于第一类值,因此可以保存到变量中。
Newsqueak 类似脚本语言,内置了一个 print 函数,它的“Hello World”程序看不出什么特色:
print("Hello,", "World", "\n");从上面的程序中,除了猜测 print 函数可以支持多个参数外,我们很难看到 Newsqueak 语言相关的特性。由于 Newsqueak 语言和 Go 语言相关的特性主要是并发和管道。因此,我们这里通过一个并发版本的“素数筛”算法来略窥 Newsqueak 语言的特性。“素数筛”的原理如图:
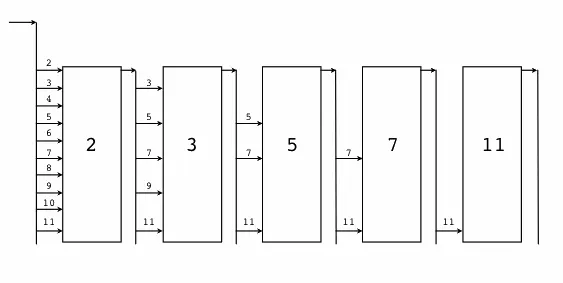
图 1-5 素数筛
Newsqueak 语言并发版本的“素数筛”程序如下:
// 向管道输出从 2 开始的自然数序列
counter := prog(c:chan of int) {
    i := 2;
    for(;;) {
        c <-= i++;
    }
};

// 针对 listen 管道获取的数列,过滤掉是 prime 倍数的数
// 新的序列输出到 send 管道
filter := prog(prime:int, listen, send:chan of int) {
    i:int;
    for(;;) {
        if((i = <-listen)%prime) {
            send <-= i;
        }
    }
};

// 主函数
// 每个管道第一个流出的数必然是素数
// 然后基于这个新的素数构建新的素数过滤器
sieve := prog() of chan of int {
    c := mk(chan of int);
    begin counter(c);
    prime := mk(chan of int);
    begin prog(){
        p:int;
        newc:chan of int;
        for(;;){
            prime <-= p =<- c;
            newc = mk();
            begin filter(p, c, newc);
            c = newc;
        }
    }();
    become prime;
};

// 启动素数筛
prime := sieve();
其中 counter 函数用于向管道输出原始的自然数序列,每个 filter 函数对象则对应每一个新的素数过滤管道,这些素数过滤管道根据当前的素数筛子将输入管道流入的数列筛选后重新输出到输出管道。mk(chan of int) 用于创建管道,类似 Go 语言的 make(chan int) 语句;begin filter(p, c, newc) 关键字启动素数筛的并发体,类似 Go 语言的 go filter(p, c, newc) 语句;become 用于返回函数结果,类似 return 语句。
Newsqueak 语言中并发体和管道的语法和 Go 语言已经比较接近了,后置的类型声明和 Go 语言的语法也很相似。
1.2.4 Alef - Phil Winterbottom, 1993
在 Go 语言出现之前,Alef 语言是作者心中比较完美的并发语言,Alef 语法和运行时基本是无缝兼容 C 语言。Alef 语言中的对线程和进程的并发体都提供了支持,其中 proc receive(c) 用于启动一个进程,task receive(c) 用于启动一个线程,它们之间通过管道 c 进行通讯。不过由于 Alef 缺乏内存自动回收机制,导致并发体的内存资源管理异常复杂。而且 Alef 语言只在 Plan9 系统中提供过短暂的支持,其它操作系统并没有实际可以运行的 Alef 开发环境。而且 Alef 语言只有《Alef 语言规范》和《Alef 编程向导》两个公开的文档,因此在贝尔实验室之外关于 Alef 语言的讨论并不多。
由于 Alef 语言同时支持进程和线程并发体,而且在并发体中可以再次启动更多的并发体,导致了 Alef 的并发状态会异常复杂。同时 Alef 没有自动垃圾回收机制(Alef 因为保留的 C 语言灵活的指针特性,也导致了自动垃圾回收机制实现比较困难),各种资源充斥于不同的线程和进程之间,导致并发体的内存资源管理异常复杂。Alef 语言全部继承了 C 语言的语法,可以认为是增强了并发语法的 C 语言。下图是 Alef 语言文档中展示的一个可能的并发体状态:
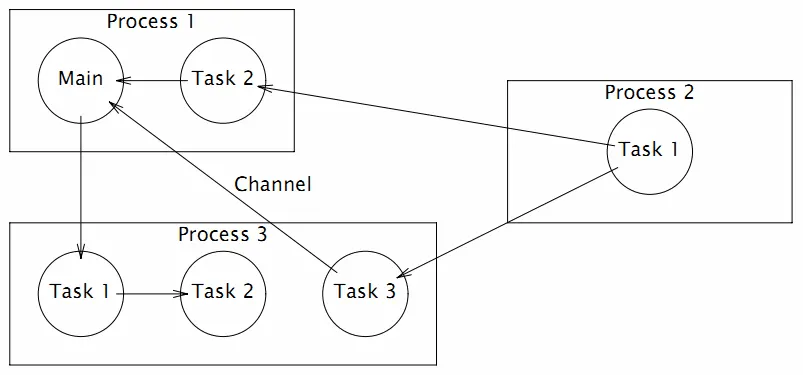
图 1-6 Alef 并发模型
Alef 语言并发版本的“Hello World”程序如下:
#include <alef.h>

void receive(chan(byte*) c) {
    byte *s;
    s = <- c;
    print("%s\n", s);
    terminate(nil);
}

void main(void) {
    chan(byte*) c;
    alloc c;
    proc receive(c);
    task receive(c);
    c <- = "hello proc or task";
    c <- = "hello proc or task";
    print("done\n");
    terminate(nil);
}
程序开头的 #include <alef.h> 语句用于包含 Alef 语言的运行时库。receive 是一个普通函数,程序中用作每个并发体的入口函数;main 函数中的 alloc c 语句先创建一个 chan(byte*) 类型的管道,类似 Go 语言的 make(chan []byte) 语句;然后分别以进程和线程的方式启动 receive 函数;启动并发体之后,main 函数向 c 管道发送了两个字符串数据; 而进程和线程状态运行的 receive 函数会以不确定的顺序先后从管道收到数据后,然后分别打印字符串;最后每个并发体都通过调用 terminate(nil) 来结束自己。
Alef 的语法和 C 语言基本保持一致,可以认为它是在 C 语言的语法基础上增加了并发编程相关的特性,可以看作是另一个维度的 C++ 语言。
1.2.5 Limbo - Sean Dorward, Phil Winterbottom, Rob Pike, 1995
Limbo(地狱)是用于开发运行在小型计算机上的分布式应用的编程语言,它支持模块化编程,编译期和运行时的强类型检查,进程内基于具有类型的通信管道,原子性垃圾收集和简单的抽象数据类型。Limbo 被设计为:即便是在没有硬件内存保护的小型设备上,也能安全运行。Limbo 语言主要运行在 Inferno 系统之上。
Limbo 语言版本的“Hello World”程序如下:
implement Hello;

include "sys.m"; sys: Sys;
include "draw.m";

Hello: module
{
    init: fn(ctxt: ref Draw->Context, args: list of string);
};

init(ctxt: ref Draw->Context, args: list of string)
{
    sys = load Sys Sys->PATH;
    sys->print("hello, world\n");
}
从这个版本的“Hello World”程序中,我们已经可以发现很多 Go 语言特性的雏形。第一句 implement Hello; 基本对应 Go 语言的 package Hello 包声明语句。然后是 include "sys.m"; sys: Sys; 和 include "draw.m"; 语句用于导入其它的模块,类似 Go 语言的 import "sys" 和 import "draw" 语句。然后 Hello 包模块还提供了模块初始化函数 init,并且函数的参数的类型也是后置的,不过 Go 语言的初始化函数是没有参数的。
1.2.6 Go 语言 - 2007~2009
贝尔实验室后来经历了多次动荡,包括 Ken Thompson 在内的 Plan9 项目原班人马最终加入了 Google 公司。在发明 Limbo 等前辈语言诞生十多年之后,在 2007 年底,Go 语言三个最初的作者因为偶然的因素聚集到一起批斗 C++(传说是 C++ 语言的布道师在 Google 公司到处鼓吹的 C++11 各种牛逼特性彻底惹恼了他们),他们终于抽出了 20% 的自由时间创造了 Go 语言。最初的 Go 语言规范从 2008 年 3 月开始编写,最初的 Go 程序也是直接编译到 C 语言然后再二次编译为机器码。到了 2008 年 5 月,Google 公司的领导们终于发现了 Go 语言的巨大潜力,从而开始全力支持这个项目(Google 的创始人甚至还贡献了func关键字),让他们可以将全部工作时间投入到 Go 语言的设计和开发中。在 Go 语言规范初版完成之后,Go 语言的编译器终于可以直接生成机器码了。
1.2.6.1 hello.go - 2008 年 6 月
package main

func main() int {
    print "hello, world\n";
    return 0;
}
这是初期 Go 语言程序正式开始测试的版本。其中内置的用于调试的 print 语句已经存在,不过是以命令的方式使用。入口 main 函数还和 C 语言中的 main 函数一样返回 int 类型的值,而且需要 return 显式地返回值。每个语句末尾的分号也还存在。
1.2.6.2 hello.go - 2008 年 6 月 27 日
package main

func main() {
    print "hello, world\n";
}
入口函数 main 已经去掉了返回值,程序默认通过隐式调用 exit(0) 来返回。Go 语言朝着简单的方向逐步进化。
1.2.6.3 hello.go - 2008 年 8 月 11 日
package main

func main() {
    print("hello, world\n");
}
用于调试的内置的 print 由开始的命令改为普通的内置函数,使得语法更加简单一致。
1.2.6.4 hello.go - 2008 年 10 月 24 日
package main

import "fmt"

func main() {
    fmt.printf("hello, world\n");
}
作为 C 语言中招牌的 printf 格式化函数已经移植了到了 Go 语言中,函数放在 fmt 包中(fmt 是格式化单词 format 的缩写)。不过 printf 函数名的开头字母依然是小写字母,采用大写字母表示导出的特性还没有出现。
1.2.6.5 hello.go - 2009年1月15日
package main

import "fmt"

func main() {
    fmt.Printf("hello, world\n");
}
Go 语言开始采用是否大小写首字母来区分符号是否可以被导出。大写字母开头表示导出的公共符号,小写字母开头表示包内部的私有符号。国内用户需要注意的是,汉字中没有大小写字母的概念,因此以汉字开头的符号目前是无法导出的(针对问题中国用户已经给出相关建议,等 Go2 之后或许会调整对汉字的导出规则)。
1.2.6.7 hello.go - 2009 年 12 月 11 日
package main

import "fmt"

func main() {
    fmt.Printf("hello, world\n")
}
Go 语言终于移除了语句末尾的分号。这是 Go 语言在 2009 年 11 月 10 号正式开源之后第一个比较重要的语法改进。从 1978 年 C 语言教程第一版引入的分号分割的规则到现在,Go 语言的作者们花了整整 32 年终于移除了语句末尾的分号。在这 32 年的演化的过程中必然充满了各种八卦故事,我想这一定是 Go 语言设计者深思熟虑的结果(现在 Swift 等新的语言也是默认忽略分号的,可见分号确实并不是那么的重要)。
1.2.7 你好, 世界! - V2.0
在经过半个世纪的涅槃重生之后,Go 语言不仅仅打印出了 Unicode 版本的“Hello, World”,而且可以方便地向全球用户提供打印服务。下面版本通过 http 服务向每个访问的客户端打印中文的“你好, 世界!”和当前的时间信息。
package main

import (
    "fmt"
    "log"
    "net/http"
    "time"
)

func main() {
    fmt.Println("Please visit http://127.0.0.1:12345/")
    http.HandleFunc("/", func(w http.ResponseWriter, req *http.Request) {
        s := fmt.Sprintf("你好, 世界! -- Time: %s", time.Now().String())
        fmt.Fprintf(w, "%v\n", s)
        log.Printf("%v\n", s)
    })
    if err := http.ListenAndServe(":12345", nil); err != nil {
        log.Fatal("ListenAndServe: ", err)
    }
}
我们通过Go语言标准库自带的 net/http 包构造了一个独立运行的 http 服务。其中 http.HandleFunc("/", ...) 针对 / 根路径请求注册了响应处理函数。在响应处理函数中,我们依然使用 fmt.Fprintf 格式化输出函数实现了通过 http 协议向请求的客户端打印格式化的字符串,同时通过标准库的日志包在服务器端也打印相关字符串。最后通过 http.ListenAndServe 函数调用来启动 http 服务。
至此,Go 语言终于完成了从单机单核时代的 C 语言到 21 世纪互联网时代多核环境的通用编程语言的蜕变。
数组、字符串和切片
在主流的编程语言中数组及其相关的数据结构是使用得最为频繁的,只有在它(们)不能满足时才会考虑链表、hash 表(hash 表可以看作是数组和链表的混合体)和更复杂的自定义数据结构。
Go 语言中数组、字符串和切片三者是密切相关的数据结构。这三种数据类型,在底层原始数据有着相同的内存结构,在上层,因为语法的限制而有着不同的行为表现。首先,Go 语言的数组是一种值类型,虽然数组的元素可以被修改,但是数组本身的赋值和函数传参都是以整体复制的方式处理的。Go 语言字符串底层数据也是对应的字节数组,但是字符串的只读属性禁止了在程序中对底层字节数组的元素的修改。字符串赋值只是复制了数据地址和对应的长度,而不会导致底层数据的复制。切片的行为更为灵活,切片的结构和字符串结构类似,但是解除了只读限制。切片的底层数据虽然也是对应数据类型的数组,但是每个切片还有独立的长度和容量信息,切片赋值和函数传参数时也是将切片头信息部分按传值方式处理。因为切片头含有底层数据的指针,所以它的赋值也不会导致底层数据的复制。其实 Go 语言的赋值和函数传参规则很简单,除了闭包函数以引用的方式对外部变量访问之外,其它赋值和函数传参数都是以传值的方式处理。要理解数组、字符串和切片三种不同的处理方式的原因需要详细了解它们的底层数据结构。
1.3.1 数组
数组是一个由固定长度的特定类型元素组成的序列,一个数组可以由零个或多个元素组成。数组的长度是数组类型的组成部分。因为数组的长度是数组类型的一个部分,不同长度或不同类型的数据组成的数组都是不同的类型,因此在 Go 语言中很少直接使用数组(不同长度的数组因为类型不同无法直接赋值)。和数组对应的类型是切片,切片是可以动态增长和收缩的序列,切片的功能也更加灵活,但是要理解切片的工作原理还是要先理解数组。
我们先看看数组有哪些定义方式:
var a [3]int                    // 定义长度为 3 的 int 型数组, 元素全部为 0
var b = [...]int{1, 2, 3}       // 定义长度为 3 的 int 型数组, 元素为 1, 2, 3
var c = [...]int{2: 3, 1: 2}    // 定义长度为 3 的 int 型数组, 元素为 0, 2, 3
var d = [...]int{1, 2, 4: 5, 6} // 定义长度为 6 的 int 型数组, 元素为 1, 2, 0, 0, 5, 6
第一种方式是定义一个数组变量的最基本的方式,数组的长度明确指定,数组中的每个元素都以零值初始化。
第二种方式定义数组,可以在定义的时候顺序指定全部元素的初始化值,数组的长度根据初始化元素的数目自动计算。
第三种方式是以索引的方式来初始化数组的元素,因此元素的初始化值出现顺序比较随意。这种初始化方式和 map[int]Type 类型的初始化语法类似。数组的长度以出现的最大的索引为准,没有明确初始化的元素依然用零值初始化。
第四种方式是混合了第二种和第三种的初始化方式,前面两个元素采用顺序初始化,第三第四个元素零值初始化,第五个元素通过索引初始化,最后一个元素跟在前面的第五个元素之后采用顺序初始化。
数组的内存结构比较简单。比如下面是一个 [4]int{2,3,5,7} 数组值对应的内存结构:
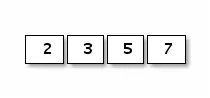
图 1-7 数组布局
Go 语言中数组是值语义。一个数组变量即表示整个数组,它并不是隐式的指向第一个元素的指针(比如 C 语言的数组),而是一个完整的值。当一个数组变量被赋值或者被传递的时候,实际上会复制整个数组。如果数组较大的话,数组的赋值也会有较大的开销。为了避免复制数组带来的开销,可以传递一个指向数组的指针,但是数组指针并不是数组。
var a = [...]int{1, 2, 3} // a 是一个数组
var b = &a                // b 是指向数组的指针

fmt.Println(a[0], a[1])   // 打印数组的前 2 个元素
fmt.Println(b[0], b[1])   // 通过数组指针访问数组元素的方式和数组类似

for i, v := range b {     // 通过数组指针迭代数组的元素
    fmt.Println(i, v)
}
其中 b 是指向 a 数组的指针,但是通过 b 访问数组中元素的写法和 a 类似的。还可以通过 for range 来迭代数组指针指向的数组元素。其实数组指针类型除了类型和数组不同之外,通过数组指针操作数组的方式和通过数组本身的操作类似,而且数组指针赋值时只会拷贝一个指针。但是数组指针类型依然不够灵活,因为数组的长度是数组类型的组成部分,指向不同长度数组的数组指针类型也是完全不同的。
可以将数组看作一个特殊的结构体,结构的字段名对应数组的索引,同时结构体成员的数目是固定的。内置函数 len 可以用于计算数组的长度,cap 函数可以用于计算数组的容量。不过对于数组类型来说,len 和 cap 函数返回的结果始终是一样的,都是对应数组类型的长度。
我们可以用 for 循环来迭代数组。下面常见的几种方式都可以用来遍历数组:
    for i := range a {
        fmt.Printf("a[%d]: %d\n", i, a[i])
    }
    for i, v := range b {
        fmt.Printf("b[%d]: %d\n", i, v)
    }
    for i := 0; i < len(c); i++ {
        fmt.Printf("c[%d]: %d\n", i, c[i])
    }
用 for range 方式迭代的性能可能会更好一些,因为这种迭代可以保证不会出现数组越界的情形,每轮迭代对数组元素的访问时可以省去对下标越界的判断。
用 for range 方式迭代,还可以忽略迭代时的下标:
    var times [5][0]int
    for range times {
        fmt.Println("hello")
    }
其中 times 对应一个 [5][0]int 类型的数组,虽然第一维数组有长度,但是数组的元素 [0]int 大小是 0,因此整个数组占用的内存大小依然是 0。没有付出额外的内存代价,我们就通过 for range 方式实现了 times 次快速迭代。
数组不仅仅可以用于数值类型,还可以定义字符串数组、结构体数组、函数数组、接口数组、管道数组等等:
// 字符串数组
var s1 = [2]string{"hello", "world"}
var s2 = [...]string{"你好", "世界"}
var s3 = [...]string{1: "世界", 0: "你好", }

// 结构体数组
var line1 [2]image.Point
var line2 = [...]image.Point{image.Point{X: 0, Y: 0}, image.Point{X: 1, Y: 1}}
var line3 = [...]image.Point{{0, 0}, {1, 1}}

// 图像解码器数组
var decoder1 [2]func(io.Reader) (image.Image, error)
var decoder2 = [...]func(io.Reader) (image.Image, error){
    png.Decode,
    jpeg.Decode,
}

// 接口数组
var unknown1 [2]interface{}
var unknown2 = [...]interface{}{123, "你好"}

// 管道数组
var chanList = [2]chan int{}
我们还可以定义一个空的数组:
var d [0]int       // 定义一个长度为 0 的数组
var e = [0]int{}   // 定义一个长度为 0 的数组
var f = [...]int{} // 定义一个长度为 0 的数组
长度为 0 的数组在内存中并不占用空间。空数组虽然很少直接使用,但是可以用于强调某种特有类型的操作时避免分配额外的内存空间,比如用于管道的同步操作:
    c1 := make(chan [0]int)
    go func() {
        fmt.Println("c1")
        c1 <- [0]int{}
    }()
    <-c1
在这里,我们并不关心管道中传输数据的真实类型,其中管道接收和发送操作只是用于消息的同步。对于这种场景,我们用空数组来作为管道类型可以减少管道元素赋值时的开销。当然一般更倾向于用无类型的匿名结构体代替:
    c2 := make(chan struct{})
    go func() {
        fmt.Println("c2")
        c2 <- struct{}{} // struct{} 部分是类型, {} 表示对应的结构体值
    }()
    <-c2
我们可以用 fmt.Printf 函数提供的 %T 或 %#v 谓词语法来打印数组的类型和详细信息:
    fmt.Printf("b: %T\n", b)  // b: [3]int
    fmt.Printf("b: %#v\n", b) // b: [3]int{1, 2, 3}
在 Go 语言中,数组类型是切片和字符串等结构的基础。以上数组的很多操作都可以直接用于字符串或切片中。
1.3.2 字符串
一个字符串是一个不可改变的字节序列,字符串通常是用来包含人类可读的文本数据。和数组不同的是,字符串的元素不可修改,是一个只读的字节数组。每个字符串的长度虽然也是固定的,但是字符串的长度并不是字符串类型的一部分。由于 Go 语言的源代码要求是 UTF8 编码,导致 Go 源代码中出现的字符串面值常量一般也是 UTF8 编码的。源代码中的文本字符串通常被解释为采用 UTF8 编码的 Unicode 码点(rune)序列。因为字节序列对应的是只读的字节序列,因此字符串可以包含任意的数据,包括 byte 值 0。我们也可以用字符串表示 GBK 等非 UTF8 编码的数据,不过这种时候将字符串看作是一个只读的二进制数组更准确,因为 for range 等语法并不能支持非 UTF8 编码的字符串的遍历。
Go 语言字符串的底层结构在 reflect.StringHeader 中定义:
type StringHeader struct {
    Data uintptr
    Len  int
}
字符串结构由两个信息组成:第一个是字符串指向的底层字节数组,第二个是字符串的字节的长度。字符串其实是一个结构体,因此字符串的赋值操作也就是 reflect.StringHeader 结构体的复制过程,并不会涉及底层字节数组的复制。在前面数组一节提到的 [2]string 字符串数组对应的底层结构和 [2]reflect.StringHeader 对应的底层结构是一样的,可以将字符串数组看作一个结构体数组。
我们可以看看字符串“Hello, world”本身对应的内存结构:
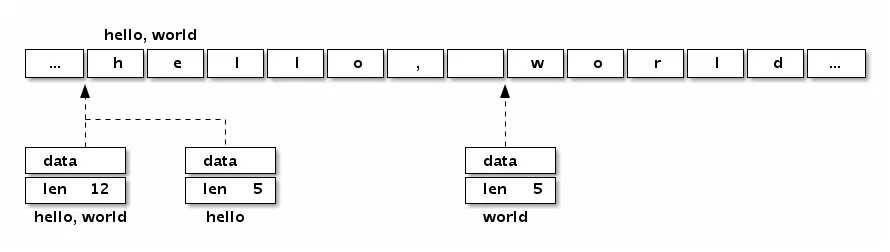
图 1-8 字符串布局
分析可以发现,“Hello, world”字符串底层数据和以下数组是完全一致的:
var data = [...]byte{
    'h', 'e', 'l', 'l', 'o', ',', ' ', 'w', 'o', 'r', 'l', 'd',
}
字符串虽然不是切片,但是支持切片操作,不同位置的切片底层也访问的同一块内存数据(因为字符串是只读的,相同的字符串面值常量通常是对应同一个字符串常量):
s := "hello, world"
hello := s[:5]
world := s[7:]

s1 := "hello, world"[:5]
s2 := "hello, world"[7:]
字符串和数组类似,内置的 len 函数返回字符串的长度。也可以通过 reflect.StringHeader 结构访问字符串的长度(这里只是为了演示字符串的结构,并不是推荐的做法):
fmt.Println("len(s):", (*reflect.StringHeader)(unsafe.Pointer(&s)).Len)   // 12
fmt.Println("len(s1):", (*reflect.StringHeader)(unsafe.Pointer(&s1)).Len) // 5
fmt.Println("len(s2):", (*reflect.StringHeader)(unsafe.Pointer(&s2)).Len) // 5
根据 Go 语言规范,Go 语言的源文件都是采用 UTF8 编码。因此,Go 源文件中出现的字符串面值常量一般也是 UTF8 编码的(对于转义字符,则没有这个限制)。提到 Go 字符串时,我们一般都会假设字符串对应的是一个合法的 UTF8 编码的字符序列。可以用内置的 print 调试函数或 fmt.Print 函数直接打印,也可以用 for range 循环直接遍历 UTF8 解码后的 Unicode 码点值。
下面的“Hello, 世界”字符串中包含了中文字符,可以通过打印转型为字节类型来查看字符底层对应的数据:
fmt.Printf("%#v\n", []byte("Hello, 世界"))输出的结果是:
[]byte{0x48, 0x65, 0x6c, 0x6c, 0x6f, 0x2c, 0x20, 0xe4, 0xb8, 0x96, 0xe7, \
0x95, 0x8c}分析可以发现0xe4, 0xb8, 0x96对应中文“世”,0xe7, 0x95, 0x8c对应中文“界”。我们也可以在字符串面值中直指定 UTF8 编码后的值(源文件中全部是 ASCII 码,可以避免出现多字节的字符)。
fmt.Println("\xe4\xb8\x96") // 打印: 世
fmt.Println("\xe7\x95\x8c") // 打印: 界
下图展示了“Hello, 世界”字符串的内存结构布局:
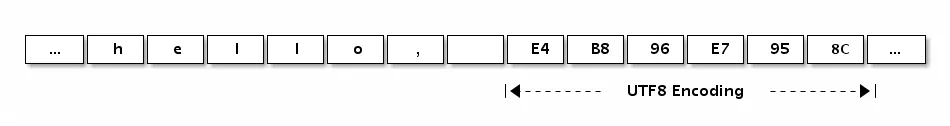
图 1-9 字符串布局
Go 语言的字符串中可以存放任意的二进制字节序列,而且即使是 UTF8 字符序列也可能会遇到坏的编码。如果遇到一个错误的 UTF8 编码输入,将生成一个特别的 Unicode 字符‘\uFFFD’,这个字符在不同的软件中的显示效果可能不太一样,在印刷中这个符号通常是一个黑色六角形或钻石形状,里面包含一个白色的问号‘�’。
下面的字符串中,我们故意损坏了第一字符的第二和第三字节,因此第一字符将会打印为“�”,第二和第三字节则被忽略,后面的“abc”依然可以正常解码打印(错误编码不会向后扩散是 UTF8 编码的优秀特性之一)。
fmt.Println("\xe4\x00\x00\xe7\x95\x8cabc") // �界abc不过在 for range 迭代这个含有损坏的 UTF8 字符串时,第一字符的第二和第三字节依然会被单独迭代到,不过此时迭代的值是损坏后的 0:
for i, c := range "\xe4\x00\x00\xe7\x95\x8cabc" {
    fmt.Println(i, c)
}
// 0 65533  // \uFFFD, 对应 �
// 1 0      // 空字符
// 2 0      // 空字符
// 3 30028  // 界
// 6 97     // a
// 7 98     // b
// 8 99     // c
如果不想解码 UTF8 字符串,想直接遍历原始的字节码,可以将字符串强制转为 []byte 字节序列后再行遍历(这里的转换一般不会产生运行时开销):
for i, c := range []byte("世界abc") {
    fmt.Println(i, c)
}
或者是采用传统的下标方式遍历字符串的字节数组:
const s = "\xe4\x00\x00\xe7\x95\x8cabc"
for i := 0; i < len(s); i++ {
    fmt.Printf("%d %x\n", i, s[i])
}
Go 语言除了 for range 语法对 UTF8 字符串提供了特殊支持外,还对字符串和 []rune 类型的相互转换提供了特殊的支持。
fmt.Printf("%#v\n", []rune("世界"))             // []int32{19990, 30028}
fmt.Printf("%#v\n", string([]rune{'世', '界'})) // 世界
从上面代码的输出结果来看,我们可以发现 []rune 其实是 []int32 类型,这里的 rune 只是 int32 类型的别名,并不是重新定义的类型。rune 用于表示每个 Unicode 码点,目前只使用了 21 个 bit 位。
字符串相关的强制类型转换主要涉及到 []byte 和 []rune 两种类型。每个转换都可能隐含重新分配内存的代价,最坏的情况下它们的运算时间复杂度都是 O(n)。不过字符串和 []rune 的转换要更为特殊一些,因为一般这种强制类型转换要求两个类型的底层内存结构要尽量一致,显然它们底层对应的 []byte 和 []int32 类型是完全不同的内部布局,因此这种转换可能隐含重新分配内存的操作。
下面分别用伪代码简单模拟 Go 语言对字符串内置的一些操作,这样对每个操作的处理的时间复杂度和空间复杂度都会有较明确的认识。
for range 对字符串的迭代模拟实现
func forOnString(s string, forBody func(i int, r rune)) {
    for i := 0; len(s) > 0; {
        r, size := utf8.DecodeRuneInString(s)
        forBody(i, r)
        s = s[size:]
        i += size
    }
}
for range 迭代字符串时,每次解码一个 Unicode 字符,然后进入 for 循环体,遇到崩坏的编码并不会导致迭代停止。
[]byte(s) 转换模拟实现
func str2bytes(s string) []byte {
    p := make([]byte, len(s))
    for i := 0; i < len(s); i++ {
        c := s[i]
        p[i] = c
    }
    return p
}
模拟实现中新创建了一个切片,然后将字符串的数组逐一复制到了切片中,这是为了保证字符串只读的语义。当然,在将字符串转为 []byte 时,如果转换后的变量并没有被修改的情形,编译器可能会直接返回原始的字符串对应的底层数据。
string(bytes) 转换模拟实现
func bytes2str(s []byte) (p string) {
    data := make([]byte, len(s))
    for i, c := range s {
        data[i] = c
    }

    hdr := (*reflect.StringHeader)(unsafe.Pointer(&p))
    hdr.Data = uintptr(unsafe.Pointer(&data[0]))
    hdr.Len = len(s)

    return p
}
因为 Go 语言的字符串是只读的,无法直接同构构造底层字节数组生成字符串。在模拟实现中通过 unsafe 包获取了字符串的底层数据结构,然后将切片的数据逐一复制到了字符串中,这同样是为了保证字符串只读的语义不会受切片的影响。如果转换后的字符串在生命周期中原始的 []byte 的变量并不会发生变化,编译器可能会直接基于 []byte 底层的数据构建字符串。
[]rune(s) 转换模拟实现
func str2runes(s string) []rune{
    var p []int32
    for len(s)>0 {
        r,size:=utf8.DecodeRuneInString(s)
        p=append(p,int32(r))
        s=s[size:]
        }
        return []rune(p)
}
因为底层内存结构的差异,字符串到 []rune 的转换必然会导致重新分配 []rune 内存空间,然后依次解码并复制对应的 Unicode 码点值。这种强制转换并不存在前面提到的字符串和字节切片转化时的优化情况。
string(runes) 转换模拟实现
func runes2string(s []int32) string {
    var p []byte
    buf := make([]byte, 3)
    for _, r := range s {
        n := utf8.EncodeRune(buf, r)
        p = append(p, buf[:n]...)
    }
    return string(p)
}同样因为底层内存结构的差异,[]rune 到字符串的转换也必然会导致重新构造字符串。这种强制转换并不存在前面提到的优化情况。
1.3.3 切片(slice)
简单地说,切片就是一种简化版的动态数组。因为动态数组的长度是不固定,切片的长度自然也就不能是类型的组成部分了。数组虽然有适用它们的地方,但是数组的类型和操作都不够灵活,因此在 Go 代码中数组使用的并不多。而切片则使用得相当广泛,理解切片的原理和用法是一个 Go 程序员的必备技能。
我们先看看切片的结构定义,reflect.SliceHeader:
type SliceHeader struct {
    Data uintptr
    Len  int
    Cap  int
}
可以看出切片的开头部分和 Go 字符串是一样的,但是切片多了一个 Cap 成员表示切片指向的内存空间的最大容量,由起始索引位置到 Data 末尾的元素数量(而不是字节数)决定。下图是 x := []int{2,3,5,7,11} 和 y := x[1:3] 两个切片对应的内存结构。
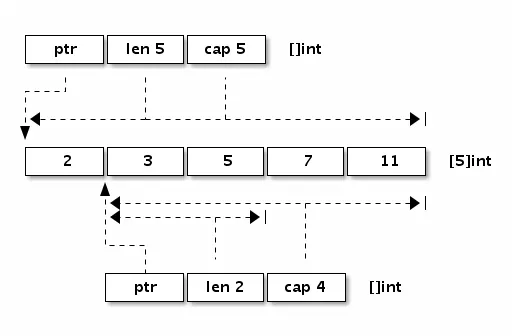
图 1-10 切片布局
让我们看看切片有哪些定义方式:
var (
    a []int               // nil 切片, 和 nil 相等, 一般用来表示一个不存在的切片
    b = []int{}           // 空切片, 和 nil 不相等, 一般用来表示一个空的集合
    c = []int{1, 2, 3}    // 有 3 个元素的切片, len 和 cap 都为 3
    d = c[:2]             // 有 2 个元素的切片, len 为 2, cap 为 3
    e = c[0:2:cap(c)]     // 有 2 个元素的切片, len 为 2, cap 为 3
    f = c[:0]             // 有 0 个元素的切片, len 为 0, cap 为 3
    g = c[1:2]            // 有 1 个元素的切片, len 为 1, cap 为 2
    h = make([]int, 3)    // 有 3 个元素的切片, len 和 cap 都为 3
    i = make([]int, 2, 3) // 有 2 个元素的切片, len 为 2, cap 为 3
    j = make([]int, 0, 3) // 有 0 个元素的切片, len 为 0, cap 为 3
)
和数组一样,内置的 len 函数返回切片中有效元素的长度,内置的 cap 函数返回切片容量大小,容量必须大于或等于切片的长度。也可以通过 reflect.SliceHeader 结构访问切片的信息(只是为了说明切片的结构,并不是推荐的做法)。切片可以和 nil 进行比较,只有当切片底层数据指针为空时切片本身为 nil,这时候切片的长度和容量信息将是无效的。如果有切片的底层数据指针为空,但是长度和容量不为 0 的情况,那么说明切片本身已经被损坏了(比如直接通过 reflect.SliceHeader 或 unsafe 包对切片作了不正确的修改)。
遍历切片的方式和遍历数组的方式类似:
    for i := range a {
        fmt.Printf("a[%d]: %d\n", i, a[i])
    }
    for i, v := range b {
        fmt.Printf("b[%d]: %d\n", i, v)
    }
    for i := 0; i < len(c); i++ {
        fmt.Printf("c[%d]: %d\n", i, c[i])
}其实除了遍历之外,只要是切片的底层数据指针、长度和容量没有发生变化的话,对切片的遍历、元素的读取和修改都和数组是一样的。在对切片本身赋值或参数传递时,和数组指针的操作方式类似,只是复制切片头信息(reflect.SliceHeader),并不会复制底层的数据。对于类型,和数组的最大不同是,切片的类型和长度信息无关,只要是相同类型元素构成的切片均对应相同的切片类型。
如前所说,切片是一种简化版的动态数组,这是切片类型的灵魂。除了构造切片和遍历切片之外,添加切片元素、删除切片元素都是切片处理中经常遇到的问题。
添加切片元素
内置的泛型函数 append 可以在切片的尾部追加 N 个元素:
var a []int
a = append(a, 1)               // 追加 1 个元素
a = append(a, 1, 2, 3)         // 追加多个元素, 手写解包方式
a = append(a, []int{1,2,3}...) // 追加 1 个切片, 切片需要解包不过要注意的是,在容量不足的情况下,append 的操作会导致重新分配内存,可能导致巨大的内存分配和复制数据代价。即使容量足够,依然需要用 append 函数的返回值来更新切片本身,因为新切片的长度已经发生了变化。
除了在切片的尾部追加,我们还可以在切片的开头添加元素:
var a = []int{1,2,3}
a = append([]int{0}, a...)        // 在开头添加 1 个元素
a = append([]int{-3,-2,-1}, a...) // 在开头添加 1 个切片
在开头一般都会导致内存的重新分配,而且会导致已有的元素全部复制 1 次。因此,从切片的开头添加元素的性能一般要比从尾部追加元素的性能差很多。
由于 append 函数返回新的切片,也就是它支持链式操作。我们可以将多个 append 操作组合起来,实现在切片中间插入元素:
var a []int
a = append(a[:i], append([]int{x}, a[i:]...)...)     // 在第 i 个位置插入 x
a = append(a[:i], append([]int{1,2,3}, a[i:]...)...) // 在第 i 个位置插入切片
每个添加操作中的第二个 append 调用都会创建一个临时切片,并将 a[i:] 的内容复制到新创建的切片中,然后将临时创建的切片再追加到 a[:i]。
可以用 copy 和 append 组合可以避免创建中间的临时切片,同样是完成添加元素的操作:
a = append(a, 0)     // 切片扩展 1 个空间
copy(a[i+1:], a[i:]) // a[i:] 向后移动 1 个位置
a[i] = x             // 设置新添加的元素
第一句 append 用于扩展切片的长度,为要插入的元素留出空间。第二句 copy 操作将要插入位置开始之后的元素向后挪动一个位置。第三句真实地将新添加的元素赋值到对应的位置。操作语句虽然冗长了一点,但是相比前面的方法,可以减少中间创建的临时切片。
用 copy 和 append 组合也可以实现在中间位置插入多个元素(也就是插入一个切片):
a = append(a, x...)       // 为 x 切片扩展足够的空间
copy(a[i+len(x):], a[i:]) // a[i:] 向后移动 len(x) 个位置
copy(a[i:], x) // 复制新添加的切片稍显不足的是,在第一句扩展切片容量的时候,扩展空间部分的元素复制是没有必要的。没有专门的内置函数用于扩展切片的容量,append 本质是用于追加元素而不是扩展容量,扩展切片容量只是 append 的一个副作用。
删除切片元素
根据要删除元素的位置有三种情况:从开头位置删除,从中间位置删除,从尾部删除。其中删除切片尾部的元素最快:
a = []int{1, 2, 3}
a = a[:len(a)-1]   // 删除尾部 1 个元素
a = a[:len(a)-N]   // 删除尾部 N 个元素
删除开头的元素可以直接移动数据指针:
a = []int{1, 2, 3}
a = a[1:] // 删除开头 1 个元素
a = a[N:] // 删除开头 N 个元素
删除开头的元素也可以不移动数据指针,但是将后面的数据向开头移动。可以用 append 原地完成(所谓原地完成是指在原有的切片数据对应的内存区间内完成,不会导致内存空间结构的变化):
a = []int{1, 2, 3}
a = append(a[:0], a[1:]...) // 删除开头 1 个元素
a = append(a[:0], a[N:]...) // 删除开头 N 个元素
也可以用 copy 完成删除开头的元素:
a = []int{1, 2, 3}
a = a[:copy(a, a[1:])] // 删除开头 1 个元素
a = a[:copy(a, a[N:])] // 删除开头 N 个元素
对于删除中间的元素,需要对剩余的元素进行一次整体挪动,同样可以用 append 或 copy 原地完成:
a = []int{1, 2, 3, ...}

a = append(a[:i], a[i+1:]...) // 删除中间 1 个元素
a = append(a[:i], a[i+N:]...) // 删除中间 N 个元素

a = a[:i+copy(a[i:], a[i+1:])]  // 删除中间 1 个元素
a = a[:i+copy(a[i:], a[i+N:])]  // 删除中间 N 个元素
删除开头的元素和删除尾部的元素都可以认为是删除中间元素操作的特殊情况。
切片内存技巧
在本节开头的数组部分我们提到过有类似 [0]int 的空数组,空数组一般很少用到。但是对于切片来说,len 为 0 但是 cap 容量不为 0 的切片则是非常有用的特性。当然,如果 len 和 cap 都为 0 的话,则变成一个真正的空切片,虽然它并不是一个 nil 值的切片。在判断一个切片是否为空时,一般通过 len 获取切片的长度来判断,一般很少将切片和 nil 值做直接的比较。
比如下面的 TrimSpace 函数用于删除 []byte 中的空格。函数实现利用了 0 长切片的特性,实现高效而且简洁。
func TrimSpace(s []byte) []byte {
    b := s[:0]
    for _, x := range s {
        if x != ' ' {
            b = append(b, x)
        }
    }
    return b
}
其实类似的根据过滤条件原地删除切片元素的算法都可以采用类似的方式处理(因为是删除操作不会出现内存不足的情形):
func Filter(s []byte, fn func(x byte) bool) []byte {
    b := s[:0]
    for _, x := range s {
        if !fn(x) {
            b = append(b, x)
        }
    }
    return b
}
切片高效操作的要点是要降低内存分配的次数,尽量保证 append 操作不会超出 cap 的容量,降低触发内存分配的次数和每次分配内存大小。
避免切片内存泄漏
如前面所说,切片操作并不会复制底层的数据。底层的数组会被保存在内存中,直到它不再被引用。但是有时候可能会因为一个小的内存引用而导致底层整个数组处于被使用的状态,这会延迟自动内存回收器对底层数组的回收。
例如,FindPhoneNumber 函数加载整个文件到内存,然后搜索第一个出现的电话号码,最后结果以切片方式返回。
func FindPhoneNumber(filename string) []byte {
    b, _ := ioutil.ReadFile(filename)
    return regexp.MustCompile("[0-9]+").Find(b)
}
这段代码返回的 []byte 指向保存整个文件的数组。因为切片引用了整个原始数组,导致自动垃圾回收器不能及时释放底层数组的空间。一个小的需求可能导致需要长时间保存整个文件数据。这虽然这并不是传统意义上的内存泄漏,但是可能会拖慢系统的整体性能。
要修复这个问题,可以将感兴趣的数据复制到一个新的切片中(数据的传值是 Go 语言编程的一个哲学,虽然传值有一定的代价,但是换取的好处是切断了对原始数据的依赖):
func FindPhoneNumber(filename string) []byte {
    b, _ := ioutil.ReadFile(filename)
    b = regexp.MustCompile("[0-9]+").Find(b)
    return append([]byte{}, b...)
}
类似的问题,在删除切片元素时可能会遇到。假设切片里存放的是指针对象,那么下面删除末尾的元素后,被删除的元素依然被切片底层数组引用,从而导致不能及时被自动垃圾回收器回收(这要依赖回收器的实现方式):
var a []*int{ ... }
a = a[:len(a)-1]    // 被删除的最后一个元素依然被引用, 可能导致 GC 操作被阻碍
保险的方式是先将需要自动内存回收的元素设置为 nil,保证自动回收器可以发现需要回收的对象,然后再进行切片的删除操作:
var a []*int{ ... }
a[len(a)-1] = nil // GC 回收最后一个元素内存
a = a[:len(a)-1]  // 从切片删除最后一个元素
当然,如果切片存在的周期很短的话,可以不用刻意处理这个问题。因为如果切片本身已经可以被 GC 回收的话,切片对应的每个元素自然也就是可以被回收的了。
切片类型强制转换
为了安全,当两个切片类型 []T 和 []Y 的底层原始切片类型不同时,Go 语言是无法直接转换类型的。不过安全都是有一定代价的,有时候这种转换是有它的价值的——可以简化编码或者是提升代码的性能。比如在 64 位系统上,需要对一个 []float64 切片进行高速排序,我们可以将它强制转为 []int 整数切片,然后以整数的方式进行排序(因为 float64 遵循 IEEE754 浮点数标准特性,当浮点数有序时对应的整数也必然是有序的)。
下面的代码通过两种方法将 []float64 类型的切片转换为 []int 类型的切片:
// +build amd64 arm64

import "sort"

var a = []float64{4, 2, 5, 7, 2, 1, 88, 1}

func SortFloat64FastV1(a []float64) {
    // 强制类型转换
    var b []int = ((*[1 << 20]int)(unsafe.Pointer(&a[0])))[:len(a):cap(a)]

    // 以 int 方式给 float64 排序
    sort.Ints(b)
}

func SortFloat64FastV2(a []float64) {
    // 通过 reflect.SliceHeader 更新切片头部信息实现转换
    var c []int
    aHdr := (*reflect.SliceHeader)(unsafe.Pointer(&a))
    cHdr := (*reflect.SliceHeader)(unsafe.Pointer(&c))
    *cHdr = *aHdr

    // 以 int 方式给 float64 排序
    sort.Ints(c)
}
第一种强制转换是先将切片数据的开始地址转换为一个较大的数组的指针,然后对数组指针对应的数组重新做切片操作。中间需要 unsafe.Pointer 来连接两个不同类型的指针传递。需要注意的是,Go语言实现中非0大小数组的长度不得超过 2GB,因此需要针对数组元素的类型大小计算数组的最大长度范围([]uint8 最大 2GB,[]uint16 最大 1GB,以此类推,但是 []struct{} 数组的长度可以超过 2GB)。
第二种转换操作是分别取到两个不同类型的切片头信息指针,任何类型的切片头部信息底层都是对应 reflect.SliceHeader 结构,然后通过更新结构体方式来更新切片信息,从而实现 a 对应的 []float64 切片到 c 对应的 []int 类型切片的转换。
通过基准测试,我们可以发现用 sort.Ints 对转换后的 []int 排序的性能要比用 sort.Float64s 排序的性能好一点。不过需要注意的是,这个方法可行的前提是要保证 []float64 中没有 NaN 和 Inf 等非规范的浮点数(因为浮点数中 NaN 不可排序,正 0 和负 0 相等,但是整数中没有这类情形)。
函数、方法和接口
函数对应操作序列,是程序的基本组成元素。Go 语言中的函数有具名和匿名之分:具名函数一般对应于包级的函数,是匿名函数的一种特例,当匿名函数引用了外部作用域中的变量时就成了闭包函数,闭包函数是函数式编程语言的核心。方法是绑定到一个具体类型的特殊函数,Go 语言中的方法是依托于类型的,必须在编译时静态绑定。接口定义了方法的集合,这些方法依托于运行时的接口对象,因此接口对应的方法是在运行时动态绑定的。Go 语言通过隐式接口机制实现了鸭子面向对象模型。
Go 语言程序的初始化和执行总是从 main.main 函数开始的。但是如果 main 包导入了其它的包,则会按照顺序将它们包含进 main 包里(这里的导入顺序依赖具体实现,一般可能是以文件名或包路径名的字符串顺序导入)。如果某个包被多次导入的话,在执行的时候只会导入一次。当一个包被导入时,如果它还导入了其它的包,则先将其它的包包含进来,然后创建和初始化这个包的常量和变量,再调用包里的 init 函数,如果一个包有多个 init 函数的话,调用顺序未定义(实现可能是以文件名的顺序调用),同一个文件内的多个 init 则是以出现的顺序依次调用(init 不是普通函数,可以定义有多个,所以也不能被其它函数调用)。最后,当 main 包的所有包级常量、变量被创建和初始化完成,并且 init 函数被执行后,才会进入 main.main 函数,程序开始正常执行。下图是 Go 程序函数启动顺序的示意图:
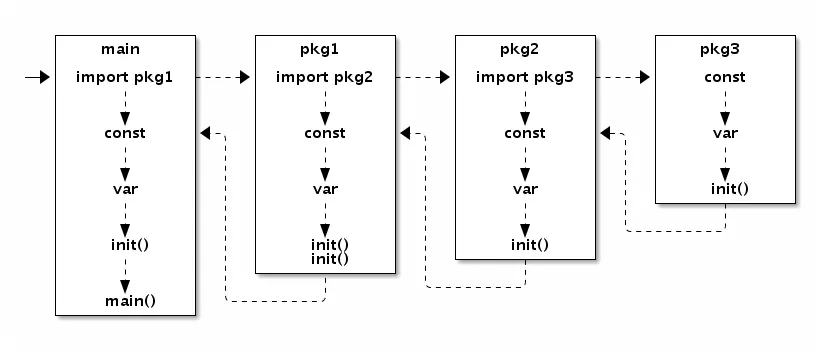
图 1-11 包初始化流程
要注意的是,在 main.main 函数执行之前所有代码都运行在同一个 Goroutine 中,也是运行在程序的主系统线程中。如果某个 init 函数内部用 go 关键字启动了新的 Goroutine 的话,新的 Goroutine 和 main.main 函数是并发执行的。
1.4.1 函数
在 Go 语言中,函数是第一类对象,我们可以将函数保持到变量中。函数主要有具名和匿名之分,包级函数一般都是具名函数,具名函数是匿名函数的一种特例。当然,Go 语言中每个类型还可以有自己的方法,方法其实也是函数的一种。
// 具名函数
func Add(a, b int) int {
    return a+b
}

// 匿名函数
var Add = func(a, b int) int {
    return a+b
}
Go 语言中的函数可以有多个参数和多个返回值,参数和返回值都是以传值的方式和被调用者交换数据。在语法上,函数还支持可变数量的参数,可变数量的参数必须是最后出现的参数,可变数量的参数其实是一个切片类型的参数。
// 多个参数和多个返回值
func Swap(a, b int) (int, int) {
    return b, a
}

// 可变数量的参数
// more 对应 []int 切片类型
func Sum(a int, more ...int) int {
    for _, v := range more {
        a += v
    }
    return a
}
当可变参数是一个空接口类型时,调用者是否解包可变参数会导致不同的结果:
func main() {
    var a = []interface{}{123, "abc"}

    Print(a...) // 123 abc
    Print(a)    // [123 abc]
}

func Print(a ...interface{}) {
    fmt.Println(a...)
}
第一个 Print 调用时传入的参数是 a...,等价于直接调用 Print(123, "abc")。第二个 Print 调用传入的是未解包的 a,等价于直接调用 Print([]interface{}{123, "abc"})。
不仅函数的参数可以有名字,也可以给函数的返回值命名:
func Find(m map[int]int, key int) (value int, ok bool) {
    value, ok = m[key]
    return
}
如果返回值命名了,可以通过名字来修改返回值,也可以通过 defer 语句在 return 语句之后修改返回值:
func Inc() (v int) {
    defer func(){ v++ } ()
    return 42
}
其中 defer 语句延迟执行了一个匿名函数,因为这个匿名函数捕获了外部函数的局部变量 v,这种函数我们一般叫闭包。闭包对捕获的外部变量并不是传值方式访问,而是以引用的方式访问。
闭包的这种引用方式访问外部变量的行为可能会导致一些隐含的问题:
func main() {
    for i := 0; i < 3; i++ {
        defer func(){ println(i) } ()
    }
}
// Output:
// 3
// 3
// 3
因为是闭包,在 for 迭代语句中,每个 defer 语句延迟执行的函数引用的都是同一个 i 迭代变量,在循环结束后这个变量的值为 3,因此最终输出的都是3。
修复的思路是在每轮迭代中为每个 defer 函数生成独有的变量。可以用下面两种方式:
func main() {
    for i := 0; i < 3; i++ {
        i := i // 定义一个循环体内局部变量 i
        defer func(){ println(i) } ()
    }
}

func main() {
    for i := 0; i < 3; i++ {
        // 通过函数传入 i
        // defer 语句会马上对调用参数求值
        defer func(i int){ println(i) } (i)
    }
}
第一种方法是在循环体内部再定义一个局部变量,这样每次迭代 defer 语句的闭包函数捕获的都是不同的变量,这些变量的值对应迭代时的值。第二种方式是将迭代变量通过闭包函数的参数传入,defer 语句会马上对调用参数求值。两种方式都是可以工作的。不过一般来说,在 for 循环内部执行 defer 语句并不是一个好的习惯,此处仅为示例,不建议使用。
Go 语言中,如果以切片为参数调用函数时,有时候会给人一种参数采用了传引用的方式的假象:因为在被调用函数内部可以修改传入的切片的元素。其实,任何可以通过函数参数修改调用参数的情形,都是因为函数参数中显式或隐式传入了指针参数。函数参数传值的规范更准确说是只针对数据结构中固定的部分传值,例如字符串或切片作为参数时实际传递的是 reflect.StringHeader 或reflect.SliceHeader 结构体,结构体是以整体复制的方式传递的。字符串或切片对应的结构体中的指针、长度和容量传值,但是并不包含指针间接指向的内容。将切片类型的参数替换为类似 reflect.SliceHeader 结构体就很好理解切片传值的含义了:
func twice(x []int) {
    for i := range x {
        x[i] *= 2
    }
}

type IntSliceHeader struct {
    Data []int
    Len  int
    Cap  int
}

func twice(x IntSliceHeader) {
    for i := 0; i < x.Len; i++ {
        x.Data[i] *= 2
    }
}因为切片中的底层数组部分是通过隐式指针(即reflect.SliceHeader 里的Data成员)传递(指针本身依然是传值的,但是指针指向的却是同一份的数据),所以被调用函数是可以通过指针修改掉调用参数切片中的数据。除了数据之外,切片结构体还包含了切片长度和切片容量信息,这2个信息也是传值的。如果被调用函数中修改了 Len 或 Cap 信息的话,就无法反映到调用参数的切片中,这时候我们一般会通过返回修改后的切片来更新之前的切片。这也是为何内置的 append 必须要返回一个切片的原因。
Go语言中,函数还可以直接或间接地调用自己,也就是支持递归调用。Go 语言函数的递归调用深度逻辑上没有限制,函数调用的栈是不会出现溢出错误的,因为 Go 语言运行时会根据需要动态地调整函数栈的大小。每个 goroutine 刚启动时只会分配很小的栈(4 或 8KB,具体依赖实现),根据需要动态调整栈的大小,栈最大可以达到 GB 级(依赖具体实现,在目前的实现中,32 位体系结构为 250MB,64 位体系结构为 1GB)。在 Go1.4 以前,Go 的动态栈采用的是分段式的动态栈,通俗地说就是采用一个链表来实现动态栈,每个链表的节点内存位置不会发生变化。但是链表实现的动态栈对某些导致跨越链表不同节点的热点调用的性能影响较大,因为相邻的链表节点它们在内存位置一般不是相邻的,这会增加 CPU 高速缓存命中失败的几率。为了解决热点调用的 CPU 缓存命中率问题,Go1.4 之后改用连续的动态栈实现,也就是采用一个类似动态数组的结构来表示栈。不过连续动态栈也带来了新的问题:当连续栈动态增长时,需要将之前的数据移动到新的内存空间,这会导致之前栈中全部变量的地址发生变化。虽然 Go 语言运行时会自动更新引用了地址变化的栈变量的指针,但最重要的一点是要明白 Go 语言中指针不再是固定不变的了(因此不能随意将指针保持到数值变量中,Go 语言的地址也不能随意保存到不在 GC 控制的环境中,因此使用 CGO 时不能在 C 语言中长期持有 Go 语言对象的地址)。
因为,Go 语言函数的栈会自动调整大小,所以普通 Go 程序员已经很少需要关心栈的运行机制的。在 Go 语言规范中甚至故意没有讲到栈和堆的概念。我们无法知道函数参数或局部变量到底是保存在栈中还是堆中,我们只需要知道它们能够正常工作就可以了。看看下面这个例子:
func f(x int) *int {
    return &x
}

func g() int {
    x := new(int)
    return *x
}
第一个函数直接返回了函数参数变量的地址——这似乎是不可以的,因为如果参数变量在栈上的话,函数返回之后栈变量就失效了,返回的地址自然也应该失效了。但是 Go 语言的编译器和运行时比我们聪明的多,它会保证指针指向的变量在合适的地方。第二个函数,内部虽然调用 new 函数创建了 *int 类型的指针对象,但是依然不知道它具体保存在哪里。对于有 C/C++ 编程经验的程序员需要强调的是:不用关心 Go 语言中函数栈和堆的问题,编译器和运行时会帮我们搞定;同样不要假设变量在内存中的位置是固定不变的,指针随时可能会变化,特别是在你不期望它变化的时候。
1.4.2 方法
方法一般是面向对象编程(OOP)的一个特性,在 C++ 语言中方法对应一个类对象的成员函数,是关联到具体对象上的虚表中的。但是 Go 语言的方法却是关联到类型的,这样可以在编译阶段完成方法的静态绑定。一个面向对象的程序会用方法来表达其属性对应的操作,这样使用这个对象的用户就不需要直接去操作对象,而是借助方法来做这些事情。面向对象编程进入主流开发领域一般认为是从 C++ 开始的,C++ 就是在兼容 C 语言的基础之上支持了 class 等面向对象的特性。然后 Java 编程则号称是纯粹的面向对象语言,因为 Java 中函数是不能独立存在的,每个函数都必然是属于某个类的。
面向对象编程更多的只是一种思想,很多号称支持面向对象编程的语言只是将经常用到的特性内置到语言中了而已。Go 语言的祖先 C 语言虽然不是一个支持面向对象的语言,但是 C 语言的标准库中的 File 相关的函数也用到了的面向对象编程的思想。下面我们实现一组 C 语言风格的 File 函数:
// 文件对象
type File struct {
    fd int
}

// 打开文件
func OpenFile(name string) (f *File, err error) {
    // ...
}

// 关闭文件
func CloseFile(f *File) error {
    // ...
}

// 读文件数据
func ReadFile(f *File, offset int64, data []byte) int {
    // ...
}
其中 OpenFile 类似构造函数用于打开文件对象,CloseFile 类似析构函数用于关闭文件对象,ReadFile 则类似普通的成员函数,这三个函数都是普通的函数。CloseFile 和 ReadFile 作为普通函数,需要占用包级空间中的名字资源。不过 CloseFile 和 ReadFile 函数只是针对 File 类型对象的操作,这时候我们更希望这类函数和操作对象的类型紧密绑定在一起。
Go 语言中的做法是,将 CloseFile 和 ReadFile 函数的第一个参数移动到函数名的开头:
// 关闭文件
func (f *File) CloseFile() error {
    // ...
}

// 读文件数据
func (f *File) ReadFile(offset int64, data []byte) int {
    // ...
}这样的话,CloseFile 和 ReadFile 函数就成了 File 类型独有的方法了(而不是 File 对象方法)。它们也不再占用包级空间中的名字资源,同时 File 类型已经明确了它们操作对象,因此方法名字一般简化为 Close 和 Read:
// 关闭文件
func (f *File) Close() error {
    // ...
}

// 读文件数据
func (f *File) Read(offset int64, data []byte) int {
    // ...
}
将第一个函数参数移动到函数前面,从代码角度看虽然只是一个小的改动,但是从编程哲学角度来看,Go 语言已经是进入面向对象语言的行列了。我们可以给任何自定义类型添加一个或多个方法。每种类型对应的方法必须和类型的定义在同一个包中,因此是无法给 int 这类内置类型添加方法的(因为方法的定义和类型的定义不在一个包中)。对于给定的类型,每个方法的名字必须是唯一的,同时方法和函数一样也不支持重载。
方法是由函数演变而来,只是将函数的第一个对象参数移动到了函数名前面了而已。因此我们依然可以按照原始的过程式思维来使用方法。通过叫方法表达式的特性可以将方法还原为普通类型的函数:
// 不依赖具体的文件对象
// func CloseFile(f *File) error
var CloseFile = (*File).Close

// 不依赖具体的文件对象
// func ReadFile(f *File, offset int64, data []byte) int
var ReadFile = (*File).Read

// 文件处理
f, _ := OpenFile("foo.dat")
ReadFile(f, 0, data)
CloseFile(f)
在有些场景更关心一组相似的操作:比如 Read 读取一些数组,然后调用 Close 关闭。此时的环境中,用户并不关心操作对象的类型,只要能满足通用的 Read 和 Close 行为就可以了。不过在方法表达式中,因为得到的 ReadFile 和 CloseFile 函数参数中含有 File 这个特有的类型参数,这使得 File 相关的方法无法和其它不是 File 类型但是有着相同 Read 和 Close 方法的对象无缝适配。这种小困难难不倒我们 Go 语言码农,我们可以通过结合闭包特性来消除方法表达式中第一个参数类型的差异:
// 先打开文件对象
f, _ := OpenFile("foo.dat")

// 绑定到了 f 对象
// func Close() error
var Close = func() error {
    return (*File).Close(f)
}

// 绑定到了 f 对象
// func Read(offset int64, data []byte) int
var Read = func(offset int64, data []byte) int {
    return (*File).Read(f, offset, data)
}

// 文件处理
Read(0, data)
Close()
这刚好是方法值也要解决的问题。我们用方法值特性可以简化实现:
// 先打开文件对象
f, _ := OpenFile("foo.dat")

// 方法值: 绑定到了 f 对象
// func Close() error
var Close = f.Close

// 方法值: 绑定到了 f 对象
// func Read(offset int64, data []byte) int
var Read = f.Read

// 文件处理
Read(0, data)
Close()
Go语言不支持传统面向对象中的继承特性,而是以自己特有的组合方式支持了方法的继承。Go 语言中,通过在结构体内置匿名的成员来实现继承:
import "image/color"

type Point struct{ X, Y float64 }

type ColoredPoint struct {
    Point
    Color color.RGBA
}
虽然我们可以将 ColoredPoint 定义为一个有三个字段的扁平结构的结构体,但是我们这里将 Point 嵌入到 ColoredPoint 来提供 X 和 Y 这两个字段。
var cp ColoredPoint
cp.X = 1
fmt.Println(cp.Point.X) // "1"
cp.Point.Y = 2
fmt.Println(cp.Y)       // "2"
通过嵌入匿名的成员,我们不仅可以继承匿名成员的内部成员,而且可以继承匿名成员类型所对应的方法。我们一般会将 Point 看作基类,把 ColoredPoint 看作是它的继承类或子类。不过这种方式继承的方法并不能实现 C++ 中虚函数的多态特性。所有继承来的方法的接收者参数依然是那个匿名成员本身,而不是当前的变量。
type Cache struct {
    m map[string]string
    sync.Mutex
}

func (p *Cache) Lookup(key string) string {
    p.Lock()
    defer p.Unlock()

    return p.m[key]
}Cache结构体类型通过嵌入一个匿名的 sync.Mutex 来继承它的 Lock 和 Unlock 方法. 但是在调用 p.Lock() 和 p.Unlock() 时, p 并不是 Lock 和 Unlock 方法的真正接收者, 而是会将它们展开为 p.Mutex.Lock() 和 p.Mutex.Unlock() 调用. 这种展开是编译期完成的, 并没有运行时代价.
在传统的面向对象语言(eg.C++ 或 Java)的继承中,子类的方法是在运行时动态绑定到对象的,因此基类实现的某些方法看到的 this 可能不是基类类型对应的对象,这个特性会导致基类方法运行的不确定性。而在 Go 语言通过嵌入匿名的成员来“继承”的基类方法,this 就是实现该方法的类型的对象,Go 语言中方法是编译时静态绑定的。如果需要虚函数的多态特性,我们需要借助 Go 语言接口来实现。
1.4.3 接口
Go 语言之父 Rob Pike 曾说过一句名言:那些试图避免白痴行为的语言最终自己变成了白痴语言(Languages that try to disallow idiocy become themselves idiotic)。一般静态编程语言都有着严格的类型系统,这使得编译器可以深入检查程序员有没有作出什么出格的举动。但是,过于严格的类型系统却会使得编程太过繁琐,让程序员把大好的青春都浪费在了和编译器的斗争中。Go 语言试图让程序员能在安全和灵活的编程之间取得一个平衡。它在提供严格的类型检查的同时,通过接口类型实现了对鸭子类型的支持,使得安全动态的编程变得相对容易。
Go 的接口类型是对其它类型行为的抽象和概括;因为接口类型不会和特定的实现细节绑定在一起,通过这种抽象的方式我们可以让对象更加灵活和更具有适应能力。很多面向对象的语言都有相似的接口概念,但 Go 语言中接口类型的独特之处在于它是满足隐式实现的鸭子类型。所谓鸭子类型说的是:只要走起路来像鸭子、叫起来也像鸭子,那么就可以把它当作鸭子。Go 语言中的面向对象就是如此,如果一个对象只要看起来像是某种接口类型的实现,那么它就可以作为该接口类型使用。这种设计可以让你创建一个新的接口类型满足已经存在的具体类型却不用去破坏这些类型原有的定义;当我们使用的类型来自于不受我们控制的包时这种设计尤其灵活有用。Go 语言的接口类型是延迟绑定,可以实现类似虚函数的多态功能。
接口在 Go 语言中无处不在,在“Hello world”的例子中,fmt.Printf 函数的设计就是完全基于接口的,它的真正功能由 fmt.Fprintf 函数完成。用于表示错误的 error 类型更是内置的接口类型。在 C 语言中,printf 只能将几种有限的基础数据类型打印到文件对象中。但是 Go 语言灵活接口特性,fmt.Fprintf 却可以向任何自定义的输出流对象打印,可以打印到文件或标准输出、也可以打印到网络、甚至可以打印到一个压缩文件;同时,打印的数据也不仅仅局限于语言内置的基础类型,任意隐式满足 fmt.Stringer 接口的对象都可以打印,不满足 fmt.Stringer 接口的依然可以通过反射的技术打印。fmt.Fprintf 函数的签名如下:
func Fprintf(w io.Writer, format string, args ...interface{}) (int, error)其中 io.Writer 用于输出的接口,error 是内置的错误接口,它们的定义如下:
type io.Writer interface {
    Write(p []byte) (n int, err error)
}

type error interface {
    Error() string
}
我们可以通过定制自己的输出对象,将每个字符转为大写字符后输出:
type UpperWriter struct {
    io.Writer
}

func (p *UpperWriter) Write(data []byte) (n int, err error) {
    return p.Writer.Write(bytes.ToUpper(data))
}

func main() {
    fmt.Fprintln(&UpperWriter{os.Stdout}, "hello, world")
}
当然,我们也可以定义自己的打印格式来实现将每个字符转为大写字符后输出的效果。对于每个要打印的对象,如果满足了 fmt.Stringer 接口,则默认使用对象的 String 方法返回的结果打印:
type UpperString string

func (s UpperString) String() string {
    return strings.ToUpper(string(s))
}

type fmt.Stringer interface {
    String() string
}

func main() {
    fmt.Fprintln(os.Stdout, UpperString("hello, world"))
}
Go 语言中,对于基础类型(非接口类型)不支持隐式的转换,我们无法将一个 int 类型的值直接赋值给 int64 类型的变量,也无法将 int 类型的值赋值给底层是 int 类型的新定义命名类型的变量。Go 语言对基础类型的类型一致性要求可谓是非常的严格,但是 Go 语言对于接口类型的转换则非常的灵活。对象和接口之间的转换、接口和接口之间的转换都可能是隐式的转换。可以看下面的例子:
var (
    a io.ReadCloser = (*os.File)(f) // 隐式转换, *os.File 满足 io.ReadCloser 接口
    b io.Reader     = a             // 隐式转换, io.ReadCloser 满足 io.Reader 接口
    c io.Closer     = a             // 隐式转换, io.ReadCloser 满足 io.Closer 接口
    d io.Reader     = c.(io.Reader) // 显式转换, io.Closer 不满足 io.Reader 接口
)
有时候对象和接口之间太灵活了,导致我们需要人为地限制这种无意之间的适配。常见的做法是定义一个含特殊方法来区分接口。比如 runtime 包中的 Error 接口就定义了一个特有的 RuntimeError 方法,用于避免其它类型无意中适配了该接口:
type runtime.Error interface {
    error

    // RuntimeError is a no-op function but
    // serves to distinguish types that are run time
    // errors from ordinary errors: a type is a
    // run time error if it has a RuntimeError method.
    RuntimeError()
}
在 protobuf 中,Message 接口也采用了类似的方法,也定义了一个特有的 ProtoMessage,用于避免其它类型无意中适配了该接口:
type proto.Message interface {
    Reset()
    String() string
    ProtoMessage()
}
不过这种做法只是君子协定,如果有人刻意伪造一个 proto.Message 接口也是很容易的。再严格一点的做法是给接口定义一个私有方法。只有满足了这个私有方法的对象才可能满足这个接口,而私有方法的名字是包含包的绝对路径名的,因此只能在包内部实现这个私有方法才能满足这个接口。测试包中的 testing.TB 接口就是采用类似的技术:
type testing.TB interface {
    Error(args ...interface{})
    Errorf(format string, args ...interface{})
    ...

    // A private method to prevent users implementing the
    // interface and so future additions to it will not
    // violate Go 1 compatibility.
    private()
}
不过这种通过私有方法禁止外部对象实现接口的做法也是有代价的:首先是这个接口只能包内部使用,外部包正常情况下是无法直接创建满足该接口对象的;其次,这种防护措施也不是绝对的,恶意的用户依然可以绕过这种保护机制。
在前面的方法一节中我们讲到,通过在结构体中嵌入匿名类型成员,可以继承匿名类型的方法。其实这个被嵌入的匿名成员不一定是普通类型,也可以是接口类型。我们可以通过嵌入匿名的 testing.TB 接口来伪造私有的 private 方法,因为接口方法是延迟绑定,编译时 private 方法是否真的存在并不重要。
package main

import (
    "fmt"
    "testing"
)

type TB struct {
    testing.TB
}

func (p *TB) Fatal(args ...interface{}) {
    fmt.Println("TB.Fatal disabled!")
}

func main() {
    var tb testing.TB = new(TB)
    tb.Fatal("Hello, playground")
}
我们在自己的 TB 结构体类型中重新实现了 Fatal 方法,然后通过将对象隐式转换为 testing.TB 接口类型(因为内嵌了匿名的 testing.TB 对象,因此是满足 testing.TB 接口的),然后通过 testing.TB 接口来调用我们自己的 Fatal 方法。
这种通过嵌入匿名接口或嵌入匿名指针对象来实现继承的做法其实是一种纯虚继承,我们继承的只是接口指定的规范,真正的实现在运行的时候才被注入。比如,我们可以模拟实现一个gRPC的插件:
type grpcPlugin struct {
    *generator.Generator
}

func (p *grpcPlugin) Name() string { return "grpc" }

func (p *grpcPlugin) Init(g *generator.Generator) {
    p.Generator = g
}

func (p *grpcPlugin) GenerateImports(file *generator.FileDescriptor) {
    if len(file.Service) == 0 {
        return
    }

    p.P(`import "google.golang.org/grpc"`)
    // ...
}
构造的 grpcPlugin 类型对象必须满足 generate.Plugin 接口(在"github.com/golang/protobuf/protoc-gen-go/generator"包中):
type Plugin interface {
    // Name identifies the plugin.
    Name() string
    // Init is called once after data structures are built but before
    // code generation begins.
    Init(g *Generator)
    // Generate produces the code generated by the plugin for this file,
    // except for the imports, by calling the generator's methods
    // P, In, and Out.
    Generate(file *FileDescriptor)
    // GenerateImports produces the import declarations for this file.
    // It is called after Generate.
    GenerateImports(file *FileDescriptor)
}generate.Plugin接口对应的 grpcPlugin 类型的 GenerateImports 方法中使用的 p.P(...) 函数却是通过 Init 函数注入的 generator.Generator 对象实现。这里的 generator.Generator 对应一个具体类型,但是如果 generator.Generator 是接口类型的话我们甚至可以传入直接的实现。
Go 语言通过几种简单特性的组合,就轻易就实现了鸭子面向对象和虚拟继承等高级特性,真的是不可思议。
面向并发的内存模型
在早期,CPU 都是以单核的形式顺序执行机器指令。Go 语言的祖先 C 语言正是这种顺序编程语言的代表。顺序编程语言中的顺序是指:所有的指令都是以串行的方式执行,在相同的时刻有且仅有一个 CPU 在顺序执行程序的指令。
随着处理器技术的发展,单核时代以提升处理器频率来提高运行效率的方式遇到了瓶颈,目前各种主流的 CPU 频率基本被锁定在了 3Ghz 附近。单核 CPU 的发展的停滞,给多核 CPU 的发展带来了机遇。相应地,编程语言也开始逐步向并行化的方向发展。Go 语言正是在多核和网络化的时代背景下诞生的原生支持并发的编程语言。
常见的并行编程有多种模型,主要有多线程、消息传递等。从理论上来看,多线程和基于消息的并发编程是等价的。由于多线程并发模型可以自然对应到多核的处理器,主流的操作系统因此也都提供了系统级的多线程支持,同时从概念上讲多线程似乎也更直观,因此多线程编程模型逐步被吸纳到主流的编程语言特性或语言扩展库中。而主流编程语言对基于消息的并发编程模型支持则相比较少,Erlang 语言是支持基于消息传递并发编程模型的代表者,它的并发体之间不共享内存。Go 语言是基于消息并发模型的集大成者,它将基于 CSP 模型的并发编程内置到了语言中,通过一个 go 关键字就可以轻易地启动一个 Goroutine,与 Erlang 不同的是 Go 语言的 Goroutine 之间是共享内存的。
1.5.1 Goroutine和系统线程
Goroutine是 Go 语言特有的并发体,是一种轻量级的线程,由 go 关键字启动。在真实的 Go 语言的实现中,goroutine 和系统线程也不是等价的。尽管两者的区别实际上只是一个量的区别,但正是这个量变引发了 Go 语言并发编程质的飞跃。
首先,每个系统级线程都会有一个固定大小的栈(一般默认可能是 2MB),这个栈主要用来保存函数递归调用时参数和局部变量。固定了栈的大小导致了两个问题:一是对于很多只需要很小的栈空间的线程来说是一个巨大的浪费,二是对于少数需要巨大栈空间的线程来说又面临栈溢出的风险。针对这两个问题的解决方案是:要么降低固定的栈大小,提升空间的利用率;要么增大栈的大小以允许更深的函数递归调用,但这两者是没法同时兼得的。相反,一个 Goroutine 会以一个很小的栈启动(可能是 2KB 或 4KB),当遇到深度递归导致当前栈空间不足时,Goroutine 会根据需要动态地伸缩栈的大小(主流实现中栈的最大值可达到1GB)。因为启动的代价很小,所以我们可以轻易地启动成千上万个 Goroutine。
Go的运行时还包含了其自己的调度器,这个调度器使用了一些技术手段,可以在 n 个操作系统线程上多工调度 m 个 Goroutine。Go 调度器的工作和内核的调度是相似的,但是这个调度器只关注单独的 Go 程序中的 Goroutine。Goroutine 采用的是半抢占式的协作调度,只有在当前 Goroutine 发生阻塞时才会导致调度;同时发生在用户态,调度器会根据具体函数只保存必要的寄存器,切换的代价要比系统线程低得多。运行时有一个 runtime.GOMAXPROCS 变量,用于控制当前运行正常非阻塞 Goroutine 的系统线程数目。
在 Go 语言中启动一个 Goroutine 不仅和调用函数一样简单,而且 Goroutine 之间调度代价也很低,这些因素极大地促进了并发编程的流行和发展。
1.5.2 原子操作
所谓的原子操作就是并发编程中“最小的且不可并行化”的操作。通常,如果多个并发体对同一个共享资源进行的操作是原子的话,那么同一时刻最多只能有一个并发体对该资源进行操作。从线程角度看,在当前线程修改共享资源期间,其它的线程是不能访问该资源的。原子操作对于多线程并发编程模型来说,不会发生有别于单线程的意外情况,共享资源的完整性可以得到保证。
一般情况下,原子操作都是通过“互斥”访问来保证的,通常由特殊的 CPU 指令提供保护。当然,如果仅仅是想模拟下粗粒度的原子操作,我们可以借助于 sync.Mutex 来实现:
import (
    "sync"
)

var total struct {
    sync.Mutex
    value int
}

func worker(wg *sync.WaitGroup) {
    defer wg.Done()

    for i := 0; i <= 100; i++ {
        total.Lock()
        total.value += i
        total.Unlock()
    }
}

func main() {
    var wg sync.WaitGroup
    wg.Add(2)
    go worker(&wg)
    go worker(&wg)
    wg.Wait()

    fmt.Println(total.value)
}
在 worker 的循环中,为了保证 total.value += i 的原子性,我们通过 sync.Mutex 加锁和解锁来保证该语句在同一时刻只被一个线程访问。对于多线程模型的程序而言,进出临界区前后进行加锁和解锁都是必须的。如果没有锁的保护,total 的最终值将由于多线程之间的竞争而可能会不正确。
用互斥锁来保护一个数值型的共享资源,麻烦且效率低下。标准库的 sync/atomic 包对原子操作提供了丰富的支持。我们可以重新实现上面的例子:
import (
    "sync"
    "sync/atomic"
)

var total uint64

func worker(wg *sync.WaitGroup) {
    defer wg.Done()

    var i uint64
    for i = 0; i <= 100; i++ {
        atomic.AddUint64(&total, i)
    }
}

func main() {
    var wg sync.WaitGroup
    wg.Add(2)

    go worker(&wg)
    go worker(&wg)
    wg.Wait()
}
atomic.AddUint64 函数调用保证了 total 的读取、更新和保存是一个原子操作,因此在多线程中访问也是安全的。
原子操作配合互斥锁可以实现非常高效的单件模式。互斥锁的代价比普通整数的原子读写高很多,在性能敏感的地方可以增加一个数字型的标志位,通过原子检测标志位状态降低互斥锁的使用次数来提高性能。
type singleton struct {}

var (
    instance    *singleton
    initialized uint32
    mu          sync.Mutex
)

func Instance() *singleton {
    if atomic.LoadUint32(&initialized) == 1 {
        return instance
    }

    mu.Lock()
    defer mu.Unlock()

    if instance == nil {
        defer atomic.StoreUint32(&initialized, 1)
        instance = &singleton{}
    }
    return instance
}
我们可以将通用的代码提取出来,就成了标准库中 sync.Once 的实现:
type Once struct {
    m    Mutex
    done uint32
}

func (o *Once) Do(f func()) {
    if atomic.LoadUint32(&o.done) == 1 {
        return
    }

    o.m.Lock()
    defer o.m.Unlock()

    if o.done == 0 {
        defer atomic.StoreUint32(&o.done, 1)
        f()
    }
}
基于 sync.Once 重新实现单件模式:
var (
    instance *singleton
    once     sync.Once
)

func Instance() *singleton {
    once.Do(func() {
        instance = &singleton{}
    })
    return instance
}
sync/atomic 包对基本的数值类型及复杂对象的读写都提供了原子操作的支持。atomic.Value 原子对象提供了 Load 和 Store 两个原子方法,分别用于加载和保存数据,返回值和参数都是 interface{} 类型,因此可以用于任意的自定义复杂类型。
var config atomic.Value // 保存当前配置信息

// 初始化配置信息
config.Store(loadConfig())

// 启动一个后台线程, 加载更新后的配置信息
go func() {
    for {
        time.Sleep(time.Second)
        config.Store(loadConfig())
    }
}()

// 用于处理请求的工作者线程始终采用最新的配置信息
for i := 0; i < 10; i++ {
    go func() {
        for r := range requests() {
            c := config.Load()
            // ...
        }
    }()
}
这是一个简化的生产者消费者模型:后台线程生成最新的配置信息;前台多个工作者线程获取最新的配置信息。所有线程共享配置信息资源。
1.5.3 顺序一致性内存模型
如果只是想简单地在线程之间进行数据同步的话,原子操作已经为编程人员提供了一些同步保障。不过这种保障有一个前提:顺序一致性的内存模型。要了解顺序一致性,我们先看看一个简单的例子:
var a string
var done bool

func setup() {
    a = "hello, world"
    done = true
}

func main() {
    go setup()
    for !done {}
    print(a)
}
我们创建了 setup 线程,用于对字符串 a 的初始化工作,初始化完成之后设置 done 标志为 true。main 函数所在的主线程中,通过 for !done {} 检测 done 变为 true 时,认为字符串初始化工作完成,然后进行字符串的打印工作。
但是 Go 语言并不保证在 main 函数中观测到的对 done 的写入操作发生在对字符串 a 的写入的操作之后,因此程序很可能打印一个空字符串。更糟糕的是,因为两个线程之间没有同步事件,setup线程对 done 的写入操作甚至无法被 main 线程看到,main函数有可能陷入死循环中。
在 Go 语言中,同一个 Goroutine 线程内部,顺序一致性内存模型是得到保证的。但是不同的 Goroutine 之间,并不满足顺序一致性内存模型,需要通过明确定义的同步事件来作为同步的参考。如果两个事件不可排序,那么就说这两个事件是并发的。为了最大化并行,Go 语言的编译器和处理器在不影响上述规定的前提下可能会对执行语句重新排序(CPU 也会对一些指令进行乱序执行)。
因此,如果在一个 Goroutine 中顺序执行 a = 1; b = 2; 两个语句,虽然在当前的 Goroutine 中可以认为 a = 1; 语句先于 b = 2; 语句执行,但是在另一个 Goroutine 中 b = 2; 语句可能会先于 a = 1; 语句执行,甚至在另一个 Goroutine 中无法看到它们的变化(可能始终在寄存器中)。也就是说在另一个 Goroutine 看来, a = 1; b = 2;两个语句的执行顺序是不确定的。如果一个并发程序无法确定事件的顺序关系,那么程序的运行结果往往会有不确定的结果。比如下面这个程序:
func main() {
    go println("你好, 世界")
}
根据 Go 语言规范,main函数退出时程序结束,不会等待任何后台线程。因为 Goroutine 的执行和 main 函数的返回事件是并发的,谁都有可能先发生,所以什么时候打印,能否打印都是未知的。
用前面的原子操作并不能解决问题,因为我们无法确定两个原子操作之间的顺序。解决问题的办法就是通过同步原语来给两个事件明确排序:
func main() {
    done := make(chan int)

    go func(){
        println("你好, 世界")
        done <- 1
    }()

    <-done
}
当 <-done 执行时,必然要求 done <- 1 也已经执行。根据同一个 Goroutine 依然满足顺序一致性规则,我们可以判断当 done <- 1 执行时,println("你好, 世界") 语句必然已经执行完成了。因此,现在的程序确保可以正常打印结果。
当然,通过 sync.Mutex 互斥量也是可以实现同步的:
func main() {
    var mu sync.Mutex

    mu.Lock()
    go func(){
        println("你好, 世界")
        mu.Unlock()
    }()

    mu.Lock()
}
可以确定后台线程的 mu.Unlock() 必然在 println("你好, 世界") 完成后发生(同一个线程满足顺序一致性),main 函数的第二个 mu.Lock() 必然在后台线程的 mu.Unlock() 之后发生(sync.Mutex 保证),此时后台线程的打印工作已经顺利完成了。
1.5.4 初始化顺序
前面函数章节中我们已经简单介绍过程序的初始化顺序,这是属于 Go 语言面向并发的内存模型的基础规范。
Go程序的初始化和执行总是从 main.main 函数开始的。但是如果 main 包里导入了其它的包,则会按照顺序将它们包含进 main 包里(这里的导入顺序依赖具体实现,一般可能是以文件名或包路径名的字符串顺序导入)。如果某个包被多次导入的话,在执行的时候只会导入一次。当一个包被导入时,如果它还导入了其它的包,则先将其它的包包含进来,然后创建和初始化这个包的常量和变量。然后就是调用包里的 init 函数,如果一个包有多个 init 函数的话,实现可能是以文件名的顺序调用,同一个文件内的多个 init 则是以出现的顺序依次调用(init不是普通函数,可以定义有多个,所以不能被其它函数调用)。最终,在 main 包的所有包常量、包变量被创建和初始化,并且 init 函数被执行后,才会进入 main.main 函数,程序开始正常执行。下图是 Go 程序函数启动顺序的示意图:
图 1-12 包初始化流程
要注意的是,在 main.main 函数执行之前所有代码都运行在同一个 Goroutine 中,也是运行在程序的主系统线程中。如果某个 init 函数内部用 go 关键字启动了新的 Goroutine 的话,新的 Goroutine 和 main.main 函数是并发执行的。
因为所有的 init 函数和 main 函数都是在主线程完成,它们也是满足顺序一致性模型的。
1.5.5 Goroutine的创建
go 语句会在当前 Goroutine 对应函数返回前创建新的 Goroutine。例如:
var a string

func f() {
    print(a)
}

func hello() {
    a = "hello, world"
    go f()
}
执行 go f() 语句创建 Goroutine 和 hello 函数是在同一个 Goroutine 中执行, 根据语句的书写顺序可以确定 Goroutine 的创建发生在 hello 函数返回之前, 但是新创建 Goroutine 对应的 f() 的执行事件和 hello 函数返回的事件则是不可排序的,也就是并发的。调用 hello 可能会在将来的某一时刻打印 "hello, world",也很可能是在 hello 函数执行完成后才打印。
1.5.6 基于 Channel 的通信
Channel 通信是在 Goroutine 之间进行同步的主要方法。在无缓存的 Channel 上的每一次发送操作都有与其对应的接收操作相配对,发送和接收操作通常发生在不同的 Goroutine 上(在同一个 Goroutine 上执行两个操作很容易导致死锁)。无缓存的 Channel 上的发送操作总在对应的接收操作完成前发生.
var done = make(chan bool)
var msg string

func aGoroutine() {
    msg = "你好, 世界"
    done <- true
}

func main() {
    go aGoroutine()
    <-done
    println(msg)
}
可保证打印出“你好, 世界”。该程序首先对 msg 进行写入,然后在 done 管道上发送同步信号,随后从 done 接收对应的同步信号,最后执行 println 函数。
若在关闭 Channel 后继续从中接收数据,接收者就会收到该 Channel 返回的零值。因此在这个例子中,用 close(c) 关闭管道代替 done <- false 依然能保证该程序产生相同的行为。
var done = make(chan bool)
var msg string

func aGoroutine() {
    msg = "你好, 世界"
    close(done)
}

func main() {
    go aGoroutine()
    <-done
    println(msg)
}
对于从无缓冲 Channel 进行的接收,发生在对该 Channel 进行的发送完成之前。
基于上面这个规则可知,交换两个 Goroutine 中的接收和发送操作也是可以的(但是很危险):
var done = make(chan bool)
var msg string

func aGoroutine() {
    msg = "hello, world"
    <-done
}
func main() {
    go aGoroutine()
    done <- true
    println(msg)
}
也可保证打印出“hello, world”。因为 main 线程中 done <- true 发送完成前,后台线程 <-done 接收已经开始,这保证 msg = "hello, world" 被执行了,所以之后 println(msg) 的msg已经被赋值过了。简而言之,后台线程首先对 msg 进行写入,然后从 done 中接收信号,随后 main 线程向 done 发送对应的信号,最后执行 println 函数完成。但是,若该 Channel 为带缓冲的(例如,done = make(chan bool, 1)),main线程的 done <- true 接收操作将不会被后台线程的 <-done 接收操作阻塞,该程序将无法保证打印出“hello, world”。
对于带缓冲的Channel,对于 Channel 的第 K 个接收完成操作发生在第 K+C 个发送操作完成之前,其中 C 是 Channel 的缓存大小。 如果将 C 设置为 0 自然就对应无缓存的 Channel,也即使第 K 个接收完成在第 K 个发送完成之前。因为无缓存的 Channel 只能同步发 1 个,也就简化为前面无缓存 Channel 的规则:对于从无缓冲 Channel 进行的接收,发生在对该 Channel 进行的发送完成之前。
我们可以根据控制 Channel 的缓存大小来控制并发执行的 Goroutine 的最大数目, 例如:
var limit = make(chan int, 3)
var work = []func(){
    func() { println("1"); time.Sleep(1 * time.Second) },
    func() { println("2"); time.Sleep(1 * time.Second) },
    func() { println("3"); time.Sleep(1 * time.Second) },
    func() { println("4"); time.Sleep(1 * time.Second) },
    func() { println("5"); time.Sleep(1 * time.Second) },
}

func main() {
    for _, w := range work {
        go func(w func()) {
            limit <- 1
            w()
            <-limit
        }(w)
    }
    select{}
}
在循环创建 Goroutine 过程中,使用了匿名函数并在函数中引用了循环变量 w,由于 w 是引用传递的而非值传递,因此无法保证 Goroutine 在运行时调用的 w 与循环创建时的 w 是同一个值,为了解决这个问题,我们可以利用函数传参的值复制来为每个 Goroutine 单独复制一份 w。
循环创建结束后,在 main 函数中最后一句 select{} 是一个空的管道选择语句,该语句会导致 main 线程阻塞,从而避免程序过早退出。还有 for{}、<-make(chan int) 等诸多方法可以达到类似的效果。因为 main 线程被阻塞了,如果需要程序正常退出的话可以通过调用 os.Exit(0) 实现。
1.5.7 不靠谱的同步
前面我们已经分析过,下面代码无法保证正常打印结果。实际的运行效果也是大概率不能正常输出结果。
func main() {
    go println("你好, 世界")
}
刚接触 Go 语言的话,可能希望通过加入一个随机的休眠时间来保证正常的输出:
func main() {
    go println("hello, world")
    time.Sleep(time.Second)
}
因为主线程休眠了 1 秒钟,因此这个程序大概率是可以正常输出结果的。因此,很多人会觉得这个程序已经没有问题了。但是这个程序是不稳健的,依然有失败的可能性。我们先假设程序是可以稳定输出结果的。因为 Go 线程的启动是非阻塞的,main 线程显式休眠了 1 秒钟退出导致程序结束,我们可以近似地认为程序总共执行了 1 秒多时间。现在假设 println 函数内部实现休眠的时间大于 main 线程休眠的时间的话,就会导致矛盾:后台线程既然先于 main 线程完成打印,那么执行时间肯定是小于 main 线程执行时间的。当然这是不可能的。
严谨的并发程序的正确性不应该是依赖于 CPU 的执行速度和休眠时间等不靠谱的因素的。严谨的并发也应该是可以静态推导出结果的:根据线程内顺序一致性,结合 Channel 或 sync 同步事件的可排序性来推导,最终完成各个线程各段代码的偏序关系排序。如果两个事件无法根据此规则来排序,那么它们就是并发的,也就是执行先后顺序不可靠的。
解决同步问题的思路是相同的:使用显式的同步。
常见的并发模式
Go 语言最吸引人的地方是它内建的并发支持。Go 语言并发体系的理论是 C.A.R Hoare 在 1978 年提出的 CSP(Communicating Sequential Process,通讯顺序进程)。CSP 有着精确的数学模型,并实际应用在了 Hoare 参与设计的 T9000 通用计算机上。从 NewSqueak、Alef、Limbo 到现在的 Go 语言,对于对 CSP 有着 20 多年实战经验的 Rob Pike 来说,他更关注的是将 CSP 应用在通用编程语言上产生的潜力。作为 Go 并发编程核心的 CSP 理论的核心概念只有一个:同步通信。关于同步通信的话题我们在前面一节已经讲过,本节我们将简单介绍下 Go 语言中常见的并发模式。
首先要明确一个概念:并发不是并行。并发更关注的是程序的设计层面,并发的程序完全是可以顺序执行的,只有在真正的多核 CPU 上才可能真正地同时运行。并行更关注的是程序的运行层面,并行一般是简单的大量重复,例如 GPU 中对图像处理都会有大量的并行运算。为更好的编写并发程序,从设计之初 Go 语言就注重如何在编程语言层级上设计一个简洁安全高效的抽象模型,让程序员专注于分解问题和组合方案,而且不用被线程管理和信号互斥这些繁琐的操作分散精力。
在并发编程中,对共享资源的正确访问需要精确的控制,在目前的绝大多数语言中,都是通过加锁等线程同步方案来解决这一困难问题,而 Go 语言却另辟蹊径,它将共享的值通过 Channel 传递(实际上多个独立执行的线程很少主动共享资源)。在任意给定的时刻,最好只有一个 Goroutine 能够拥有该资源。数据竞争从设计层面上就被杜绝了。为了提倡这种思考方式,Go 语言将其并发编程哲学化为一句口号:
Do not communicate by sharing memory; instead, share memory by communicating.
不要通过共享内存来通信,而应通过通信来共享内存。
这是更高层次的并发编程哲学(通过管道来传值是 Go 语言推荐的做法)。虽然像引用计数这类简单的并发问题通过原子操作或互斥锁就能很好地实现,但是通过 Channel 来控制访问能够让你写出更简洁正确的程序。
1.6.1 并发版本的 Hello world
我们先以在一个新的 Goroutine 中输出“Hello world”,main 等待后台线程输出工作完成之后退出,这样一个简单的并发程序作为热身。
并发编程的核心概念是同步通信,但是同步的方式却有多种。我们先以大家熟悉的互斥量 sync.Mutex 来实现同步通信。根据文档,我们不能直接对一个未加锁状态的 sync.Mutex 进行解锁,这会导致运行时异常。下面这种方式并不能保证正常工作:
func main() {
    var mu sync.Mutex

    go func(){
        fmt.Println("你好, 世界")
        mu.Lock()
    }()

    mu.Unlock()
}
因为 mu.Lock() 和 mu.Unlock() 并不在同一个 Goroutine 中,所以也就不满足顺序一致性内存模型。同时它们也没有其它的同步事件可以参考,这两个事件不可排序也就是可以并发的。因为可能是并发的事件,所以 main 函数中的 mu.Unlock() 很有可能先发生,而这个时刻 mu 互斥对象还处于未加锁的状态,从而会导致运行时异常。
下面是修复后的代码:
func main() {
    var mu sync.Mutex

    mu.Lock()
    go func(){
        fmt.Println("你好, 世界")
        mu.Unlock()
    }()

    mu.Lock()
}
修复的方式是在 main 函数所在线程中执行两次 mu.Lock(),当第二次加锁时会因为锁已经被占用(不是递归锁)而阻塞,main 函数的阻塞状态驱动后台线程继续向前执行。当后台线程执行到 mu.Unlock() 时解锁,此时打印工作已经完成了,解锁会导致 main 函数中的第二个 mu.Lock() 阻塞状态取消,此时后台线程和主线程再没有其它的同步事件参考,它们退出的事件将是并发的:在 main 函数退出导致程序退出时,后台线程可能已经退出了,也可能没有退出。虽然无法确定两个线程退出的时间,但是打印工作是可以正确完成的。
使用 sync.Mutex 互斥锁同步是比较低级的做法。我们现在改用无缓存的管道来实现同步:
func main() {
    done := make(chan int)

    go func(){
        fmt.Println("你好, 世界")
        <-done
    }()

    done <- 1
}
根据 Go 语言内存模型规范,对于从无缓冲 Channel 进行的接收,发生在对该 Channel 进行的发送完成之前。因此,后台线程 <-done 接收操作完成之后,main 线程的 done <- 1 发送操作才可能完成(从而退出 main、退出程序),而此时打印工作已经完成了。
上面的代码虽然可以正确同步,但是对管道的缓存大小太敏感:如果管道有缓存的话,就无法保证 main 退出之前后台线程能正常打印了。更好的做法是将管道的发送和接收方向调换一下,这样可以避免同步事件受管道缓存大小的影响:
func main() {
    done := make(chan int, 1) // 带缓存的管道

    go func(){
        fmt.Println("你好, 世界")
        done <- 1
    }()

    <-done
}
对于带缓冲的 Channel,对于 Channel 的第 K 个接收完成操作发生在第 K+C 个发送操作完成之前,其中 C 是 Channel 的缓存大小。虽然管道是带缓存的,main 线程接收完成是在后台线程发送开始但还未完成的时刻,此时打印工作也是已经完成的。
基于带缓存的管道,我们可以很容易将打印线程扩展到 N 个。下面的例子是开启 10 个后台线程分别打印:
func main() {
    done := make(chan int, 10) // 带 10 个缓存

    // 开 N 个后台打印线程
    for i := 0; i < cap(done); i++ {
        go func(){
            fmt.Println("你好, 世界")
            done <- 1
        }()
    }

    // 等待 N 个后台线程完成
    for i := 0; i < cap(done); i++ {
        <-done
    }
}
对于这种要等待 N 个线程完成后再进行下一步的同步操作有一个简单的做法,就是使用 sync.WaitGroup 来等待一组事件:
func main() {
    var wg sync.WaitGroup

    // 开 N 个后台打印线程
    for i := 0; i < 10; i++ {
        wg.Add(1)

        go func() {
            fmt.Println("你好, 世界")
            wg.Done()
        }()
    }

    // 等待 N 个后台线程完成
    wg.Wait()
}
其中 wg.Add(1) 用于增加等待事件的个数,必须确保在后台线程启动之前执行(如果放到后台线程之中执行则不能保证被正常执行到)。当后台线程完成打印工作之后,调用 wg.Done() 表示完成一个事件。main 函数的 wg.Wait() 是等待全部的事件完成。
1.6.2 生产者消费者模型
并发编程中最常见的例子就是生产者消费者模式,该模式主要通过平衡生产线程和消费线程的工作能力来提高程序的整体处理数据的速度。简单地说,就是生产者生产一些数据,然后放到成果队列中,同时消费者从成果队列中来取这些数据。这样就让生产消费变成了异步的两个过程。当成果队列中没有数据时,消费者就进入饥饿的等待中;而当成果队列中数据已满时,生产者则面临因产品挤压导致 CPU 被剥夺的下岗问题。
Go 语言实现生产者消费者并发很简单:
// 生产者: 生成 factor 整数倍的序列
func Producer(factor int, out chan<- int) {
    for i := 0; ; i++ {
        out <- i*factor
    }
}

// 消费者
func Consumer(in <-chan int) {
    for v := range in {
        fmt.Println(v)
    }
}
func main() {
    ch := make(chan int, 64) // 成果队列

    go Producer(3, ch) // 生成 3 的倍数的序列
    go Producer(5, ch) // 生成 5 的倍数的序列
    go Consumer(ch)    // 消费生成的队列

    // 运行一定时间后退出
    time.Sleep(5 * time.Second)
}
我们开启了 2 个 Producer 生产流水线,分别用于生成 3 和 5 的倍数的序列。然后开启 1 个 Consumer 消费者线程,打印获取的结果。我们通过在 main 函数休眠一定的时间来让生产者和消费者工作一定时间。正如前面一节说的,这种靠休眠方式是无法保证稳定的输出结果的。
我们可以让 main 函数保存阻塞状态不退出,只有当用户输入 Ctrl-C 时才真正退出程序:
func main() {
    ch := make(chan int, 64) // 成果队列

    go Producer(3, ch) // 生成 3 的倍数的序列
    go Producer(5, ch) // 生成 5 的倍数的序列
    go Consumer(ch)    // 消费 生成的队列

    // Ctrl+C 退出
    sig := make(chan os.Signal, 1)
    signal.Notify(sig, syscall.SIGINT, syscall.SIGTERM)
    fmt.Printf("quit (%v)\n", <-sig)
}
我们这个例子中有 2 个生产者,并且 2 个生产者之间并无同步事件可参考,它们是并发的。因此,消费者输出的结果序列的顺序是不确定的,这并没有问题,生产者和消费者依然可以相互配合工作。
1.6.3 发布订阅模型
发布订阅(publish-and-subscribe)模型通常被简写为 pub/sub 模型。在这个模型中,消息生产者成为发布者(publisher),而消息消费者则成为订阅者(subscriber),生产者和消费者是 M:N 的关系。在传统生产者和消费者模型中,是将消息发送到一个队列中,而发布订阅模型则是将消息发布给一个主题。
为此,我们构建了一个名为 pubsub 的发布订阅模型支持包:
// Package pubsub implements a simple multi-topic pub-sub library.
package pubsub

import (
    "sync"
    "time"
)

type (
    subscriber chan interface{}         // 订阅者为一个管道
    topicFunc  func(v interface{}) bool // 主题为一个过滤器
)

// 发布者对象
type Publisher struct {
    m           sync.RWMutex             // 读写锁
    buffer      int                      // 订阅队列的缓存大小
    timeout     time.Duration            // 发布超时时间
    subscribers map[subscriber]topicFunc // 订阅者信息
}

// 构建一个发布者对象, 可以设置发布超时时间和缓存队列的长度
func NewPublisher(publishTimeout time.Duration, buffer int) *Publisher {
    return &Publisher{
        buffer:      buffer,
        timeout:     publishTimeout,
        subscribers: make(map[subscriber]topicFunc),
    }
}

// 添加一个新的订阅者,订阅全部主题
func (p *Publisher) Subscribe() chan interface{} {
    return p.SubscribeTopic(nil)
}

// 添加一个新的订阅者,订阅过滤器筛选后的主题
func (p *Publisher) SubscribeTopic(topic topicFunc) chan interface{} {
    ch := make(chan interface{}, p.buffer)
    p.m.Lock()
    p.subscribers[ch] = topic
    p.m.Unlock()
    return ch
}

// 退出订阅
func (p *Publisher) Evict(sub chan interface{}) {
    p.m.Lock()
    defer p.m.Unlock()

    delete(p.subscribers, sub)
    close(sub)
}

// 发布一个主题
func (p *Publisher) Publish(v interface{}) {
    p.m.RLock()
    defer p.m.RUnlock()

    var wg sync.WaitGroup
    for sub, topic := range p.subscribers {
        wg.Add(1)
        go p.sendTopic(sub, topic, v, &wg)
    }
    wg.Wait()
}

// 关闭发布者对象,同时关闭所有的订阅者管道。
func (p *Publisher) Close() {
    p.m.Lock()
    defer p.m.Unlock()

    for sub := range p.subscribers {
        delete(p.subscribers, sub)
        close(sub)
    }
}

// 发送主题,可以容忍一定的超时
func (p *Publisher) sendTopic(
    sub subscriber, topic topicFunc, v interface{}, wg *sync.WaitGroup,
) {
    defer wg.Done()
    if topic != nil && !topic(v) {
        return
    }

    select {
    case sub <- v:
    case <-time.After(p.timeout):
    }
}
下面的例子中,有两个订阅者分别订阅了全部主题和含有"golang"的主题:
import "path/to/pubsub"

func main() {
    p := pubsub.NewPublisher(100*time.Millisecond, 10)
    defer p.Close()

    all := p.Subscribe()
    golang := p.SubscribeTopic(func(v interface{}) bool {
        if s, ok := v.(string); ok {
            return strings.Contains(s, "golang")
        }
        return false
    })

    p.Publish("hello,  world!")
    p.Publish("hello, golang!")

    go func() {
        for  msg := range all {
            fmt.Println("all:", msg)
        }
    } ()

    go func() {
        for  msg := range golang {
            fmt.Println("golang:", msg)
        }
    } ()

    // 运行一定时间后退出
    time.Sleep(3 * time.Second)
}
在发布订阅模型中,每条消息都会传送给多个订阅者。发布者通常不会知道、也不关心哪一个订阅者正在接收主题消息。订阅者和发布者可以在运行时动态添加,是一种松散的耦合关系,这使得系统的复杂性可以随时间的推移而增长。在现实生活中,像天气预报之类的应用就可以应用这个并发模式。
1.6.4 控制并发数
很多用户在适应了 Go 语言强大的并发特性之后,都倾向于编写最大并发的程序,因为这样似乎可以提供最大的性能。在现实中我们行色匆匆,但有时却需要我们放慢脚步享受生活,并发的程序也是一样:有时候我们需要适当地控制并发的程度,因为这样不仅仅可给其它的应用/任务让出/预留一定的 CPU 资源,也可以适当降低功耗缓解电池的压力。
在 Go 语言自带的 godoc 程序实现中有一个 vfs 的包对应虚拟的文件系统,在 vfs 包下面有一个 gatefs 的子包,gatefs 子包的目的就是为了控制访问该虚拟文件系统的最大并发数。gatefs 包的应用很简单:
import (
    "golang.org/x/tools/godoc/vfs"
    "golang.org/x/tools/godoc/vfs/gatefs"
)

func main() {
    fs := gatefs.New(vfs.OS("/path"), make(chan bool, 8))
    // ...
}
其中 vfs.OS("/path") 基于本地文件系统构造一个虚拟的文件系统,然后 gatefs.New 基于现有的虚拟文件系统构造一个并发受控的虚拟文件系统。并发数控制的原理在前面一节已经讲过,就是通过带缓存管道的发送和接收规则来实现最大并发阻塞:
var limit = make(chan int, 3)

func main() {
    for _, w := range work {
        go func() {
            limit <- 1
            w()
            <-limit
        }()
    }
    select{}
}
不过 gatefs 对此做一个抽象类型 gate,增加了 enter 和 leave 方法分别对应并发代码的进入和离开。当超出并发数目限制的时候,enter 方法会阻塞直到并发数降下来为止。
type gate chan bool

func (g gate) enter() { g <- true }
func (g gate) leave() { <-g }
gatefs 包装的新的虚拟文件系统就是将需要控制并发的方法增加了 enter 和 leave 调用而已:
type gatefs struct {
    fs vfs.FileSystem
    gate
}

func (fs gatefs) Lstat(p string) (os.FileInfo, error) {
    fs.enter()
    defer fs.leave()
    return fs.fs.Lstat(p)
}
我们不仅可以控制最大的并发数目,而且可以通过带缓存 Channel 的使用量和最大容量比例来判断程序运行的并发率。当管道为空的时候可以认为是空闲状态,当管道满了时任务是繁忙状态,这对于后台一些低级任务的运行是有参考价值的。
1.6.5 赢者为王
采用并发编程的动机有很多:并发编程可以简化问题,比如一类问题对应一个处理线程会更简单;并发编程还可以提升性能,在一个多核 CPU 上开 2 个线程一般会比开 1 个线程快一些。其实对于提升性能而言,程序并不是简单地运行速度快就表示用户体验好的;很多时候程序能快速响应用户请求才是最重要的,当没有用户请求需要处理的时候才合适处理一些低优先级的后台任务。
假设我们想快速地搜索“golang”相关的主题,我们可能会同时打开 Bing、Google 或百度等多个检索引擎。当某个搜索最先返回结果后,就可以关闭其它搜索页面了。因为受网络环境和搜索引擎算法的影响,某些搜索引擎可能很快返回搜索结果,某些搜索引擎也可能等到他们公司倒闭也没有完成搜索。我们可以采用类似的策略来编写这个程序:
func main() {
    ch := make(chan string, 32)

    go func() {
        ch <- searchByBing("golang")
    }()
    go func() {
        ch <- searchByGoogle("golang")
    }()
    go func() {
        ch <- searchByBaidu("golang")
    }()

    fmt.Println(<-ch)
}
首先,我们创建了一个带缓存的管道,管道的缓存数目要足够大,保证不会因为缓存的容量引起不必要的阻塞。然后我们开启了多个后台线程,分别向不同的搜索引擎提交搜索请求。当任意一个搜索引擎最先有结果之后,都会马上将结果发到管道中(因为管道带了足够的缓存,这个过程不会阻塞)。但是最终我们只从管道取第一个结果,也就是最先返回的结果。
通过适当开启一些冗余的线程,尝试用不同途径去解决同样的问题,最终以赢者为王的方式提升了程序的相应性能。
1.6.6 素数筛
在“Hello world 的革命”一节中,我们为了演示 Newsqueak 的并发特性,文中给出了并发版本素数筛的实现。并发版本的素数筛是一个经典的并发例子,通过它我们可以更深刻地理解 Go 语言的并发特性。“素数筛”的原理如图:
图 1-13 素数筛
我们需要先生成最初的 2, 3, 4, ... 自然数序列(不包含开头的 0、1):
// 返回生成自然数序列的管道: 2, 3, 4, ...
func GenerateNatural() chan int {
    ch := make(chan int)
    go func() {
        for i := 2; ; i++ {
            ch <- i
        }
    }()
    return ch
}
GenerateNatural 函数内部启动一个 Goroutine 生产序列,返回对应的管道。
然后是为每个素数构造一个筛子:将输入序列中是素数倍数的数提出,并返回新的序列,是一个新的管道。
// 管道过滤器: 删除能被素数整除的数
func PrimeFilter(in <-chan int, prime int) chan int {
    out := make(chan int)
    go func() {
        for {
            if i := <-in; i%prime != 0 {
                out <- i
            }
        }
    }()
    return out
}
PrimeFilter 函数也是内部启动一个 Goroutine 生产序列,返回过滤后序列对应的管道。
现在我们可以在 main 函数中驱动这个并发的素数筛了:
func main() {
    ch := GenerateNatural() // 自然数序列: 2, 3, 4, ...
    for i := 0; i < 100; i++ {
        prime := <-ch // 新出现的素数
        fmt.Printf("%v: %v\n", i+1, prime)
        ch = PrimeFilter(ch, prime) // 基于新素数构造的过滤器
    }
}
我们先是调用 GenerateNatural() 生成最原始的从 2 开始的自然数序列。然后开始一个 100 次迭代的循环,希望生成 100 个素数。在每次循环迭代开始的时候,管道中的第一个数必定是素数,我们先读取并打印这个素数。然后基于管道中剩余的数列,并以当前取出的素数为筛子过滤后面的素数。不同的素数筛子对应的管道是串联在一起的。
素数筛展示了一种优雅的并发程序结构。但是因为每个并发体处理的任务粒度太细微,程序整体的性能并不理想。对于细粒度的并发程序,CSP 模型中固有的消息传递的代价太高了(多线程并发模型同样要面临线程启动的代价)。
1.6.7 并发的安全退出
有时候我们需要通知 Goroutine 停止它正在干的事情,特别是当它工作在错误的方向上的时候。Go 语言并没有提供在一个直接终止 Goroutine 的方法,由于这样会导致 Goroutine 之间的共享变量处在未定义的状态上。但是如果我们想要退出两个或者任意多个 Goroutine 怎么办呢?
Go 语言中不同 Goroutine 之间主要依靠管道进行通信和同步。要同时处理多个管道的发送或接收操作,我们需要使用 select 关键字(这个关键字和网络编程中的 select 函数的行为类似)。当 select 有多个分支时,会随机选择一个可用的管道分支,如果没有可用的管道分支则选择 default 分支,否则会一直保存阻塞状态。
基于 select 实现的管道的超时判断:
select {
case v := <-in:
    fmt.Println(v)
case <-time.After(time.Second):
    return // 超时
}
通过 select 的 default 分支实现非阻塞的管道发送或接收操作:
select {
case v := <-in:
    fmt.Println(v)
default:
    // 没有数据
}
通过 select 来阻止 main 函数退出:
func main() {
    // do some thins
    select{}
}当有多个管道均可操作时,select 会随机选择一个管道。基于该特性我们可以用 select 实现一个生成随机数序列的程序:
func main() {
    ch := make(chan int)
    go func() {
        for {
            select {
            case ch <- 0:
            case ch <- 1:
            }
        }
    }()

    for v := range ch {
        fmt.Println(v)
    }
}
我们通过 select 和 default 分支可以很容易实现一个 Goroutine 的退出控制:
func worker(cancel chan bool) {
    for {
        select {
        default:
            fmt.Println("hello")
            // 正常工作
        case <-cancel:
            // 退出
        }
    }
}

func main() {
    cancel := make(chan bool)
    go worker(cancel)

    time.Sleep(time.Second)
    cancel <- true
}
但是管道的发送操作和接收操作是一一对应的,如果要停止多个 Goroutine 那么可能需要创建同样数量的管道,这个代价太大了。其实我们可以通过 close 关闭一个管道来实现广播的效果,所有从关闭管道接收的操作均会收到一个零值和一个可选的失败标志。
func worker(cancel chan bool) {
    for {
        select {
        default:
            fmt.Println("hello")
            // 正常工作
        case <-cancel:
            // 退出
        }
    }
}

func main() {
    cancel := make(chan bool)

    for i := 0; i < 10; i++ {
        go worker(cancel)
    }

    time.Sleep(time.Second)
    close(cancel)
}
我们通过 close 来关闭 cancel 管道向多个 Goroutine 广播退出的指令。不过这个程序依然不够稳健:当每个 Goroutine 收到退出指令退出时一般会进行一定的清理工作,但是退出的清理工作并不能保证被完成,因为 main 线程并没有等待各个工作 Goroutine 退出工作完成的机制。我们可以结合 sync.WaitGroup 来改进:
func worker(wg *sync.WaitGroup, cancel chan bool) {
    defer wg.Done()

    for {
        select {
        default:
            fmt.Println("hello")
        case <-cancel:
            return
        }
    }
}

func main() {
    cancel := make(chan bool)

    var wg sync.WaitGroup
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go worker(&wg, cancel)
    }

    time.Sleep(time.Second)
    close(cancel)
    wg.Wait()
}
现在每个工作者并发体的创建、运行、暂停和退出都是在 main 函数的安全控制之下了。
1.6.8 context 包
在 Go1.7 发布时,标准库增加了一个 context 包,用来简化对于处理单个请求的多个 Goroutine 之间与请求域的数据、超时和退出等操作,官方有博文对此做了专门介绍。我们可以用 context 包来重新实现前面的线程安全退出或超时的控制:
func worker(ctx context.Context, wg *sync.WaitGroup) error {
    defer wg.Done()

    for {
        select {
        default:
            fmt.Println("hello")
        case <-ctx.Done():
            return ctx.Err()
        }
    }
}

func main() {
    ctx, cancel := context.WithTimeout(context.Background(), 10*time.Second)

    var wg sync.WaitGroup
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go worker(ctx, &wg)
    }

    time.Sleep(time.Second)
    cancel()

    wg.Wait()
}
当并发体超时或 main 主动停止工作者 Goroutine 时,每个工作者都可以安全退出。
Go 语言是带内存自动回收特性的,因此内存一般不会泄漏。在前面素数筛的例子中,GenerateNatural 和 PrimeFilter 函数内部都启动了新的 Goroutine,当 main 函数不再使用管道时后台 Goroutine 有泄漏的风险。我们可以通过 context 包来避免这个问题,下面是改进的素数筛实现:
// 返回生成自然数序列的管道: 2, 3, 4, ...
func GenerateNatural(ctx context.Context) chan int {
    ch := make(chan int)
    go func() {
        for i := 2; ; i++ {
            select {
            case <- ctx.Done():
                return
            case ch <- i:
            }
        }
    }()
    return ch
}

// 管道过滤器: 删除能被素数整除的数
func PrimeFilter(ctx context.Context, in <-chan int, prime int) chan int {
    out := make(chan int)
    go func() {
        for {
            if i := <-in; i%prime != 0 {
                select {
                case <- ctx.Done():
                    return
                case out <- i:
                }
            }
        }
    }()
    return out
}

func main() {
    // 通过 Context 控制后台 Goroutine 状态
    ctx, cancel := context.WithCancel(context.Background())

    ch := GenerateNatural(ctx) // 自然数序列: 2, 3, 4, ...
    for i := 0; i < 100; i++ {
        prime := <-ch // 新出现的素数
        fmt.Printf("%v: %v\n", i+1, prime)
        ch = PrimeFilter(ctx, ch, prime) // 基于新素数构造的过滤器
    }

    cancel()
}
当 main 函数完成工作前,通过调用 cancel() 来通知后台 Goroutine 退出,这样就避免了 Goroutine 的泄漏。
然而,上面这个例子只是展示了 cancel() 的基础用法,实际上这个例子会导致 Goroutine 死锁,不能正常退出。
我们可以给上面这个例子添加 sync.WaitGroup 来复现这个问题。
package main

import (
    "context"
    "fmt"
    "sync"
)

// 返回生成自然数序列的管道: 2, 3, 4, ...
func GenerateNatural(ctx context.Context, wg *sync.WaitGroup) chan int {
    ch := make(chan int)
    go func() {
        defer wg.Done()
        for i := 2; ; i++ {
            select {
            case <-ctx.Done():
                return
            case ch <- i:
            }
        }
    }()
    return ch
}

// 管道过滤器: 删除能被素数整除的数
func PrimeFilter(ctx context.Context, in <-chan int, prime int, wg *sync.WaitGroup) chan int {
    out := make(chan int)
    go func() {
        defer wg.Done()
        for {
            if i := <-in; i%prime != 0 {
                select {
                case <-ctx.Done():
                    return
                case out <- i:
                }
            }
        }
    }()
    return out
}

func main() {
    wg := sync.WaitGroup{}
    // 通过 Context 控制后台 Goroutine 状态
    ctx, cancel := context.WithCancel(context.Background())
    wg.Add(1)
    ch := GenerateNatural(ctx, &wg) // 自然数序列: 2, 3, 4, ...
    for i := 0; i < 100; i++ {
        prime := <-ch // 新出现的素数
        fmt.Printf("%v: %v\n", i+1, prime)
        wg.Add(1)
        ch = PrimeFilter(ctx, ch, prime, &wg) // 基于新素数构造的过滤器
    }

    cancel()
    wg.Wait()
}
执行上面这个例子很容易就复现了死锁的问题,原因是素数筛中的 ctx.Done() 位于 if i := <-in; i%prime != 0 判断之内,
而这个判断可能会一直阻塞,导致 Goroutine 无法正常退出。让我们来解决这个问题。
package main

import (
    "context"
    "fmt"
    "sync"
)

// 返回生成自然数序列的管道: 2, 3, 4, ...
func GenerateNatural(ctx context.Context, wg *sync.WaitGroup) chan int {
    ch := make(chan int)
    go func() {
        defer wg.Done()
        for i := 2; ; i++ {
            select {
            case <-ctx.Done():
                return
            case ch <- i:
            }
        }
    }()
    return ch
}

// 管道过滤器: 删除能被素数整除的数
func PrimeFilter(ctx context.Context, in <-chan int, prime int, wg *sync.WaitGroup) chan int {
    out := make(chan int)
    go func() {
        defer wg.Done()
        for {
            select {
            case <-ctx.Done():
                return
            case i := <-in:
                if i%prime != 0 {
                    select {
                    case <-ctx.Done():
                        return
                    case out <- i:
                    }
                }
            }

        }
    }()
    return out
}

func main() {
    wg := sync.WaitGroup{}
    // 通过 Context 控制后台 Goroutine 状态
    ctx, cancel := context.WithCancel(context.Background())
    wg.Add(1)
    ch := GenerateNatural(ctx, &wg) // 自然数序列: 2, 3, 4, ...
    for i := 0; i < 100; i++ {
        prime := <-ch // 新出现的素数
        fmt.Printf("%v: %v\n", i+1, prime)
        wg.Add(1)
        ch = PrimeFilter(ctx, ch, prime, &wg) // 基于新素数构造的过滤器
    }

    cancel()
    wg.Wait()
}
如上所示,我们可以通过将 i := <-in 放入 select,在这个 select 内也执行 <-ctx.Done() 来解决阻塞导致的死锁。
不过上面这个例子并不优美,让我们换一种方式。
package main

import (
    "context"
    "fmt"
    "sync"
)

// 返回生成自然数序列的管道: 2, 3, 4, ...
func GenerateNatural(ctx context.Context, wg *sync.WaitGroup) chan int {
    ch := make(chan int)
    go func() {
        defer wg.Done()
        defer close(ch)
        for i := 2; ; i++ {
            select {
            case <-ctx.Done():
                return
            case ch <- i:
            }
        }
    }()
    return ch
}

// 管道过滤器: 删除能被素数整除的数
func PrimeFilter(ctx context.Context, in <-chan int, prime int, wg *sync.WaitGroup) chan int {
    out := make(chan int)
    go func() {
        defer wg.Done()
        defer close(out)
        for i := range in {
            if i%prime != 0 {
                select {
                case <-ctx.Done():
                    return
                case out <- i:
                }
            }
        }
    }()
    return out
}

func main() {
    wg := sync.WaitGroup{}
    // 通过 Context 控制后台 Goroutine 状态
    ctx, cancel := context.WithCancel(context.Background())
    wg.Add(1)
    ch := GenerateNatural(ctx, &wg) // 自然数序列: 2, 3, 4, ...
    for i := 0; i < 100; i++ {
        prime := <-ch // 新出现的素数
        fmt.Printf("%v: %v\n", i+1, prime)
        wg.Add(1)
        ch = PrimeFilter(ctx, ch, prime, &wg) // 基于新素数构造的过滤器
    }

    cancel()
    wg.Wait()
}
在上面这个例子中主要有以下几点需要关注:
- 通过
for range循环保证了输入管道被关闭时,循环能退出,不会出现死循环; - 通过
defer close保证了无论是输入管道被关闭,还是 ctx 被取消,只要素数筛退出,都会关闭输出管道。
至此,我们终于足够优美地解决了这个死锁问题。
并发是一个非常大的主题,我们这里只是展示几个非常基础的并发编程的例子。官方文档也有很多关于并发编程的讨论,国内也有专门讨论 Go 语言并发编程的书籍。读者可以根据自己的需求查阅相关的文献。
错误和异常
错误处理是每个编程语言都要考虑的一个重要话题。在 Go 语言的错误处理中,错误是软件包 API 和应用程序用户界面的一个重要组成部分。
在程序中总有一部分函数总是要求必须能够成功的运行。比如 strconv.Itoa 将整数转换为字符串,从数组或切片中读写元素,从 map 读取已经存在的元素等。这类操作在运行时几乎不会失败,除非程序中有 BUG,或遇到灾难性的、不可预料的情况,比如运行时的内存溢出。如果真的遇到真正异常情况,我们只要简单终止程序就可以了。
排除异常的情况,如果程序运行失败仅被认为是几个预期的结果之一。对于那些将运行失败看作是预期结果的函数,它们会返回一个额外的返回值,通常是最后一个来传递错误信息。如果导致失败的原因只有一个,额外的返回值可以是一个布尔值,通常被命名为 ok。比如,当从一个 map 查询一个结果时,可以通过额外的布尔值判断是否成功:
if v, ok := m["key"]; ok {
    return v
}
但是导致失败的原因通常不止一种,很多时候用户希望了解更多的错误信息。如果只是用简单的布尔类型的状态值将不能满足这个要求。在 C 语言中,默认采用一个整数类型的 errno 来表达错误,这样就可以根据需要定义多种错误类型。在 Go 语言中,syscall.Errno 就是对应 C 语言中 errno 类型的错误。在 syscall 包中的接口,如果有返回错误的话,底层也是 syscall.Errno 错误类型。
比如我们通过 syscall 包的接口来修改文件的模式时,如果遇到错误我们可以通过将 err 强制断言为 syscall.Errno 错误类型来处理:
err := syscall.Chmod(":invalid path:", 0666)
if err != nil {
    log.Fatal(err.(syscall.Errno))
}
我们还可以进一步地通过类型查询或类型断言来获取底层真实的错误类型,这样就可以获取更详细的错误信息。不过一般情况下我们并不关心错误在底层的表达方式,我们只需要知道它是一个错误就可以了。当返回的错误值不是 nil 时,我们可以通过调用 error 接口类型的 Error 方法来获得字符串类型的错误信息。
在 Go 语言中,错误被认为是一种可以预期的结果;而异常则是一种非预期的结果,发生异常可能表示程序中存在 BUG 或发生了其它不可控的问题。Go 语言推荐使用 recover 函数将内部异常转为错误处理,这使得用户可以真正的关心业务相关的错误处理。
如果某个接口简单地将所有普通的错误当做异常抛出,将会使错误信息杂乱且没有价值。就像在 main 函数中直接捕获全部一样,是没有意义的:
func main() {
    defer func() {
        if r := recover(); r != nil {
            log.Fatal(r)
        }
    }()

    ...
}
捕获异常不是最终的目的。如果异常不可预测,直接输出异常信息是最好的处理方式。
1.7.1 错误处理策略
让我们演示一个文件复制的例子:函数需要打开两个文件,然后将其中一个文件的内容复制到另一个文件:
func CopyFile(dstName, srcName string) (written int64, err error) {
    src, err := os.Open(srcName)
    if err != nil {
        return
    }

    dst, err := os.Create(dstName)
    if err != nil {
        return
    }

    written, err = io.Copy(dst, src)
    dst.Close()
    src.Close()
    return
}
上面的代码虽然能够工作,但是隐藏一个 bug。如果第一个 os.Open 调用成功,但是第二个 os.Create 调用失败,那么会在没有释放 src 文件资源的情况下返回。虽然我们可以通过在第二个返回语句前添加 src.Close() 调用来修复这个 BUG;但是当代码变得复杂时,类似的问题将很难被发现和修复。我们可以通过 defer 语句来确保每个被正常打开的文件都能被正常关闭:
func CopyFile(dstName, srcName string) (written int64, err error) {
    src, err := os.Open(srcName)
    if err != nil {
        return
    }
    defer src.Close()

    dst, err := os.Create(dstName)
    if err != nil {
        return
    }
    defer dst.Close()

    return io.Copy(dst, src)
}defer语句可以让我们在打开文件时马上思考如何关闭文件。不管函数如何返回,文件关闭语句始终会被执行。同时 defer 语句可以保证,即使 io.Copy 发生了异常,文件依然可以安全地关闭。
前文我们说到,Go 语言中的导出函数一般不抛出异常,一个未受控的异常可以看作是程序的 BUG。但是对于那些提供类似 Web 服务的框架而言;它们经常需要接入第三方的中间件。因为第三方的中间件是否存在 BUG 是否会抛出异常,Web 框架本身是不能确定的。为了提高系统的稳定性,Web 框架一般会通过 recover 来防御性地捕获所有处理流程中可能产生的异常,然后将异常转为普通的错误返回。
让我们以 JSON 解析器为例,说明 recover 的使用场景。考虑到 JSON 解析器的复杂性,即使某个语言解析器目前工作正常,也无法肯定它没有漏洞。因此,当某个异常出现时,我们不会选择让解析器崩溃,而是会将 panic 异常当作普通的解析错误,并附加额外信息提醒用户报告此错误。
func ParseJSON(input string) (s *Syntax, err error) {
    defer func() {
        if p := recover(); p != nil {
            err = fmt.Errorf("JSON: internal error: %v", p)
        }
    }()
    // ...parser...
}
标准库中的 json 包,在内部递归解析 JSON 数据的时候如果遇到错误,会通过抛出异常的方式来快速跳出深度嵌套的函数调用,然后由最外一级的接口通过 recover 捕获 panic,然后返回相应的错误信息。
Go 语言库的实现习惯: 即使在包内部使用了 panic,但是在导出函数时会被转化为明确的错误值。
1.7.2 获取错误的上下文
有时候为了方便上层用户理解;底层实现者会将底层的错误重新包装为新的错误类型返回给用户:
if _, err := html.Parse(resp.Body); err != nil {
    return nil, fmt.Errorf("parsing %s as HTML: %v", url,err)
}
上层用户在遇到错误时,可以很容易从业务层面理解错误发生的原因。但是鱼和熊掌总是很难兼得,在上层用户获得新的错误的同时,我们也丢失了底层最原始的错误类型(只剩下错误描述信息了)。
为了记录这种错误类型在包装的变迁过程中的信息,我们一般会定义一个辅助的 WrapError 函数,用于包装原始的错误,同时保留完整的原始错误类型。为了问题定位的方便,同时也为了能记录错误发生时的函数调用状态,我们很多时候希望在出现致命错误的时候保存完整的函数调用信息。同时,为了支持 RPC 等跨网络的传输,我们可能要需要将错误序列化为类似 JSON 格式的数据,然后再从这些数据中将错误解码恢复出来。
为此,我们可以定义自己的 github.com/chai2010/errors 包,里面是以下的错误类型:
type Error interface {
    Caller() []CallerInfo
    Wraped() []error
    Code() int
    error

    private()
}

type CallerInfo struct {
    FuncName string
    FileName string
    FileLine int
}
其中 Error 为接口类型,是 error 接口类型的扩展,用于给错误增加调用栈信息,同时支持错误的多级嵌套包装,支持错误码格式。为了使用方便,我们可以定义以下的辅助函数:
func New(msg string) error
func NewWithCode(code int, msg string) error

func Wrap(err error, msg string) error
func WrapWithCode(code int, err error, msg string) error

func FromJson(json string) (Error, error)
func ToJson(err error) stringNew用于构建新的错误类型,和标准库中 errors.New 功能类似,但是增加了出错时的函数调用栈信息。FromJson 用于从 JSON 字符串编码的错误中恢复错误对象。NewWithCode 则是构造一个带错误码的错误,同时也包含出错时的函数调用栈信息。Wrap 和 WrapWithCode 则是错误二次包装函数,用于将底层的错误包装为新的错误,但是保留的原始的底层错误信息。这里返回的错误对象都可以直接调用 json.Marshal 将错误编码为 JSON 字符串。
我们可以这样使用包装函数:
import (
    "github.com/chai2010/errors"
)

func loadConfig() error {
    _, err := ioutil.ReadFile("/path/to/file")
    if err != nil {
        return errors.Wrap(err, "read failed")
    }

    // ...
}

func setup() error {
    err := loadConfig()
    if err != nil {
        return errors.Wrap(err, "invalid config")
    }

    // ...
}

func main() {
    if err := setup(); err != nil {
        log.Fatal(err)
    }

    // ...
}
上面的例子中,错误被进行了 2 层包装。我们可以这样遍历原始错误经历了哪些包装流程:
    for i, e := range err.(errors.Error).Wraped() {
        fmt.Printf("wrapped(%d): %v\n", i, e)
    }
同时也可以获取每个包装错误的函数调用堆栈信息:
    for i, x := range err.(errors.Error).Caller() {
        fmt.Printf("caller:%d: %s\n", i, x.FuncName)
    }
如果需要将错误通过网络传输,可以用 errors.ToJson(err) 编码为 JSON 字符串:
// 以 JSON 字符串方式发送错误
func sendError(ch chan<- string, err error) {
    ch <- errors.ToJson(err)
}

// 接收 JSON 字符串格式的错误
func recvError(ch <-chan string) error {
    p, err := errors.FromJson(<-ch)
    if err != nil {
        log.Fatal(err)
    }
    return p
}
对于基于 http 协议的网络服务,我们还可以给错误绑定一个对应的 http 状态码:
err := errors.NewWithCode(404, "http error code")

fmt.Println(err)
fmt.Println(err.(errors.Error).Code())
在 Go 语言中,错误处理也有一套独特的编码风格。检查某个子函数是否失败后,我们通常将处理失败的逻辑代码放在处理成功的代码之前。如果某个错误会导致函数返回,那么成功时的逻辑代码不应放在 else 语句块中,而应直接放在函数体中。
f, err := os.Open("filename.ext")
if err != nil {
    // 失败的情形, 马上返回错误
}

// 正常的处理流程
Go 语言中大部分函数的代码结构几乎相同,首先是一系列的初始检查,用于防止错误发生,之后是函数的实际逻辑。
1.7.3 错误的错误返回
Go 语言中的错误是一种接口类型。接口信息中包含了原始类型和原始的值。只有当接口的类型和原始的值都为空的时候,接口的值才对应 nil。其实当接口中类型为空的时候,原始值必然也是空的;反之,当接口对应的原始值为空的时候,接口对应的原始类型并不一定为空的。
在下面的例子中,试图返回自定义的错误类型,当没有错误的时候返回 nil:
func returnsError() error {
    var p *MyError = nil
    if bad() {
        p = ErrBad
    }
    return p // Will always return a non-nil error.
}
但是,最终返回的结果其实并非是 nil:是一个正常的错误,错误的值是一个 MyError 类型的空指针。下面是改进的 returnsError:
func returnsError() error {
    if bad() {
        return (*MyError)(err)
    }
    return nil
}
因此,在处理错误返回值的时候,没有错误的返回值最好直接写为 nil。
Go 语言作为一个强类型语言,不同类型之间必须要显式的转换(而且必须有相同的基础类型)。但是,Go 语言中 interface 是一个例外:非接口类型到接口类型,或者是接口类型之间的转换都是隐式的。这是为了支持鸭子类型,当然会牺牲一定的安全性。
1.7.4 剖析异常
panic支持抛出任意类型的异常(而不仅仅是 error 类型的错误),recover 函数调用的返回值和 panic 函数的输入参数类型一致,它们的函数签名如下:
func panic(interface{})
func recover() interface{}
Go 语言函数调用的正常流程是函数执行返回语句返回结果,在这个流程中是没有异常的,因此在这个流程中执行 recover 异常捕获函数始终是返回 nil。另一种是异常流程: 当函数调用 panic 抛出异常,函数将停止执行后续的普通语句,但是之前注册的 defer 函数调用仍然保证会被正常执行,然后再返回到调用者。对于当前函数的调用者,因为处理异常状态还没有被捕获,和直接调用 panic 函数的行为类似。在异常发生时,如果在 defer 中执行 recover 调用,它可以捕获触发 panic 时的参数,并且恢复到正常的执行流程。
在非 defer 语句中执行 recover 调用是初学者常犯的错误:
func main() {
    if r := recover(); r != nil {
        log.Fatal(r)
    }

    panic(123)

    if r := recover(); r != nil {
        log.Fatal(r)
    }
}
上面程序中两个 recover 调用都不能捕获任何异常。在第一个 recover 调用执行时,函数必然是在正常的非异常执行流程中,这时候 recover 调用将返回 nil。发生异常时,第二个 recover 调用将没有机会被执行到,因为 panic 调用会导致函数马上执行已经注册 defer 的函数后返回。
其实 recover 函数调用有着更严格的要求:我们必须在 defer 函数中直接调用 recover。如果 defer 中调用的是 recover 函数的包装函数的话,异常的捕获工作将失败!比如,有时候我们可能希望包装自己的 MyRecover 函数,在内部增加必要的日志信息然后再调用 recover,这是错误的做法:
func main() {
    defer func() {
        // 无法捕获异常
        if r := MyRecover(); r != nil {
            fmt.Println(r)
        }
    }()
    panic(1)
}

func MyRecover() interface{} {
    log.Println("trace...")
    return recover()
}
同样,如果是在嵌套的 defer 函数中调用 recover 也将导致无法捕获异常:
func main() {
    defer func() {
        defer func() {
            // 无法捕获异常
            if r := recover(); r != nil {
                fmt.Println(r)
            }
        }()
    }()
    panic(1)
}
2 层嵌套的 defer 函数中直接调用 recover 和 1 层 defer 函数中调用包装的 MyRecover 函数一样,都是经过了 2 个函数帧才到达真正的 recover 函数,这个时候 Goroutine 的对应上一级栈帧中已经没有异常信息。
如果我们直接在 defer 语句中调用 MyRecover 函数又可以正常工作了:
func MyRecover() interface{} {
    return recover()
}

func main() {
    // 可以正常捕获异常
    defer MyRecover()
    panic(1)
}
但是,如果 defer 语句直接调用 recover 函数,依然不能正常捕获异常:
func main() {
    // 无法捕获异常
    defer recover()
    panic(1)
}必须要和有异常的栈帧只隔一个栈帧,recover 函数才能正常捕获异常。换言之,recover 函数捕获的是祖父一级调用函数栈帧的异常(刚好可以跨越一层 defer 函数)!
当然,为了避免 recover 调用者不能识别捕获到的异常, 应该避免用 nil 为参数抛出异常:
func main() {
    defer func() {
        if r := recover(); r != nil { ... }
        // 虽然总是返回 nil, 但是可以恢复异常状态
    }()

    // 警告: 用 nil 为参数抛出异常
    panic(nil)
}
当希望将捕获到的异常转为错误时,如果希望忠实返回原始的信息,需要针对不同的类型分别处理:
func foo() (err error) {
    defer func() {
        if r := recover(); r != nil {
            switch x := r.(type) {
            case string:
                err = errors.New(x)
            case error:
                err = x
            default:
                err = fmt.Errorf("Unknown panic: %v", r)
            }
        }
    }()

    panic("TODO")
}
基于这个代码模板,我们甚至可以模拟出不同类型的异常。通过为定义不同类型的保护接口,我们就可以区分异常的类型了:
func main {
    defer func() {
        if r := recover(); r != nil {
            switch x := r.(type) {
            case runtime.Error:
                // 这是运行时错误类型异常
            case error:
                // 普通错误类型异常
            default:
                // 其他类型异常
            }
        }
    }()

    // ...
}
不过这样做和 Go 语言简单直接的编程哲学背道而驰了。
补充说明
1.8 补充说明
本书定位是 Go 语言进阶图书,因此读者需要有一定的 Go 语言基础。如果对 Go 语言不太了解,作者推荐通过以下资料开始学习 Go 语言。首先是安装 Go 语言环境,然后通过 go tool tour 命令打开“A Tour of Go”教程学习。在学习“A Tour of Go”教程的同时,可以阅读 Go 语言官方团队出版的《The Go Programming Language》教程。《The Go Programming Language》在国内 Go 语言社区被称为 Go 语言圣经,它将带你系统地学习 Go 语言。在学习的同时可以尝试用 Go 语言解决一些小问题,如果遇到要查阅 API 的时候可以通过 godoc 命令打开自带的文档查询。Go 语言本身不仅仅包含了所有的文档,也包含了所有标准库的实现代码,这是第一手的最权威的 Go 语言资料。我们认为此时你应该已经可以熟练使用 Go 语言了。