2 / 7
CGO编程
快速入门
本节我们将通过一系列由浅入深的小例子来快速掌握 CGO 的基本用法。
2.1.1 最简 CGO 程序
真实的 CGO 程序一般都比较复杂。不过我们可以由浅入深,一个最简的 CGO 程序该是什么样的呢?要构造一个最简 CGO 程序,首先要忽视一些复杂的 CGO 特性,同时要展示 CGO 程序和纯 Go 程序的差别来。下面是我们构建的最简 CGO 程序:
// hello.go
package main

import "C"

func main() {
    println("hello cgo")
}
代码通过 import "C" 语句启用 CGO 特性,主函数只是通过 Go 内置的 println 函数输出字符串,其中并没有任何和 CGO 相关的代码。虽然没有调用 CGO 的相关函数,但是 go build 命令会在编译和链接阶段启动 gcc 编译器,这已经是一个完整的 CGO 程序了。
2.1.2 基于 C 标准库函数输出字符串
第一章那个 CGO 程序还不够简单,我们现在来看看更简单的版本:
// hello.go
package main

//#include <stdio.h>
import "C"

func main() {
    C.puts(C.CString("Hello, World\n"))
}
我们不仅仅通过 import "C" 语句启用 CGO 特性,同时包含 C 语言的 <stdio.h> 头文件。然后通过 CGO 包的 C.CString 函数将 Go 语言字符串转为 C 语言字符串,最后调用 CGO 包的 C.puts 函数向标准输出窗口打印转换后的 C 字符串。
相比 “Hello, World 的革命” 一节中的 CGO 程序最大的不同是:我们没有在程序退出前释放 C.CString 创建的 C 语言字符串;还有我们改用 puts 函数直接向标准输出打印,之前是采用 fputs 向标准输出打印。
没有释放使用 C.CString 创建的 C 语言字符串会导致内存泄漏。但是对于这个小程序来说,这样是没有问题的,因为程序退出后操作系统会自动回收程序的所有资源。
2.1.3 使用自己的 C 函数
前面我们使用了标准库中已有的函数。现在我们先自定义一个叫 SayHello 的 C 函数来实现打印,然后从 Go 语言环境中调用这个 SayHello 函数:
// hello.go
package main

/*
#include <stdio.h>

static void SayHello(const char* s) {
    puts(s);
}
*/
import "C"

func main() {
    C.SayHello(C.CString("Hello, World\n"))
}
除了 SayHello 函数是我们自己实现的之外,其它的部分和前面的例子基本相似。
我们也可以将 SayHello 函数放到当前目录下的一个 C 语言源文件中(后缀名必须是 .c)。因为是编写在独立的 C 文件中,为了允许外部引用,所以需要去掉函数的 static 修饰符。
// hello.c

#include <stdio.h>

void SayHello(const char* s) {
    puts(s);
}
然后在 CGO 部分先声明 SayHello 函数,其它部分不变:
// hello.go
package main

//void SayHello(const char* s);
import "C"

func main() {
    C.SayHello(C.CString("Hello, World\n"))
}
注意,如果之前运行的命令是 go run hello.go 或 go build hello.go 的话,此处须使用 go run "your/package" 或 go build "your/package" 才可以。若本就在包路径下的话,也可以直接运行 go run . 或 go build。
既然 SayHello 函数已经放到独立的 C 文件中了,我们自然可以将对应的 C 文件编译打包为静态库或动态库文件供使用。如果是以静态库或动态库方式引用 SayHello 函数的话,需要将对应的 C 源文件移出当前目录(CGO 构建程序会自动构建当前目录下的 C 源文件,从而导致 C 函数名冲突)。关于静态库等细节将在稍后章节讲解。
2.1.4 C 代码的模块化
在编程过程中,抽象和模块化是将复杂问题简化的通用手段。当代码语句变多时,我们可以将相似的代码封装到一个个函数中;当程序中的函数变多时,我们将函数拆分到不同的文件或模块中。而模块化编程的核心是面向程序接口编程(这里的接口并不是 Go 语言的 interface,而是 API 的概念)。
在前面的例子中,我们可以抽象一个名为 hello 的模块,模块的全部接口函数都在 hello.h 头文件定义:
// hello.h
void SayHello(const char* s);
其中只有一个 SayHello 函数的声明。但是作为 hello 模块的用户来说,就可以放心地使用 SayHello 函数,而无需关心函数的具体实现。而作为 SayHello 函数的实现者来说,函数的实现只要满足头文件中函数的声明的规范即可。下面是 SayHello 函数的 C 语言实现,对应 hello.c 文件:
// hello.c

#include "hello.h"
#include <stdio.h>

void SayHello(const char* s) {
    puts(s);
}
在 hello.c 文件的开头,实现者通过 #include "hello.h" 语句包含 SayHello 函数的声明,这样可以保证函数的实现满足模块对外公开的接口。
接口文件 hello.h 是 hello 模块的实现者和使用者共同的约定,但是该约定并没有要求必须使用 C 语言来实现 SayHello 函数。我们也可以用 C++ 语言来重新实现这个 C 语言函数:
// hello.cpp

#include <iostream>

extern "C" {
    #include "hello.h"
}

void SayHello(const char* s) {
    std::cout << s;
}
在 C++ 版本的 SayHello 函数实现中,我们通过 C++ 特有的 std::cout 输出流输出字符串。不过为了保证 C++ 语言实现的 SayHello 函数满足 C 语言头文件 hello.h 定义的函数规范,我们需要通过 extern "C" 语句指示该函数的链接符号遵循 C 语言的规则。
在采用面向 C 语言 API 接口编程之后,我们彻底解放了模块实现者的语言枷锁:实现者可以用任何编程语言实现模块,只要最终满足公开的 API 约定即可。我们可以用 C 语言实现 SayHello 函数,也可以使用更复杂的 C++ 语言来实现 SayHello 函数,当然我们也可以用汇编语言甚至 Go 语言来重新实现 SayHello 函数。
2.1.5 用 Go 重新实现 C 函数
其实 CGO 不仅仅用于 Go 语言中调用 C 语言函数,还可以用于导出 Go 语言函数给 C 语言函数调用。在前面的例子中,我们已经抽象一个名为 hello 的模块,模块的全部接口函数都在 hello.h 头文件定义:
// hello.h
void SayHello(/*const*/ char* s);
现在我们创建一个 hello.go 文件,用 Go 语言重新实现 C 语言接口的 SayHello 函数:
// hello.go
package main

import "C"

import "fmt"

//export SayHello
func SayHello(s *C.char) {
    fmt.Print(C.GoString(s))
}
我们通过 CGO 的 //export SayHello 指令将 Go 语言实现的函数 SayHello 导出为 C 语言函数。为了适配 CGO 导出的 C 语言函数,我们禁止了在函数的声明语句中的 const 修饰符。需要注意的是,这里其实有两个版本的 SayHello 函数:一个 Go 语言环境的;另一个是 C 语言环境的。cgo 生成的 C 语言版本 SayHello 函数最终会通过桥接代码调用 Go 语言版本的 SayHello 函数。
通过面向 C 语言接口的编程技术,我们不仅仅解放了函数的实现者,同时也简化的函数的使用者。现在我们可以将 SayHello 当作一个标准库的函数使用(和 puts 函数的使用方式类似):
package main

//#include "hello.h"
import "C"

func main() {
    C.SayHello(C.CString("Hello, World\n"))
}
一切似乎都回到了开始的 CGO 代码,但是代码内涵更丰富了。
2.1.6 面向 C 接口的 Go 编程
在开始的例子中,我们的全部 CGO 代码都在一个 Go 文件中。然后,通过面向 C 接口编程的技术将 SayHello 分别拆分到不同的 C 文件,而 main 依然是 Go 文件。再然后,是用 Go 函数重新实现了 C 语言接口的 SayHello 函数。但是对于目前的例子来说只有一个函数,要拆分到三个不同的文件确实有些繁琐了。
正所谓合久必分、分久必合,我们现在尝试将例子中的几个文件重新合并到一个 Go 文件。下面是合并后的成果:
package main

//void SayHello(char* s);
import "C"

import (
    "fmt"
)

func main() {
    C.SayHello(C.CString("Hello, World\n"))
}

//export SayHello
func SayHello(s *C.char) {
    fmt.Print(C.GoString(s))
}
现在版本的 CGO 代码中 C 语言代码的比例已经很少了,但是我们依然可以进一步以 Go 语言的思维来提炼我们的 CGO 代码。通过分析可以发现 SayHello 函数的参数如果可以直接使用 Go 字符串是最直接的。在 Go1.10 中 CGO 新增加了一个 _GoString_ 预定义的 C 语言类型,用来表示 Go 语言字符串。下面是改进后的代码:
// +build go1.10

package main

//void SayHello(_GoString_ s);
import "C"

import (
    "fmt"
)

func main() {
    C.SayHello("Hello, World\n")
}

//export SayHello
func SayHello(s string) {
    fmt.Print(s)
}
虽然看起来全部是 Go 语言代码,但是执行的时候是先从 Go 语言的 main 函数,到 CGO 自动生成的 C 语言版本 SayHello 桥接函数,最后又回到了 Go 语言环境的 SayHello 函数。这个代码包含了 CGO 编程的精华,读者需要深入理解。
思考题: main 函数和 SayHello 函数是否在同一个 Goroutine 里执行?
CGO基础
要使用 CGO 特性,需要安装 C/C++ 构建工具链,在 macOS 和 Linux 下是要安装 GCC,在 windows 下是需要安装 MinGW 工具。同时需要保证环境变量 CGO_ENABLED 被设置为 1,这表示 CGO 是被启用的状态。在本地构建时 CGO_ENABLED 默认是启用的,当交叉构建时 CGO 默认是禁止的。比如要交叉构建 ARM 环境运行的 Go 程序,需要手工设置好 C/C++ 交叉构建的工具链,同时开启 CGO_ENABLED 环境变量。然后通过 import "C" 语句启用 CGO 特性。
2.2.1 import "C" 语句
如果在 Go 代码中出现了 import "C" 语句则表示使用了 CGO 特性,紧跟在这行语句前面的注释是一种特殊语法,里面包含的是正常的 C 语言代码。当确保 CGO 启用的情况下,还可以在当前目录中包含 C/C++ 对应的源文件。
举个最简单的例子:
package main

/*
#include <stdio.h>

void printint(int v) {
    printf("printint: %d\n", v);
}
*/
import "C"

func main() {
    v := 42
    C.printint(C.int(v))
}
这个例子展示了 cgo 的基本使用方法。开头的注释中写了要调用的 C 函数和相关的头文件,头文件被 include 之后里面的所有的 C 语言元素都会被加入到”C” 这个虚拟的包中。import "C" 导入语句推荐单独一行,不与其他包一同 import(在 Go 早期版本中必须单独 import)。向 C 函数传递参数也很简单,就直接转化成对应 C 语言类型传递就可以。如上例中 C.int(v) 用于将一个 Go 中的 int 类型值强制类型转换转化为 C 语言中的 int 类型值,然后调用 C 语言定义的 printint 函数进行打印。
需要注意的是,Go 是强类型语言,所以 cgo 中传递的参数类型必须与声明的类型完全一致,而且传递前必须用”C” 中的转化函数转换成对应的 C 类型,不能直接传入 Go 中类型的变量。同时通过虚拟的 C 包导入的 C 语言符号并不需要是大写字母开头,它们不受 Go 语言的导出规则约束。
cgo 将当前包引用的 C 语言符号都放到了虚拟的 C 包中,同时当前包依赖的其它 Go 语言包内部可能也通过 cgo 引入了相似的虚拟 C 包,但是不同的 Go 语言包引入的虚拟的 C 包之间的类型是不能通用的。这个约束对于要自己构造一些 cgo 辅助函数时有可能会造成一点的影响。
比如我们希望在 Go 中定义一个 C 语言字符指针对应的 CChar 类型,然后增加一个 GoString 方法返回 Go 语言字符串:
package cgo_helper

//#include <stdio.h>
import "C"

type CChar C.char

func (p *CChar) GoString() string {
    return C.GoString((*C.char)(p))
}

func PrintCString(cs *C.char) {
    C.puts(cs)
}
现在我们可能会想在其它的 Go 语言包中也使用这个辅助函数:
package main

//static const char* cs = "hello";
import "C"
import "./cgo_helper"

func main() {
    cgo_helper.PrintCString(C.cs)
}
这段代码是不能正常工作的,因为当前 main 包引入的 C.cs 变量的类型是当前 main 包的 cgo 构造的虚拟的 C 包下的 *char 类型(具体点是 *C.char,更具体点是 *main.C.char),它和 cgo_helper 包引入的 *C.char 类型(具体点是 *cgo_helper.C.char)是不同的。在 Go 语言中方法是依附于类型存在的,不同 Go 包中引入的虚拟的 C 包的类型却是不同的(main.C 不等 cgo_helper.C),这导致从它们延伸出来的 Go 类型也是不同的类型(*main.C.char 不等 *cgo_helper.C.char),这最终导致了前面代码不能正常工作。
有 Go 语言使用经验的用户可能会建议参数转型后再传入。但是这个方法似乎也是不可行的,因为 cgo_helper.PrintCString 的参数是它自身包引入的 *C.char 类型,在外部是无法直接获取这个类型的。换言之,一个包如果在公开的接口中直接使用了 *C.char 等类似的虚拟 C 包的类型,其它的 Go 包是无法直接使用这些类型的,除非这个 Go 包同时也提供了 *C.char 类型的构造函数。因为这些诸多因素,如果想在 go test 环境直接测试这些 cgo 导出的类型也会有相同的限制。
2.2.2 #cgo 语句
在 import "C" 语句前的注释中可以通过 #cgo 语句设置编译阶段和链接阶段的相关参数。编译阶段的参数主要用于定义相关宏和指定头文件检索路径。链接阶段的参数主要是指定库文件检索路径和要链接的库文件。
// #cgo CFLAGS: -DPNG_DEBUG=1 -I./include
// #cgo LDFLAGS: -L/usr/local/lib -lpng
// #include <png.h>
import "C"
上面的代码中,CFLAGS 部分,-D 部分定义了宏 PNG_DEBUG,值为 1;-I 定义了头文件包含的检索目录。LDFLAGS 部分,-L 指定了链接时库文件检索目录,-l 指定了链接时需要链接 png 库。
因为 C/C++ 遗留的问题,C 头文件检索目录可以是相对目录,但是库文件检索目录则需要绝对路径。在库文件的检索目录中可以通过 ${SRCDIR} 变量表示当前包目录的绝对路径:
// #cgo LDFLAGS: -L${SRCDIR}/libs -lfoo上面的代码在链接时将被展开为:
// #cgo LDFLAGS: -L/go/src/foo/libs -lfoo#cgo 语句主要影响 CFLAGS、CPPFLAGS、CXXFLAGS、FFLAGS 和 LDFLAGS 几个编译器环境变量。LDFLAGS 用于设置链接时的参数,除此之外的几个变量用于改变编译阶段的构建参数 (CFLAGS 用于针对 C 语言代码设置编译参数)。
对于在 cgo 环境混合使用 C 和 C++ 的用户来说,可能有三种不同的编译选项:其中 CFLAGS 对应 C 语言特有的编译选项、CXXFLAGS 对应是 C++ 特有的编译选项、CPPFLAGS 则对应 C 和 C++ 共有的编译选项。但是在链接阶段,C 和 C++ 的链接选项是通用的,因此这个时候已经不再有 C 和 C++ 语言的区别,它们的目标文件的类型是相同的。
#cgo 指令还支持条件选择,当满足某个操作系统或某个 CPU 架构类型时后面的编译或链接选项生效。比如下面是分别针对 windows 和非 windows 下平台的编译和链接选项:
// #cgo windows CFLAGS: -DX86=1
// #cgo !windows LDFLAGS: -lm
其中在 windows 平台下,编译前会预定义 X86 宏为 1;在非 windows 平台下,在链接阶段会要求链接 math 数学库。这种用法对于在不同平台下只有少数编译选项差异的场景比较适用。
如果在不同的系统下 cgo 对应着不同的 c 代码,我们可以先使用 #cgo 指令定义不同的 C 语言的宏,然后通过宏来区分不同的代码:
package main

/*
#cgo windows CFLAGS: -DCGO_OS_WINDOWS=1
#cgo darwin CFLAGS: -DCGO_OS_DARWIN=1
#cgo linux CFLAGS: -DCGO_OS_LINUX=1

#if defined(CGO_OS_WINDOWS)
    const char* os = "windows";
#elif defined(CGO_OS_DARWIN)
    const char* os = "darwin";
#elif defined(CGO_OS_LINUX)
    const char* os = "linux";
#else
#    error(unknown os)
#endif
*/
import "C"

func main() {
    print(C.GoString(C.os))
}
这样我们就可以用 C 语言中常用的技术来处理不同平台之间的差异代码。
2.2.3 build tag 条件编译
build tag 是在 Go 或 cgo 环境下的 C/C++ 文件开头的一种特殊的注释。条件编译类似于前面通过 #cgo 指令针对不同平台定义的宏,只有在对应平台的宏被定义之后才会构建对应的代码。但是通过 #cgo 指令定义宏有个限制,它只能是基于 Go 语言支持的 windows、darwin 和 linux 等已经支持的操作系统。如果我们希望定义一个 DEBUG 标志的宏,#cgo 指令就无能为力了。而 Go 语言提供的 build tag 条件编译特性则可以简单做到。
比如下面的源文件只有在设置 debug 构建标志时才会被构建:
// +build debug

package main

var buildMode = "debug"
可以用以下命令构建:
go build -tags="debug"
go build -tags="windows debug"
我们可以通过 -tags 命令行参数同时指定多个 build 标志,它们之间用空格分隔。
当有多个 build tag 时,我们将多个标志通过逻辑操作的规则来组合使用。比如以下的构建标志表示只有在”linux/386“或”darwin 平台下非 cgo 环境 “才进行构建。
// +build linux,386 darwin,!cgo其中 linux,386 中 linux 和 386 用逗号链接表示 AND 的意思;而 linux,386 和 darwin,!cgo 之间通过空白分割来表示 OR 的意思。
类型转换
最初 CGO 是为了达到方便从 Go 语言函数调用 C 语言函数(用 C 语言实现 Go 语言声明的函数)以复用 C 语言资源这一目的而出现的(因为 C 语言还会涉及回调函数,自然也会涉及到从 C 语言函数调用 Go 语言函数(用 Go 语言实现 C 语言声明的函数))。现在,它已经演变为 C 语言和 Go 语言双向通讯的桥梁。要想利用好 CGO 特性,自然需要了解此二语言类型之间的转换规则,这是本节要讨论的问题。
2.3.1 数值类型
在 Go 语言中访问 C 语言的符号时,一般是通过虚拟的 “C” 包访问,比如 C.int 对应 C 语言的 int 类型。有些 C 语言的类型是由多个关键字组成,但通过虚拟的 “C” 包访问 C 语言类型时名称部分不能有空格字符,比如 unsigned int 不能直接通过 C.unsigned int 访问。因此 CGO 为 C 语言的基础数值类型都提供了相应转换规则,比如 C.uint 对应 C 语言的 unsigned int。
Go 语言中数值类型和 C 语言数据类型基本上是相似的,以下是它们的对应关系表 2-1 所示。
| C 语言类型 | CGO 类型 | Go 语言类型 |
|---|---|---|
| char | C.char | byte |
| singed char | C.schar | int8 |
| unsigned char | C.uchar | uint8 |
| short | C.short | int16 |
| unsigned short | C.ushort | uint16 |
| int | C.int | int32 |
| unsigned int | C.uint | uint32 |
| long | C.long | int32 |
| unsigned long | C.ulong | uint32 |
| long long int | C.longlong | int64 |
| unsigned long long int | C.ulonglong | uint64 |
| float | C.float | float32 |
| double | C.double | float64 |
| size_t | C.size_t | uint |
表 2-1 Go 语言和 C 语言类型对比
需要注意的是,虽然在 C 语言中 int、short 等类型没有明确定义内存大小,但是在 CGO 中它们的内存大小是确定的。在 CGO 中,C 语言的 int 和 long 类型都是对应 4 个字节的内存大小,size_t 类型可以当作 Go 语言 uint 无符号整数类型对待。
CGO 中,虽然 C 语言的 int 固定为 4 字节的大小,但是 Go 语言自己的 int 和 uint 却在 32 位和 64 位系统下分别对应 4 个字节和 8 个字节大小。如果需要在 C 语言中访问 Go 语言的 int 类型,可以通过 GoInt 类型访问,GoInt 类型在 CGO 工具生成的 _cgo_export.h 头文件中定义。其实在 _cgo_export.h 头文件中,每个基本的 Go 数值类型都定义了对应的 C 语言类型,它们一般都是以单词 Go 为前缀。下面是 64 位环境下,_cgo_export.h 头文件生成的 Go 数值类型的定义,其中 GoInt 和 GoUint 类型分别对应 GoInt64 和 GoUint64:
typedef signed char GoInt8;
typedef unsigned char GoUint8;
typedef short GoInt16;
typedef unsigned short GoUint16;
typedef int GoInt32;
typedef unsigned int GoUint32;
typedef long long GoInt64;
typedef unsigned long long GoUint64;
typedef GoInt64 GoInt;
typedef GoUint64 GoUint;
typedef float GoFloat32;
typedef double GoFloat64;
除了 GoInt 和 GoUint 之外,我们并不推荐直接访问 GoInt32、GoInt64 等类型。更好的做法是通过 C 语言的 C99 标准引入的 <stdint.h> 头文件。为了提高 C 语言的可移植性,在 <stdint.h> 文件中,不但每个数值类型都提供了明确内存大小,而且和 Go 语言的类型命名更加一致。Go 语言类型 <stdint.h> 头文件类型对比如表 2-2 所示。
| C 语言类型 | CGO 类型 | Go 语言类型 |
|---|---|---|
| int8_t | C.int8_t | int8 |
| uint8_t | C.uint8_t | uint8 |
| int16_t | C.int16_t | int16 |
| uint16_t | C.uint16_t | uint16 |
| int32_t | C.int32_t | int32 |
| uint32_t | C.uint32_t | uint32 |
| int64_t | C.int64_t | int64 |
| uint64_t | C.uint64_t | uint64 |
表 2-2 <stdint.h> 类型对比
前文说过,如果 C 语言的类型是由多个关键字组成,则无法通过虚拟的 “C” 包直接访问(比如 C 语言的 unsigned short 不能直接通过 C.unsigned short 访问)。但是,在 <stdint.h> 中通过使用 C 语言的 typedef 关键字将 unsigned short 重新定义为 uint16_t 这样一个单词的类型后,我们就可以通过 C.uint16_t 访问原来的 unsigned short 类型了。对于比较复杂的 C 语言类型,推荐使用 typedef 关键字提供一个规则的类型命名,这样更利于在 CGO 中访问。
2.3.2 Go 字符串和切片
在 CGO 生成的 _cgo_export.h 头文件中还会为 Go 语言的字符串、切片、字典、接口和管道等特有的数据类型生成对应的 C 语言类型:
typedef struct {const char *p; GoInt n;} GoString;
typedef void *GoMap;
typedef void *GoChan;
typedef struct {void *t; void *v;} GoInterface;
typedef struct {void *data; GoInt len; GoInt cap;} GoSlice;
不过需要注意的是,其中只有字符串和切片在 CGO 中有一定的使用价值,因为 CGO 为他们的某些 GO 语言版本的操作函数生成了 C 语言版本,因此二者可以在 Go 调用 C 语言函数时马上使用; 而 CGO 并未针对其他的类型提供相关的辅助函数,且 Go 语言特有的内存模型导致我们无法保持这些由 Go 语言管理的内存指针,所以它们 C 语言环境并无使用的价值。
在导出的 C 语言函数中我们可以直接使用 Go 字符串和切片。假设有以下两个导出函数:
//export helloString
func helloString(s string) {}

//export helloSlice
func helloSlice(s []byte) {}
CGO 生成的 _cgo_export.h 头文件会包含以下的函数声明:
extern void helloString(GoString p0);
extern void helloSlice(GoSlice p0);
不过需要注意的是,如果使用了 GoString 类型则会对 _cgo_export.h 头文件产生依赖,而这个头文件是动态输出的。
Go1.10 针对 Go 字符串增加了一个 _GoString_ 预定义类型,可以降低在 cgo 代码中可能对 _cgo_export.h 头文件产生的循环依赖的风险。我们可以调整 helloString 函数的 C 语言声明为:
extern void helloString(_GoString_ p0);因为 _GoString_ 是预定义类型,我们无法通过此类型直接访问字符串的长度和指针等信息。Go1.10 同时也增加了以下两个函数用于获取字符串结构中的长度和指针信息:
size_t _GoStringLen(_GoString_ s);
const char *_GoStringPtr(_GoString_ s);
更严谨的做法是为 C 语言函数接口定义严格的头文件,然后基于稳定的头文件实现代码。
2.3.3 结构体、联合、枚举类型
C 语言的结构体、联合、枚举类型不能作为匿名成员被嵌入到 Go 语言的结构体中。在 Go 语言中,我们可以通过 C.struct_xxx 来访问 C 语言中定义的 struct xxx 结构体类型。结构体的内存布局按照 C 语言的通用对齐规则,在 32 位 Go 语言环境 C 语言结构体也按照 32 位对齐规则,在 64 位 Go 语言环境按照 64 位的对齐规则。对于指定了特殊对齐规则的结构体,无法在 CGO 中访问。
结构体的简单用法如下:
/*
struct A {
    int i;
    float f;
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a.i)
    fmt.Println(a.f)
}
如果结构体的成员名字中碰巧是 Go 语言的关键字,可以通过在成员名开头添加下划线来访问:
/*
struct A {
    int type; // type 是 Go 语言的关键字
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a._type) // _type 对应 type
}
但是如果有 2 个成员:一个是以 Go 语言关键字命名,另一个刚好是以下划线和 Go 语言关键字命名,那么以 Go 语言关键字命名的成员将无法访问(被屏蔽):
/*
struct A {
    int   type;  // type 是 Go 语言的关键字
    float _type; // 将屏蔽 CGO 对 type 成员的访问
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a._type) // _type 对应 _type
}
C 语言结构体中位字段对应的成员无法在 Go 语言中访问,如果需要操作位字段成员,需要通过在 C 语言中定义辅助函数来完成。对应零长数组的成员,无法在 Go 语言中直接访问数组的元素,但其中零长的数组成员所在位置的偏移量依然可以通过 unsafe.Offsetof(a.arr) 来访问。
/*
struct A {
    int   size: 10; // 位字段无法访问
    float arr[];    // 零长的数组也无法访问
};
*/
import "C"
import "fmt"

func main() {
    var a C.struct_A
    fmt.Println(a.size) // 错误: 位字段无法访问
    fmt.Println(a.arr)  // 错误: 零长的数组也无法访问
}
在 C 语言中,我们无法直接访问 Go 语言定义的结构体类型。
对于联合类型,我们可以通过 C.union_xxx 来访问 C 语言中定义的 union xxx 类型。但是 Go 语言中并不支持 C 语言联合类型,它们会被转为对应大小的字节数组。
/*
#include <stdint.h>

union B1 {
    int i;
    float f;
};

union B2 {
    int8_t i8;
    int64_t i64;
};
*/
import "C"
import "fmt"

func main() {
    var b1 C.union_B1;
    fmt.Printf("%T\n", b1) // [4]uint8

    var b2 C.union_B2;
    fmt.Printf("%T\n", b2) // [8]uint8
}
如果需要操作 C 语言的联合类型变量,一般有三种方法:第一种是在 C 语言中定义辅助函数;第二种是通过 Go 语言的 "encoding/binary" 手工解码成员 (需要注意大端小端问题);第三种是使用 unsafe 包强制转型为对应类型 (这是性能最好的方式)。下面展示通过 unsafe 包访问联合类型成员的方式:
/*
#include <stdint.h>

union B {
    int i;
    float f;
};
*/
import "C"
import "fmt"

func main() {
    var b C.union_B;
    fmt.Println("b.i:", *(*C.int)(unsafe.Pointer(&b)))
    fmt.Println("b.f:", *(*C.float)(unsafe.Pointer(&b)))
}
虽然 unsafe 包访问最简单、性能也最好,但是对于有嵌套联合类型的情况处理会导致问题复杂化。对于复杂的联合类型,推荐通过在 C 语言中定义辅助函数的方式处理。
对于枚举类型,我们可以通过 C.enum_xxx 来访问 C 语言中定义的 enum xxx 结构体类型。
/*
enum C {
    ONE,
    TWO,
};
*/
import "C"
import "fmt"

func main() {
    var c C.enum_C = C.TWO
    fmt.Println(c)
    fmt.Println(C.ONE)
    fmt.Println(C.TWO)
}
在 C 语言中,枚举类型底层对应 int 类型,支持负数类型的值。我们可以通过 C.ONE、C.TWO 等直接访问定义的枚举值。
2.3.4 数组、字符串和切片
在 C 语言中,数组名其实对应于一个指针,指向特定类型特定长度的一段内存,但是这个指针不能被修改;当把数组名传递给一个函数时,实际上传递的是数组第一个元素的地址。为了讨论方便,我们将一段特定长度的内存统称为数组。C 语言的字符串是一个 char 类型的数组,字符串的长度需要根据表示结尾的 NULL 字符的位置确定。C 语言中没有切片类型。
在 Go 语言中,数组是一种值类型,而且数组的长度是数组类型的一个部分。Go 语言字符串对应一段长度确定的只读 byte 类型的内存。Go 语言的切片则是一个简化版的动态数组。
Go 语言和 C 语言的数组、字符串和切片之间的相互转换可以简化为 Go 语言的切片和 C 语言中指向一定长度内存的指针之间的转换。
CGO 的 C 虚拟包提供了以下一组函数,用于 Go 语言和 C 语言之间数组和字符串的双向转换:
// Go string to C string
// The C string is allocated in the C heap using malloc.
// It is the caller's responsibility to arrange for it to be
// freed, such as by calling C.free (be sure to include stdlib.h
// if C.free is needed).
func C.CString(string) *C.char

// Go []byte slice to C array
// The C array is allocated in the C heap using malloc.
// It is the caller's responsibility to arrange for it to be
// freed, such as by calling C.free (be sure to include stdlib.h
// if C.free is needed).
func C.CBytes([]byte) unsafe.Pointer

// C string to Go string
func C.GoString(*C.char) string

// C data with explicit length to Go string
func C.GoStringN(*C.char, C.int) string

// C data with explicit length to Go []byte
func C.GoBytes(unsafe.Pointer, C.int) []byte
其中 C.CString 针对输入的 Go 字符串,克隆一个 C 语言格式的字符串;返回的字符串由 C 语言的 malloc 函数分配,不使用时需要通过 C 语言的 free 函数释放。C.CBytes 函数的功能和 C.CString 类似,用于从输入的 Go 语言字节切片克隆一个 C 语言版本的字节数组,同样返回的数组需要在合适的时候释放。C.GoString 用于将从 NULL 结尾的 C 语言字符串克隆一个 Go 语言字符串。C.GoStringN 是另一个字符数组克隆函数。C.GoBytes 用于从 C 语言数组,克隆一个 Go 语言字节切片。
该组辅助函数都是以克隆的方式运行。当 Go 语言字符串和切片向 C 语言转换时,克隆的内存由 C 语言的 malloc 函数分配,最终可以通过 free 函数释放。当 C 语言字符串或数组向 Go 语言转换时,克隆的内存由 Go 语言分配管理。通过该组转换函数,转换前和转换后的内存依然在各自的语言环境中,它们并没有跨越 Go 语言和 C 语言。克隆方式实现转换的优点是接口和内存管理都很简单,缺点是克隆需要分配新的内存和复制操作都会导致额外的开销。
在 reflect 包中有字符串和切片的定义:
type StringHeader struct {
    Data uintptr
    Len  int
}

type SliceHeader struct {
    Data uintptr
    Len  int
    Cap  int
}
如果不希望单独分配内存,可以在 Go 语言中直接访问 C 语言的内存空间:
/*
#include <string.h>
char arr[10];
char *s = "Hello";
*/
import "C"
import (
    "reflect"
    "unsafe"
)
func main() {
    // 通过 reflect.SliceHeader 转换
    var arr0 []byte
    var arr0Hdr = (*reflect.SliceHeader)(unsafe.Pointer(&arr0))
    arr0Hdr.Data = uintptr(unsafe.Pointer(&C.arr[0]))
    arr0Hdr.Len = 10
    arr0Hdr.Cap = 10

    // 通过切片语法转换
    arr1 := (*[31]byte)(unsafe.Pointer(&C.arr[0]))[:10:10]

    var s0 string
    var s0Hdr = (*reflect.StringHeader)(unsafe.Pointer(&s0))
    s0Hdr.Data = uintptr(unsafe.Pointer(C.s))
    s0Hdr.Len = int(C.strlen(C.s))

    sLen := int(C.strlen(C.s))
        s1 := string((*[31]byte)(unsafe.Pointer(C.s))[:sLen:sLen])
}
因为 Go 语言的字符串是只读的,用户需要自己保证 Go 字符串在使用期间,底层对应的 C 字符串内容不会发生变化、内存不会被提前释放掉。
在 CGO 中,会为字符串和切片生成和上面结构对应的 C 语言版本的结构体:
typedef struct {const char *p; GoInt n;} GoString;
typedef struct {void *data; GoInt len; GoInt cap;} GoSlice;
在 C 语言中可以通过 GoString 和 GoSlice 来访问 Go 语言的字符串和切片。如果是 Go 语言中数组类型,可以将数组转为切片后再行转换。如果字符串或切片对应的底层内存空间由 Go 语言的运行时管理,那么在 C 语言中不能长时间保存 Go 内存对象。
关于 CGO 内存模型的细节在稍后章节中会详细讨论。
2.3.5 指针间的转换
在 C 语言中,不同类型的指针是可以显式或隐式转换的,如果是隐式只是会在编译时给出一些警告信息。但是 Go 语言对于不同类型的转换非常严格,任何 C 语言中可能出现的警告信息在 Go 语言中都可能是错误!指针是 C 语言的灵魂,指针间的自由转换也是 cgo 代码中经常要解决的第一个重要的问题。
在 Go 语言中两个指针的类型完全一致则不需要转换可以直接通用。如果一个指针类型是用 type 命令在另一个指针类型基础之上构建的,换言之两个指针底层是相同完全结构的指针,那么我我们可以通过直接强制转换语法进行指针间的转换。但是 cgo 经常要面对的是 2 个完全不同类型的指针间的转换,原则上这种操作在纯 Go 语言代码是严格禁止的。
cgo 存在的一个目的就是打破 Go 语言的禁止,恢复 C 语言应有的指针的自由转换和指针运算。以下代码演示了如何将 X 类型的指针转化为 Y 类型的指针:
var p *X
var q *Y

q = (*Y)(unsafe.Pointer(p)) // *X => *Y
p = (*X)(unsafe.Pointer(q)) // *Y => *X
为了实现 X 类型指针到 Y 类型指针的转换,我们需要借助 unsafe.Pointer 作为中间桥接类型实现不同类型指针之间的转换。unsafe.Pointer 指针类型类似 C 语言中的 void* 类型的指针。
下面是指针间的转换流程的示意图:
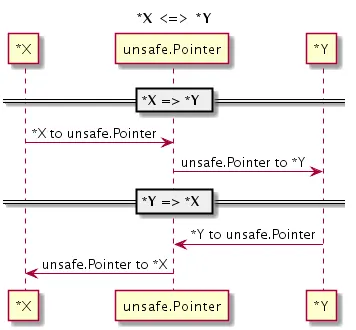
图 2-1 X 类型指针转 Y 类型指针
任何类型的指针都可以通过强制转换为 unsafe.Pointer 指针类型去掉原有的类型信息,然后再重新赋予新的指针类型而达到指针间的转换的目的。
2.3.6 数值和指针的转换
不同类型指针间的转换看似复杂,但是在 cgo 中已经算是比较简单的了。在 C 语言中经常遇到用普通数值表示指针的场景,也就是说如何实现数值和指针的转换也是 cgo 需要面对的一个问题。
为了严格控制指针的使用,Go 语言禁止将数值类型直接转为指针类型!不过,Go 语言针对 unsafe.Pointr 指针类型特别定义了一个 uintptr 类型。我们可以 uintptr 为中介,实现数值类型到 unsafe.Pointr 指针类型到转换。再结合前面提到的方法,就可以实现数值和指针的转换了。
下面流程图演示了如何实现 int32 类型到 C 语言的 char* 字符串指针类型的相互转换:
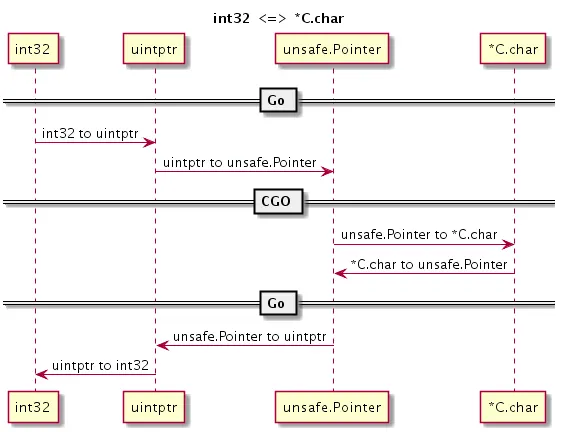
图 2-2 int32 和 char* 指针转换
转换分为几个阶段,在每个阶段实现一个小目标:首先是 int32 到 uintptr 类型,然后是 uintptr 到 unsafe.Pointr 指针类型,最后是 unsafe.Pointr 指针类型到 *C.char 类型。
2.3.7 切片间的转换
在 C 语言中数组也一种指针,因此两个不同类型数组之间的转换和指针间转换基本类似。但是在 Go 语言中,数组或数组对应的切片都不再是指针类型,因此我们也就无法直接实现不同类型的切片之间的转换。
不过 Go 语言的 reflect 包提供了切片类型的底层结构,再结合前面讨论到不同类型之间的指针转换技术就可以实现 []X 和 []Y 类型的切片转换:
var p []X
var q []Y

pHdr := (*reflect.SliceHeader)(unsafe.Pointer(&p))
qHdr := (*reflect.SliceHeader)(unsafe.Pointer(&q))

pHdr.Data = qHdr.Data
pHdr.Len = qHdr.Len * unsafe.Sizeof(q[0]) / unsafe.Sizeof(p[0])
pHdr.Cap = qHdr.Cap * unsafe.Sizeof(q[0]) / unsafe.Sizeof(p[0])
不同切片类型之间转换的思路是先构造一个空的目标切片,然后用原有的切片底层数据填充目标切片。如果 X 和 Y 类型的大小不同,需要重新设置 Len 和 Cap 属性。需要注意的是,如果 X 或 Y 是空类型,上述代码中可能导致除 0 错误,实际代码需要根据情况酌情处理。
下面演示了切片间的转换的具体流程:
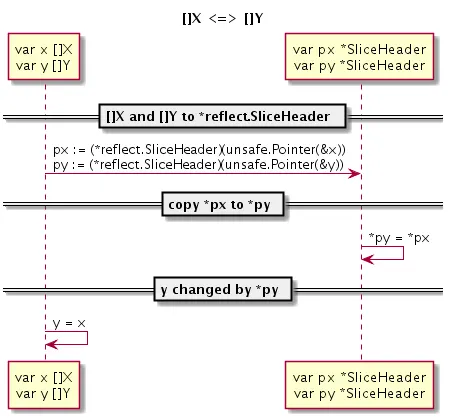
图 2-3 X 类型切片转 Y 类型切片
针对 CGO 中常用的功能,作者封装了 "github.com/chai2010/cgo" 包,提供基本的转换功能,具体的细节可以参考实现代码。
函数调用
函数是 C 语言编程的核心,通过 CGO 技术我们不仅仅可以在 Go 语言中调用 C 语言函数,也可以将 Go 语言函数导出为 C 语言函数。
2.4.1 Go 调用 C 函数
对于一个启用 CGO 特性的程序,CGO 会构造一个虚拟的 C 包。通过这个虚拟的 C 包可以调用 C 语言函数。
/*
static int add(int a, int b) {
    return a+b;
}
*/
import "C"

func main() {
    C.add(1, 1)
}
以上的 CGO 代码首先定义了一个当前文件内可见的 add 函数,然后通过 C.add。
2.4.2 C 函数的返回值
对于有返回值的 C 函数,我们可以正常获取返回值。
/*
static int div(int a, int b) {
    return a/b;
}
*/
import "C"
import "fmt"

func main() {
    v := C.div(6, 3)
    fmt.Println(v)
}
上面的 div 函数实现了一个整数除法的运算,然后通过返回值返回除法的结果。
不过对于除数为 0 的情形并没有做特殊处理。如果希望在除数为 0 的时候返回一个错误,其他时候返回正常的结果。因为 C 语言不支持返回多个结果,因此 <errno.h> 标准库提供了一个 errno 宏用于返回错误状态。我们可以近似地将 errno 看成一个线程安全的全局变量,可以用于记录最近一次错误的状态码。
改进后的 div 函数实现如下:
#include <errno.h>

int div(int a, int b) {
    if(b == 0) {
        errno = EINVAL;
        return 0;
    }
    return a/b;
}
CGO 也针对 <errno.h> 标准库的 errno 宏做的特殊支持:在 CGO 调用 C 函数时如果有两个返回值,那么第二个返回值将对应 errno 错误状态。
/*
#include <errno.h>

static int div(int a, int b) {
    if(b == 0) {
        errno = EINVAL;
        return 0;
    }
    return a/b;
}
*/
import "C"
import "fmt"

func main() {
    v0, err0 := C.div(2, 1)
    fmt.Println(v0, err0)

    v1, err1 := C.div(1, 0)
    fmt.Println(v1, err1)
}
运行这个代码将会产生以下输出:
2 <nil>
0 invalid argument
我们可以近似地将 div 函数看作为以下类型的函数:
func C.div(a, b C.int) (C.int, [error])第二个返回值是可忽略的 error 接口类型,底层对应 syscall.Errno 错误类型。
2.4.3 void 函数的返回值
C 语言函数还有一种没有返回值类型的函数,用 void 表示返回值类型。一般情况下,我们无法获取 void 类型函数的返回值,因为没有返回值可以获取。前面的例子中提到,cgo 对 errno 做了特殊处理,可以通过第二个返回值来获取 C 语言的错误状态。对于 void 类型函数,这个特性依然有效。
以下的代码是获取没有返回值函数的错误状态码:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    _, err := C.noreturn()
    fmt.Println(err)
}
此时,我们忽略了第一个返回值,只获取第二个返回值对应的错误码。
我们也可以尝试获取第一个返回值,它对应的是 C 语言的 void 对应的 Go 语言类型:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    v, _ := C.noreturn()
    fmt.Printf("%#v", v)
}
运行这个代码将会产生以下输出:
main._Ctype_void{}我们可以看出 C 语言的 void 类型对应的是当前的 main 包中的 _Ctype_void 类型。其实也将 C 语言的 noreturn 函数看作是返回 _Ctype_void 类型的函数,这样就可以直接获取 void 类型函数的返回值:
//static void noreturn() {}
import "C"
import "fmt"

func main() {
    fmt.Println(C.noreturn())
}
运行这个代码将会产生以下输出:
[]其实在 CGO 生成的代码中,_Ctype_void 类型对应一个 0 长的数组类型 [0]byte,因此 fmt.Println 输出的是一个表示空数值的方括弧。
以上有效特性虽然看似有些无聊,但是通过这些例子我们可以精确掌握 CGO 代码的边界,可以从更深层次的设计的角度来思考产生这些奇怪特性的原因。
2.4.4 C 调用 Go 导出函数
CGO 还有一个强大的特性:将 Go 函数导出为 C 语言函数。这样的话我们可以定义好 C 语言接口,然后通过 Go 语言实现。在本章的第一节快速入门部分我们已经展示过 Go 语言导出 C 语言函数的例子。
下面是用 Go 语言重新实现本节开始的 add 函数:
import "C"

//export add
func add(a, b C.int) C.int {
    return a+b
}
add 函数名以小写字母开头,对于 Go 语言来说是包内的私有函数。但是从 C 语言角度来看,导出的 add 函数是一个可全局访问的 C 语言函数。如果在两个不同的 Go 语言包内,都存在一个同名的要导出为 C 语言函数的 add 函数,那么在最终的链接阶段将会出现符号重名的问题。
CGO 生成的 _cgo_export.h 文件会包含导出后的 C 语言函数的声明。我们可以在纯 C 源文件中包含 _cgo_export.h 文件来引用导出的 add 函数。如果希望在当前的 CGO 文件中马上使用导出的 C 语言 add 函数,则无法引用 _cgo_export.h 文件。因为 _cgo_export.h 文件的生成需要依赖当前文件可以正常构建,而如果当前文件内部循环依赖还未生成的 _cgo_export.h 文件将会导致 cgo 命令错误。
#include "_cgo_export.h"

void foo() {
    add(1, 1);
}
当导出 C 语言接口时,需要保证函数的参数和返回值类型都是 C 语言友好的类型,同时返回值不得直接或间接包含 Go 语言内存空间的指针。
内部机制
对于刚刚接触 CGO 用户来说,CGO 的很多特性类似魔法。CGO 特性主要是通过一个叫 cgo 的命令行工具来辅助输出 Go 和 C 之间的桥接代码。本节我们尝试从生成的代码分析 Go 语言和 C 语言函数直接相互调用的流程。
2.5.1 CGO 生成的中间文件
要了解 CGO 技术的底层秘密首先需要了解 CGO 生成了哪些中间文件。我们可以在构建一个 cgo 包时增加一个 -work 输出中间生成文件所在的目录并且在构建完成时保留中间文件。如果是比较简单的 cgo 代码我们也可以直接通过手工调用 go tool cgo 命令来查看生成的中间文件。
在一个 Go 源文件中,如果出现了 import "C" 指令则表示将调用 cgo 命令生成对应的中间文件。下图是 cgo 生成的中间文件的简单示意图:
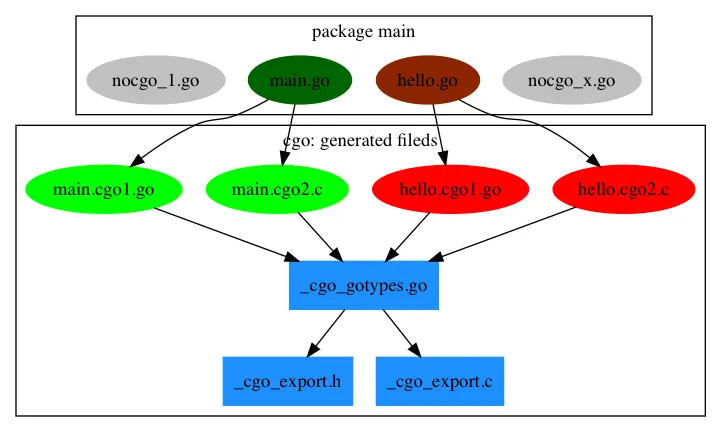
图 2-4 cgo 生成的中间文件
包中有 4 个 Go 文件,其中 nocgo 开头的文件中没有 import "C" 指令,其它的 2 个文件则包含了 cgo 代码。cgo 命令会为每个包含了 cgo 代码的 Go 文件创建 2 个中间文件,比如 main.go 会分别创建 main.cgo1.go 和 main.cgo2.c 两个中间文件。然后会为整个包创建一个 _cgo_gotypes.go Go 文件,其中包含 Go 语言部分辅助代码。此外还会创建一个 _cgo_export.h 和 _cgo_export.c 文件,对应 Go 语言导出到 C 语言的类型和函数。
2.5.2 Go 调用 C 函数
Go 调用 C 函数是 CGO 最常见的应用场景,我们将从最简单的例子入手分析 Go 调用 C 函数的详细流程。
具体代码如下(main.go):
package main

//int sum(int a, int b) { return a+b; }
import "C"

func main() {
    println(C.sum(1, 1))
}
首先构建并运行该例子没有错误。然后通过 cgo 命令行工具在_obj 目录生成中间文件:
$ go tool cgo main.go查看_obj 目录生成中间文件:
$ ls _obj | awk '{print $NF}'
_cgo_.o
_cgo_export.c
_cgo_export.h
_cgo_flags
_cgo_gotypes.go
_cgo_main.c
main.cgo1.go
main.cgo2.c
其中 _cgo_.o、_cgo_flags 和 _cgo_main.c 文件和我们的代码没有直接的逻辑关联,可以暂时忽略。
我们先查看 main.cgo1.go 文件,它是 main.go 文件展开虚拟 C 包相关函数和变量后的 Go 代码:
package main

//int sum(int a, int b) { return a+b; }
import _ "unsafe"

func main() {
    println((_Cfunc_sum)(1, 1))
}
其中 C.sum(1, 1) 函数调用被替换成了 (_Cfunc_sum)(1, 1)。每一个 C.xxx 形式的函数都会被替换为 _Cfunc_xxx 格式的纯 Go 函数,其中前缀 _Cfunc_ 表示这是一个 C 函数,对应一个私有的 Go 桥接函数。
_Cfunc_sum 函数在 cgo 生成的 _cgo_gotypes.go 文件中定义:
//go:cgo_unsafe_args
func _Cfunc_sum(p0 _Ctype_int, p1 _Ctype_int) (r1 _Ctype_int) {
    _cgo_runtime_cgocall(_cgo_506f45f9fa85_Cfunc_sum, uintptr(unsafe.Pointer(&p0)))
    if _Cgo_always_false {
        _Cgo_use(p0)
        _Cgo_use(p1)
    }
    return
}
_Cfunc_sum 函数的参数和返回值 _Ctype_int 类型对应 C.int 类型,命名的规则和 _Cfunc_xxx 类似,不同的前缀用于区分函数和类型。
其中 _cgo_runtime_cgocall 对应 runtime.cgocall 函数,函数的声明如下:
func runtime.cgocall(fn, arg unsafe.Pointer) int32第一个参数是 C 语言函数的地址,第二个参数是存放 C 语言函数对应的参数结构体的地址。
在这个例子中,被传入 C 语言函数 _cgo_506f45f9fa85_Cfunc_sum 也是 cgo 生成的中间函数。函数在 main.cgo2.c 定义:
void _cgo_506f45f9fa85_Cfunc_sum(void *v) {
    struct {
        int p0;
        int p1;
        int r;
        char __pad12[4];
    } __attribute__((__packed__)) *a = v;
    char *stktop = _cgo_topofstack();
    __typeof__(a->r) r;
    _cgo_tsan_acquire();
    r = sum(a->p0, a->p1);
    _cgo_tsan_release();
    a = (void*)((char*)a + (_cgo_topofstack() - stktop));
    a->r = r;
}
这个函数参数只有一个 void 泛型的指针,函数没有返回值。真实的 sum 函数的函数参数和返回值均通过唯一的参数指针类实现。
_cgo_506f45f9fa85_Cfunc_sum 函数的指针指向的结构为:
    struct {
        int p0;
        int p1;
        int r;
        char __pad12[4];
    } __attribute__((__packed__)) *a = v;
其中 p0 成员对应 sum 的第一个参数,p1 成员对应 sum 的第二个参数,r 成员,__pad12 用于填充结构体保证对齐 CPU 机器字的整倍数。
然后从参数指向的结构体获取调用参数后开始调用真实的 C 语言版 sum 函数,并且将返回值保持到结构体内返回值对应的成员。
因为 Go 语言和 C 语言有着不同的内存模型和函数调用规范。其中 _cgo_topofstack 函数相关的代码用于 C 函数调用后恢复调用栈。_cgo_tsan_acquire 和 _cgo_tsan_release 则是用于扫描 CGO 相关的函数则是对 CGO 相关函数的指针做相关检查。
C.sum 的整个调用流程图如下:
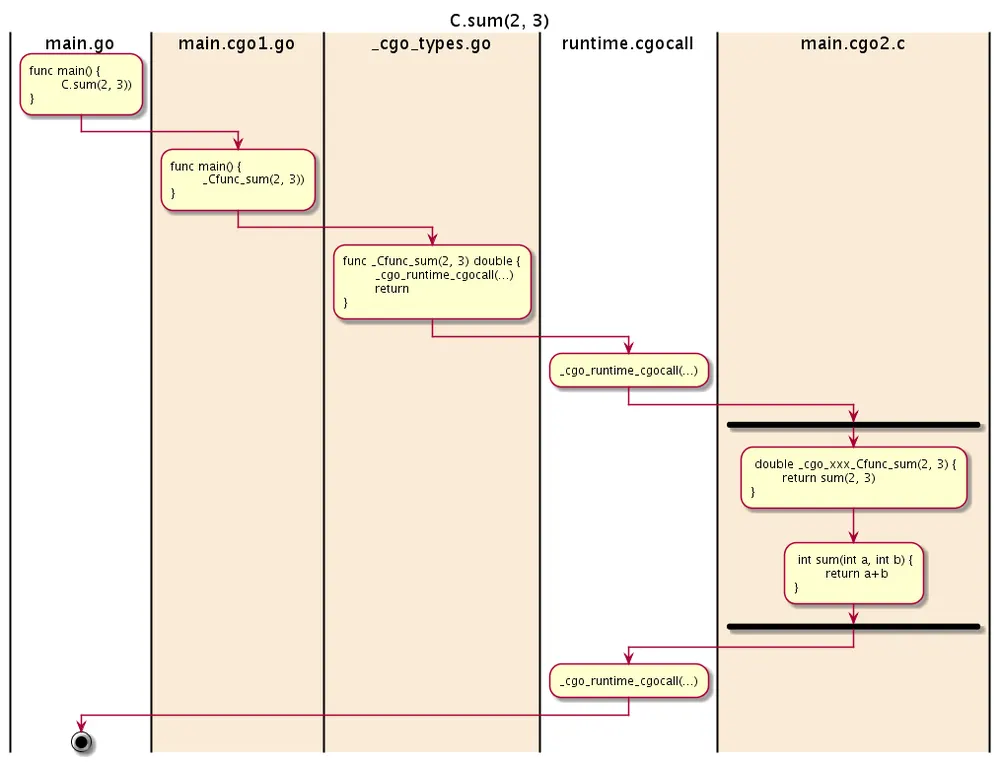
图 2-5 调用 C 函数
其中 runtime.cgocall 函数是实现 Go 语言到 C 语言函数跨界调用的关键。更详细的细节可以参考 https://golang.org/src/cmd/cgo/doc.go 内部的代码注释和 runtime.cgocall 函数的实现。
2.5.3 C 调用 Go 函数
在简单分析了 Go 调用 C 函数的流程后,我们现在来分析 C 反向调用 Go 函数的流程。同样,我们现构造一个 Go 语言版本的 sum 函数,文件名同样为 main.go:
package main

//int sum(int a, int b);
import "C"

//export sum
func sum(a, b C.int) C.int {
    return a + b
}

func main() {}
CGO 的语法细节不再赘述。为了在 C 语言中使用 sum 函数,我们需要将 Go 代码编译为一个 C 静态库:
$ go build -buildmode=c-archive -o sum.a main.go如果没有错误的话,以上编译命令将生成一个 sum.a 静态库和 sum.h 头文件。其中 sum.h 头文件将包含 sum 函数的声明,静态库中将包含 sum 函数的实现。
要分析生成的 C 语言版 sum 函数的调用流程,同样需要分析 cgo 生成的中间文件:
$ go tool cgo main.go_obj 目录还是生成类似的中间文件。为了查看方便,我们刻意忽略了无关的几个文件:
$ ls _obj | awk '{print $NF}'
_cgo_export.c
_cgo_export.h
_cgo_gotypes.go
main.cgo1.go
main.cgo2.c
其中 _cgo_export.h 文件的内容和生成 C 静态库时产生的 sum.h 头文件是同一个文件,里面同样包含 sum 函数的声明。
既然 C 语言是主调用者,我们需要先从 C 语言版 sum 函数的实现开始分析。C 语言版本的 sum 函数在生成的 _cgo_export.c 文件中(该文件包含的是 Go 语言导出函数对应的 C 语言函数实现):
int sum(int p0, int p1)
{
    __SIZE_TYPE__ _cgo_ctxt = _cgo_wait_runtime_init_done();
    struct {
        int p0;
        int p1;
        int r0;
        char __pad0[4];
    } __attribute__((__packed__)) a;
    a.p0 = p0;
    a.p1 = p1;
    _cgo_tsan_release();
    crosscall2(_cgoexp_8313eaf44386_sum, &a, 16, _cgo_ctxt);
    _cgo_tsan_acquire();
    _cgo_release_context(_cgo_ctxt);
    return a.r0;
}
sum 函数的内容采用和前面类似的技术,将 sum 函数的参数和返回值打包到一个结构体中,然后通过 runtime/cgo.crosscall2 函数将结构体传给 _cgoexp_8313eaf44386_sum 函数执行。
runtime/cgo.crosscall2 函数采用汇编语言实现,它对应的函数声明如下:
func runtime/cgo.crosscall2(
    fn func(a unsafe.Pointer, n int32, ctxt uintptr),
    a unsafe.Pointer, n int32,
    ctxt uintptr,
)
其中关键的是 fn 和 a,fn 是中间代理函数的指针,a 是对应调用参数和返回值的结构体指针。
中间的 _cgoexp_8313eaf44386_sum 代理函数在 _cgo_gotypes.go 文件:
func _cgoexp_8313eaf44386_sum(a unsafe.Pointer, n int32, ctxt uintptr) {
    fn := _cgoexpwrap_8313eaf44386_sum
    _cgo_runtime_cgocallback(**(**unsafe.Pointer)(unsafe.Pointer(&fn)), a, uintptr(n), ctxt);
}

func _cgoexpwrap_8313eaf44386_sum(p0 _Ctype_int, p1 _Ctype_int) (r0 _Ctype_int) {
    return sum(p0, p1)
}
内部将 sum 的包装函数 _cgoexpwrap_8313eaf44386_sum 作为函数指针,然后由 _cgo_runtime_cgocallback 函数完成 C 语言到 Go 函数的回调工作。
_cgo_runtime_cgocallback 函数对应 runtime.cgocallback 函数,函数的类型如下:
func runtime.cgocallback(fn, frame unsafe.Pointer, framesize, ctxt uintptr)参数分别是函数指针,函数参数和返回值对应结构体的指针,函数调用帧大小和上下文参数。
整个调用流程图如下:
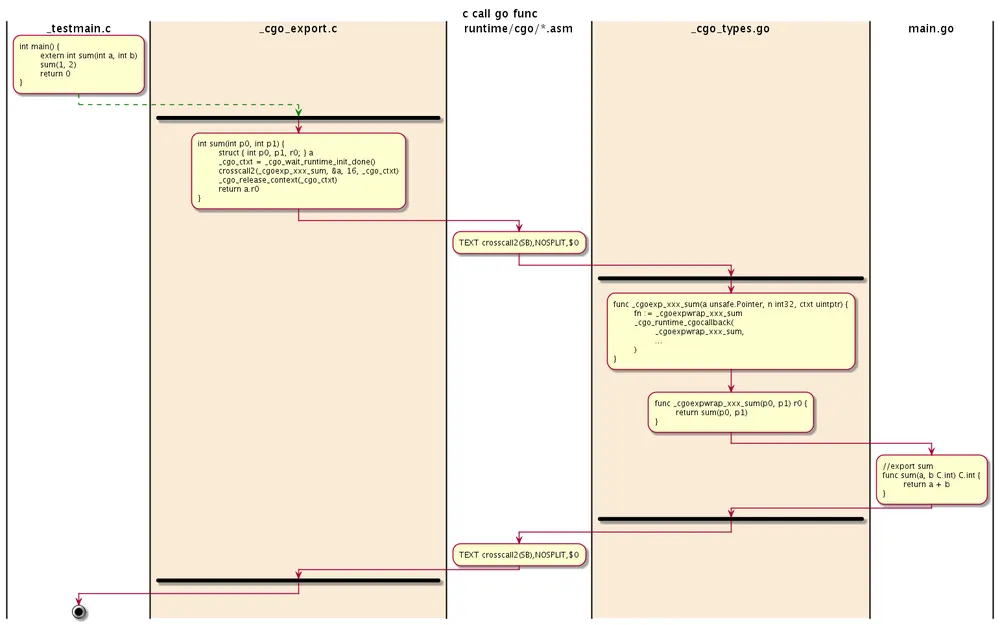
图 2-6 调用导出的 Go 函数
其中 runtime.cgocallback 函数是实现 C 语言到 Go 语言函数跨界调用的关键。更详细的细节可以参考相关函数的实现。
实战: 封装qsort
qsort 快速排序函数是 C 语言的高阶函数,支持用于自定义排序比较函数,可以对任意类型的数组进行排序。本节我们尝试基于 C 语言的 qsort 函数封装一个 Go 语言版本的 qsort 函数。
2.6.1 认识 qsort 函数
qsort 快速排序函数由 <stdlib.h> 标准库提供,函数的声明如下:
void qsort(
    void* base, size_t num, size_t size,
    int (*cmp)(const void*, const void*)
);
其中 base 参数是要排序数组的首个元素的地址,num 是数组中元素的个数,size 是数组中每个元素的大小。最关键是 cmp 比较函数,用于对数组中任意两个元素进行排序。cmp 排序函数的两个指针参数分别是要比较的两个元素的地址,如果第一个参数对应元素大于第二个参数对应的元素将返回结果大于 0,如果两个元素相等则返回 0,如果第一个元素小于第二个元素则返回结果小于 0。
下面的例子是用 C 语言的 qsort 对一个 int 类型的数组进行排序:
#include <stdio.h>
#include <stdlib.h>

#define DIM(x) (sizeof(x)/sizeof((x)[0]))

static int cmp(const void* a, const void* b) {
    const int* pa = (int*)a;
    const int* pb = (int*)b;
    return *pa - *pb;
}

int main() {
    int values[] = { 42, 8, 109, 97, 23, 25};
    int i;

    qsort(values, DIM(values), sizeof(values[0]), cmp);

    for(i = 0; i < DIM(values); i++) {
        printf ("%d",values[i]);
    }
    return 0;
}
其中 DIM(values) 宏用于计算数组元素的个数,sizeof(values[0]) 用于计算数组元素的大小。
cmp 是用于排序时比较两个元素大小的回调函数。为了避免对全局名字空间的污染,我们将 cmp 回调函数定义为仅当前文件内可访问的静态函数。
2.6.2 将 qsort 函数从 Go 包导出
为了方便 Go 语言的非 CGO 用户使用 qsort 函数,我们需要将 C 语言的 qsort 函数包装为一个外部可以访问的 Go 函数。
用 Go 语言将 qsort 函数重新包装为 qsort.Sort 函数:
package qsort

//typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
import "C"
import "unsafe"

func Sort(
    base unsafe.Pointer, num, size C.size_t,
    cmp C.qsort_cmp_func_t,
) {
    C.qsort(base, num, size, cmp)
}
因为 Go 语言的 CGO 语言不好直接表达 C 语言的函数类型,因此在 C 语言空间将比较函数类型重新定义为一个 qsort_cmp_func_t 类型。
虽然 Sort 函数已经导出了,但是对于 qsort 包之外的用户依然不能直接使用该函数——Sort 函数的参数还包含了虚拟的 C 包提供的类型。
在 CGO 的内部机制一节中我们已经提过,虚拟的 C 包下的任何名称其实都会被映射为包内的私有名字。比如 C.size_t 会被展开为 _Ctype_size_t,C.qsort_cmp_func_t 类型会被展开为 _Ctype_qsort_cmp_func_t。
被 CGO 处理后的 Sort 函数的类型如下:
func Sort(
    base unsafe.Pointer, num, size _Ctype_size_t,
    cmp _Ctype_qsort_cmp_func_t,
)
这样将会导致包外部用于无法构造 _Ctype_size_t 和 _Ctype_qsort_cmp_func_t 类型的参数而无法使用 Sort 函数。因此,导出的 Sort 函数的参数和返回值要避免对虚拟 C 包的依赖。
重新调整 Sort 函数的参数类型和实现如下:
/*
#include <stdlib.h>

typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
*/
import "C"
import "unsafe"

type CompareFunc C.qsort_cmp_func_t

func Sort(base unsafe.Pointer, num, size int, cmp CompareFunc) {
    C.qsort(base, C.size_t(num), C.size_t(size), C.qsort_cmp_func_t(cmp))
}
我们将虚拟 C 包中的类型通过 Go 语言类型代替,在内部调用 C 函数时重新转型为 C 函数需要的类型。因此外部用户将不再依赖 qsort 包内的虚拟 C 包。
以下代码展示的 Sort 函数的使用方式:
package main

//extern int go_qsort_compare(void* a, void* b);
import "C"

import (
    "fmt"
    "unsafe"

    qsort "."
)

//export go_qsort_compare
func go_qsort_compare(a, b unsafe.Pointer) C.int {
    pa, pb := (*C.int)(a), (*C.int)(b)
    return C.int(*pa - *pb)
}

func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    qsort.Sort(unsafe.Pointer(&values[0]),
        len(values), int(unsafe.Sizeof(values[0])),
        qsort.CompareFunc(C.go_qsort_compare),
    )
    fmt.Println(values)
}
为了使用 Sort 函数,我们需要将 Go 语言的切片取首地址、元素个数、元素大小等信息作为调用参数,同时还需要提供一个 C 语言规格的比较函数。
其中 go_qsort_compare 是用 Go 语言实现的,并导出到 C 语言空间的函数,用于 qsort 排序时的比较函数。
目前已经实现了对 C 语言的 qsort 初步包装,并且可以通过包的方式被其它用户使用。但是 qsort.Sort 函数已经有很多不便使用之处:用户要提供 C 语言的比较函数,这对许多 Go 语言用户是一个挑战。下一步我们将继续改进 qsort 函数的包装函数,尝试通过闭包函数代替 C 语言的比较函数。
消除用户对 CGO 代码的直接依赖。
2.6.3 改进:闭包函数作为比较函数
在改进之前我们先回顾下 Go 语言 sort 包自带的排序函数的接口:
func Slice(slice interface{}, less func(i, j int) bool)标准库的 sort.Slice 因为支持通过闭包函数指定比较函数,对切片的排序非常简单:
import "sort"

func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    sort.Slice(values, func(i, j int) bool {
        return values[i] < values[j]
    })

    fmt.Println(values)
}
我们也尝试将 C 语言的 qsort 函数包装为以下格式的 Go 语言函数:
package qsort

func Sort(base unsafe.Pointer, num, size int, cmp func(a, b unsafe.Pointer) int)
闭包函数无法导出为 C 语言函数,因此无法直接将闭包函数传入 C 语言的 qsort 函数。
为此我们可以用 Go 构造一个可以导出为 C 语言的代理函数,然后通过一个全局变量临时保存当前的闭包比较函数。
代码如下:
var go_qsort_compare_info struct {
    fn func(a, b unsafe.Pointer) int
    sync.Mutex
}

//export _cgo_qsort_compare
func _cgo_qsort_compare(a, b unsafe.Pointer) C.int {
    return C.int(go_qsort_compare_info.fn(a, b))
}
其中导出的 C 语言函数 _cgo_qsort_compare 是公用的 qsort 比较函数,内部通过 go_qsort_compare_info.fn 来调用当前的闭包比较函数。
新的 Sort 包装函数实现如下:
/*
#include <stdlib.h>

typedef int (*qsort_cmp_func_t)(const void* a, const void* b);
extern int _cgo_qsort_compare(void* a, void* b);
*/
import "C"

func Sort(base unsafe.Pointer, num, size int, cmp func(a, b unsafe.Pointer) int) {
    go_qsort_compare_info.Lock()
    defer go_qsort_compare_info.Unlock()

    go_qsort_compare_info.fn = cmp

    C.qsort(base, C.size_t(num), C.size_t(size),
        C.qsort_cmp_func_t(C._cgo_qsort_compare),
    )
}
每次排序前,对全局的 go_qsort_compare_info 变量加锁,同时将当前的闭包函数保存到全局变量,然后调用 C 语言的 qsort 函数。
基于新包装的函数,我们可以简化之前的排序代码:
func main() {
    values := []int32{42, 9, 101, 95, 27, 25}

    qsort.Sort(unsafe.Pointer(&values[0]), len(values), int(unsafe.Sizeof(values[0])),
        func(a, b unsafe.Pointer) int {
            pa, pb := (*int32)(a), (*int32)(b)
            return int(*pa - *pb)
        },
    )

    fmt.Println(values)
}
现在排序不再需要通过 CGO 实现 C 语言版本的比较函数了,可以传入 Go 语言闭包函数作为比较函数。
但是导入的排序函数依然依赖 unsafe 包,这是违背 Go 语言编程习惯的。
2.6.4 改进:消除用户对 unsafe 包的依赖
前一个版本的 qsort.Sort 包装函数已经比最初的 C 语言版本的 qsort 易用很多,但是依然保留了很多 C 语言底层数据结构的细节。
现在我们将继续改进包装函数,尝试消除对 unsafe 包的依赖,并实现一个类似标准库中 sort.Slice 的排序函数。
新的包装函数声明如下:
package qsort

func Slice(slice interface{}, less func(a, b int) bool)
首先,我们将 slice 作为接口类型参数传入,这样可以适配不同的切片类型。
然后切片的首个元素的地址、元素个数和元素大小可以通过 reflect 反射包从切片中获取。
为了保存必要的排序上下文信息,我们需要在全局包变量增加要排序数组的地址、元素个数和元素大小等信息,比较函数改为 less:
var go_qsort_compare_info struct {
    base     unsafe.Pointer
    elemnum  int
    elemsize int
    less     func(a, b int) bool
    sync.Mutex
}
同样比较函数需要根据元素指针、排序数组的开始地址和元素的大小计算出元素对应数组的索引下标,
然后根据 less 函数的比较结果返回 qsort 函数需要格式的比较结果。
//export _cgo_qsort_compare
func _cgo_qsort_compare(a, b unsafe.Pointer) C.int {
    var (
        // array memory is locked
        base     = uintptr(go_qsort_compare_info.base)
        elemsize = uintptr(go_qsort_compare_info.elemsize)
    )

    i := int((uintptr(a) - base) / elemsize)
    j := int((uintptr(b) - base) / elemsize)

    switch {
    case go_qsort_compare_info.less(i, j): // v[i] < v[j]
        return -1
    case go_qsort_compare_info.less(j, i): // v[i] > v[j]
        return +1
    default:
        return 0
    }
}
新的 Slice 函数的实现如下:
func Slice(slice interface{}, less func(a, b int) bool) {
    sv := reflect.ValueOf(slice)
    if sv.Kind() != reflect.Slice {
        panic(fmt.Sprintf("qsort called with non-slice value of type %T", slice))
    }
    if sv.Len() == 0 {
        return
    }

    go_qsort_compare_info.Lock()
    defer go_qsort_compare_info.Unlock()

    defer func() {
        go_qsort_compare_info.base = nil
        go_qsort_compare_info.elemnum = 0
        go_qsort_compare_info.elemsize = 0
        go_qsort_compare_info.less = nil
    }()

    // baseMem = unsafe.Pointer(sv.Index(0).Addr().Pointer())
    // baseMem maybe moved, so must saved after call C.fn
    go_qsort_compare_info.base = unsafe.Pointer(sv.Index(0).Addr().Pointer())
    go_qsort_compare_info.elemnum = sv.Len()
    go_qsort_compare_info.elemsize = int(sv.Type().Elem().Size())
    go_qsort_compare_info.less = less

    C.qsort(
        go_qsort_compare_info.base,
        C.size_t(go_qsort_compare_info.elemnum),
        C.size_t(go_qsort_compare_info.elemsize),
        C.qsort_cmp_func_t(C._cgo_qsort_compare),
    )
}
首先需要判断传入的接口类型必须是切片类型。然后通过反射获取 qsort 函数需要的切片信息,并调用 C 语言的 qsort 函数。
基于新包装的函数我们可以采用和标准库相似的方式排序切片:
import (
    "fmt"

    qsort "."
)

func main() {
    values := []int64{42, 9, 101, 95, 27, 25}

    qsort.Slice(values, func(i, j int) bool {
        return values[i] < values[j]
    })

    fmt.Println(values)
}
为了避免在排序过程中,排序数组的上下文信息 go_qsort_compare_info 被修改,我们进行了全局加锁。
因此目前版本的 qsort.Slice 函数是无法并发执行的,读者可以自己尝试改进这个限制。
CGO内存模型
CGO 是架接 Go 语言和 C 语言的桥梁,它使二者在二进制接口层面实现了互通,但是我们要注意因两种语言的内存模型的差异而可能引起的问题。如果在 CGO 处理的跨语言函数调用时涉及到了指针的传递,则可能会出现 Go 语言和 C 语言共享某一段内存的场景。我们知道 C 语言的内存在分配之后就是稳定的,但是 Go 语言因为函数栈的动态伸缩可能导致栈中内存地址的移动 (这是 Go 和 C 内存模型的最大差异)。如果 C 语言持有的是移动之前的 Go 指针,那么以旧指针访问 Go 对象时会导致程序崩溃。
2.7.1 Go 访问 C 内存
C 语言空间的内存是稳定的,只要不是被人为提前释放,那么在 Go 语言空间可以放心大胆地使用。在 Go 语言访问 C 语言内存是最简单的情形,我们在之前的例子中已经见过多次。
因为 Go 语言实现的限制,我们无法在 Go 语言中创建大于 2GB 内存的切片(具体请参考 makeslice 实现代码)。不过借助 cgo 技术,我们可以在 C 语言环境创建大于 2GB 的内存,然后转为 Go 语言的切片使用:
package main

/*
#include <stdlib.h>

void* makeslice(size_t memsize) {
    return malloc(memsize);
}
*/
import "C"
import "unsafe"

func makeByteSlice(n int) []byte {
    p := C.makeslice(C.size_t(n))
    return ((*[1 << 31]byte)(p))[0:n:n]
}

func freeByteSlice(p []byte) {
    C.free(unsafe.Pointer(&p[0]))
}

func main() {
    s := makeByteSlice(1<<32+1)
    s[len(s)-1] = 255
    print(s[len(s)-1])
    freeByteSlice(s)
}
例子中我们通过 makeByteSlice 来创建大于 4G 内存大小的切片,从而绕过了 Go 语言实现的限制(需要代码验证)。而 freeByteSlice 辅助函数则用于释放从 C 语言函数创建的切片。
因为 C 语言内存空间是稳定的,基于 C 语言内存构造的切片也是绝对稳定的,不会因为 Go 语言栈的变化而被移动。
2.7.2 C 临时访问传入的 Go 内存
cgo 之所以存在的一大因素是为了方便在 Go 语言中接纳吸收过去几十年来使用 C/C++ 语言软件构建的大量的软件资源。C/C++ 很多库都是需要通过指针直接处理传入的内存数据的,因此 cgo 中也有很多需要将 Go 内存传入 C 语言函数的应用场景。
假设一个极端场景:我们将一块位于某 goroutine 的栈上的 Go 语言内存传入了 C 语言函数后,在此 C 语言函数执行期间,此 goroutinue 的栈因为空间不足的原因发生了扩展,也就是导致了原来的 Go 语言内存被移动到了新的位置。但是此时此刻 C 语言函数并不知道该 Go 语言内存已经移动了位置,仍然用之前的地址来操作该内存——这将将导致内存越界。以上是一个推论(真实情况有些差异),也就是说 C 访问传入的 Go 内存可能是不安全的!
当然有 RPC 远程过程调用的经验的用户可能会考虑通过完全传值的方式处理:借助 C 语言内存稳定的特性,在 C 语言空间先开辟同样大小的内存,然后将 Go 的内存填充到 C 的内存空间;返回的内存也是如此处理。下面的例子是这种思路的具体实现:
package main

/*
#include <stdlib.h>
#include <stdio.h>

void printString(const char* s) {
    printf("%s", s);
}
*/
import "C"
import "unsafe"

func printString(s string) {
    cs := C.CString(s)
    defer C.free(unsafe.Pointer(cs))

    C.printString(cs)
}

func main() {
    s := "hello"
    printString(s)
}
在需要将 Go 的字符串传入 C 语言时,先通过 C.CString 将 Go 语言字符串对应的内存数据复制到新创建的 C 语言内存空间上。上面例子的处理思路虽然是安全的,但是效率极其低下(因为要多次分配内存并逐个复制元素),同时也极其繁琐。
为了简化并高效处理此种向 C 语言传入 Go 语言内存的问题,cgo 针对该场景定义了专门的规则:在 CGO 调用的 C 语言函数返回前,cgo 保证传入的 Go 语言内存在此期间不会发生移动,C 语言函数可以大胆地使用 Go 语言的内存!
根据新的规则我们可以直接传入 Go 字符串的内存:
package main

/*
#include<stdio.h>

void printString(const char* s, int n) {
    int i;
    for(i = 0; i < n; i++) {
        putchar(s[i]);
    }
    putchar('\n');
}
*/
import "C"

func printString(s string) {
    p := (*reflect.StringHeader)(unsafe.Pointer(&s))
    C.printString((*C.char)(unsafe.Pointer(p.Data)), C.int(len(s)))
}

func main() {
    s := "hello"
    printString(s)
}
现在的处理方式更加直接,且避免了分配额外的内存。完美的解决方案!
任何完美的技术都有被滥用的时候,CGO 的这种看似完美的规则也是存在隐患的。我们假设调用的 C 语言函数需要长时间运行,那么将会导致被他引用的 Go 语言内存在 C 语言返回前不能被移动,从而可能间接地导致这个 Go 内存栈对应的 goroutine 不能动态伸缩栈内存,也就是可能导致这个 goroutine 被阻塞。因此,在需要长时间运行的 C 语言函数(特别是在纯 CPU 运算之外,还可能因为需要等待其它的资源而需要不确定时间才能完成的函数),需要谨慎处理传入的 Go 语言内存。
不过需要小心的是在取得 Go 内存后需要马上传入 C 语言函数,不能保存到临时变量后再间接传入 C 语言函数。因为 CGO 只能保证在 C 函数调用之后被传入的 Go 语言内存不会发生移动,它并不能保证在传入 C 函数之前内存不发生变化。
以下代码是错误的:
// 错误的代码
tmp := uintptr(unsafe.Pointer(&x))
pb := (*int16)(unsafe.Pointer(tmp))
*pb = 42
因为 tmp 并不是指针类型,在它获取到 Go 对象地址之后 x 对象可能会被移动,但是因为不是指针类型,所以不会被 Go 语言运行时更新成新内存的地址。在非指针类型的 tmp 保持 Go 对象的地址,和在 C 语言环境保持 Go 对象的地址的效果是一样的:如果原始的 Go 对象内存发生了移动,Go 语言运行时并不会同步更新它们。
2.7.3 C 长期持有 Go 指针对象
作为一个 Go 程序员在使用 CGO 时潜意识会认为总是 Go 调用 C 函数。其实 CGO 中,C 语言函数也可以回调 Go 语言实现的函数。特别是我们可以用 Go 语言写一个动态库,导出 C 语言规范的接口给其它用户调用。当 C 语言函数调用 Go 语言函数的时候,C 语言函数就成了程序的调用方,Go 语言函数返回的 Go 对象内存的生命周期也就自然超出了 Go 语言运行时的管理。简言之,我们不能在 C 语言函数中直接使用 Go 语言对象的内存。
虽然 Go 语言禁止在 C 语言函数中长期持有 Go 指针对象,但是这种需求是切实存在的。如果需要在 C 语言中访问 Go 语言内存对象,我们可以将 Go 语言内存对象在 Go 语言空间映射为一个 int 类型的 id,然后通过此 id 来间接访问和控制 Go 语言对象。
以下代码用于将 Go 对象映射为整数类型的 ObjectId,用完之后需要手工调用 free 方法释放该对象 ID:
package main

import "sync"

type ObjectId int32

var refs struct {
    sync.Mutex
    objs map[ObjectId]interface{}
    next ObjectId
}

func init() {
    refs.Lock()
    defer refs.Unlock()

    refs.objs = make(map[ObjectId]interface{})
    refs.next = 1000
}

func NewObjectId(obj interface{}) ObjectId {
    refs.Lock()
    defer refs.Unlock()

    id := refs.next
    refs.next++

    refs.objs[id] = obj
    return id
}

func (id ObjectId) IsNil() bool {
    return id == 0
}

func (id ObjectId) Get() interface{} {
    refs.Lock()
    defer refs.Unlock()

    return refs.objs[id]
}

func (id *ObjectId) Free() interface{} {
    refs.Lock()
    defer refs.Unlock()

    obj := refs.objs[*id]
    delete(refs.objs, *id)
    *id = 0

    return obj
}
我们通过一个 map 来管理 Go 语言对象和 id 对象的映射关系。其中 NewObjectId 用于创建一个和对象绑定的 id,而 id 对象的方法可用于解码出原始的 Go 对象,也可以用于结束 id 和原始 Go 对象的绑定。
下面一组函数以 C 接口规范导出,可以被 C 语言函数调用:
package main

/*
extern char* NewGoString(char*);
extern void FreeGoString(char*);
extern void PrintGoString(char*);

static void printString(const char* s) {
    char* gs = NewGoString(s);
    PrintGoString(gs);
    FreeGoString(gs);
}
*/
import "C"

//export NewGoString
func NewGoString(s *C.char) *C.char {
    gs := C.GoString(s)
    id := NewObjectId(gs)
    return (*C.char)(unsafe.Pointer(uintptr(id)))
}

//export FreeGoString
func FreeGoString(p *C.char) {
    id := ObjectId(uintptr(unsafe.Pointer(p)))
    id.Free()
}

//export PrintGoString
func PrintGoString(s *C.char) {
    id := ObjectId(uintptr(unsafe.Pointer(p)))
    gs := id.Get().(string)
    print(gs)
}

func main() {
    C.printString("hello")
}
在 printString 函数中,我们通过 NewGoString 创建一个对应的 Go 字符串对象,返回的其实是一个 id,不能直接使用。我们借助 PrintGoString 函数将 id 解析为 Go 语言字符串后打印。该字符串在 C 语言函数中完全跨越了 Go 语言的内存管理,在 PrintGoString 调用前即使发生了栈伸缩导致的 Go 字符串地址发生变化也依然可以正常工作,因为该字符串对应的 id 是稳定的,在 Go 语言空间通过 id 解码得到的字符串也就是有效的。
2.7.4 导出 C 函数不能返回 Go 内存
在 Go 语言中,Go 是从一个固定的虚拟地址空间分配内存。而 C 语言分配的内存则不能使用 Go 语言保留的虚拟内存空间。在 CGO 环境,Go 语言运行时默认会检查导出返回的内存是否是由 Go 语言分配的,如果是则会抛出运行时异常。
下面是 CGO 运行时异常的例子:
/*
extern int* getGoPtr();

static void Main() {
    int* p = getGoPtr();
    *p = 42;
}
*/
import "C"

func main() {
    C.Main()
}

//export getGoPtr
func getGoPtr() *C.int {
    return new(C.int)
}
其中 getGoPtr 返回的虽然是 C 语言类型的指针,但是内存本身是从 Go 语言的 new 函数分配,也就是由 Go 语言运行时统一管理的内存。然后我们在 C 语言的 Main 函数中调用了 getGoPtr 函数,此时默认将发送运行时异常:
$ go run main.go
panic: runtime error: cgo result has Go pointer

goroutine 1 [running]:
main._cgoexpwrap_cfb3840e3af2_getGoPtr.func1(0xc420051dc0)
  command-line-arguments/_obj/_cgo_gotypes.go:60 +0x3a
main._cgoexpwrap_cfb3840e3af2_getGoPtr(0xc420016078)
  command-line-arguments/_obj/_cgo_gotypes.go:62 +0x67
main._Cfunc_Main()
  command-line-arguments/_obj/_cgo_gotypes.go:43 +0x41
main.main()
  /Users/chai/go/src/github.com/chai2010 \
  /advanced-go-programming-book/examples/ch2-xx \
  /return-go-ptr/main.go:17 +0x20
exit status 2
异常说明 cgo 函数返回的结果中含有 Go 语言分配的指针。指针的检查操作发生在 C 语言版的 getGoPtr 函数中,它是由 cgo 生成的桥接 C 语言和 Go 语言的函数。
下面是 cgo 生成的 C 语言版本 getGoPtr 函数的具体细节(在 cgo 生成的 _cgo_export.c 文件定义):
int* getGoPtr()
{
    __SIZE_TYPE__ _cgo_ctxt = _cgo_wait_runtime_init_done();
    struct {
        int* r0;
    } __attribute__((__packed__)) a;
    _cgo_tsan_release();
    crosscall2(_cgoexp_95d42b8e6230_getGoPtr, &a, 8, _cgo_ctxt);
    _cgo_tsan_acquire();
    _cgo_release_context(_cgo_ctxt);
    return a.r0;
}
其中 _cgo_tsan_acquire 是从 LLVM 项目移植过来的内存指针扫描函数,它会检查 cgo 函数返回的结果是否包含 Go 指针。
需要说明的是,cgo 默认对返回结果的指针的检查是有代价的,特别是 cgo 函数返回的结果是一个复杂的数据结构时将花费更多的时间。如果已经确保了 cgo 函数返回的结果是安全的话,可以通过设置环境变量 GODEBUG=cgocheck=0 来关闭指针检查行为。
$ GODEBUG=cgocheck=0 go run main.go关闭 cgocheck 功能后再运行上面的代码就不会出现上面的异常的。但是要注意的是,如果 C 语言使用期间对应的内存被 Go 运行时释放了,将会导致更严重的崩溃问题。cgocheck 默认的值是 1,对应一个简化版本的检测,如果需要完整的检测功能可以将 cgocheck 设置为 2。
关于 cgo 运行时指针检测的功能详细说明可以参考 Go 语言的官方文档。
C++类包装
CGO 是 C 语言和 Go 语言之间的桥梁,原则上无法直接支持 C++ 的类。CGO 不支持 C++ 语法的根本原因是 C++ 至今为止还没有一个二进制接口规范 (ABI)。一个 C++ 类的构造函数在编译为目标文件时如何生成链接符号名称、方法在不同平台甚至是 C++ 的不同版本之间都是不一样的。但是 C++ 是兼容 C 语言,所以我们可以通过增加一组 C 语言函数接口作为 C++ 类和 CGO 之间的桥梁,这样就可以间接地实现 C++ 和 Go 之间的互联。当然,因为 CGO 只支持 C 语言中值类型的数据类型,所以我们是无法直接使用 C++ 的引用参数等特性的。
2.8.1 C++ 类到 Go 语言对象
实现 C++ 类到 Go 语言对象的包装需要经过以下几个步骤:首先是用纯 C 函数接口包装该 C++ 类;其次是通过 CGO 将纯 C 函数接口映射到 Go 函数;最后是做一个 Go 包装对象,将 C++ 类到方法用 Go 对象的方法实现。
2.8.1.1 准备一个 C++ 类
为了演示简单,我们基于 std::string 做一个最简单的缓存类 MyBuffer。除了构造函数和析构函数之外,只有两个成员函数分别是返回底层的数据指针和缓存的大小。因为是二进制缓存,所以我们可以在里面中放置任意数据。
// my_buffer.h
#include <string>

struct MyBuffer {
    std::string* s_;

    MyBuffer(int size) {
        this->s_ = new std::string(size, char('\0'));
    }
    ~MyBuffer() {
        delete this->s_;
    }

    int Size() const {
        return this->s_->size();
    }
    char* Data() {
        return (char*)this->s_->data();
    }
};
我们在构造函数中指定缓存的大小并分配空间,在使用完之后通过析构函数释放内部分配的内存空间。下面是简单的使用方式:
int main() {
    auto pBuf = new MyBuffer(1024);

    auto data = pBuf->Data();
    auto size = pBuf->Size();

    delete pBuf;
}
为了方便向 C 语言接口过渡,在此处我们故意没有定义 C++ 的拷贝构造函数。我们必须以 new 和 delete 来分配和释放缓存对象,而不能以值风格的方式来使用。
2.8.1.2 用纯 C 函数接口封装 C++ 类
如果要将上面的 C++ 类用 C 语言函数接口封装,我们可以从使用方式入手。我们可以将 new 和 delete 映射为 C 语言函数,将对象的方法也映射为 C 语言函数。
在 C 语言中我们期望 MyBuffer 类可以这样使用:
int main() {
    MyBuffer* pBuf = NewMyBuffer(1024);

    char* data = MyBuffer_Data(pBuf);
    auto size = MyBuffer_Size(pBuf);

    DeleteMyBuffer(pBuf);
}
先从 C 语言接口用户的角度思考需要什么样的接口,然后创建 my_buffer_capi.h 头文件接口规范:
// my_buffer_capi.h
typedef struct MyBuffer_T MyBuffer_T;

MyBuffer_T* NewMyBuffer(int size);
void DeleteMyBuffer(MyBuffer_T* p);

char* MyBuffer_Data(MyBuffer_T* p);
int MyBuffer_Size(MyBuffer_T* p);
然后就可以基于 C++ 的 MyBuffer 类定义这些 C 语言包装函数。我们创建对应的 my_buffer_capi.cc 文件如下:
// my_buffer_capi.cc

#include "./my_buffer.h"

extern "C" {
    #include "./my_buffer_capi.h"
}

struct MyBuffer_T: MyBuffer {
    MyBuffer_T(int size): MyBuffer(size) {}
    ~MyBuffer_T() {}
};

MyBuffer_T* NewMyBuffer(int size) {
    auto p = new MyBuffer_T(size);
    return p;
}
void DeleteMyBuffer(MyBuffer_T* p) {
    delete p;
}

char* MyBuffer_Data(MyBuffer_T* p) {
    return p->Data();
}
int MyBuffer_Size(MyBuffer_T* p) {
    return p->Size();
}
因为头文件 my_buffer_capi.h 是用于 CGO,必须是采用 C 语言规范的名字修饰规则。在 C++ 源文件包含时需要用 extern "C" 语句说明。另外 MyBuffer_T 的实现只是从 MyBuffer 继承的类,这样可以简化包装代码的实现。同时和 CGO 通信时必须通过 MyBuffer_T 指针,我们无法将具体的实现暴露给 CGO,因为实现中包含了 C++ 特有的语法,CGO 无法识别 C++ 特性。
将 C++ 类包装为纯 C 接口之后,下一步的工作就是将 C 函数转为 Go 函数。
2.8.1.3 将纯 C 接口函数转为 Go 函数
将纯 C 函数包装为对应的 Go 函数的过程比较简单。需要注意的是,因为我们的包中包含 C++11 的语法,因此需要通过 #cgo CXXFLAGS: -std=c++11 打开 C++11 的选项。
// my_buffer_capi.go

package main

/*
#cgo CXXFLAGS: -std=c++11

#include "my_buffer_capi.h"
*/
import "C"

type cgo_MyBuffer_T C.MyBuffer_T

func cgo_NewMyBuffer(size int) *cgo_MyBuffer_T {
    p := C.NewMyBuffer(C.int(size))
    return (*cgo_MyBuffer_T)(p)
}

func cgo_DeleteMyBuffer(p *cgo_MyBuffer_T) {
    C.DeleteMyBuffer((*C.MyBuffer_T)(p))
}

func cgo_MyBuffer_Data(p *cgo_MyBuffer_T) *C.char {
    return C.MyBuffer_Data((*C.MyBuffer_T)(p))
}

func cgo_MyBuffer_Size(p *cgo_MyBuffer_T) C.int {
    return C.MyBuffer_Size((*C.MyBuffer_T)(p))
}
为了区分,我们在 Go 中的每个类型和函数名称前面增加了 cgo_ 前缀,比如 cgo_MyBuffer_T 是对应 C 中的 MyBuffer_T 类型。
为了处理简单,在包装纯 C 函数到 Go 函数时,除了 cgo_MyBuffer_T 类型外,对输入参数和返回值的基础类型,我们依然是用的 C 语言的类型。
2.8.1.4 包装为 Go 对象
在将纯 C 接口包装为 Go 函数之后,我们就可以很容易地基于包装的 Go 函数构造出 Go 对象来。因为 cgo_MyBuffer_T 是从 C 语言空间导入的类型,它无法定义自己的方法,因此我们构造了一个新的 MyBuffer 类型,里面的成员持有 cgo_MyBuffer_T 指向的 C 语言缓存对象。
// my_buffer.go

package main

import "unsafe"

type MyBuffer struct {
    cptr *cgo_MyBuffer_T
}

func NewMyBuffer(size int) *MyBuffer {
    return &MyBuffer{
        cptr: cgo_NewMyBuffer(size),
    }
}

func (p *MyBuffer) Delete() {
    cgo_DeleteMyBuffer(p.cptr)
}

func (p *MyBuffer) Data() []byte {
    data := cgo_MyBuffer_Data(p.cptr)
    size := cgo_MyBuffer_Size(p.cptr)
    return ((*[1 << 31]byte)(unsafe.Pointer(data)))[0:int(size):int(size)]
}
同时,因为 Go 语言的切片本身含有长度信息,我们将 cgo_MyBuffer_Data 和 cgo_MyBuffer_Size 两个函数合并为 MyBuffer.Data 方法,它返回一个对应底层 C 语言缓存空间的切片。
现在我们就可以很容易在 Go 语言中使用包装后的缓存对象了(底层是基于 C++ 的 std::string 实现):
package main

//#include <stdio.h>
import "C"
import "unsafe"

func main() {
    buf := NewMyBuffer(1024)
    defer buf.Delete()

    copy(buf.Data(), []byte("hello\x00"))
    C.puts((*C.char)(unsafe.Pointer(&(buf.Data()[0]))))
}
例子中,我们创建了一个 1024 字节大小的缓存,然后通过 copy 函数向缓存填充了一个字符串。为了方便 C 语言字符串函数处理,我们在填充字符串的默认用'\0'表示字符串结束。最后我们直接获取缓存的底层数据指针,用 C 语言的 puts 函数打印缓存的内容。
2.8.2 Go 语言对象到 C++ 类
要实现 Go 语言对象到 C++ 类的包装需要经过以下几个步骤:首先是将 Go 对象映射为一个 id;然后基于 id 导出对应的 C 接口函数;最后是基于 C 接口函数包装为 C++ 对象。
2.8.2.1 构造一个 Go 对象
为了便于演示,我们用 Go 语言构建了一个 Person 对象,每个 Person 可以有名字和年龄信息:
package main

type Person struct {
    name string
    age  int
}

func NewPerson(name string, age int) *Person {
    return &Person{
        name: name,
        age:  age,
    }
}

func (p *Person) Set(name string, age int) {
    p.name = name
    p.age = age
}

func (p *Person) Get() (name string, age int) {
    return p.name, p.age
}
Person 对象如果想要在 C/C++ 中访问,需要通过 cgo 导出 C 接口来访问。
2.8.2.2 导出 C 接口
我们前面仿照 C++ 对象到 C 接口的过程,也抽象一组 C 接口描述 Person 对象。创建一个 person_capi.h 文件,对应 C 接口规范文件:
// person_capi.h
#include <stdint.h>

typedef uintptr_t person_handle_t;

person_handle_t person_new(char* name, int age);
void person_delete(person_handle_t p);

void person_set(person_handle_t p, char* name, int age);
char* person_get_name(person_handle_t p, char* buf, int size);
int person_get_age(person_handle_t p);
然后是在 Go 语言中实现这一组 C 函数。
需要注意的是,通过 CGO 导出 C 函数时,输入参数和返回值类型都不支持 const 修饰,同时也不支持可变参数的函数类型。同时如内存模式一节所述,我们无法在 C/C++ 中直接长期访问 Go 内存对象。因此我们使用前一节所讲述的技术将 Go 对象映射为一个整数 id。
下面是 person_capi.go 文件,对应 C 接口函数的实现:
// person_capi.go
package main

//#include "./person_capi.h"
import "C"
import "unsafe"

//export person_new
func person_new(name *C.char, age C.int) C.person_handle_t {
    id := NewObjectId(NewPerson(C.GoString(name), int(age)))
    return C.person_handle_t(id)
}

//export person_delete
func person_delete(h C.person_handle_t) {
    ObjectId(h).Free()
}

//export person_set
func person_set(h C.person_handle_t, name *C.char, age C.int) {
    p := ObjectId(h).Get().(*Person)
    p.Set(C.GoString(name), int(age))
}

//export person_get_name
func person_get_name(h C.person_handle_t, buf *C.char, size C.int) *C.char {
    p := ObjectId(h).Get().(*Person)
    name, _ := p.Get()

    n := int(size) - 1
    bufSlice := ((*[1 << 31]byte)(unsafe.Pointer(buf)))[0:n:n]
    n = copy(bufSlice, []byte(name))
    bufSlice[n] = 0

    return buf
}

//export person_get_age
func person_get_age(h C.person_handle_t) C.int {
    p := ObjectId(h).Get().(*Person)
    _, age := p.Get()
    return C.int(age)
}
在创建 Go 对象后,我们通过 NewObjectId 将 Go 对应映射为 id。然后将 id 强制转义为 person_handle_t 类型返回。其它的接口函数则是根据 person_handle_t 所表示的 id,让根据 id 解析出对应的 Go 对象。
2.8.2.3 封装 C++ 对象
有了 C 接口之后封装 C++ 对象就比较简单了。常见的做法是新建一个 Person 类,里面包含一个 person_handle_t 类型的成员对应真实的 Go 对象,然后在 Person 类的构造函数中通过 C 接口创建 Go 对象,在析构函数中通过 C 接口释放 Go 对象。下面是采用这种技术的实现:
extern "C" {
    #include "./person_capi.h"
}

struct Person {
    person_handle_t goobj_;

    Person(const char* name, int age) {
        this->goobj_ = person_new((char*)name, age);
    }
    ~Person() {
        person_delete(this->goobj_);
    }

    void Set(char* name, int age) {
        person_set(this->goobj_, name, age);
    }
    char* GetName(char* buf, int size) {
        return person_get_name(this->goobj_ buf, size);
    }
    int GetAge() {
        return person_get_age(this->goobj_);
    }
}
包装后我们就可以像普通 C++ 类那样使用了:
#include "person.h"

#include <stdio.h>

int main() {
    auto p = new Person("gopher", 10);

    char buf[64];
    char* name = p->GetName(buf, sizeof(buf)-1);
    int age = p->GetAge();

    printf("%s, %d years old.\n", name, age);
    delete p;

    return 0;
}
2.8.2.4 封装 C++ 对象改进
在前面的封装 C++ 对象的实现中,每次通过 new 创建一个 Person 实例需要进行两次内存分配:一次是针对 C++ 版本的 Person,再一次是针对 Go 语言版本的 Person。其实 C++ 版本的 Person 内部只有一个 person_handle_t 类型的 id,用于映射 Go 对象。我们完全可以将 person_handle_t 直接当中 C++ 对象来使用。
下面时改进后的包装方式:
extern "C" {
    #include "./person_capi.h"
}

struct Person {
    static Person* New(const char* name, int age) {
        return (Person*)person_new((char*)name, age);
    }
    void Delete() {
        person_delete(person_handle_t(this));
    }

    void Set(char* name, int age) {
        person_set(person_handle_t(this), name, age);
    }
    char* GetName(char* buf, int size) {
        return person_get_name(person_handle_t(this), buf, size);
    }
    int GetAge() {
        return person_get_age(person_handle_t(this));
    }
};
我们在 Person 类中增加了一个叫 New 静态成员函数,用于创建新的 Person 实例。在 New 函数中通过调用 person_new 来创建 Person 实例,返回的是 person_handle_t 类型的 id,我们将其强制转型作为 Person* 类型指针返回。在其它的成员函数中,我们通过将 this 指针再反向转型为 person_handle_t 类型,然后通过 C 接口调用对应的函数。
到此,我们就达到了将 Go 对象导出为 C 接口,然后基于 C 接口再包装为 C++ 对象以便于使用的目的。
2.8.3 彻底解放 C++ 的 this 指针
熟悉 Go 语言的用法会发现 Go 语言中方法是绑定到类型的。比如我们基于 int 定义一个新的 Int 类型,就可以有自己的方法:
type Int int

func (p Int) Twice() int {
    return int(p)*2
}

func main() {
    var x = Int(42)
    fmt.Println(int(x))
    fmt.Println(x.Twice())
}
这样就可以在不改变原有数据底层内存结构的前提下,自由切换 int 和 Int 类型来使用变量。
而在 C++ 中要实现类似的特性,一般会采用以下实现:
class Int {
    int v_;

    Int(v int) { this.v_ = v; }
    int Twice() const{ return this.v_*2;}
};

int main() {
    Int v(42);

    printf("%d\n", v); // error
    printf("%d\n", v.Twice());
}
新包装后的 Int 类虽然增加了 Twice 方法,但是失去了自由转回 int 类型的权利。这时候不仅连 printf 都无法输出 Int 本身的值,而且也失去了 int 类型运算的所有特性。这就是 C++ 构造函数的邪恶之处:以失去原有的一切特性的代价换取 class 的施舍。
造成这个问题的根源是 C++ 中 this 被固定为 class 的指针类型了。我们重新回顾下 this 在 Go 语言中的本质:
func (this Int) Twice() int
func Int_Twice(this Int) int
在 Go 语言中,和 this 有着相似功能的类型接收者参数其实只是一个普通的函数参数,我们可以自由选择值或指针类型。
如果以 C 语言的角度来思考,this 也只是一个普通的 void* 类型的指针,我们可以随意自由地将 this 转换为其它类型。
struct Int {
    int Twice() {
        const int* p = (int*)(this);
        return (*p) * 2;
    }
};
int main() {
    int x = 42;
    printf("%d\n", x);
    printf("%d\n", ((Int*)(&x))->Twice());
    return 0;
}
这样我们就可以通过将 int 类型指针强制转为 Int 类型指针,代替通过默认的构造函数后 new 来构造 Int 对象。
在 Twice 函数的内部,以相反的操作将 this 指针转回 int 类型的指针,就可以解析出原有的 int 类型的值了。
这时候 Int 类型只是编译时的一个壳子,并不会在运行时占用额外的空间。
因此 C++ 的方法其实也可以用于普通非 class 类型,C++ 到普通成员函数其实也是可以绑定到类型的。
只有纯虚方法是绑定到对象,那就是接口。
静态库和动态库
CGO 在使用 C/C++ 资源的时候一般有三种形式:直接使用源码;链接静态库;链接动态库。直接使用源码就是在 import "C" 之前的注释部分包含 C 代码,或者在当前包中包含 C/C++ 源文件。链接静态库和动态库的方式比较类似,都是通过在 LDFLAGS 选项指定要链接的库方式链接。本节我们主要关注在 CGO 中如何使用静态库和动态库相关的问题。
2.9.1 使用 C 静态库
如果 CGO 中引入的 C/C++ 资源有代码而且代码规模也比较小,直接使用源码是最理想的方式,但很多时候我们并没有源代码,或者从 C/C++ 源代码开始构建的过程异常复杂,这种时候使用 C 静态库也是一个不错的选择。静态库因为是静态链接,最终的目标程序并不会产生额外的运行时依赖,也不会出现动态库特有的跨运行时资源管理的错误。不过静态库对链接阶段会有一定要求:静态库一般包含了全部的代码,里面会有大量的符号,如果不同静态库之间出现了符号冲突则会导致链接的失败。
我们先用纯 C 语言构造一个简单的静态库。我们要构造的静态库名叫 number,库中只有一个 number_add_mod 函数,用于表示数论中的模加法运算。number 库的文件都在 number 目录下。
number/number.h 头文件只有一个纯 C 语言风格的函数声明:
int number_add_mod(int a, int b, int mod);number/number.c 对应函数的实现:
#include "number.h"

int number_add_mod(int a, int b, int mod) {
    return (a+b)%mod;
}
因为 CGO 使用的是 GCC 命令来编译和链接 C 和 Go 桥接的代码。因此静态库也必须是 GCC 兼容的格式。
通过以下命令可以生成一个叫 libnumber.a 的静态库:
$ cd ./number
$ gcc -c -o number.o number.c
$ ar rcs libnumber.a number.o
生成 libnumber.a 静态库之后,我们就可以在 CGO 中使用该资源了。
创建 main.go 文件如下:
package main

//#cgo CFLAGS: -I./number
//#cgo LDFLAGS: -L${SRCDIR}/number -lnumber
//
//#include "number.h"
import "C"
import "fmt"

func main() {
    fmt.Println(C.number_add_mod(10, 5, 12))
}
其中有两个 #cgo 命令,分别是编译和链接参数。CFLAGS 通过 -I./number 将 number 库对应头文件所在的目录加入头文件检索路径。LDFLAGS 通过 -L${SRCDIR}/number 将编译后 number 静态库所在目录加为链接库检索路径,-lnumber 表示链接 libnumber.a 静态库。需要注意的是,在链接部分的检索路径不能使用相对路径(C/C++ 代码的链接程序所限制),我们必须通过 cgo 特有的 ${SRCDIR} 变量将源文件对应的当前目录路径展开为绝对路径(因此在 windows 平台中绝对路径不能有空白符号)。
因为我们有 number 库的全部代码,所以我们可以用 go generate 工具来生成静态库,或者是通过 Makefile 来构建静态库。因此发布 CGO 源码包时,我们并不需要提前构建 C 静态库。
因为多了一个静态库的构建步骤,这种使用了自定义静态库并已经包含了静态库全部代码的 Go 包无法直接用 go get 安装。不过我们依然可以通过 go get 下载,然后用 go generate 触发静态库构建,最后才是 go install 来完成安装。
为了支持 go get 命令直接下载并安装,我们 C 语言的 #include 语法可以将 number 库的源文件链接到当前的包。
创建 z_link_number_c.c 文件如下:
#include "./number/number.c"然后在执行 go get 或 go build 之类命令的时候,CGO 就是自动构建 number 库对应的代码。这种技术是在不改变静态库源代码组织结构的前提下,将静态库转化为了源代码方式引用。这种 CGO 包是最完美的。
如果使用的是第三方的静态库,我们需要先下载安装静态库到合适的位置。然后在 #cgo 命令中通过 CFLAGS 和 LDFLAGS 来指定头文件和库的位置。对于不同的操作系统甚至同一种操作系统的不同版本来说,这些库的安装路径可能都是不同的,那么如何在代码中指定这些可能变化的参数呢?
在 Linux 环境,有一个 pkg-config 命令可以查询要使用某个静态库或动态库时的编译和链接参数。我们可以在 #cgo 命令中直接使用 pkg-config 命令来生成编译和链接参数。而且还可以通过 PKG_CONFIG 环境变量定制 pkg-config 命令。因为不同的操作系统对 pkg-config 命令的支持不尽相同,通过该方式很难兼容不同的操作系统下的构建参数。不过对于 Linux 等特定的系统,pkg-config 命令确实可以简化构建参数的管理。关于 pkg-config 的使用细节在此我们不深入展开,大家可以自行参考相关文档。
2.9.2 使用 C 动态库
动态库出现的初衷是对于相同的库,多个进程可以共享同一个,以节省内存和磁盘资源。但是在磁盘和内存已经白菜价的今天,这两个作用已经显得微不足道了,那么除此之外动态库还有哪些存在的价值呢?从库开发角度来说,动态库可以隔离不同动态库之间的关系,减少链接时出现符号冲突的风险。而且对于 windows 等平台,动态库是跨越 VC 和 GCC 不同编译器平台的唯一的可行方式。
对于 CGO 来说,使用动态库和静态库是一样的,因为动态库也必须要有一个小的静态导出库用于链接动态库(Linux 下可以直接链接 so 文件,但是在 Windows 下必须为 dll 创建一个 .a 文件用于链接)。我们还是以前面的 number 库为例来说明如何以动态库方式使用。
对于在 macOS 和 Linux 系统下的 gcc 环境,我们可以用以下命令创建 number 库的的动态库:
$ cd number
$ gcc -shared -o libnumber.so number.c
因为动态库和静态库的基础名称都是 libnumber,只是后缀名不同而已。因此 Go 语言部分的代码和静态库版本完全一样:
package main

//#cgo CFLAGS: -I./number
//#cgo LDFLAGS: -L${SRCDIR}/number -lnumber
//
//#include "number.h"
import "C"
import "fmt"

func main() {
    fmt.Println(C.number_add_mod(10, 5, 12))
}
编译时 GCC 会自动找到 libnumber.a 或 libnumber.so 进行链接。
对于 windows 平台,我们还可以用 VC 工具来生成动态库(windows 下有一些复杂的 C++ 库只能用 VC 构建)。我们需要先为 number.dll 创建一个 def 文件,用于控制要导出到动态库的符号。
number.def 文件的内容如下:
LIBRARY number.dll

EXPORTS
number_add_mod
其中第一行的 LIBRARY 指明动态库的文件名,然后的 EXPORTS 语句之后是要导出的符号名列表。
现在我们可以用以下命令来创建动态库(需要进入 VC 对应的 x64 命令行环境)。
$ cl /c number.c
$ link /DLL /OUT:number.dll number.obj number.def
这时候会为 dll 同时生成一个 number.lib 的导出库。但是在 CGO 中我们无法使用 lib 格式的链接库。
要生成 .a 格式的导出库需要通过 mingw 工具箱中的 dlltool 命令完成:
$ dlltool -dllname number.dll --def number.def --output-lib libnumber.a生成了 libnumber.a 文件之后,就可以通过 -lnumber 链接参数进行链接了。
需要注意的是,在运行时需要将动态库放到系统能够找到的位置。对于 windows 来说,可以将动态库和可执行程序放到同一个目录,或者将动态库所在的目录绝对路径添加到 PATH 环境变量中。对于 macOS 来说,需要设置 DYLD_LIBRARY_PATH 环境变量。而对于 Linux 系统来说,需要设置 LD_LIBRARY_PATH 环境变量。
2.9.3 导出 C 静态库
CGO 不仅可以使用 C 静态库,也可以将 Go 实现的函数导出为 C 静态库。我们现在用 Go 实现前面的 number 库的模加法函数。
创建 number.go,内容如下:
package main

import "C"

func main() {}

//export number_add_mod
func number_add_mod(a, b, mod C.int) C.int {
    return (a + b) % mod
}
根据 CGO 文档的要求,我们需要在 main 包中导出 C 函数。对于 C 静态库构建方式来说,会忽略 main 包中的 main 函数,只是简单导出 C 函数。采用以下命令构建:
$ go build -buildmode=c-archive -o number.a在生成 number.a 静态库的同时,cgo 还会生成一个 number.h 文件。
number.h 文件的内容如下(为了便于显示,内容做了精简):
#ifdef __cplusplus
extern "C" {
#endif

extern int number_add_mod(int p0, int p1, int p2);

#ifdef __cplusplus
}
#endif
其中 extern "C" 部分的语法是为了同时适配 C 和 C++ 两种语言。核心内容是声明了要导出的 number_add_mod 函数。
然后我们创建一个 _test_main.c 的 C 文件用于测试生成的 C 静态库(用下划线作为前缀名是让为了让 go build 构建 C 静态库时忽略这个文件):
#include "number.h"

#include <stdio.h>

int main() {
    int a = 10;
    int b = 5;
    int c = 12;

    int x = number_add_mod(a, b, c);
    printf("(%d+%d)%%%d = %d\n", a, b, c, x);

    return 0;
}
通过以下命令编译并运行:
$ gcc -o a.out _test_main.c number.a
$ ./a.out
使用 CGO 创建静态库的过程非常简单。
2.9.4 导出 C 动态库
CGO 导出动态库的过程和静态库类似,只是将构建模式改为 c-shared,输出文件名改为 number.so 而已:
$ go build -buildmode=c-shared -o number.so_test_main.c 文件内容不变,然后用以下命令编译并运行:
$ gcc -o a.out _test_main.c number.so
$ ./a.out
2.9.5 导出非 main 包的函数
通过 go help buildmode 命令可以查看 C 静态库和 C 动态库的构建说明:
-buildmode=c-archive
    Build the listed main package, plus all packages it imports,
    into a C archive file. The only callable symbols will be those
    functions exported using a cgo //export comment. Requires
    exactly one main package to be listed.

-buildmode=c-shared
    Build the listed main package, plus all packages it imports,
    into a C shared library. The only callable symbols will
    be those functions exported using a cgo //export comment.
    Requires exactly one main package to be listed.
文档说明导出的 C 函数必须是在 main 包导出,然后才能在生成的头文件包含声明的语句。但是很多时候我们可能更希望将不同类型的导出函数组织到不同的 Go 包中,然后统一导出为一个静态库或动态库。
要实现从是从非 main 包导出 C 函数,或者是多个包导出 C 函数(因为只能有一个 main 包),我们需要自己提供导出 C 函数对应的头文件(因为 CGO 无法为非 main 包的导出函数生成头文件)。
假设我们先创建一个 number 子包,用于提供模加法函数:
package number

import "C"

//export number_add_mod
func number_add_mod(a, b, mod C.int) C.int {
    return (a + b) % mod
}
然后是当前的 main 包:
package main

import "C"

import (
    "fmt"

    _ "./number"
)

func main() {
    println("Done")
}

//export goPrintln
func goPrintln(s *C.char) {
    fmt.Println("goPrintln:", C.GoString(s))
}
其中我们导入了 number 子包,在 number 子包中有导出的 C 函数 number_add_mod,同时我们在 main 包也导出了 goPrintln 函数。
通过以下命令创建 C 静态库:
$ go build -buildmode=c-archive -o main.a这时候在生成 main.a 静态库的同时,也会生成一个 main.h 头文件。但是 main.h 头文件中只有 main 包中导出的 goPrintln 函数的声明,并没有 number 子包导出函数的声明。其实 number_add_mod 函数在生成的 C 静态库中是存在的,我们可以直接使用。
创建 _test_main.c 测试文件如下:
#include <stdio.h>

void goPrintln(char*);
int number_add_mod(int a, int b, int mod);

int main() {
    int a = 10;
    int b = 5;
    int c = 12;

    int x = number_add_mod(a, b, c);
    printf("(%d+%d)%%%d = %d\n", a, b, c, x);

    goPrintln("done");
    return 0;
}
我们并没有包含 CGO 自动生成的 main.h 头文件,而是通过手工方式声明了 goPrintln 和 number_add_mod 两个导出函数。这样我们就实现了从多个 Go 包导出 C 函数了。
编译和链接参数
编译和链接参数是每一个 C/C++ 程序员需要经常面对的问题。构建每一个 C/C++ 应用均需要经过编译和链接两个步骤,CGO 也是如此。
本节我们将简要讨论 CGO 中经常用到的编译和链接参数的用法。
2.10.1 编译参数:CFLAGS/CPPFLAGS/CXXFLAGS
编译参数主要是头文件的检索路径,预定义的宏等参数。理论上来说 C 和 C++ 是完全独立的两个编程语言,它们可以有着自己独立的编译参数。
但是因为 C++ 语言对 C 语言做了深度兼容,甚至可以将 C++ 理解为 C 语言的超集,因此 C 和 C++ 语言之间又会共享很多编译参数。
因此 CGO 提供了 CFLAGS/CPPFLAGS/CXXFLAGS 三种参数,其中 CFLAGS 对应 C 语言编译参数 (以 .c 后缀名)、
CPPFLAGS 对应 C/C++ 代码编译参数 (.c,.cc,.cpp,.cxx)、CXXFLAGS 对应纯 C++ 编译参数 (.cc,.cpp,*.cxx)。
2.10.2 链接参数:LDFLAGS
链接参数主要包含要链接库的检索目录和要链接库的名字。因为历史遗留问题,链接库不支持相对路径,我们必须为链接库指定绝对路径。
cgo 中的 ${SRCDIR} 为当前目录的绝对路径。经过编译后的 C 和 C++ 目标文件格式是一样的,因此 LDFLAGS 对应 C/C++ 共同的链接参数。
2.10.3 pkg-config
为不同 C/C++ 库提供编译和链接参数是一项非常繁琐的工作,因此 cgo 提供了对应 pkg-config 工具的支持。
我们可以通过 #cgo pkg-config xxx 命令来生成 xxx 库需要的编译和链接参数,其底层通过调用
pkg-config xxx --cflags 生成编译参数,通过 pkg-config xxx --libs 命令生成链接参数。
需要注意的是 pkg-config 工具生成的编译和链接参数是 C/C++ 公用的,无法做更细的区分。
pkg-config 工具虽然方便,但是有很多非标准的 C/C++ 库并没有实现对其支持。
这时候我们可以手工为 pkg-config 工具创建对应库的编译和链接参数实现支持。
比如有一个名为 xxx 的 C/C++ 库,我们可以手工创建 /usr/local/lib/pkgconfig/xxx.pc 文件:
Name: xxx
Cflags:-I/usr/local/include
Libs:-L/usr/local/lib –lxxx2
其中 Name 是库的名字,Cflags 和 Libs 行分别对应 xxx 使用库需要的编译和链接参数。如果 pc 文件在其它目录,
可以通过 PKG_CONFIG_PATH 环境变量指定 pkg-config 工具的检索目录。
而对应 cgo 来说,我们甚至可以通过 PKG_CONFIG 环境变量可指定自定义的 pkg-config 程序。
如果是自己实现 CGO 专用的 pkg-config 程序,只要处理 --cflags 和 --libs 两个参数即可。
下面的程序是 macos 系统下生成 Python3 的编译和链接参数:
// py3-config.go
func main() {
    for _, s := range os.Args {
        if s == "--cflags" {
            out, _ := exec.Command("python3-config", "--cflags").CombinedOutput()
            out = bytes.Replace(out, []byte("-arch"), []byte{}, -1)
            out = bytes.Replace(out, []byte("i386"), []byte{}, -1)
            out = bytes.Replace(out, []byte("x86_64"), []byte{}, -1)
            fmt.Print(string(out))
            return
        }
        if s == "--libs" {
            out, _ := exec.Command("python3-config", "--ldflags").CombinedOutput()
            fmt.Print(string(out))
            return
        }
    }
}
然后通过以下命令构建并使用自定义的 pkg-config 工具:
$ go build -o py3-config py3-config.go
$ PKG_CONFIG=./py3-config go build -buildmode=c-shared -o gopkg.so main.go
具体的细节可以参考 Go 实现 Python 模块章节。
2.10.4 go get 链
在使用 go get 获取 Go 语言包的同时会获取包依赖的包。比如 A 包依赖 B 包,B 包依赖 C 包,C 包依赖 D 包:
pkgA -> pkgB -> pkgC -> pkgD -> ...。再 go get 获取 A 包之后会依次线获取 BCD 包。
如果在获取 B 包之后构建失败,那么将导致链条的断裂,从而导致 A 包的构建失败。
链条断裂的原因有很多,其中常见的原因有:
- 不支持某些系统, 编译失败
- 依赖 cgo, 用户没有安装 gcc
- 依赖 cgo, 但是依赖的库没有安装
- 依赖 pkg-config, windows 上没有安装
- 依赖 pkg-config, 没有找到对应的 bc 文件
- 依赖 自定义的 pkg-config, 需要额外的配置
- 依赖 swig, 用户没有安装 swig, 或版本不对
仔细分析可以发现,失败的原因中和 CGO 相关的问题占了绝大多数。这并不是偶然现象,
自动化构建 C/C++ 代码一直是一个世界难题,到目前位置也没有出现一个大家认可的统一的 C/C++ 管理工具。
因为用了 cgo,比如 gcc 等构建工具是必须安装的,同时尽量要做到对主流系统的支持。
如果依赖的 C/C++ 包比较小并且有源代码的前提下,可以优先选择从代码构建。
比如 github.com/chai2010/webp 包通过为每个 C/C++ 源文件在当前包建立关键文件实现零配置依赖:
// z_libwebp_src_dec_alpha.c
#include "./internal/libwebp/src/dec/alpha.c"
因此在编译 z_libwebp_src_dec_alpha.c 文件时,会编译 libweb 原生的代码。
其中的依赖是相对目录,对于不同的平台支持可以保持最大的一致性。
2.10.5 多个非 main 包中导出 C 函数
官方文档说明导出的 Go 函数要放 main 包,但是真实情况是其它包的 Go 导出函数也是有效的。
因为导出后的 Go 函数就可以当作 C 函数使用,所以必须有效。但是不同包导出的 Go 函数将在同一个全局的名字空间,因此需要小心避免重名的问题。
如果是从不同的包导出 Go 函数到 C 语言空间,那么 cgo 自动生成的 _cgo_export.h 文件将无法包含全部导出的函数声明,
我们必须通过手写头文件的方式声明导出的全部函数。
补充说明
2.11 补充说明
CGO 是 C 语言和 Go 语言混合编程的技术,因此要想熟练地使用 CGO 需要了解这两门语言。C 语言推荐两本书:第一本是 C 语言之父编写的《C 程序设计语言》;第二本是讲述 C 语言模块化编程的《C 语言接口与实现: 创建可重用软件的技术》。Go 语言推荐官方出版的《The Go Programming Language》和 Go 语言自带的全部文档和全部代码。
为何要花费巨大的精力学习 CGO 是一个问题。任何技术和语言都有它自身的优点和不足,Go 语言不是银弹,它无法解决全部问题。而通过 CGO 可以继承 C/C++ 将近半个世纪的软件遗产,通过 CGO 可以用 Go 给其它系统写 C 接口的共享库,通过 CGO 技术可以让 Go 语言编写的代码可以很好地融入现有的软件生态——而现在的软件正式建立在 C/C++ 语言之上的。因此说 CGO 是一个保底的后备技术,它是 Go 的一个重量级的替补技术,值得任何一个严肃的 Go 语言开发人员学习。