5 / 7
Go和Web
Web开发简介
因为 Go 的 net/http 包提供了基础的路由函数组合与丰富的功能函数。所以在社区里流行一种用 Go 编写 API 不需要框架的观点,在我们看来,如果你的项目的路由在个位数、URI 固定且不通过 URI 来传递参数,那么确实使用官方库也就足够。但在复杂场景下,官方的 http 库还是有些力有不逮。例如下面这样的路由:
GET   /card/:id
POST  /card/:id
DELTE /card/:id
GET   /card/:id/name
...
GET   /card/:id/relations
可见是否使用框架还是要具体问题具体分析的。
Go 的 Web 框架大致可以分为这么两类:
- Router 框架
- MVC 类框架
在框架的选择上,大多数情况下都是依照个人的喜好和公司的技术栈。例如公司有很多技术人员是 PHP 出身,那么他们一定会非常喜欢像 beego 这样的框架,但如果公司有很多 C 程序员,那么他们的想法可能是越简单越好。比如很多大厂的 C 程序员甚至可能都会去用 C 语言去写很小的 CGI 程序,他们可能本身并没有什么意愿去学习 MVC 或者更复杂的 Web 框架,他们需要的只是一个非常简单的路由(甚至连路由都不需要,只需要一个基础的 HTTP 协议处理库来帮他省掉没什么意思的体力劳动)。
Go 的 net/http 包提供的就是这样的基础功能,写一个简单的 http echo server 只需要 30s。
//brief_intro/echo.go
package main
import (...)

func echo(wr http.ResponseWriter, r *http.Request) {
    msg, err := ioutil.ReadAll(r.Body)
    if err != nil {
        wr.Write([]byte("echo error"))
        return
    }

    writeLen, err := wr.Write(msg)
    if err != nil || writeLen != len(msg) {
        log.Println(err, "write len:", writeLen)
    }
}

func main() {
    http.HandleFunc("/", echo)
    err := http.ListenAndServe(":8080", nil)
    if err != nil {
        log.Fatal(err)
    }
}
如果你过了 30s 还没有完成这个程序,请检查一下你自己的打字速度是不是慢了(开个玩笑 :D)。这个例子是为了说明在 Go 中写一个 HTTP 协议的小程序有多么简单。如果你面临的情况比较复杂,例如几十个接口的企业级应用,直接用 net/http 库就显得不太合适了。
我们来看看开源社区中一个 Kafka 监控项目中的做法:
//Burrow: http_server.go
func NewHttpServer(app *ApplicationContext) (*HttpServer, error) {
    ...
    server.mux.HandleFunc("/", handleDefault)

    server.mux.HandleFunc("/burrow/admin", handleAdmin)

    server.mux.Handle("/v2/kafka", appHandler{server.app, handleClusterList})
    server.mux.Handle("/v2/kafka/", appHandler{server.app, handleKafka})
    server.mux.Handle("/v2/zookeeper", appHandler{server.app, handleClusterList})
    ...
}
上面这段代码来自大名鼎鼎的 linkedin 公司的 Kafka 监控项目 Burrow,没有使用任何 router 框架,只使用了 net/http。只看上面这段代码似乎非常优雅,我们的项目里大概只有这五个简单的 URI,所以我们提供的服务就是下面这个样子:
/
/burrow/admin
/v2/kafka
/v2/kafka/
/v2/zookeeper
如果你确实这么想的话就被骗了。我们再进 handleKafka() 这个函数一探究竟:
func handleKafka(app *ApplicationContext, w http.ResponseWriter, r *http.Request) (int, string) {
    pathParts := strings.Split(r.URL.Path[1:], "/")
    if _, ok := app.Config.Kafka[pathParts[2]]; !ok {
        return makeErrorResponse(http.StatusNotFound, "cluster not found", w, r)
    }
    if pathParts[2] == "" {
        // Allow a trailing / on requests
        return handleClusterList(app, w, r)
    }
    if (len(pathParts) == 3) || (pathParts[3] == "") {
        return handleClusterDetail(app, w, r, pathParts[2])
    }

    switch pathParts[3] {
    case "consumer":
        switch {
        case r.Method == "DELETE":
            switch {
            case (len(pathParts) == 5) || (pathParts[5] == ""):
                return handleConsumerDrop(app, w, r, pathParts[2], pathParts[4])
            default:
                return makeErrorResponse(http.StatusMethodNotAllowed, "request method not supported", w, r)
            }
        case r.Method == "GET":
            switch {
            case (len(pathParts) == 4) || (pathParts[4] == ""):
                return handleConsumerList(app, w, r, pathParts[2])
            case (len(pathParts) == 5) || (pathParts[5] == ""):
                // Consumer detail - list of consumer streams/hosts? Can be config info later
                return makeErrorResponse(http.StatusNotFound, "unknown API call", w, r)
            case pathParts[5] == "topic":
                switch {
                case (len(pathParts) == 6) || (pathParts[6] == ""):
                    return handleConsumerTopicList(app, w, r, pathParts[2], pathParts[4])
                case (len(pathParts) == 7) || (pathParts[7] == ""):
                    return handleConsumerTopicDetail(app, w, r, pathParts[2], pathParts[4], pathParts[6])
                }
            case pathParts[5] == "status":
                return handleConsumerStatus(app, w, r, pathParts[2], pathParts[4], false)
            case pathParts[5] == "lag":
                return handleConsumerStatus(app, w, r, pathParts[2], pathParts[4], true)
            }
        default:
            return makeErrorResponse(http.StatusMethodNotAllowed, "request method not supported", w, r)
        }
    case "topic":
        switch {
        case r.Method != "GET":
            return makeErrorResponse(http.StatusMethodNotAllowed, "request method not supported", w, r)
        case (len(pathParts) == 4) || (pathParts[4] == ""):
            return handleBrokerTopicList(app, w, r, pathParts[2])
        case (len(pathParts) == 5) || (pathParts[5] == ""):
            return handleBrokerTopicDetail(app, w, r, pathParts[2], pathParts[4])
        }
    case "offsets":
        // Reserving this endpoint to implement later
        return makeErrorResponse(http.StatusNotFound, "unknown API call", w, r)
    }

    // If we fell through, return a 404
    return makeErrorResponse(http.StatusNotFound, "unknown API call", w, r)
}
因为默认的 net/http 包中的 mux 不支持带参数的路由,所以 Burrow 这个项目使用了非常蹩脚的字符串 Split 和乱七八糟的 switch case 来达到自己的目的,但却让本来应该很集中的路由管理逻辑变得复杂,散落在系统的各处,难以维护和管理。如果读者细心地看过这些代码之后,可能会发现其它的几个 handler 函数逻辑上较简单,最复杂的也就是这个 handleKafka()。而我们的系统总是从这样微不足道的混乱开始积少成多,最终变得难以收拾。
根据我们的经验,简单地来说,只要你的路由带有参数,并且这个项目的 API 数目超过了 10,就尽量不要使用 net/http 中默认的路由。在 Go 开源界应用最广泛的 router 是 httpRouter,很多开源的 router 框架都是基于 httpRouter 进行一定程度的改造的成果。关于 httpRouter 路由的原理,会在本章节的 router 一节中进行详细的阐释。
再来回顾一下文章开头说的,开源界有这么几种框架,第一种是对 httpRouter 进行简单的封装,然后提供定制的中间件和一些简单的小工具集成比如 gin,主打轻量,易学,高性能。第二种是借鉴其它语言的编程风格的一些 MVC 类框架,例如 beego,方便从其它语言迁移过来的程序员快速上手,快速开发。还有一些框架功能更为强大,除了数据库 schema 设计,大部分代码直接生成,例如 goa。不管哪种框架,适合开发者背景的就是最好的。
本章的内容除了会展开讲解 router 和中间件的原理外,还会以现在工程界面临的问题结合 Go 来进行一些实践性的说明。希望能够对没有接触过相关内容的读者有所帮助。
请求路由
在常见的 Web 框架中,router 是必备的组件。Go 语言圈子里 router 也时常被称为 http 的 multiplexer。在上一节中我们通过对 Burrow 代码的简单学习,已经知道如何用 http 标准库中内置的 mux 来完成简单的路由功能了。如果开发 Web 系统对路径中带参数没什么兴趣的话,用 http 标准库中的 mux 就可以。
RESTful 是几年前刮起的 API 设计风潮,在 RESTful 中除了 GET 和 POST 之外,还使用了 HTTP 协议定义的几种其它的标准化语义。具体包括:
const (
    MethodGet     = "GET"
    MethodHead    = "HEAD"
    MethodPost    = "POST"
    MethodPut     = "PUT"
    MethodPatch   = "PATCH" // RFC 5789
    MethodDelete  = "DELETE"
    MethodConnect = "CONNECT"
    MethodOptions = "OPTIONS"
    MethodTrace   = "TRACE"
)
来看看 RESTful 中常见的请求路径:
GET /repos/:owner/:repo/comments/:id/reactions

POST /projects/:project_id/columns

PUT /user/starred/:owner/:repo

DELETE /user/starred/:owner/:repo
相信聪明的你已经猜出来了,这是 Github 官方文档中挑出来的几个 API 设计。RESTful 风格的 API 重度依赖请求路径。会将很多参数放在请求 URI 中。除此之外还会使用很多并不那么常见的 HTTP 状态码,不过本节只讨论路由,所以先略过不谈。
如果我们的系统也想要这样的 URI 设计,使用标准库的 mux 显然就力不从心了。
5.2.1 httprouter
较流行的开源 go Web 框架大多使用 httprouter,或是基于 httprouter 的变种对路由进行支持。前面提到的 Github 的参数式路由在 httprouter 中都是可以支持的。
因为 httprouter 中使用的是显式匹配,所以在设计路由的时候需要规避一些会导致路由冲突的情况,例如:
conflict:
GET /user/info/:name
GET /user/:id

no conflict:
GET /user/info/:name
POST /user/:id
简单来讲的话,如果两个路由拥有一致的 http 方法 (指 GET、POST、PUT、DELETE) 和请求路径前缀,且在某个位置出现了 A 路由是 wildcard(指 :id 这种形式)参数,B 路由则是普通字符串,那么就会发生路由冲突。路由冲突会在初始化阶段直接 panic:
panic: wildcard route ':id' conflicts with existing children in path '/user/:id'

goroutine 1 [running]:
github.com/cch123/httprouter.(*node).insertChild(0xc4200801e0, 0xc42004fc01, 0x126b177, 0x3, 0x126b171, 0x9, 0x127b668)
  /Users/caochunhui/go_work/src/github.com/cch123/httprouter/tree.go:256 +0x841
github.com/cch123/httprouter.(*node).addRoute(0xc4200801e0, 0x126b171, 0x9, 0x127b668)
  /Users/caochunhui/go_work/src/github.com/cch123/httprouter/tree.go:221 +0x22a
github.com/cch123/httprouter.(*Router).Handle(0xc42004ff38, 0x126a39b, 0x3, 0x126b171, 0x9, 0x127b668)
  /Users/caochunhui/go_work/src/github.com/cch123/httprouter/router.go:262 +0xc3
github.com/cch123/httprouter.(*Router).GET(0xc42004ff38, 0x126b171, 0x9, 0x127b668)
  /Users/caochunhui/go_work/src/github.com/cch123/httprouter/router.go:193 +0x5e
main.main()
  /Users/caochunhui/test/go_web/httprouter_learn2.go:18 +0xaf
exit status 2
还有一点需要注意,因为 httprouter 考虑到字典树的深度,在初始化时会对参数的数量进行限制,所以在路由中的参数数目不能超过 255,否则会导致 httprouter 无法识别后续的参数。不过这一点上也不用考虑太多,毕竟 URI 是人设计且给人来看的,相信没有长得夸张的 URI 能在一条路径中带有 200 个以上的参数。
除支持路径中的 wildcard 参数之外,httprouter 还可以支持 * 号来进行通配,不过 * 号开头的参数只能放在路由的结尾,例如下面这样:
Pattern: /src/*filepath

 /src/                     filepath = ""
 /src/somefile.go          filepath = "somefile.go"
 /src/subdir/somefile.go   filepath = "subdir/somefile.go"
这种设计在 RESTful 中可能不太常见,主要是为了能够使用 httprouter 来做简单的 HTTP 静态文件服务器。
除了正常情况下的路由支持,httprouter 也支持对一些特殊情况下的回调函数进行定制,例如 404 的时候:
r := httprouter.New()
r.NotFound = http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
    w.Write([]byte("oh no, not found"))
})
或者内部 panic 的时候:
r.PanicHandler = func(w http.ResponseWriter, r *http.Request, c interface{}) {
    log.Printf("Recovering from panic, Reason: %#v", c.(error))
    w.WriteHeader(http.StatusInternalServerError)
    w.Write([]byte(c.(error).Error()))
}
目前开源界最为流行(star 数最多)的 Web 框架 gin 使用的就是 httprouter 的变种。
5.2.2 原理
httprouter 和众多衍生 router 使用的数据结构被称为压缩字典树(Radix Tree)。读者可能没有接触过压缩字典树,但对字典树(Trie Tree)应该有所耳闻。图 5-1 是一个典型的字典树结构:
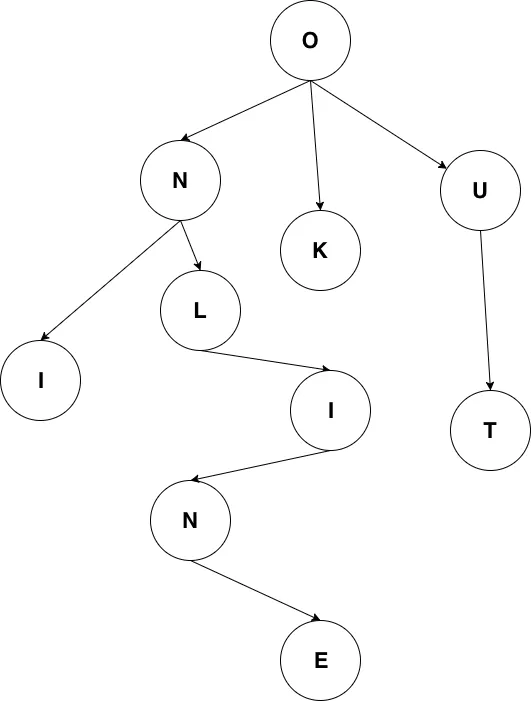
图 5-1 字典树
字典树常用来进行字符串检索,例如用给定的字符串序列建立字典树。对于目标字符串,只要从根节点开始深度优先搜索,即可判断出该字符串是否曾经出现过,时间复杂度为 O(n),n 可以认为是目标字符串的长度。为什么要这样做?字符串本身不像数值类型可以进行数值比较,两个字符串对比的时间复杂度取决于字符串长度。如果不用字典树来完成上述功能,要对历史字符串进行排序,再利用二分查找之类的算法去搜索,时间复杂度只高不低。可认为字典树是一种空间换时间的典型做法。
普通的字典树有一个比较明显的缺点,就是每个字母都需要建立一个孩子节点,这样会导致字典树的层数比较深,压缩字典树相对好地平衡了字典树的优点和缺点。是典型的压缩字典树结构:
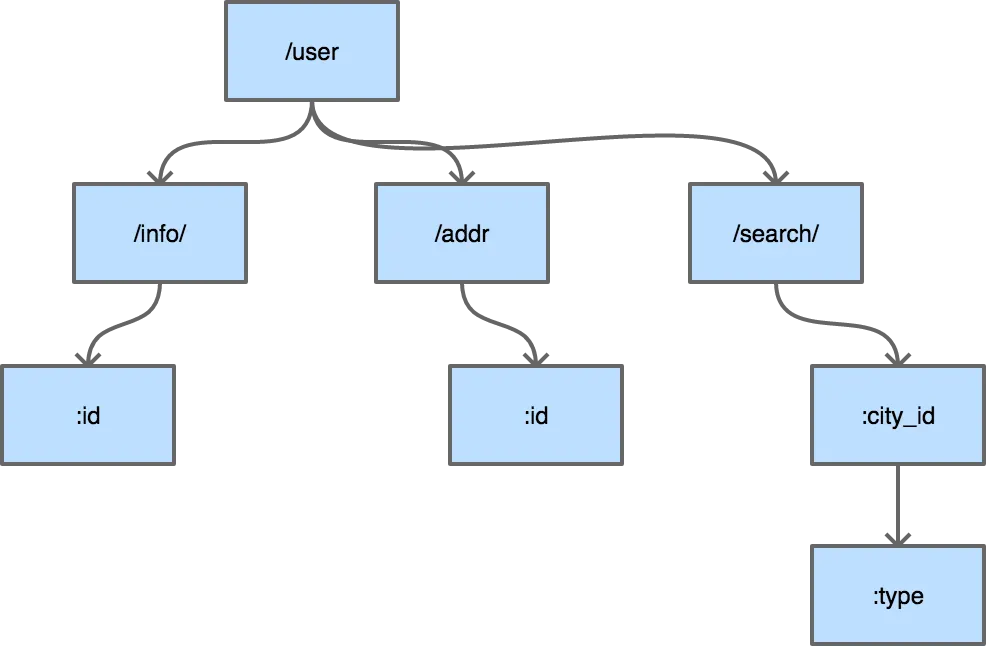
图 5-2 压缩字典树
每个节点上不只存储一个字母了,这也是压缩字典树中 “压缩” 的主要含义。使用压缩字典树可以减少树的层数,同时因为每个节点上数据存储也比通常的字典树要多,所以程序的局部性较好(一个节点的 path 加载到 cache 即可进行多个字符的对比),从而对 CPU 缓存友好。
5.2.3 压缩字典树创建过程
我们来跟踪一下 httprouter 中,一个典型的压缩字典树的创建过程,路由设定如下:
PUT /user/installations/:installation_id/repositories/:repository_id

GET /marketplace_listing/plans/
GET /marketplace_listing/plans/:id/accounts
GET /search
GET /status
GET /support

补充路由:
GET /marketplace_listing/plans/ohyes
最后一条补充路由是我们臆想的,除此之外所有 API 路由均来自于 api.github.com。
5.2.3.1 root 节点创建
httprouter 的 Router 结构体中存储压缩字典树使用的是下述数据结构:
// 略去了其它部分的 Router struct
type Router struct {
    // ...
    trees map[string]*node
    // ...
}
trees 中的 key 即为 HTTP 1.1 的 RFC 中定义的各种方法,具体有:
GET
HEAD
OPTIONS
POST
PUT
PATCH
DELETE每一种方法对应的都是一棵独立的压缩字典树,这些树彼此之间不共享数据。具体到我们上面用到的路由,PUT 和 GET 是两棵树而非一棵。
简单来讲,某个方法第一次插入的路由就会导致对应字典树的根节点被创建,我们按顺序,先是一个 PUT:
r := httprouter.New()
r.PUT("/user/installations/:installation_id/repositories/:reposit", Hello)
这样 PUT 对应的根节点就会被创建出来。把这棵 PUT 的树画出来:
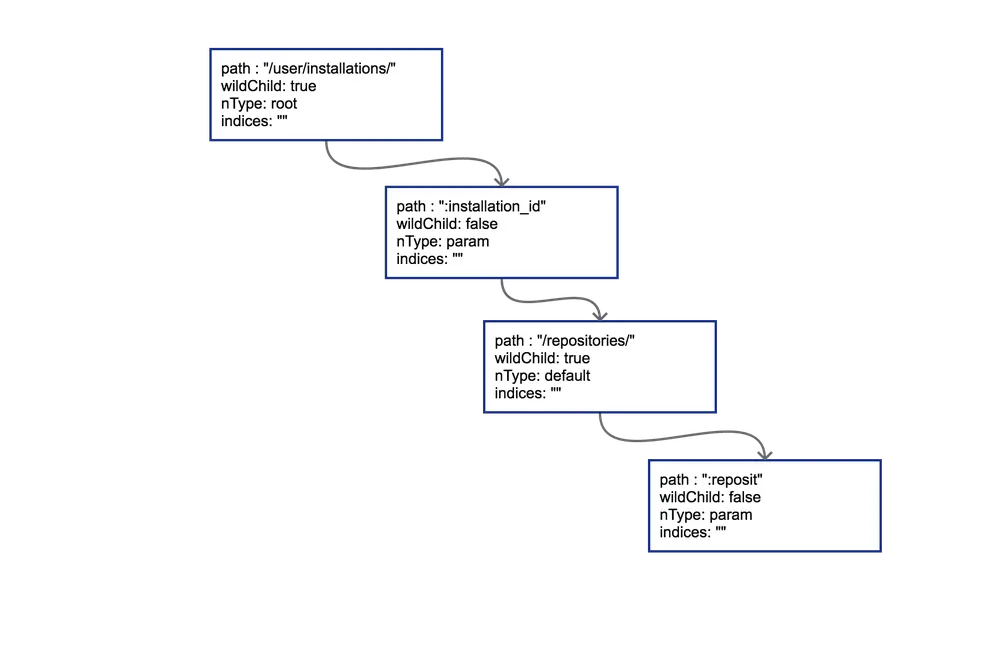
图 5-3 插入路由之后的压缩字典树
radix 的节点类型为 *httprouter.node,为了说明方便,我们留下了目前关心的几个字段:
path: 当前节点对应的路径中的字符串

wildChild: 子节点是否为参数节点,即 wildcard node,或者说 :id 这种类型的节点

nType: 当前节点类型,有四个枚举值: 分别为 static/root/param/catchAll。
    static                   // 非根节点的普通字符串节点
    root                     // 根节点
    param                    // 参数节点,例如 :id
    catchAll                 // 通配符节点,例如 *anyway

indices:子节点索引,当子节点为非参数类型,即本节点的 wildChild 为 false 时,会将每个子节点的首字母放在该索引数组。说是数组,实际上是个 string。当然,PUT 路由只有唯一的一条路径。接下来,我们以后续的多条 GET 路径为例,讲解子节点的插入过程。
5.2.3.2 子节点插入
当插入 GET /marketplace_listing/plans 时,类似前面 PUT 的过程,GET 树的结构如 图 5-4:
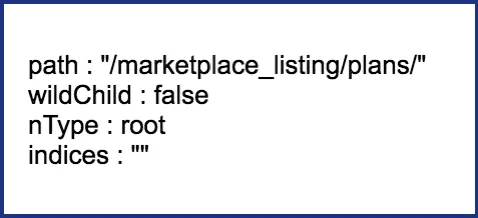
图 5-4 插入第一个节点的压缩字典树
因为第一个路由没有参数,path 都被存储到根节点上了。所以只有一个节点。
然后插入 GET /marketplace_listing/plans/:id/accounts,新的路径与之前的路径有共同的前缀,且可以直接在之前叶子节点后进行插入,那么结果也很简单,插入后的树结构见 图 5-5:
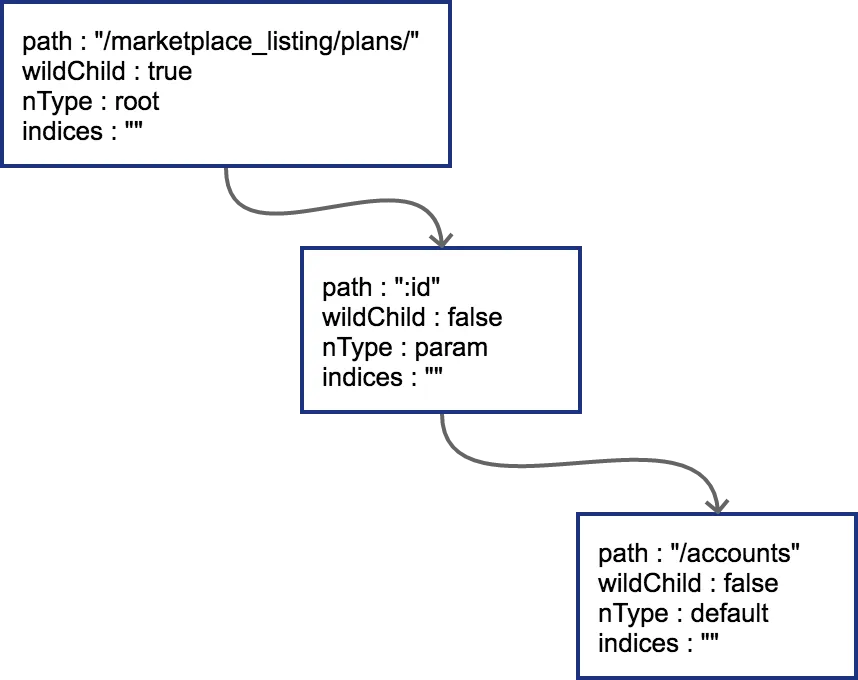
图 5-5 插入第二个节点的压缩字典树
由于 :id 这个节点只有一个字符串的普通子节点,所以 indices 还依然不需要处理。
上面这种情况比较简单,新的路由可以直接作为原路由的子节点进行插入。实际情况不会这么美好。
5.2.3.3 边分裂
接下来我们插入 GET /search,这时会导致树的边分裂,见 图 5-6。
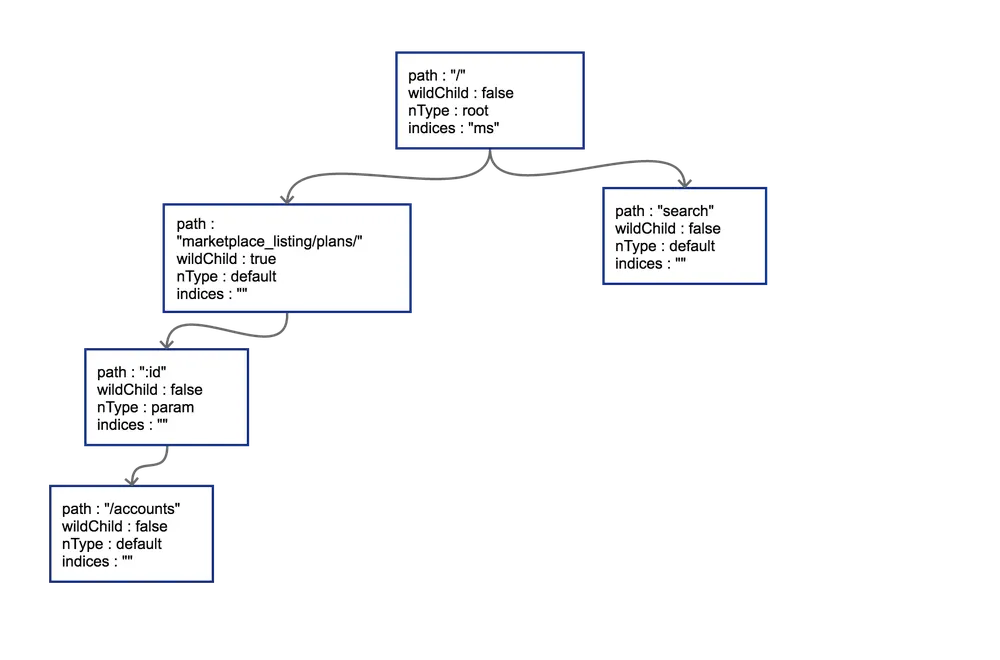
图 5-6 插入第三个节点,导致边分裂
原有路径和新的路径在初始的 / 位置发生分裂,这样需要把原有的 root 节点内容下移,再将新路由 search 同样作为子节点挂在 root 节点之下。这时候因为子节点出现多个,root 节点的 indices 提供子节点索引,这时候该字段就需要派上用场了。"ms" 代表子节点的首字母分别为 m(marketplace)和 s(search)。
我们一口作气,把 GET /status 和 GET /support 也插入到树中。这时候会导致在 search 节点上再次发生分裂,最终结果见 图 5-7:
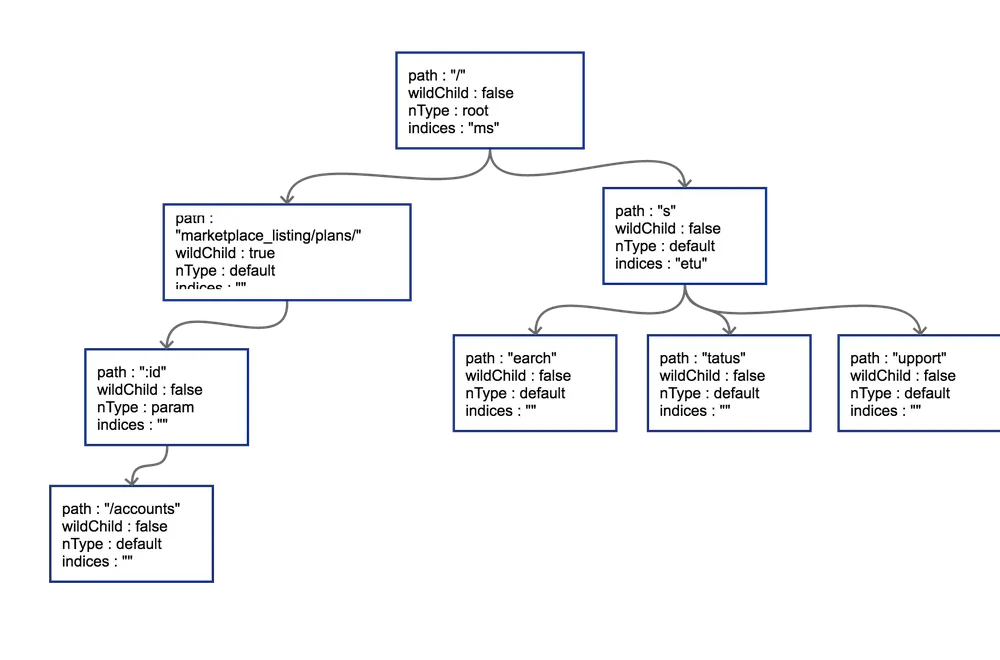
图 5-7 插入所有路由后的压缩字典树
5.2.3.4 子节点冲突处理
在路由本身只有字符串的情况下,不会发生任何冲突。只有当路由中含有 wildcard(类似 :id)或者 catchAll 的情况下才可能冲突。这一点在前面已经提到了。
子节点的冲突处理很简单,分几种情况:
- 在插入 wildcard 节点时,父节点的 children 数组非空且 wildChild 被设置为 false。例如:
GET /user/getAll和GET /user/:id/getAddr,或者GET /user/*aaa和GET /user/:id。 - 在插入 wildcard 节点时,父节点的 children 数组非空且 wildChild 被设置为 true,但该父节点的 wildcard 子节点要插入的 wildcard 名字不一样。例如:
GET /user/:id/info和GET /user/:name/info。 - 在插入 catchAll 节点时,父节点的 children 非空。例如:
GET /src/abc和GET /src/*filename,或者GET /src/:id和GET /src/*filename。 - 在插入 static 节点时,父节点的 wildChild 字段被设置为 true。
- 在插入 static 节点时,父节点的 children 非空,且子节点 nType 为 catchAll。
只要发生冲突,都会在初始化的时候 panic。例如,在插入我们臆想的路由 GET /marketplace_listing/plans/ohyes 时,出现第 4 种冲突情况:它的父节点 marketplace_listing/plans/ 的 wildChild 字段为 true。
中间件
本章将对现在流行的 Web 框架中的中间件 (middleware) 技术原理进行分析,并介绍如何使用中间件技术将业务和非业务代码功能进行解耦。
5.3.1 代码泥潭
先来看一段代码:
// middleware/hello.go
package main

func hello(wr http.ResponseWriter, r *http.Request) {
    wr.Write([]byte("hello"))
}

func main() {
    http.HandleFunc("/", hello)
    err := http.ListenAndServe(":8080", nil)
    ...
}
这是一个典型的 Web 服务,挂载了一个简单的路由。我们的线上服务一般也是从这样简单的服务开始逐渐拓展开去的。
现在突然来了一个新的需求,我们想要统计之前写的 hello 服务的处理耗时,需求很简单,我们对上面的程序进行少量修改:
// middleware/hello_with_time_elapse.go
var logger = log.New(os.Stdout, "", 0)

func hello(wr http.ResponseWriter, r *http.Request) {
    timeStart := time.Now()
    wr.Write([]byte("hello"))
    timeElapsed := time.Since(timeStart)
    logger.Println(timeElapsed)
}
这样便可以在每次接收到 http 请求时,打印出当前请求所消耗的时间。
完成了这个需求之后,我们继续进行业务开发,提供的 API 逐渐增加,现在我们的路由看起来是这个样子:
// middleware/hello_with_more_routes.go
// 省略了一些相同的代码
package main

func helloHandler(wr http.ResponseWriter, r *http.Request) {
    // ...
}

func showInfoHandler(wr http.ResponseWriter, r *http.Request) {
    // ...
}

func showEmailHandler(wr http.ResponseWriter, r *http.Request) {
    // ...
}

func showFriendsHandler(wr http.ResponseWriter, r *http.Request) {
    timeStart := time.Now()
    wr.Write([]byte("your friends is tom and alex"))
    timeElapsed := time.Since(timeStart)
    logger.Println(timeElapsed)
}

func main() {
    http.HandleFunc("/", helloHandler)
    http.HandleFunc("/info/show", showInfoHandler)
    http.HandleFunc("/email/show", showEmailHandler)
    http.HandleFunc("/friends/show", showFriendsHandler)
    // ...
}
每一个 handler 里都有之前提到的记录运行时间的代码,每次增加新的路由我们也同样需要把这些看起来长得差不多的代码拷贝到我们需要的地方去。因为代码不太多,所以实施起来也没有遇到什么大问题。
渐渐的我们的系统增加到了 30 个路由和 handler 函数,每次增加新的 handler,我们的第一件工作就是把之前写的所有和业务逻辑无关的周边代码先拷贝过来。
接下来系统安稳地运行了一段时间,突然有一天,老板找到你,我们最近找人新开发了监控系统,为了系统运行可以更加可控,需要把每个接口运行的耗时数据主动上报到我们的监控系统里。给监控系统起个名字吧,叫 metrics。现在你需要修改代码并把耗时通过 HTTP Post 的方式发给 metrics 系统了。我们来修改一下 helloHandler():
func helloHandler(wr http.ResponseWriter, r *http.Request) {
    timeStart := time.Now()
    wr.Write([]byte("hello"))
    timeElapsed := time.Since(timeStart)
    logger.Println(timeElapsed)
    // 新增耗时上报
    metrics.Upload("timeHandler", timeElapsed)
}
修改到这里,本能地发现我们的开发工作开始陷入了泥潭。无论未来对我们的这个 Web 系统有任何其它的非功能或统计需求,我们的修改必然牵一发而动全身。只要增加一个非常简单的非业务统计,我们就需要去几十个 handler 里增加这些业务无关的代码。虽然一开始我们似乎并没有做错,但是显然随着业务的发展,我们的行事方式让我们陷入了代码的泥潭。
5.3.2 使用中间件剥离非业务逻辑
我们来分析一下,一开始在哪里做错了呢?我们只是一步一步地满足需求,把我们需要的逻辑按照流程写下去呀?
我们犯的最大的错误,是把业务代码和非业务代码揉在了一起。对于大多数的场景来讲,非业务的需求都是在 http 请求处理前做一些事情,并且在响应完成之后做一些事情。我们有没有办法使用一些重构思路把这些公共的非业务功能代码剥离出去呢?回到刚开头的例子,我们需要给我们的 helloHandler() 增加超时时间统计,我们可以使用一种叫 function adapter 的方法来对 helloHandler() 进行包装:
func hello(wr http.ResponseWriter, r *http.Request) {
    wr.Write([]byte("hello"))
}

func timeMiddleware(next http.Handler) http.Handler {
    return http.HandlerFunc(func(wr http.ResponseWriter, r *http.Request) {
        timeStart := time.Now()

        // next handler
        next.ServeHTTP(wr, r)

        timeElapsed := time.Since(timeStart)
        logger.Println(timeElapsed)
    })
}

func main() {
    http.Handle("/", timeMiddleware(http.HandlerFunc(hello)))
    err := http.ListenAndServe(":8080", nil)
    ...
}
这样就非常轻松地实现了业务与非业务之间的剥离,魔法就在于这个 timeMiddleware。可以从代码中看到,我们的 timeMiddleware() 也是一个函数,其参数为 http.Handler,http.Handler 的定义在 net/http 包中:
type Handler interface {
    ServeHTTP(ResponseWriter, *Request)
}
任何方法实现了 ServeHTTP,即是一个合法的 http.Handler,读到这里你可能会有一些混乱,我们先来梳理一下 http 库的 Handler,HandlerFunc 和 ServeHTTP 的关系:
type Handler interface {
    ServeHTTP(ResponseWriter, *Request)
}

type HandlerFunc func(ResponseWriter, *Request)

func (f HandlerFunc) ServeHTTP(w ResponseWriter, r *Request) {
    f(w, r)
}
只要你的 handler 函数签名是:
func (ResponseWriter, *Request)那么这个 handler 和 http.HandlerFunc() 就有了一致的函数签名,可以将该 handler() 函数进行类型转换,转为 http.HandlerFunc。而 http.HandlerFunc 实现了 http.Handler 这个接口。在 http 库需要调用你的 handler 函数来处理 http 请求时,会调用 HandlerFunc() 的 ServeHTTP() 函数,可见一个请求的基本调用链是这样的:
h = getHandler() => h.ServeHTTP(w, r) => h(w, r)上面提到的把自定义 handler 转换为 http.HandlerFunc() 这个过程是必须的,因为我们的 handler 没有直接实现 ServeHTTP 这个接口。上面的代码中我们看到的 HandleFunc(注意 HandlerFunc 和 HandleFunc 的区别) 里也可以看到这个强制转换过程:
func HandleFunc(pattern string, handler func(ResponseWriter, *Request)) {
    DefaultServeMux.HandleFunc(pattern, handler)
}

// 调用

func (mux *ServeMux) HandleFunc(pattern string, handler func(ResponseWriter, *Request)) {
    mux.Handle(pattern, HandlerFunc(handler))
}
知道 handler 是怎么一回事,我们的中间件通过包装 handler,再返回一个新的 handler 就好理解了。
总结一下,我们的中间件要做的事情就是通过一个或多个函数对 handler 进行包装,返回一个包括了各个中间件逻辑的函数链。我们把上面的包装再做得复杂一些:
customizedHandler = logger(timeout(ratelimit(helloHandler)))这个函数链在执行过程中的上下文可以用 图 5-8 来表示。
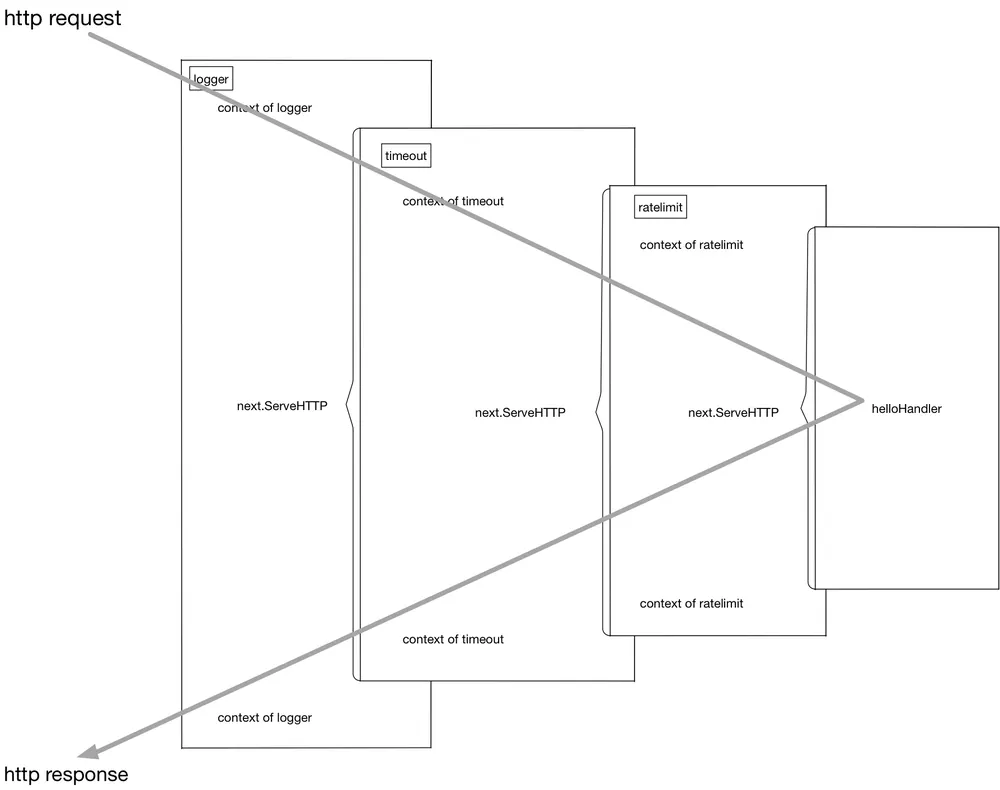
图 5-8 请求处理过程
再直白一些,这个流程在进行请求处理的时候就是不断地进行函数压栈再出栈,有一些类似于递归的执行流:
[exec of logger logic]           函数栈: []

[exec of timeout logic]          函数栈: [logger]

[exec of ratelimit logic]        函数栈: [timeout/logger]

[exec of helloHandler logic]     函数栈: [ratelimit/timeout/logger]

[exec of ratelimit logic part2]  函数栈: [timeout/logger]

[exec of timeout logic part2]    函数栈: [logger]

[exec of logger logic part2]     函数栈: []
功能实现了,但在上面的使用过程中我们也看到了,这种函数套函数的用法不是很美观,同时也不具备什么可读性。
5.3.3 更优雅的中间件写法
上一节中解决了业务功能代码和非业务功能代码的解耦,但也提到了,看起来并不美观,如果需要修改这些函数的顺序,或者增删中间件还是有点费劲,本节我们来进行一些 “写法” 上的优化。
看一个例子:
r = NewRouter()
r.Use(logger)
r.Use(timeout)
r.Use(ratelimit)
r.Add("/", helloHandler)
通过多步设置,我们拥有了和上一节差不多的执行函数链。胜在直观易懂,如果我们要增加或者删除中间件,只要简单地增加删除对应的 Use() 调用就可以了。非常方便。
从框架的角度来讲,怎么实现这样的功能呢?也不复杂:
type middleware func(http.Handler) http.Handler

type Router struct {
    middlewareChain [] middleware
    mux map[string] http.Handler
}

func NewRouter() *Router {
    return &Router{
        mux: make(map[string]http.Handler),
    }
}

func (r *Router) Use(m middleware) {
    r.middlewareChain = append(r.middlewareChain, m)
}

func (r *Router) Add(route string, h http.Handler) {
    var mergedHandler = h

    for i := len(r.middlewareChain) - 1; i >= 0; i-- {
        mergedHandler = r.middlewareChain[i](mergedHandler)
    }

    r.mux[route] = mergedHandler
}
注意代码中的 middleware 数组遍历顺序,和用户希望的调用顺序应该是 "相反" 的。应该不难理解。
5.3.4 哪些事情适合在中间件中做
以较流行的开源 Go 语言框架 chi 为例:
compress.go
  => 对 http 的响应体进行压缩处理
heartbeat.go
  => 设置一个特殊的路由,例如 / ping,/healthcheck,用来给负载均衡一类的前置服务进行探活
logger.go
  => 打印请求处理处理日志,例如请求处理时间,请求路由
profiler.go
  => 挂载 pprof 需要的路由,如 `/pprof`、`/pprof/trace` 到系统中
realip.go
  => 从请求头中读取 X-Forwarded-For 和 X-Real-IP,将 http.Request 中的 RemoteAddr 修改为得到的 RealIP
requestid.go
  => 为本次请求生成单独的 requestid,可一路透传,用来生成分布式调用链路,也可用于在日志中串连单次请求的所有逻辑
timeout.go
  => 用 context.Timeout 设置超时时间,并将其通过 http.Request 一路透传下去
throttler.go
  => 通过定长大小的 channel 存储 token,并通过这些 token 对接口进行限流
每一个 Web 框架都会有对应的中间件组件,如果你有兴趣,也可以向这些项目贡献有用的中间件,只要合理一般项目的维护人也愿意合并你的 Pull Request。
比如开源界很火的 gin 这个框架,就专门为用户贡献的中间件开了一个仓库,见图 5-9:
图 5-9 gin 的中间件仓库
如果读者去阅读 gin 的源码的话,可能会发现 gin 的中间件中处理的并不是 http.Handler,而是一个叫 gin.HandlerFunc 的函数类型,和本节中讲解的 http.Handler 签名并不一样。不过 gin 的 handler 也只是针对其框架的一种封装,中间件的原理与本节中的说明是一致的。
请求校验
社区里曾经有人用 图 5-10 来嘲笑 PHP:
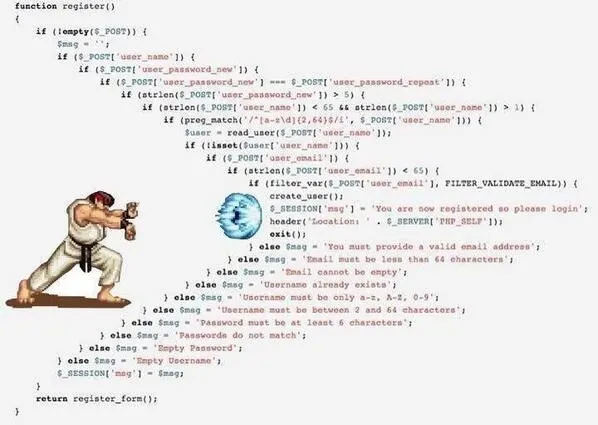
图 5-10 validator 流程
这其实是一个语言无关的场景,需要进行字段校验的情况有很多,Web 系统的 Form 或 JSON 提交只是一个典型的例子。我们用 Go 来写一个类似上图的校验示例。然后研究怎么一步步对其进行改进。
5.4.1 重构请求校验函数
假设我们的数据已经通过某个开源绑定库绑定到了具体的结构体上。
type RegisterReq struct {
    Username       string   `json:"username"`
    PasswordNew    string   `json:"password_new"`
    PasswordRepeat string   `json:"password_repeat"`
    Email          string   `json:"email"`
}

func register(req RegisterReq) error{
    if len(req.Username) > 0 {
        if len(req.PasswordNew) > 0 && len(req.PasswordRepeat) > 0 {
            if req.PasswordNew == req.PasswordRepeat {
                if emailFormatValid(req.Email) {
                    createUser()
                    return nil
                } else {
                    return errors.New("invalid email")
                }
            } else {
                return errors.New("password and reinput must be the same")
            }
        } else {
            return errors.New("password and password reinput must be longer than 0")
        }
    } else {
        return errors.New("length of username cannot be 0")
    }
}
我们用 Go 里成功写出了波动拳开路的箭头型代码。。这种代码一般怎么进行优化呢?
很简单,在《重构》一书中已经给出了方案:Guard Clauses。
func register(req RegisterReq) error{
    if len(req.Username) == 0 {
        return errors.New("length of username cannot be 0")
    }

    if len(req.PasswordNew) == 0 || len(req.PasswordRepeat) == 0 {
        return errors.New("password and password reinput must be longer than 0")
    }

    if req.PasswordNew != req.PasswordRepeat {
        return errors.New("password and reinput must be the same")
    }

    if emailFormatValid(req.Email) {
        return errors.New("invalid email")
    }

    createUser()
    return nil
}
代码更清爽,看起来也不那么别扭了。这是比较通用的重构理念。虽然使用了重构方法使我们的校验过程代码看起来优雅了,但我们还是得为每一个 http 请求都去写这么一套差不多的 validate() 函数,有没有更好的办法来帮助我们解除这项体力劳动?答案就是 validator。
5.4.2 用 validator 解放体力劳动
从设计的角度讲,我们一定会为每个请求都声明一个结构体。前文中提到的校验场景我们都可以通过 validator 完成工作。还以前文中的结构体为例。为了美观起见,我们先把 json tag 省略掉。
这里我们引入一个新的 validator 库:
使用 go get github.com/go-playground/validator/v10 可以下载 validator 库。
import "github.com/go-playground/validator/v10"

type RegisterReq struct {
    // 字符串的 gt=0 表示长度必须 > 0,gt = greater than
    Username       string   `validate:"gt=0"`
    // 同上
    PasswordNew    string   `validate:"gt=0"`
    // eqfield 跨字段相等校验
    PasswordRepeat string   `validate:"eqfield=PasswordNew"`
    // 合法 email 格式校验
    Email          string   `validate:"email"`
}

var validate = validator.New()

func validateFunc(req RegisterReq) error {
    err := validate.Struct(req)
    if err != nil {
        doSomething()
        return err
    }
    ...
}
这样就不需要在每个请求进入业务逻辑之前都写重复的 validate() 函数了。本例中只列出了这个校验器非常简单的几个功能。
我们试着跑一下这个程序,输入参数设置为:
//...

var req = RegisterReq {
    Username       : "Xargin",
    PasswordNew    : "ohno",
    PasswordRepeat : "ohn",
    Email          : "alex@abc.com",
}

err := validateFunc(req)
fmt.Println(err)

// Key: 'RegisterReq.PasswordRepeat' Error:Field validation for
// 'PasswordRepeat' failed on the 'eqfield' tag
如果觉得这个 validator 提供的错误信息不够人性化,例如要把错误信息返回给用户,那就不应该直接显示英文了。可以针对每种 tag 进行错误信息定制,读者可以自行探索。
5.4.3 原理
从结构上来看,每一个结构体都可以看成是一棵树。假如我们有如下定义的结构体:
type Nested struct {
    Email string `validate:"email"`
}
type T struct {
    Age int `validate:"eq=10"`
    Nested Nested
}
把这个结构体画成一棵树,见 图 5-11:
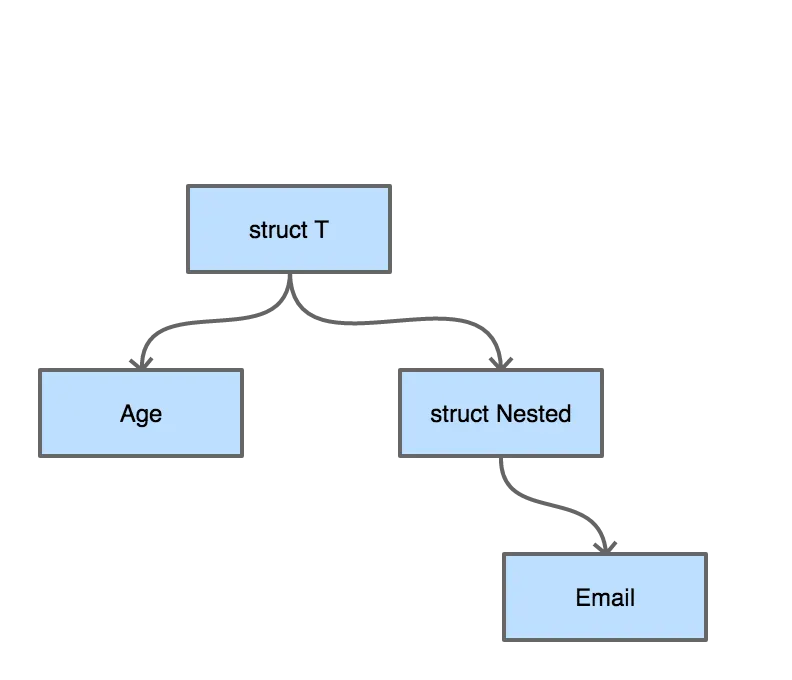
图 5-11 validator 树
从字段校验的需求来讲,无论我们采用深度优先搜索还是广度优先搜索来对这棵结构体树来进行遍历,都是可以的。
我们来写一个递归的深度优先搜索方式的遍历示例:
package main

import (
    "fmt"
    "reflect"
    "regexp"
    "strconv"
    "strings"
)

type Nested struct {
    Email string `validate:"email"`
}
type T struct {
    Age int `validate:"eq=10"`
    Nested Nested
}

func validateEmail(input string) bool {
    if pass, _ := regexp.MatchString(
        `^([\w\.\_]{2,10})@(\w{1,}).([a-z]{2,4})$`, input,
    ); pass {
        return true
    }
    return false
}

func validate(v interface{}) (bool, string) {
    validateResult := true
    errmsg := "success"
    vt := reflect.TypeOf(v)
    vv := reflect.ValueOf(v)
    for i := 0; i <vv.NumField(); i++ {
        fieldVal := vv.Field(i)
        tagContent := vt.Field(i).Tag.Get("validate")
        k := fieldVal.Kind()

        switch k {
        case reflect.Int:
            val := fieldVal.Int()
            tagValStr := strings.Split(tagContent, "=")
            tagVal, _ := strconv.ParseInt(tagValStr[1], 10, 64)
            if val != tagVal {
                errmsg = "validate int failed, tag is:"+ strconv.FormatInt(
                    tagVal, 10,
                )
                validateResult = false
            }
        case reflect.String:
            val := fieldVal.String()
            tagValStr := tagContent
            switch tagValStr {
            case "email":
                nestedResult := validateEmail(val)
                if nestedResult == false {
                    errmsg = "validate mail failed, field val is:"+ val
                    validateResult = false
                }
            }
        case reflect.Struct:
            // 如果有内嵌的 struct,那么深度优先遍历
            // 就是一个递归过程
            valInter := fieldVal.Interface()
            nestedResult, msg := validate(valInter)
            if nestedResult == false {
                validateResult = false
                errmsg = msg
            }
        }
    }
    return validateResult, errmsg
}

func main() {
    var a = T{Age: 10, Nested: Nested{Email: "abc@abc.com"}}

    validateResult, errmsg := validate(a)
    fmt.Println(validateResult, errmsg)
}
这里我们简单地对 eq=x 和 email 这两个 tag 进行了支持,读者可以对这个程序进行简单的修改以查看具体的 validate 效果。为了演示精简掉了错误处理和复杂情况的处理,例如 reflect.Int8/16/32/64,reflect.Ptr 等类型的处理,如果给生产环境编写校验库的话,请务必做好功能的完善和容错。
在前一小节中介绍的开源校验组件在功能上要远比我们这里的例子复杂的多。但原理很简单,就是用反射对结构体进行树形遍历。有心的读者这时候可能会产生一个问题,我们对结构体进行校验时大量使用了反射,而 Go 的反射在性能上不太出众,有时甚至会影响到我们程序的性能。这样的考虑确实有一些道理,但需要对结构体进行大量校验的场景往往出现在 Web 服务,这里并不一定是程序的性能瓶颈所在,实际的效果还是要从 pprof 中做更精确的判断。
如果基于反射的校验真的成为了你服务的性能瓶颈怎么办?现在也有一种思路可以避免反射:使用 Go 内置的 Parser 对源代码进行扫描,然后根据结构体的定义生成校验代码。我们可以将所有需要校验的结构体放在单独的包内。这就交给读者自己去探索了。
和数据库打交道
本节将对 db/sql 官方标准库作一些简单分析,并介绍一些应用比较广泛的开源 ORM 和 SQL Builder。并从企业级应用开发和公司架构的角度来分析哪种技术栈对于现代的企业级应用更为合适。
5.5.1 从 database/sql 讲起
Go 官方提供了 database/sql 包来给用户进行和数据库打交道的工作,database/sql 库实际只提供了一套操作数据库的接口和规范,例如抽象好的 SQL 预处理(prepare),连接池管理,数据绑定,事务,错误处理等等。官方并没有提供具体某种数据库实现的协议支持。
和具体的数据库,例如 MySQL 打交道,还需要再引入 MySQL 的驱动,像下面这样:
import "database/sql"
import _ "github.com/go-sql-driver/mysql"

db, err := sql.Open("mysql", "user:password@/dbname")
import _ "github.com/go-sql-driver/mysql"这条 import 语句会调用了 mysql 包的 init 函数,做的事情也很简单:
func init() {
    sql.Register("mysql", &MySQLDriver{})
}
在 sql 包的全局 map 里把 mysql 这个名字的 driver 注册上。Driver 在 sql 包中是一个接口:
type Driver interface {
    Open(name string) (Conn, error)
}
调用 sql.Open() 返回的 db 对象就是这里的 Conn。
type Conn interface {
    Prepare(query string) (Stmt, error)
    Close() error
    Begin() (Tx, error)
}
也是一个接口。如果你仔细地查看 database/sql/driver/driver.go 的代码会发现,这个文件里所有的成员全都是接口,对这些类型进行操作,还是会调用具体的 driver 里的方法。
从用户的角度来讲,在使用 database/sql 包的过程中,你能够使用的也就是这些接口里提供的函数。来看一个使用 database/sql 和 go-sql-driver/mysql 的完整的例子:
package main

import (
    "database/sql"
    _ "github.com/go-sql-driver/mysql"
)

func main() {
    // db 是一个 sql.DB 类型的对象
    // 该对象线程安全,且内部已包含了一个连接池
    // 连接池的选项可以在 sql.DB 的方法中设置,这里为了简单省略了
    db, err := sql.Open("mysql",
        "user:password@tcp(127.0.0.1:3306)/hello")
    if err != nil {
        log.Fatal(err)
    }
    defer db.Close()

    var (
        id int
        name string
    )
    rows, err := db.Query("select id, name from users where id = ?", 1)
    if err != nil {
        log.Fatal(err)
    }

    defer rows.Close()

    // 必须要把 rows 里的内容读完,或者显式调用 Close() 方法,
    // 否则在 defer 的 rows.Close() 执行之前,连接永远不会释放
    for rows.Next() {
        err := rows.Scan(&id, &name)
        if err != nil {
            log.Fatal(err)
        }
        log.Println(id, name)
    }

    err = rows.Err()
    if err != nil {
        log.Fatal(err)
    }
}
如果读者想了解官方这个 database/sql 库更加详细的用法的话,可以参考 http://go-database-sql.org/。
包括该库的功能介绍、用法、注意事项和反直觉的一些实现方式(例如同一个 goroutine 内对 sql.DB 的查询,可能在多个连接上)都有涉及,本章中不再赘述。
聪明如你的话,在上面这段简短的程序中可能已经嗅出了一些不好的味道。官方的 db 库提供的功能这么简单,我们每次去数据库里读取内容岂不是都要去写这么一套差不多的代码?或者如果我们的对象是结构体,把 sql.Rows 绑定到对象的工作就会变得更加得重复而无聊。
是的,所以社区才会有各种各样的 SQL Builder 和 ORM 百花齐放。
5.5.2 提高生产效率的 ORM 和 SQL Builder
在 Web 开发领域常常提到的 ORM 是什么?我们先看看万能的维基百科:
对象关系映射(英语:Object Relational Mapping,简称 ORM,或 O/RM,或 O/R mapping),是一种程序设计技术,用于实现面向对象编程语言里不同类型系统的数据之间的转换。
从效果上说,它其实是创建了一个可在编程语言里使用的 “虚拟对象数据库”。
最为常见的 ORM 做的是从 db 到程序的类或结构体这样的映射。所以你手边的程序可能是从 MySQL 的表映射你的程序内的类。我们可以先来看看其它的程序语言里的 ORM 写起来是怎么样的感觉:
>>> from blog.models import Blog
>>> b = Blog(name='Beatles Blog', tagline='All the latest Beatles news.')
>>> b.save()
完全没有数据库的痕迹,没错,ORM 的目的就是屏蔽掉 DB 层,很多语言的 ORM 只要把你的类或结构体定义好,再用特定的语法将结构体之间的一对一或者一对多关系表达出来。那么任务就完成了。然后你就可以对这些映射好了数据库表的对象进行各种操作,例如 save、create、retrieve、delete。至于 ORM 在背地里做了什么阴险的勾当,你是不一定清楚的。使用 ORM 的时候,我们往往比较容易有一种忘记了数据库的直观感受。举个例子,我们有个需求:向用户展示最新的商品列表,我们再假设,商品和商家是 1:1 的关联关系,我们就很容易写出像下面这样的代码:
# 伪代码
shopList := []
for product in productList {
    shopList = append(shopList, product.GetShop)
}
当然了,我们不能批判这样写代码的程序员是偷懒的程序员。因为 ORM 一类的工具在出发点上就是屏蔽 sql,让我们对数据库的操作更接近于人类的思维方式。这样很多只接触过 ORM 而且又是刚入行的程序员就很容易写出上面这样的代码。
这样的代码将对数据库的读请求放大了 N 倍。也就是说,如果你的商品列表有 15 个 SKU,那么每次用户打开这个页面,至少需要执行 1(查询商品列表)+ 15(查询相关的商铺信息)次查询。这里 N 是 16。如果你的列表页很大,比如说有 600 个条目,那么你就至少要执行 1+600 次查询。如果说你的数据库能够承受的最大的简单查询是 12 万 QPS,而上述这样的查询正好是你最常用的查询的话,你能对外提供的服务能力是多少呢?是 200 qps!互联网系统的忌讳之一,就是这种无端的读放大。
当然,你也可以说这不是 ORM 的问题,如果你手写 sql 你还是可能会写出差不多的程序,那么再来看两个 demo:
o := orm.NewOrm()
num, err := o.QueryTable("cardgroup").Filter("Cards__Card__Name", cardName).All(&cardgroups)
很多 ORM 都提供了这种 Filter 类型的查询方式,不过在某些 ORM 背后可能隐藏了非常难以察觉的细节,比如生成的 SQL 语句会自动 limit 1000。
也许喜欢 ORM 的读者读到这里会反驳了,你是没有认真阅读文档就瞎写。是的,尽管这些 ORM 工具在文档里说明了 All 查询在不显式地指定 Limit 的话会自动 limit 1000,但对于很多没有阅读过文档或者看过 ORM 源码的人,这依然是一个非常难以察觉的 “魔鬼” 细节。喜欢强类型语言的人一般都不喜欢语言隐式地去做什么事情,例如各种语言在赋值操作时进行的隐式类型转换然后又在转换中丢失了精度的勾当,一定让你非常的头疼。所以一个程序库背地里做的事情还是越少越好,如果一定要做,那也一定要在显眼的地方做。比如上面的例子,去掉这种默认的自作聪明的行为,或者要求用户强制传入 limit 参数都是更好的选择。
除了 limit 的问题,我们再看一遍这个下面的查询:
num, err := o.QueryTable("cardgroup").Filter("Cards__Card__Name", cardName).All(&cardgroups)你可以看得出来这个 Filter 是有表 join 的操作么?当然了,有深入使用经验的用户还是会觉得这是在吹毛求疵。但这样的分析想证明的是,ORM 想从设计上隐去太多的细节。而方便的代价是其背后的运行完全失控。这样的项目在经过几任维护人员之后,将变得面目全非,难以维护。
当然,我们不能否认 ORM 的进步意义,它的设计初衷就是为了让数据的操作和存储的具体实现相剥离。但是在上了规模的公司的人们渐渐达成了一个共识,由于隐藏重要的细节,ORM 可能是失败的设计。其所隐藏的重要细节对于上了规模的系统开发来说至关重要。
相比 ORM 来说,SQL Builder 在 SQL 和项目可维护性之间取得了比较好的平衡。首先 sql builder 不像 ORM 那样屏蔽了过多的细节,其次从开发的角度来讲,SQL Builder 进行简单封装后也可以非常高效地完成开发,举个例子:
where := map[string]interface{} {
    "order_id > ?" : 0,
    "customer_id != ?" : 0,
}
limit := []int{0,100}
orderBy := []string{"id asc", "create_time desc"}

orders := orderModel.GetList(where, limit, orderBy)
写 SQL Builder 的相关代码,或者读懂都不费劲。把这些代码脑内转换为 sql 也不会太费劲。所以通过代码就可以对这个查询是否命中数据库索引,是否走了覆盖索引,是否能够用上联合索引进行分析了。
说白了 SQL Builder 是 sql 在代码里的一种特殊方言,如果你们没有 DBA 但研发有自己分析和优化 sql 的能力,或者你们公司的 DBA 对于学习这样一些 sql 的方言没有异议。那么使用 SQL Builder 是一个比较好的选择,不会导致什么问题。
另外在一些本来也不需要 DBA 介入的场景内,使用 SQL Builder 也是可以的,例如你要做一套运维系统,且将 MySQL 当作了系统中的一个组件,系统的 QPS 不高,查询不复杂等等。
一旦你做的是高并发的 OLTP 在线系统,且想在人员充足分工明确的前提下最大程度控制系统的风险,使用 SQL Builder 就不合适了。
5.5.3 脆弱的数据库
无论是 ORM 还是 SQL Builder 都有一个致命的缺点,就是没有办法进行系统上线的事前 sql 审核。虽然很多 ORM 和 SQL Builder 也提供了运行期打印 sql 的功能,但只在查询的时候才能进行输出。而 SQL Builder 和 ORM 本身提供的功能太过灵活。使得你不可能通过测试枚举出所有可能在线上执行的 sql。例如你可能用 SQL Builder 写出下面这样的代码:
where := map[string]interface{} {
    "product_id = ?" : 10,
    "user_id = ?" : 1232 ,
}

if order_id != 0 {
    where["order_id = ?"] = order_id
}

res, err := historyModel.GetList(where, limit, orderBy)
你的系统里有大量类似上述样例的 if 的话,就难以通过测试用例来覆盖到所有可能的 sql 组合了。
这样的系统只要发布,就已经孕育了初期的巨大风险。
对于现在 7 乘 24 服务的互联网公司来说,服务不可用是非常重大的问题。存储层的技术栈虽经历了多年的发展,在整个系统中依然是最为脆弱的一环。系统宕机对于 24 小时对外提供服务的公司来说,意味着直接的经济损失。各种风险不可忽视。
从行业分工的角度来讲,现今的互联网公司都有专职的 DBA。大多数 DBA 并不一定有写代码的能力,去阅读 SQL Builder 的相关 “拼 SQL” 代码多多少少还是会有一点障碍。从 DBA 角度出发,还是希望能够有专门的事前 SQL 审核机制,并能让其低成本地获取到系统的所有 SQL 内容,而不是去阅读业务研发编写的 SQL Builder 的相关代码。
所以现如今,大型的互联网公司核心线上业务都会在代码中把 SQL 放在显眼的位置提供给 DBA 评审,举一个例子:
const (
    getAllByProductIDAndCustomerID = `select * from p_orders where product_id in (:product_id) and customer_id=:customer_id`
)

// GetAllByProductIDAndCustomerID
// @param driver_id
// @param rate_date
// @return []Order, error
func GetAllByProductIDAndCustomerID(ctx context.Context, productIDs []uint64, customerID uint64) ([]Order, error) {
    var orderList []Order

    params := map[string]interface{}{
        "product_id" : productIDs,
        "customer_id": customerID,
    }

    // getAllByProductIDAndCustomerID 是 const 类型的 sql 字符串
    sql, args, err := sqlutil.Named(getAllByProductIDAndCustomerID, params)
    if err != nil {
        return nil, err
    }

    err = dao.QueryList(ctx, sqldbInstance, sql, args, &orderList)
    if err != nil {
        return nil, err
    }

    return orderList, err
}
像这样的代码,在上线之前把 DAO 层的变更集的 const 部分直接拿给 DBA 来进行审核,就比较方便了。代码中的 sqlutil.Named 是类似于 sqlx 中的 Named 函数,同时支持 where 表达式中的比较操作符和 in。
这里为了说明简便,函数写得稍微复杂一些,仔细思考一下的话查询的导出函数还可以进一步进行简化。请读者朋友们自行尝试。
服务流量限制
计算机程序可依据其瓶颈分为磁盘 IO 瓶颈型,CPU 计算瓶颈型,网络带宽瓶颈型,分布式场景下有时候也会外部系统而导致自身瓶颈。
Web 系统打交道最多的是网络,无论是接收,解析用户请求,访问存储,还是把响应数据返回给用户,都是要走网络的。在没有 epoll/kqueue 之类的系统提供的 IO 多路复用接口之前,多个核心的现代计算机最头痛的是 C10k 问题,C10k 问题会导致计算机没有办法充分利用 CPU 来处理更多的用户连接,进而没有办法通过优化程序提升 CPU 利用率来处理更多的请求。
自从 Linux 实现了 epoll,FreeBSD 实现了 kqueue,这个问题基本解决了,我们可以借助内核提供的 API 轻松解决当年的 C10k 问题,也就是说如今如果你的程序主要是和网络打交道,那么瓶颈一定在用户程序而不在操作系统内核。
随着时代的发展,编程语言对这些系统调用又进一步进行了封装,如今做应用层开发,几乎不会在程序中看到 epoll 之类的字眼,大多数时候我们就只要聚焦在业务逻辑上就好。Go 的 net 库针对不同平台封装了不同的 syscall API,http 库又是构建在 net 库之上,所以在 Go 语言中我们可以借助标准库,很轻松地写出高性能的 http 服务,下面是一个简单的 hello world 服务的代码:
package main

import (
    "io"
    "log"
    "net/http"
)

func sayhello(wr http.ResponseWriter, r *http.Request) {
    wr.WriteHeader(200)
    io.WriteString(wr, "hello world")
}

func main() {
    http.HandleFunc("/", sayhello)
    err := http.ListenAndServe(":9090", nil)
    if err != nil {
        log.Fatal("ListenAndServe:", err)
    }
}
我们需要衡量一下这个 Web 服务的吞吐量,再具体一些,就是接口的 QPS。借助 wrk,在家用电脑 Macbook Pro 上对这个 hello world 服务进行基准测试,Mac 的硬件情况如下:
CPU: Intel(R) Core(TM) i5-5257U CPU @ 2.70GHz
Core: 2
Threads: 4

Graphics/Displays:
      Chipset Model: Intel Iris Graphics 6100
          Resolution: 2560 x 1600 Retina
    Memory Slots:
          Size: 4 GB
          Speed: 1867 MHz
          Size: 4 GB
          Speed: 1867 MHz
Storage:
          Size: 250.14 GB (250,140,319,744 bytes)
          Media Name: APPLE SSD SM0256G Media
          Size: 250.14 GB (250,140,319,744 bytes)
          Medium Type: SSD
测试结果:
~ ❯❯❯ wrk -c 10 -d 10s -t10 http://localhost:9090
Running 10s test @ http://localhost:9090
  10 threads and 10 connections
  Thread Stats   Avg      Stdev  Max   +/- Stdev
    Latency   339.99us  1.28ms  44.43ms   98.29%
    Req/Sec  4.49k   656.81  7.47k  73.36%
  449588 requests in 10.10s, 54.88MB read
Requests/sec:  44513.22
Transfer/sec:      5.43MB

~ ❯❯❯ wrk -c 10 -d 10s -t10 http://localhost:9090
Running 10s test @ http://localhost:9090
  10 threads and 10 connections
  Thread Stats   Avg      Stdev  Max   +/- Stdev
    Latency   334.76us  1.21ms  45.47ms   98.27%
    Req/Sec  4.42k   633.62  6.90k  71.16%
  443582 requests in 10.10s, 54.15MB read
Requests/sec:  43911.68
Transfer/sec:      5.36MB

~ ❯❯❯ wrk -c 10 -d 10s -t10 http://localhost:9090
Running 10s test @ http://localhost:9090
  10 threads and 10 connections
  Thread Stats   Avg      Stdev  Max   +/- Stdev
    Latency   379.26us  1.34ms  44.28ms   97.62%
    Req/Sec  4.55k   591.64  8.20k  76.37%
  455710 requests in 10.10s, 55.63MB read
Requests/sec:  45118.57
Transfer/sec:      5.51MB
多次测试的结果在 4 万左右的 QPS 浮动,响应时间最多也就是 40ms 左右,对于一个 Web 程序来说,这已经是很不错的成绩了,我们只是照抄了别人的示例代码,就完成了一个高性能的 hello world 服务器,是不是很有成就感?
这还只是家用 PC,线上服务器大多都是 24 核心起,32G 内存 +,CPU 基本都是 Intel i7。所以同样的程序在服务器上运行会得到更好的结果。
这里的 hello world 服务没有任何业务逻辑。真实环境的程序要复杂得多,有些程序偏网络 IO 瓶颈,例如一些 CDN 服务、Proxy 服务;有些程序偏 CPU/GPU 瓶颈,例如登陆校验服务、图像处理服务;有些程序瓶颈偏磁盘,例如专门的存储系统,数据库。不同的程序瓶颈会体现在不同的地方,这里提到的这些功能单一的服务相对来说还算容易分析。如果碰到业务逻辑复杂代码量巨大的模块,其瓶颈并不是三下五除二可以推测出来的,还是需要从压力测试中得到更为精确的结论。
对于 IO/Network 瓶颈类的程序,其表现是网卡 / 磁盘 IO 会先于 CPU 打满,这种情况即使优化 CPU 的使用也不能提高整个系统的吞吐量,只能提高磁盘的读写速度,增加内存大小,提升网卡的带宽来提升整体性能。而 CPU 瓶颈类的程序,则是在存储和网卡未打满之前 CPU 占用率先到达 100%,CPU 忙于各种计算任务,IO 设备相对则较闲。
无论哪种类型的服务,在资源使用到极限的时候都会导致请求堆积,超时,系统 hang 死,最终伤害到终端用户。对于分布式的 Web 服务来说,瓶颈还不一定总在系统内部,也有可能在外部。非计算密集型的系统往往会在关系型数据库环节失守,而这时候 Web 模块本身还远远未达到瓶颈。
不管我们的服务瓶颈在哪里,最终要做的事情都是一样的,那就是流量限制。
5.6.1 常见的流量限制手段
流量限制的手段有很多,最常见的:漏桶、令牌桶两种:
- 漏桶是指我们有一个一直装满了水的桶,每过固定的一段时间即向外漏一滴水。如果你接到了这滴水,那么你就可以继续服务请求,如果没有接到,那么就需要等待下一滴水。
- 令牌桶则是指匀速向桶中添加令牌,服务请求时需要从桶中获取令牌,令牌的数目可以按照需要消耗的资源进行相应的调整。如果没有令牌,可以选择等待,或者放弃。
这两种方法看起来很像,不过还是有区别的。漏桶流出的速率固定,而令牌桶只要在桶中有令牌,那就可以拿。也就是说令牌桶是允许一定程度的并发的,比如同一个时刻,有 100 个用户请求,只要令牌桶中有 100 个令牌,那么这 100 个请求全都会放过去。令牌桶在桶中没有令牌的情况下也会退化为漏桶模型。
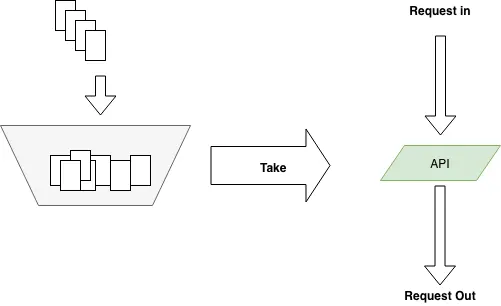
图 5-12 令牌桶
实际应用中令牌桶应用较为广泛,开源界流行的限流器大多数都是基于令牌桶思想的。并且在此基础上进行了一定程度的扩充,比如 github.com/juju/ratelimit 提供了几种不同特色的令牌桶填充方式:
func NewBucket(fillInterval time.Duration, capacity int64) *Bucket默认的令牌桶,fillInterval 指每过多长时间向桶里放一个令牌,capacity 是桶的容量,超过桶容量的部分会被直接丢弃。桶初始是满的。
func NewBucketWithQuantum(fillInterval time.Duration, capacity, quantum int64) *Bucket和普通的 NewBucket() 的区别是,每次向桶中放令牌时,是放 quantum 个令牌,而不是一个令牌。
func NewBucketWithRate(rate float64, capacity int64) *Bucket这个就有点特殊了,会按照提供的比例,每秒钟填充令牌数。例如 capacity 是 100,而 rate 是 0.1,那么每秒会填充 10 个令牌。
从桶中获取令牌也提供了几个 API:
func (tb *Bucket) Take(count int64) time.Duration {}
func (tb *Bucket) TakeAvailable(count int64) int64 {}
func (tb *Bucket) TakeMaxDuration(count int64, maxWait time.Duration) (
    time.Duration, bool,
) {}
func (tb *Bucket) Wait(count int64) {}
func (tb *Bucket) WaitMaxDuration(count int64, maxWait time.Duration) bool {}
名称和功能都比较直观,这里就不再赘述了。相比于开源界更为有名的 Google 的 Java 工具库 Guava 中提供的 ratelimiter,这个库不支持令牌桶预热,且无法修改初始的令牌容量,所以可能个别极端情况下的需求无法满足。但在明白令牌桶的基本原理之后,如果没办法满足需求,相信你也可以很快对其进行修改并支持自己的业务场景。
5.6.2 原理
从功能上来看,令牌桶模型就是对全局计数的加减法操作过程,但使用计数需要我们自己加读写锁,有小小的思想负担。如果我们对 Go 语言已经比较熟悉的话,很容易想到可以用 buffered channel 来完成简单的加令牌取令牌操作:
var tokenBucket = make(chan struct{}, capacity)每过一段时间向 tokenBucket 中添加 token,如果 bucket 已经满了,那么直接放弃:
fillToken := func() {
    ticker := time.NewTicker(fillInterval)
    for {
        select {
        case <-ticker.C:
            select {
            case tokenBucket <- struct{}{}:
            default:
            }
            fmt.Println("current token cnt:", len(tokenBucket), time.Now())
        }
    }
}
把代码组合起来:
package main

import (
    "fmt"
    "time"
)

func main() {
    var fillInterval = time.Millisecond * 10
    var capacity = 100
    var tokenBucket = make(chan struct{}, capacity)

    fillToken := func() {
        ticker := time.NewTicker(fillInterval)
        for {
            select {
            case <-ticker.C:
                select {
                case tokenBucket <- struct{}{}:
                default:
                }
                fmt.Println("current token cnt:", len(tokenBucket), time.Now())
            }
        }
    }

    go fillToken()
    time.Sleep(time.Hour)
}
看看运行结果:
current token cnt: 98 2018-06-16 18:17:50.234556981 +0800 CST m=+0.981524018
current token cnt: 99 2018-06-16 18:17:50.243575354 +0800 CST m=+0.990542391
current token cnt: 100 2018-06-16 18:17:50.254628067 +0800 CST m=+1.001595104
current token cnt: 100 2018-06-16 18:17:50.264537143 +0800 CST m=+1.011504180
current token cnt: 100 2018-06-16 18:17:50.273613018 +0800 CST m=+1.020580055
current token cnt: 100 2018-06-16 18:17:50.2844406 +0800 CST m=+1.031407637
current token cnt: 100 2018-06-16 18:17:50.294528695 +0800 CST m=+1.041495732
current token cnt: 100 2018-06-16 18:17:50.304550145 +0800 CST m=+1.051517182
current token cnt: 100 2018-06-16 18:17:50.313970334 +0800 CST m=+1.060937371
在 1s 钟的时候刚好填满 100 个,没有太大的偏差。不过这里可以看到,Go 的定时器存在大约 0.001s 的误差,所以如果令牌桶大小在 1000 以上的填充可能会有一定的误差。对于一般的服务来说,这一点误差无关紧要。
上面的令牌桶的取令牌操作实现起来也比较简单,简化问题,我们这里只取一个令牌:
func TakeAvailable(block bool) bool{
    var takenResult bool
    if block {
        select {
        case <-tokenBucket:
            takenResult = true
        }
    } else {
        select {
        case <-tokenBucket:
            takenResult = true
        default:
            takenResult = false
        }
    }

    return takenResult
}
一些公司自己造的限流的轮子就是用上面这种方式来实现的,不过如果开源版 ratelimit 也如此的话,那我们也没什么可说的了。现实并不是这样的。
我们来思考一下,令牌桶每隔一段固定的时间向桶中放令牌,如果我们记下上一次放令牌的时间为 t1,和当时的令牌数 k1,放令牌的时间间隔为 ti,每次向令牌桶中放 x 个令牌,令牌桶容量为 cap。现在如果有人来调用 TakeAvailable 来取 n 个令牌,我们将这个时刻记为 t2。在 t2 时刻,令牌桶中理论上应该有多少令牌呢?伪代码如下:
cur = k1 + ((t2 - t1)/ti) * x
cur = cur > cap ? cap : cur
我们用两个时间点的时间差,再结合其它的参数,理论上在取令牌之前就完全可以知道桶里有多少令牌了。那劳心费力地像本小节前面向 channel 里填充 token 的操作,理论上是没有必要的。只要在每次 Take 的时候,再对令牌桶中的 token 数进行简单计算,就可以得到正确的令牌数。是不是很像 惰性求值 的感觉?
在得到正确的令牌数之后,再进行实际的 Take 操作就好,这个 Take 操作只需要对令牌数进行简单的减法即可,记得加锁以保证并发安全。github.com/juju/ratelimit 这个库就是这样做的。
5.6.3 服务瓶颈和 QoS
前面我们说了很多 CPU 瓶颈、IO 瓶颈之类的概念,这种性能瓶颈从大多数公司都有的监控系统中可以比较快速地定位出来,如果一个系统遇到了性能问题,那监控图的反应一般都是最快的。
虽然性能指标很重要,但对用户提供服务时还应考虑服务整体的 QoS。QoS 全称是 Quality of Service,顾名思义是服务质量。QoS 包含有可用性、吞吐量、时延、时延变化和丢失等指标。一般来讲我们可以通过优化系统,来提高 Web 服务的 CPU 利用率,从而提高整个系统的吞吐量。但吞吐量提高的同时,用户体验是有可能变差的。用户角度比较敏感的除了可用性之外,还有时延。虽然你的系统吞吐量高,但半天刷不开页面,想必会造成大量的用户流失。所以在大公司的 Web 服务性能指标中,除了平均响应时延之外,还会把响应时间的 95 分位,99 分位也拿出来作为性能标准。平均响应在提高 CPU 利用率没受到太大影响时,可能 95 分位、99 分位的响应时间大幅度攀升了,那么这时候就要考虑提高这些 CPU 利用率所付出的代价是否值得了。
在线系统的机器一般都会保持 CPU 有一定的余裕。
大型Web项目分层
流行的 Web 框架大多数是 MVC 框架,MVC 这个概念最早由 Trygve Reenskaug 在 1978 年提出,为了能够对 GUI 类型的应用进行方便扩展,将程序划分为:
- 控制器(Controller)- 负责转发请求,对请求进行处理。
- 视图(View) - 界面设计人员进行图形界面设计。
- 模型(Model) - 程序员编写程序应有的功能(实现算法等等)、数据库专家进行数据管理和数据库设计(可以实现具体的功能)。
随着时代的发展,前端也变成了越来越复杂的工程,为了更好地工程化,现在更为流行的一般是前后分离的架构。可以认为前后分离是把 V 层从 MVC 中抽离单独成为项目。这样一个后端项目一般就只剩下 M 和 C 层了。前后端之间通过 ajax 来交互,有时候要解决跨域的问题,但也已经有了较为成熟的方案。图 5-13 是一个前后分离的系统的简易交互图。
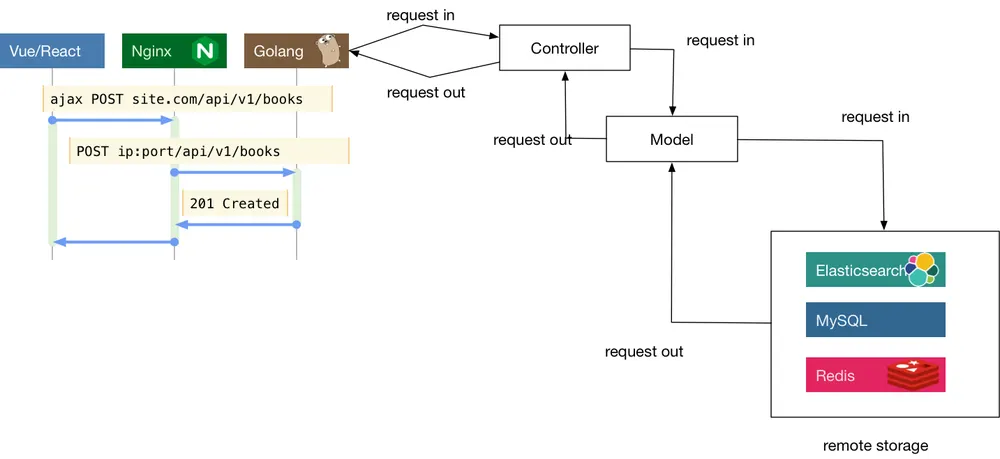
图 5-13 前后分离交互图
图里的 Vue 和 React 是现在前端界比较流行的两个框架,因为我们的重点不在这里,所以前端项目内的组织我们就不强调了。事实上,即使是简单的项目,业界也并没有完全遵守 MVC 框架提出者对于 M 和 C 所定义的分工。有很多公司的项目会在 Controller 层塞入大量的逻辑,在 Model 层就只管理数据的存储。这往往来源于对于 model 层字面含义的某种擅自引申理解。认为字面意思,这一层就是处理某种建模,而模型是什么?就是数据呗!
这种理解显然是有问题的,业务流程也算是一种 “模型”,是对真实世界用户行为或者既有流程的一种建模,并非只有按格式组织的数据才能叫模型。不过按照 MVC 的创始人的想法,我们如果把和数据打交道的代码还有业务流程全部塞进 MVC 里的 M 层的话,这个 M 层又会显得有些过于臃肿。对于复杂的项目,一个 C 和一个 M 层显然是不够用的,现在比较流行的纯后端 API 模块一般采用下述划分方法:
- Controller,与上述类似,服务入口,负责处理路由,参数校验,请求转发。
- Logic/Service,逻辑(服务)层,一般是业务逻辑的入口,可以认为从这里开始,所有的请求参数一定是合法的。业务逻辑和业务流程也都在这一层中。常见的设计中会将该层称为 Business Rules。
- DAO/Repository,这一层主要负责和数据、存储打交道。将下层存储以更简单的函数、接口形式暴露给 Logic 层来使用。负责数据的持久化工作。
每一层都会做好自己的工作,然后用请求当前的上下文构造下一层工作所需要的结构体或其它类型参数,然后调用下一层的函数。在工作完成之后,再把处理结果一层层地传出到入口,如 图 5-14 所示。
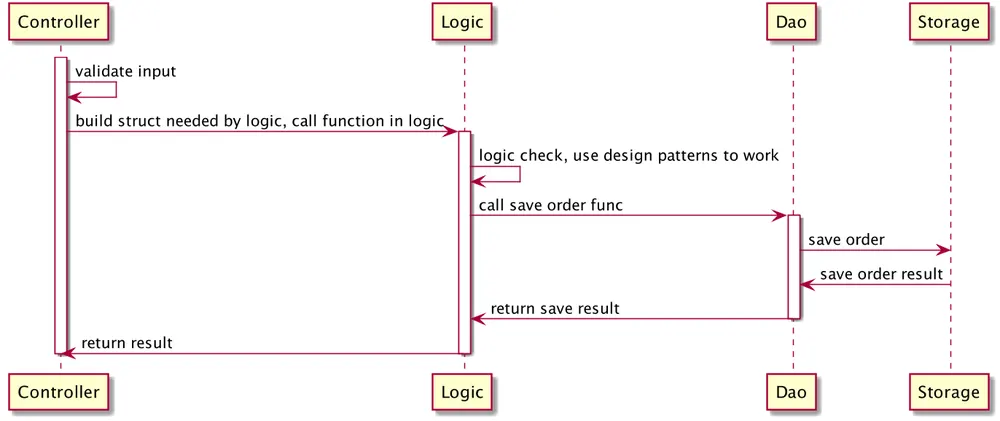
图 5-14 请求处理流程
划分为 CLD 三层之后,在 C 层之前我们可能还需要同时支持多种协议。本章前面讲到的 thrift、gRPC 和 http 并不是一定只选择其中一种,有时我们需要支持其中的两种,比如同一个接口,我们既需要效率较高的 thrift,也需要方便 debug 的 http 入口。即除了 CLD 之外,还需要一个单独的 protocol 层,负责处理各种交互协议的细节。这样请求的流程会变成 图 5-15 所示。
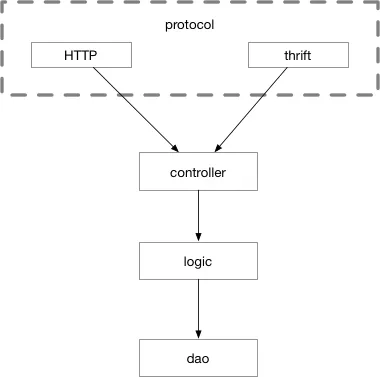
图 5-15 多协议示意图
这样我们 Controller 中的入口函数就变成了下面这样:
func CreateOrder(ctx context.Context, req *CreateOrderStruct) (
    *CreateOrderRespStruct, error,
) {
    // ...
}
CreateOrder 有两个参数,ctx 用来传入 trace_id 一类的需要串联请求的全局参数,req 里存储了我们创建订单所需要的所有输入信息。返回结果是一个响应结构体和错误。可以认为,我们的代码运行到 Controller 层之后,就没有任何与 “协议” 相关的代码了。在这里你找不到 http.Request,也找不到 http.ResponseWriter,也找不到任何与 thrift 或者 gRPC 相关的字眼。
在协议 (Protocol) 层,处理 http 协议的大概代码如下:
// defined in protocol layer
type CreateOrderRequest struct {
OrderID int64 `json:"order_id"`
// ...
}
// defined in controller
type CreateOrderParams struct {
OrderID int64
}
func HTTPCreateOrderHandler(wr http.ResponseWriter, r *http.Request) {
var req CreateOrderRequest
var params CreateOrderParams
ctx := context.TODO()
// bind data to req
bind(r, &req)
// map protocol binded to protocol-independent
map(req, params)
logicResp,err := controller.CreateOrder(ctx, ¶ms)
if err != nil {}
// ...
}理论上我们可以用同一个请求结构体组合上不同的 tag,来达到一个结构体来给不同的协议复用的目的。不过遗憾的是在 thrift 中,请求结构体也是通过 IDL 生成的,其内容在自动生成的 ttypes.go 文件中,我们还是需要在 thrift 的入口将这个自动生成的结构体映射到我们 logic 入口所需要的结构体上。gRPC 也是类似。这部分代码还是需要的。
聪明的读者可能已经可以看出来了,协议细节处理这一层有大量重复劳动,每一个接口在协议这一层的处理,无非是把数据从协议特定的结构体 (例如 http.Request,thrift 的被包装过了) 读出来,再绑定到我们协议无关的结构体上,再把这个结构体映射到 Controller 入口的结构体上,这些代码长得都差不多。差不多的代码都遵循着某种模式,那么我们可以对这些模式进行简单的抽象,用代码生成的方式,把繁复的协议处理代码从工作内容中抽离出去。
先来看看 HTTP 对应的结构体、thrift 对应的结构体和我们协议无关的结构体分别长什么样子:
// http 请求结构体
type CreateOrder struct {
    OrderID   int64  `json:"order_id" validate:"required"`
    UserID    int64  `json:"user_id" validate:"required"`
    ProductID int    `json:"prod_id" validate:"required"`
    Addr      string `json:"addr" validate:"required"`
}

// thrift 请求结构体
type FeatureSetParams struct {
    DriverID  int64  `thrift:"driverID,1,required"`
    OrderID   int64  `thrift:"OrderID,2,required"`
    UserID    int64  `thrift:"UserID,3,required"`
    ProductID int    `thrift:"ProductID,4,required"`
    Addr      string `thrift:"Addr,5,required"`
}

// controller input struct
type CreateOrderParams struct {
    OrderID int64
    UserID int64
    ProductID int
    Addr string
}
我们需要通过一个源结构体来生成我们需要的 HTTP 和 thrift 入口代码。再观察一下上面定义的三种结构体,我们只要能用一个结构体生成 thrift 的 IDL,以及 HTTP 服务的 “IDL(只要能包含 json 或 form 相关 tag 的结构体定义信息)” 就可以了。这个初始的结构体我们可以把结构体上的 HTTP 的 tag 和 thrift 的 tag 揉在一起:
type FeatureSetParams struct {
    DriverID  int64  `thrift:"driverID,1,required" json:"driver_id"`
    OrderID   int64  `thrift:"OrderID,2,required" json:"order_id"`
    UserID    int64  `thrift:"UserID,3,required" json:"user_id"`
    ProductID int    `thrift:"ProductID,4,required" json:"prod_id"`
    Addr      string `thrift:"Addr,5,required" json:"addr"`
}
然后通过代码生成把 thrift 的 IDL 和 HTTP 的请求结构体都生成出来,如 图 5-16 所示
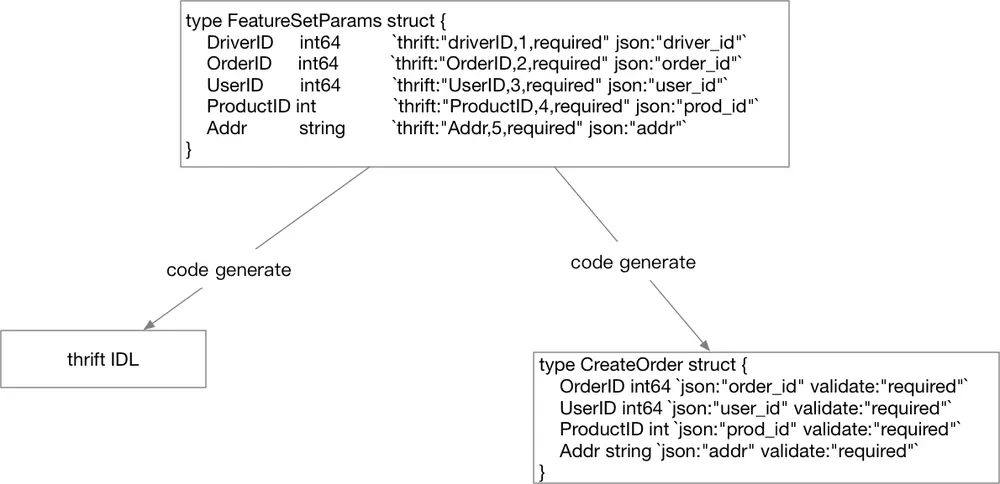
图 5-16 通过 Go 代码定义结构体生成项目入口
至于用什么手段来生成,你可以通过 Go 语言内置的 Parser 读取文本文件中的 Go 源代码,然后根据 AST 来生成目标代码,也可以简单地把这个源结构体和 Generator 的代码放在一起编译,让结构体作为 Generator 的输入参数(这样会更简单一些),都是可以的。
当然这种思路并不是唯一选择,我们还可以通过解析 thrift 的 IDL,生成一套 HTTP 接口的结构体。如果你选择这么做,那整个流程就变成了 图 5-17 所示。
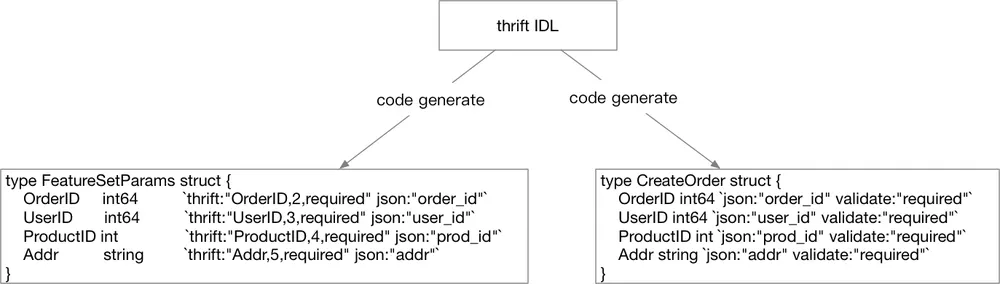
图 5-17 也可以从 thrift 生成其它部分
看起来比之前的图顺畅一点,不过如果你选择了这么做,你需要自行对 thrift 的 IDL 进行解析,也就是相当于可能要手写一个 thrift 的 IDL 的 Parser,虽然现在有 Antlr 或者 peg 能帮你简化这些 Parser 的书写工作,但在 “解析” 的这一步我们不希望引入太多的工作量,所以量力而行即可。
既然工作流已经成型,我们可以琢磨一下怎么让整个流程对用户更加友好。
比如在前面的生成环境引入 Web 页面,只要让用户点点鼠标就能生成 SDK,这些就靠读者自己去探索了。
虽然我们成功地使自己的项目在入口支持了多种交互协议,但是还有一些问题没有解决。本节中所叙述的分层没有将中间件作为项目的分层考虑进去。如果我们考虑中间件的话,请求的流程是什么样的?见 图 5-18 所示。
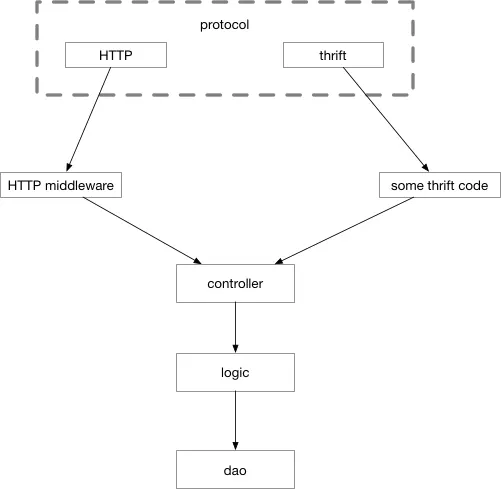
图 5-18 加入中间件后的控制流
之前我们学习的中间件是和 HTTP 协议强相关的,遗憾的是在 thrift 中看起来没有和 HTTP 中对等的解决这些非功能性逻辑代码重复问题的中间件。所以我们在图上写 thrift stuff。这些 stuff 可能需要你手写去实现,然后每次增加一个新的 thrift 接口,就需要去写一遍这些非功能性代码。
这也是很多企业项目所面临的真实问题,遗憾的是开源界并没有这样方便的多协议中间件解决方案。当然了,前面我们也说过,很多时候我们给自己保留的 HTTP 接口只是用来做调试,并不会暴露给外人用。这种情况下,这些非功能性的代码只要在 thrift 的代码中完成即可。
接口和表驱动开发
在 Web 项目中经常会遇到外部依赖环境的变化,比如:
- 公司的老存储系统年久失修,现在已经没有人维护了,新的系统上线也没有考虑平滑迁移,但最后通牒已下,要求 N 天之内迁移完毕。
- 平台部门的老用户系统年久失修,现在已经没有人维护了,真是悲伤的故事。新系统上线没有考虑兼容老接口,但最后通牒已下,要求 N 个月之内迁移完毕。
- 公司的老消息队列人走茶凉,年久失修,新来的技术精英们没有考虑向前兼容,但最后通牒已下,要求半年之内迁移完毕。
嗯,所以你看到了,我们的外部依赖总是为了自己爽而不断地做升级,且不想做向前兼容,然后来给我们下最后通牒。如果我们的部门工作饱和,领导强势,那么有时候也可以倒逼依赖方来做兼容。但世事不一定如人愿,即使我们的领导强势,读者朋友的领导也还是可能认怂的。
我们可以思考一下怎么缓解这个问题。
5.8.1 业务系统的发展过程
互联网公司只要可以活过三年,工程方面面临的首要问题就是代码膨胀。系统的代码膨胀之后,可以将系统中与业务本身流程无关的部分做拆解和异步化。什么算是业务无关呢,比如一些统计、反作弊、营销发券、价格计算、用户状态更新等等需求。这些需求往往依赖于主流程的数据,但又只是挂在主流程上的旁支,自成体系。
这时候我们就可以把这些旁支拆解出去,作为独立的系统来部署、开发以及维护。这些旁支流程的时延如若非常敏感,比如用户在界面上点了按钮,需要立刻返回(价格计算、支付),那么需要与主流程系统进行 RPC 通信,并且在通信失败时,要将结果直接返回给用户。如果时延不敏感,比如抽奖系统,结果稍后公布的这种,或者非实时的统计类系统,那么就没有必要在主流程里为每一套系统做一套 RPC 流程。我们只要将下游需要的数据打包成一条消息,传入消息队列,之后的事情与主流程一概无关(当然,与用户的后续交互流程还是要做的)。
通过拆解和异步化虽然解决了一部分问题,但并不能解决所有问题。随着业务发展,单一职责的模块也会变得越来越复杂,这是必然的趋势。一件事情本身变的复杂的话,这时候拆解和异步化就不灵了。我们还是要对事情本身进行一定程度的封装抽象。
5.8.2 使用函数封装业务流程
最基本的封装过程,我们把相似的行为放在一起,然后打包成一个一个的函数,让自己杂乱无章的代码变成下面这个样子:
func BusinessProcess(ctx context.Context, params Params) (resp, error){
    ValidateLogin()
    ValidateParams()
    AntispamCheck()
    GetPrice()
    CreateOrder()
    UpdateUserStatus()
    NotifyDownstreamSystems()
}
不管是多么复杂的业务,系统内的逻辑都是可以分解为 step1 -> step2 -> step3 ... 这样的流程的。
每一个步骤内部也会有复杂的流程,比如:
func CreateOrder() {
    ValidateDistrict()    // 判断是否是地区限定商品
    ValidateVIPProduct()  // 检查是否是只提供给 vip 的商品
    GetUserInfo()         // 从用户系统获取更详细的用户信息
    GetProductDesc()      // 从商品系统中获取商品在该时间点的详细信息
    DecrementStorage()    // 扣减库存
    CreateOrderSnapshot() // 创建订单快照
    return CreateSuccess
}
在阅读业务流程代码时,我们只要阅读其函数名就能知晓在该流程中完成了哪些操作,如果需要修改细节,那么就继续深入到每一个业务步骤去看具体的流程。写得稀烂的业务流程代码则会将所有过程都堆积在少数的几个函数中,从而导致几百甚至上千行的函数。这种意大利面条式的代码阅读和维护都会非常痛苦。在开发的过程中,一旦有条件应该立即进行类似上面这种方式的简单封装。
5.8.3 使用接口来做抽象
业务发展的早期,是不适宜引入接口(interface)的,很多时候业务流程变化很大,过早引入接口会使业务系统本身增加很多不必要的分层,从而导致每次修改几乎都要全盘否定之前的工作。
当业务发展到一定阶段,主流程稳定之后,就可以适当地使用接口来进行抽象了。这里的稳定,是指主流程的大部分业务步骤已经确定,即使再进行修改,也不会进行大规模的变动,而只是小修小补,或者只是增加或删除少量业务步骤。
如果我们在开发过程中,已经对业务步骤进行了良好的封装,这时候进行接口抽象化就会变的非常容易,伪代码:
// OrderCreator 创建订单流程
type OrderCreator interface {
    ValidateDistrict()    // 判断是否是地区限定商品
    ValidateVIPProduct()  // 检查是否是只提供给 vip 的商品
    GetUserInfo()         // 从用户系统获取更详细的用户信息
    GetProductDesc()      // 从商品系统中获取商品在该时间点的详细信息
    DecrementStorage()    // 扣减库存
    CreateOrderSnapshot() // 创建订单快照
}
我们只要把之前写过的步骤函数签名都提到一个接口中,就可以完成抽象了。
在进行抽象之前,我们应该想明白的一点是,引入接口对我们的系统本身是否有意义,这是要按照场景去进行分析的。假如我们的系统只服务一条产品线,并且内部的代码只是针对很具体的场景进行定制化开发,那么引入接口是不会带来任何收益的。至于说是否方便测试,这一点我们会在之后的章节来讲。
如果我们正在做的是平台系统,需要由平台来定义统一的业务流程和业务规范,那么基于接口的抽象就是有意义的。举个例子:
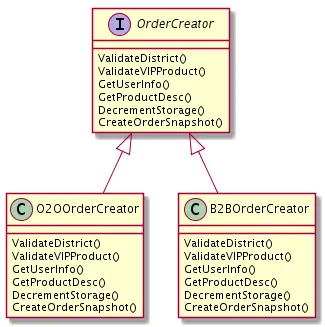
图 5-19 实现公有的接口
平台需要服务多条业务线,但数据定义需要统一,所以希望都能走平台定义的流程。作为平台方,我们可以定义一套类似上文的接口,然后要求接入方的业务必须将这些接口都实现。如果接口中有其不需要的步骤,那么只要返回 nil,或者忽略就好。
在业务进行迭代时,平台的代码是不用修改的,这样我们便把这些接入业务当成了平台代码的插件(plugin)引入进来了。如果没有接口的话,我们会怎么做?
import (
    "sample.com/travelorder"
    "sample.com/marketorder"
)

func CreateOrder() {
    switch businessType {
    case TravelBusiness:
        travelorder.CreateOrder()
    case MarketBusiness:
        marketorder.CreateOrderForMarket()
    default:
        return errors.New("not supported business")
    }
}

func ValidateUser() {
    switch businessType {
    case TravelBusiness:
        travelorder.ValidateUserVIP()
    case MarketBusiness:
        marketorder.ValidateUserRegistered()
    default:
        return errors.New("not supported business")
    }
}

// ...
switch ...
switch ...
switch ...
没错,就是无穷无尽的 switch,和没完没了的垃圾代码。引入了接口之后,我们的 switch 只需要在业务入口做一次。
type BusinessInstance interface {
    ValidateLogin()
    ValidateParams()
    AntispamCheck()
    GetPrice()
    CreateOrder()
    UpdateUserStatus()
    NotifyDownstreamSystems()
}

func entry() {
    var bi BusinessInstance
    switch businessType {
        case TravelBusiness:
            bi = travelorder.New()
        case MarketBusiness:
            bi = marketorder.New()
        default:
            return errors.New("not supported business")
    }
}

func BusinessProcess(bi BusinessInstance) {
    bi.ValidateLogin()
    bi.ValidateParams()
    bi.AntispamCheck()
    bi.GetPrice()
    bi.CreateOrder()
    bi.UpdateUserStatus()
    bi.NotifyDownstreamSystems()
}
面向接口编程,不用关心具体的实现。如果对应的业务在迭代中发生了修改,所有的逻辑对平台方来说也是完全透明的。
5.8.4 接口的优缺点
Go 被人称道的最多的地方是其接口设计的正交性,模块之间不需要知晓相互的存在,A 模块定义接口,B 模块实现这个接口就可以。如果接口中没有 A 模块中定义的数据类型,那 B 模块中甚至都不用 import A。比如标准库中的 io.Writer:
type Writer interface {
    Write(p []byte) (n int, err error)
}
我们可以在自己的模块中实现 io.Writer 接口:
type MyType struct {}

func (m MyType) Write(p []byte) (n int, err error) {
    return 0, nil
}
那么我们就可以把我们自己的 MyType 传给任何使用 io.Writer 作为参数的函数来使用了,比如:
package log

func SetOutput(w io.Writer) {
    output = w
}
然后:
package my-business

import "xy.com/log"

func init() {
    log.SetOutput(MyType)
}
在 MyType 定义的地方,不需要 import "io" 就可以直接实现 io.Writer 接口,我们还可以随意地组合很多函数,以实现各种类型的接口,同时接口实现方和接口定义方都不用建立 import 产生的依赖关系。因此很多人认为 Go 的这种正交是一种很优秀的设计。
但这种 “正交” 性也会给我们带来一些麻烦。当我们接手了一个几十万行的系统时,如果看到定义了很多接口,例如订单流程的接口,我们希望能直接找到这些接口都被哪些对象实现了。但直到现在,这个简单的需求也就只有 Goland 实现了,并且体验尚可。Visual Studio Code 则需要对项目进行全局扫描,来看到底有哪些结构体实现了该接口的全部函数。那些显式实现接口的语言,对于 IDE 的接口查找来说就友好多了。另一方面,我们看到一个结构体,也希望能够立刻知道这个结构体实现了哪些接口,但也有着和前面提到的相同的问题。
虽有不便,接口带给我们的好处也是不言而喻的:一是依赖反转,这是接口在大多数语言中对软件项目所能产生的影响,在 Go 的正交接口的设计场景下甚至可以去除依赖;二是由编译器来帮助我们在编译期就能检查到类似 “未完全实现接口” 这样的错误,如果业务未实现某个流程,但又将其实例作为接口强行来使用的话:
package main

type OrderCreator interface {
    ValidateUser()
    CreateOrder()
}

type BookOrderCreator struct{}

func (boc BookOrderCreator) ValidateUser() {}

func createOrder(oc OrderCreator) {
    oc.ValidateUser()
    oc.CreateOrder()
}

func main() {
    createOrder(BookOrderCreator{})
}
会报出下述错误。
# command-line-arguments
./a.go:18:30: cannot use BookOrderCreator literal (type BookOrderCreator) as type OrderCreator in argument to createOrder:
    BookOrderCreator does not implement OrderCreator (missing CreateOrder method)
所以接口也可以认为是一种编译期进行检查的保证类型安全的手段。
5.8.5 表驱动开发
熟悉开源 lint 工具的同学应该见到过圈复杂度的说法,在函数中如果有 if 和 switch 的话,会使函数的圈复杂度上升,所以有强迫症的同学即使在入口一个函数中有 switch,还是想要干掉这个 switch,有没有什么办法呢?当然有,用表驱动的方式来存储我们需要实例:
func entry() {
    var bi BusinessInstance
    switch businessType {
    case TravelBusiness:
        bi = travelorder.New()
    case MarketBusiness:
        bi = marketorder.New()
    default:
        return errors.New("not supported business")
    }
}
可以修改为:
var businessInstanceMap = map[int]BusinessInstance {
    TravelBusiness : travelorder.New(),
    MarketBusiness : marketorder.New(),
}

func entry() {
    bi := businessInstanceMap[businessType]
}
表驱动的设计方式,很多设计模式相关的书籍并没有把它作为一种设计模式来讲,但我认为这依然是一种非常重要的帮助我们来简化代码的手段。在日常的开发工作中可以多多思考,哪些不必要的 switch case 可以用一个字典和一行代码就可以轻松搞定。
当然,表驱动也不是没有缺点,因为需要对输入 key 计算哈希,在性能敏感的场合,需要多加斟酌。
灰度发布和A/B测试
中型的互联网公司往往有着以百万计的用户,而大型互联网公司的系统则可能要服务千万级甚至亿级的用户需求。大型系统的请求流入往往是源源不断的,任何风吹草动,都一定会有最终用户感受得到。例如你的系统在上线途中会拒绝一些上游过来的请求,而这时候依赖你的系统没有做任何容错,那么这个错误就会一直向上抛出,直到触达最终用户。形成一次对用户切切实实的伤害。这种伤害可能是在用户的 APP 上弹出一个让用户摸不着头脑的诡异字符串,用户只要刷新一下页面就可以忘记这件事。但也可能会让正在心急如焚地和几万竞争对手同时抢夺秒杀商品的用户,因为代码上的小问题,丧失掉了先发优势,与自己蹲了几个月的心仪产品失之交臂。对用户的伤害有多大,取决于你的系统对于你的用户来说有多重要。
不管怎么说,在大型系统中容错是重要的,能够让系统按百分比,分批次到达最终用户,也是很重要的。虽然当今的互联网公司系统,名义上会说自己上线前都经过了充分慎重严格的测试,但就算它们真得做到了,代码的 bug 总是在所难免的。即使代码没有 bug,分布式服务之间的协作也是可能出现 “逻辑” 上的非技术问题的。
这时候,灰度发布就显得非常重要了,灰度发布也称为金丝雀发布,传说 17 世纪的英国矿井工人发现金丝雀对瓦斯气体非常敏感,瓦斯达到一定浓度时,金丝雀即会死亡,但金丝雀的致死量瓦斯对人并不致死,因此金丝雀被用来当成他们的瓦斯检测工具。互联网系统的灰度发布一般通过两种方式实现:
- 通过分批次部署实现灰度发布
- 通过业务规则进行灰度发布
在对系统的旧功能进行升级迭代时,第一种方式用的比较多。新功能上线时,第二种方式用的比较多。当然,对比较重要的老功能进行较大幅度的修改时,一般也会选择按业务规则来进行发布,因为直接全量开放给所有用户风险实在太大。
5.9.1 通过分批次部署实现灰度发布
假如服务部署在 15 个实例(可能是物理机,也可能是容器)上,我们把这 15 个实例分为四组,按照先后顺序,分别有 1-2-4-8 台机器,保证每次扩展时大概都是二倍的关系。
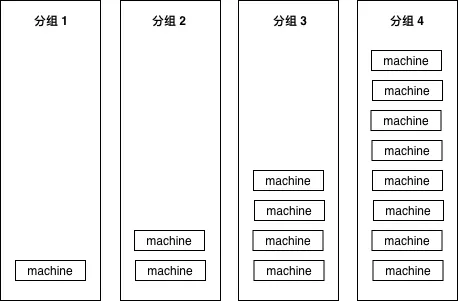
图 5-20 分组部署
为什么要用 2 倍?这样能够保证我们不管有多少台机器,都不会把组划分得太多。例如 1024 台机器,也就只需要 1-2-4-8-16-32-64-128-256-512 部署十次就可以全部部署完毕。
这样我们上线最开始影响到的用户在整体用户中占的比例也不大,比如 1000 台机器的服务,我们上线后如果出现问题,也只影响 1/1000 的用户。如果 10 组完全平均分,那一上线立刻就会影响 1/10 的用户,1/10 的业务出问题,那可能对于公司来说就已经是一场不可挽回的事故了。
在上线时,最有效的观察手法是查看程序的错误日志,如果较明显的逻辑错误,一般错误日志的滚动速度都会有肉眼可见的增加。这些错误也可以通过 metrics 一类的系统上报给公司内的监控系统,所以在上线过程中,也可以通过观察监控曲线,来判断是否有异常发生。
如果有异常情况,首先要做的自然就是回滚了。
5.9.2 通过业务规则进行灰度发布
常见的灰度策略有多种,较为简单的需求,例如我们的策略是要按照千分比来发布,那么我们可以用用户 id、手机号、用户设备信息,等等,来生成一个简单的哈希值,然后再求模,用伪代码表示一下:
// pass 3/1000
func passed() bool {
    key := hashFunctions(userID) % 1000
    if key <= 2 {
        return true
    }

    return false
}
5.9.2.1 可选规则
常见的灰度发布系统会有下列规则提供选择:
- 按城市发布
- 按概率发布
- 按百分比发布
- 按白名单发布
- 按业务线发布
- 按 UA 发布 (APP、Web、PC)
- 按分发渠道发布
因为和公司的业务相关,所以城市、业务线、UA、分发渠道这些都可能会被直接编码在系统里,不过功能其实大同小异。
按白名单发布比较简单,功能上线时,可能我们希望只有公司内部的员工和测试人员可以访问到新功能,会直接把账号、邮箱写入到白名单,拒绝其它任何账号的访问。
按概率发布则是指实现一个简单的函数:
func isTrue() bool {
    return true/false according to the rate provided by user
}
其可以按照用户指定的概率返回 true 或者 false,当然,true 的概率加 false 的概率应该是 100%。这个函数不需要任何输入。
按百分比发布,是指实现下面这样的函数:
func isTrue(phone string) bool {
    if hash of phone matches {
        return true
    }

    return false
}
这种情况可以按照指定的百分比,返回对应的 true 和 false,和上面的单纯按照概率的区别是这里我们需要调用方提供给我们一个输入参数,我们以该输入参数作为源来计算哈希,并以哈希后的结果来求模,并返回结果。这样可以保证同一个用户的返回结果多次调用是一致的,在下面这种场景下,必须使用这种结果可预期的灰度算法,见 图 5-21 所示。
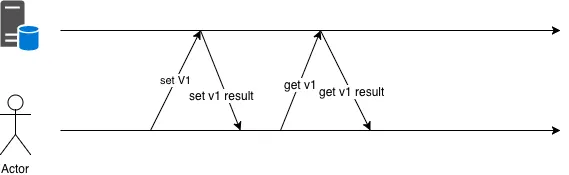
图 5-21 先 set 然后马上 get
如果采用随机策略,可能会出现像 图 5-22 这样的问题:
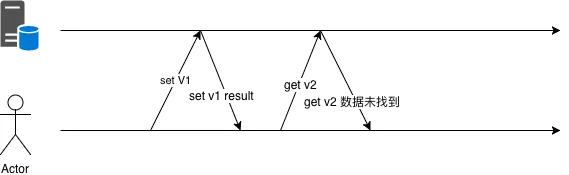
图 5-22 先 set 然后马上 get
举个具体的例子,网站的注册环节,可能有两套 API,按照用户 ID 进行灰度,分别是不同的存取逻辑。如果存储时使用了 V1 版本的 API 而获取时使用 V2 版本的 API,那么就可能出现用户注册成功后反而返回注册失败消息的诡异问题。
5.9.3 如何实现一套灰度发布系统
前面也提到了,提供给用户的接口大概可以分为和业务绑定的简单灰度判断逻辑。以及输入稍微复杂一些的哈希灰度。我们来分别看看怎么实现这样的灰度系统(函数)。
5.9.3.1 业务相关的简单灰度
公司内一般都会有公共的城市名字和 id 的映射关系,如果业务只涉及中国国内,那么城市数量不会特别多,且 id 可能都在 10000 范围以内。那么我们只要开辟一个一万大小左右的 bool 数组,就可以满足需求了:
var cityID2Open = [12000]bool{}

func init() {
    readConfig()
    for i:=0;i<len(cityID2Open);i++ {
        if city i is opened in configs {
            cityID2Open[i] = true
        }
    }
}

func isPassed(cityID int) bool {
    return cityID2Open[cityID]
}
如果公司给 cityID 赋的值比较大,那么我们可以考虑用 map 来存储映射关系,map 的查询比数组稍慢,但扩展会灵活一些:
var cityID2Open = map[int]struct{}{}

func init() {
    readConfig()
    for _, city := range openCities {
        cityID2Open[city] = struct{}{}
    }
}

func isPassed(cityID int) bool {
    if _, ok := cityID2Open[cityID]; ok {
        return true
    }

    return false
}
按白名单、按业务线、按 UA、按分发渠道发布,本质上和按城市发布是一样的,这里就不再赘述了。
按概率发布稍微特殊一些,不过不考虑输入实现起来也很简单:
func init() {
    rand.Seed(time.Now().UnixNano())
}

// rate 为 0~100
func isPassed(rate int) bool {
    if rate >= 100 {
        return true
    }

    if rate > 0 && rand.Int(100) > rate {
        return true
    }

    return false
}
注意初始化种子。
5.9.3.2 哈希算法
求哈希可用的算法非常多,比如 md5,crc32,sha1 等等,但我们这里的目的只是为了给这些数据做个映射,并不想要因为计算哈希消耗过多的 cpu,所以现在业界使用较多的算法是 murmurhash,下面是我们对这些常见的 hash 算法的简单 benchmark。
下面使用了标准库的 md5,sha1 和开源的 murmur3 实现来进行对比。
package main

import (
    "crypto/md5"
    "crypto/sha1"

    "github.com/spaolacci/murmur3"
)

var str = "hello world"

func md5Hash() [16]byte {
    return md5.Sum([]byte(str))
}

func sha1Hash() [20]byte {
    return sha1.Sum([]byte(str))
}

func murmur32() uint32 {
    return murmur3.Sum32([]byte(str))
}

func murmur64() uint64 {
    return murmur3.Sum64([]byte(str))
}
为这些算法写一个基准测试:
package main

import "testing"

func BenchmarkMD5(b *testing.B) {
    for i := 0; i < b.N; i++ {
        md5Hash()
    }
}

func BenchmarkSHA1(b *testing.B) {
    for i := 0; i < b.N; i++ {
        sha1Hash()
    }
}

func BenchmarkMurmurHash32(b *testing.B) {
    for i := 0; i < b.N; i++ {
        murmur32()
    }
}

func BenchmarkMurmurHash64(b *testing.B) {
    for i := 0; i < b.N; i++ {
        murmur64()
    }
}
然后看看运行效果:
~/t/g/hash_bench git:master ❯❯❯ go test -bench=.
goos: darwin
goarch: amd64
BenchmarkMD5-4          10000000 180 ns/op
BenchmarkSHA1-4         10000000 211 ns/op
BenchmarkMurmurHash32-4 50000000  25.7 ns/op
BenchmarkMurmurHash64-4 20000000  66.2 ns/op
PASS
ok _/Users/caochunhui/test/go/hash_bench 7.050s
可见 murmurhash 相比其它的算法有三倍以上的性能提升。显然做负载均衡的话,用 murmurhash 要比 md5 和 sha1 都要好,这些年社区里还有另外一些更高效的哈希算法涌现,感兴趣的读者可以自行调研。
5.9.3.3 分布是否均匀
对于哈希算法来说,除了性能方面的问题,还要考虑哈希后的值是否分布均匀。如果哈希后的值分布不均匀,那也自然就起不到均匀灰度的效果了。
以 murmur3 为例,我们先以 15810000000 开头,造一千万个和手机号类似的数字,然后将计算后的哈希值分十个桶,并观察计数是否均匀:
package main

import (
    "fmt"

    "github.com/spaolacci/murmur3"
)

var bucketSize = 10

func main() {
    var bucketMap = map[uint64]int{}
    for i := 15000000000; i < 15000000000+10000000; i++ {
        hashInt := murmur64(fmt.Sprint(i)) % uint64(bucketSize)
        bucketMap[hashInt]++
    }
    fmt.Println(bucketMap)
}

func murmur64(p string) uint64 {
    return murmur3.Sum64([]byte(p))
}
看看执行结果:
map[7:999475 5:1000359 1:999945 6:1000200 3:1000193 9:1000765 2:1000044 \
4:1000343 8:1000823 0:997853]
偏差都在 1/100 以内,可以接受。读者在调研其它算法,并判断是否可以用来做灰度发布时,也应该从本节中提到的性能和均衡度两方面出发,对其进行考察。
补充说明
现代的软件工程是离不开 Web 的,广义地来讲,Web 甚至可以不用非得基于 http 协议。只要是 CS 或者 BS 架构,都可以认为是 Web 系统。
即使是在看起来非常封闭的游戏系统里,因为玩家们与日俱增的联机需求,也同样会涉及到远程通信,这里面也会涉及到很多 Web 方面的技术。
所以这个时代,Web 编程是一个程序员所必须接触的知识领域。无论你的目标是成为架构师,是去创业,或是去当技术顾问。Web 方面的知识都会成为你的硬通货。