[!IMPORTANT]
本章学习时间:3天
本章配套视频教程:
https://www.bilibili.com/video/BV1Mh411e7VU?p=12
https://www.bilibili.com/video/BV1Mh411e7VU?p=13
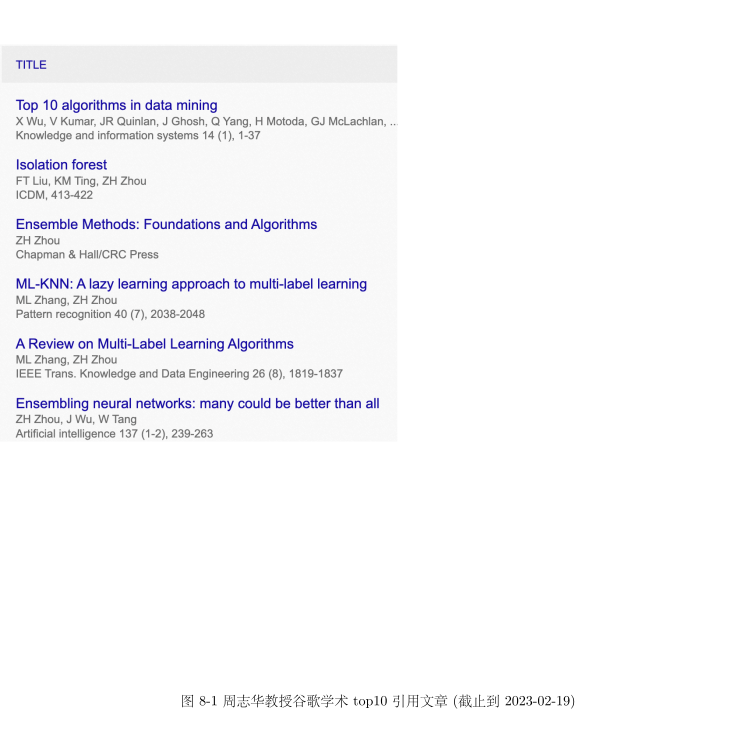
集成学习(ensemble
在引用次数前10的文章中,第1名"Top 10 algorithms in data
毫不夸张的说,周志华教授在集成学习领域深耕了很多年,是绝对的权威。而集成学习也是经受了时间考验的非常有效的算法,常常被各位竞赛同学作为涨点提分的致胜法宝。下面,让我们一起认真享受"西瓜书"作者最拿手的集成学习章节吧。
8.1 个体与集成
基学习器(base
8.1.1 式(8.1)的解释
h i ( x ) h_{i}(\boldsymbol{x}) h i ( x ) i i i x x x f ( x ) f(\boldsymbol{x}) f ( x ) x x x ϵ \epsilon ϵ
8.1.2 式(8.2)的解释
注意到当前仅针对二分类问题 y ∈ { − 1 , + 1 } y \in\{-1,+1\} y ∈ { − 1 , + 1 } h i ( x ) ∈ { − 1 , + 1 } h_i(\boldsymbol{x}) \in\{-1,+1\} h i ( x ) ∈ { − 1 , + 1 } h i h_i h i sign \operatorname{sign} sign H ( x ) H(\boldsymbol{x}) H ( x )
8.1.3 式(8.3)的推导
由基分类器相互独立,假设随机变量X X X T T T X \mathrm{X} X X ∼ B ( T , 1 − ϵ ) \mathrm{X} \sim \mathcal{B}(\mathrm{T}, 1-\mathrm{\epsilon}) X ∼ B ( T , 1 − ϵ ) x i x_i x i x i ∼ B ( 1 , 1 − ϵ ) ( i = 1 , 2 , 3 , . . . , T ) x_i\sim \mathcal{B}(1, 1-\mathrm{\epsilon})(i=1,2,3,...,\mathrm{T}) x i ∼ B ( 1 , 1 − ϵ ) ( i = 1 , 2 , 3 , ... , T )
X = ∑ i = 1 T x i E ( X ) = ∑ i = 1 T E ( x i ) = ( 1 − ϵ ) T \begin{aligned}
\mathrm{X}&=\sum_{i=1}^{\mathrm{T}} x_i\\
\mathbb{E}(X)&=\sum_{i=1}^{\mathrm{T}}\mathbb{E}(x_i)=(1-\epsilon)T
\end{aligned} X E ( X ) = i = 1 ∑ T x i = i = 1 ∑ T E ( x i ) = ( 1 − ϵ ) T
证明过程如下:
P ( H ( x ) ≠ f ( x ) ) = P ( X ≤ ⌊ T / 2 ⌋ ) ⩽ P ( X ≤ T / 2 ) = P [ X − ( 1 − ϵ ) T ⩽ T 2 − ( 1 − ϵ ) T ] = P [ X − ( 1 − ϵ ) T ⩽ − T 2 ( 1 − 2 ϵ ) ] ] = P [ ∑ i = 1 T x i − ∑ i = 1 T E ( x i ) ⩽ − T 2 ( 1 − 2 ϵ ) ] ] = P [ 1 T ∑ i = 1 T x i − 1 T ∑ i = 1 T E ( x i ) ⩽ − 1 2 ( 1 − 2 ϵ ) ] ] \begin{aligned} P(H(x) \neq f(x))=& P(X \leq\lfloor T / 2\rfloor) \\ & \leqslant P(X \leq T / 2)
\\ & =P\left[X-(1-\epsilon) T \leqslant \frac{T}{2}-(1-\epsilon) T\right]
\\ & =P\left[X-
(1-\epsilon) T \leqslant -\frac{T}{2}\left(1-2\epsilon\right)]\right]
\\ &=P\left[\sum_{i=1}^{\mathrm{T}} x_i-
\sum_{i=1}^{\mathrm{T}}\mathbb{E}(x_i) \leqslant -\frac{T}{2}\left(1-2\epsilon\right)]\right]
\\ &=P\left[\frac{1}{\mathrm{T}}\sum_{i=1}^{\mathrm{T}} x_i-\frac{1}{\mathrm{T}}
\sum_{i=1}^{\mathrm{T}}\mathbb{E}(x_i) \leqslant -\frac{1}{2}\left(1-2\epsilon\right)]\right]
\end{aligned} P ( H ( x ) = f ( x )) = P ( X ≤ ⌊ T /2 ⌋) ⩽ P ( X ≤ T /2 ) = P [ X − ( 1 − ϵ ) T ⩽ 2 T − ( 1 − ϵ ) T ] = P [ X − ( 1 − ϵ ) T ⩽ − 2 T ( 1 − 2 ϵ ) ] ] = P [ i = 1 ∑ T x i − i = 1 ∑ T E ( x i ) ⩽ − 2 T ( 1 − 2 ϵ ) ] ] = P [ T 1 i = 1 ∑ T x i − T 1 i = 1 ∑ T E ( x i ) ⩽ − 2 1 ( 1 − 2 ϵ ) ] ]
根据Hoeffding不等式知
P ( 1 m ∑ i = 1 m x i − 1 m ∑ i = 1 m E ( x i ) ⩽ − δ ) ⩽ exp ( − 2 m δ 2 ) P\left(\frac{1}{m} \sum_{i=1}^{m} x_{i}-\frac{1}{m} \sum_{i=1}^{m} \mathbb{E}\left(x_{i}\right) \leqslant -\delta\right) \leqslant \exp \left(-2 m \delta^{2}\right) P ( m 1 i = 1 ∑ m x i − m 1 i = 1 ∑ m E ( x i ) ⩽ − δ ) ⩽ exp ( − 2 m δ 2 )
令δ = ( 1 − 2 ϵ ) 2 , m = T \delta=\frac {(1-2\epsilon)}{2},m=T δ = 2 ( 1 − 2 ϵ ) , m = T
P ( H ( x ) ≠ f ( x ) ) = ∑ k = 0 ⌊ T / 2 ⌋ ( T k ) ( 1 − ϵ ) k ϵ T − k ⩽ exp ( − 1 2 T ( 1 − 2 ϵ ) 2 ) \begin{aligned} P(H(\boldsymbol{x}) \neq f(\boldsymbol{x})) &=\sum_{k=0}^{\lfloor T / 2\rfloor} \left( \begin{array}{c}{T} \\ {k}\end{array}\right)(1-\epsilon)^{k} \epsilon^{T-k} \\ & \leqslant \exp \left(-\frac{1}{2} T(1-2 \epsilon)^{2}\right) \end{aligned} P ( H ( x ) = f ( x )) = k = 0 ∑ ⌊ T /2 ⌋ ( T k ) ( 1 − ϵ ) k ϵ T − k ⩽ exp ( − 2 1 T ( 1 − 2 ϵ ) 2 )
8.2 Boosting
注意8.1节最后一段提到:根据个体学习器的生成方式,目前的集成学习方法大致可分为两大类,即个体学习器间存在强依赖关系、必须串行生成的序列化方法,以及个体学习器间不存在强依赖关系、可同时生成的并行化方法。
本节Boosting为前者的代表,Adaboost又是Boosting族算法的代表。
8.2.1 式(8.4)的解释
这个式子是集成学习的加性模型,加性模型不采用梯度下降的思想,而是H ( x ) = ∑ t = 1 T − 1 α t h t ( x ) + α T h T ( x ) H(\boldsymbol{x})=\sum_{t=1}^{T-1} \alpha_{t} h_{t}(\boldsymbol{x})+\alpha_{T}h_{T}(\boldsymbol{x}) H ( x ) = ∑ t = 1 T − 1 α t h t ( x ) + α T h T ( x ) T T T h T h_T h T α T \alpha_T α T (h T h_T h T α T \alpha_T α T
8.2.2 式(8.5)的解释
先考虑指数损失函数e − f ( x ) H ( x ) e^{-f(x) H(x)} e − f ( x ) H ( x ) (参见"西瓜书"图6.5) :f f f x x x f ( x ) ∈ { + 1 , − 1 } f(\boldsymbol{x}) \in\{+1,-1\} f ( x ) ∈ { + 1 , − 1 } + 1 +1 + 1 − 1 -1 − 1 H ( x ) H(\boldsymbol{x}) H ( x )
当H ( x ) H(\boldsymbol{x}) H ( x ) f ( x ) f(x) f ( x ) f ( x ) H ( x ) > 0 f(\boldsymbol{x}) H(\boldsymbol{x})>0 f ( x ) H ( x ) > 0 e − f ( x ) H ( x ) = e − ∣ H ( x ) ∣ < 1 e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}=e^{-|H(\boldsymbol{x})|}<1 e − f ( x ) H ( x ) = e − ∣ H ( x ) ∣ < 1 ∣ H ( x ) ∣ |H(\boldsymbol{x})| ∣ H ( x ) ∣ e − f ( x ) H ( x ) e^{-f(\boldsymbol{x}) H(\boldsymbol{x})} e − f ( x ) H ( x ) ∣ H ( x ) ∣ |H(\boldsymbol{x})| ∣ H ( x ) ∣ ∣ H ( x ) ∣ |H(\boldsymbol{x})| ∣ H ( x ) ∣
当H ( x ) H(\boldsymbol{x}) H ( x ) f ( x ) f(\boldsymbol{x}) f ( x ) f ( x ) H ( x ) < 0 f(\boldsymbol{x}) H(\boldsymbol{x})<0 f ( x ) H ( x ) < 0 e − f ( x ) H ( x ) = e ∣ H ( x ) ∣ > 1 e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}=e^{|H(\boldsymbol{x})|}>1 e − f ( x ) H ( x ) = e ∣ H ( x ) ∣ > 1 ∣ H ( x ) ∣ | H(\boldsymbol{x}) | ∣ H ( x ) ∣ ∣ H ( x ) ∣ | H(\boldsymbol{x}) | ∣ H ( x ) ∣ ∣ H ( x ) ∣ | H(\boldsymbol{x}) | ∣ H ( x ) ∣
再解释符号E x ∼ D [ ⋅ ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}[\cdot] E x ∼ D [ ⋅ ] D \mathcal{D} D D D D E [ ⋅ ] \mathbb{E}[\cdot] E [ ⋅ ] E x ∼ D [ ⋅ ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}[\cdot] E x ∼ D [ ⋅ ] D \mathcal{D} D D D D D \mathcal{D} D
综上所述, 若数据集 D D D x \boldsymbol{x} x D ( x ) \mathcal{D}(\boldsymbol{x}) D ( x )
ℓ exp ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = ∑ x ∈ D D ( x ) e − f ( x ) H ( x ) = ∑ x ∈ D D ( x ) ( e − H ( x ) I ( f ( x ) = 1 ) + e H ( x ) I ( f ( x ) = − 1 ) ) \begin{aligned}
\ell_{\exp }(H \mid \mathcal{D}) & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}\right] \\
& =\sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H(\boldsymbol{x})} \\
& =\sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x})\left(e^{-H(\boldsymbol{x})} \mathbb{I}(f(\boldsymbol{x})=1)+e^{H(\boldsymbol{x})} \mathbb{I}(f(\boldsymbol{x})=-1)\right)
\end{aligned} ℓ e x p ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = x ∈ D ∑ D ( x ) e − f ( x ) H ( x ) = x ∈ D ∑ D ( x ) ( e − H ( x ) I ( f ( x ) = 1 ) + e H ( x ) I ( f ( x ) = − 1 ) )
特别地, 若针对任意样本 x \boldsymbol{x} x D ( x ) = 1 ∣ D ∣ \mathcal{D}(\boldsymbol{x})=\frac{1}{|D|} D ( x ) = ∣ D ∣ 1 ∣ D ∣ |D| ∣ D ∣ D D D
ℓ exp ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = 1 ∣ D ∣ ∑ x ∈ D e − f ( x ) H ( x ) \ell_{\exp }(H \mid \mathcal{D})=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}\right]=\frac{1}{|D|} \sum_{\boldsymbol{x} \in D} e^{-f(\boldsymbol{x}) H(\boldsymbol{x})} ℓ e x p ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = ∣ D ∣ 1 x ∈ D ∑ e − f ( x ) H ( x )
而这就是在求传统平均值。
8.2.3 式(8.6)的推导
由式(8.5)中对于符号E x ∼ D [ ⋅ ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}[\cdot] E x ∼ D [ ⋅ ]
ℓ exp ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = ∑ x ∈ D D ( x ) e − f ( x ) H ( x ) = ∑ i = 1 ∣ D ∣ D ( x i ) ( e − H ( x i ) I ( f ( x i ) = 1 ) + e H ( x i ) I ( f ( x i ) = − 1 ) ) = ∑ i = 1 ∣ D ∣ ( e − H ( x i ) D ( x i ) I ( f ( x i ) = 1 ) + e H ( x i ) D ( x i ) I ( f ( x i ) = − 1 ) ) = ∑ i = 1 ∣ D ∣ ( e − H ( x i ) P ( f ( x i ) = 1 ∣ x i ) + e H ( x i ) P ( f ( x i ) = − 1 ∣ x i ) ) \begin{aligned}
\ell_{\exp }(H | \mathcal{D}) &=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}\right] \\
&=\sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H(\boldsymbol{x})} \\
&=\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_{i}\right)\left(e^{-H\left(\boldsymbol{x}_{i}\right)} \mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=1\right)+e^{H\left(\boldsymbol{x}_{i}\right)} \mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=-1\right)\right)\\
&=\sum_{i=1}^{|D|} \left(e^{-H\left(\boldsymbol{x}_{i}\right)} \mathcal{D}\left(\boldsymbol{x}_{i}\right)\mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=1\right)+e^{H\left(\boldsymbol{x}_{i}\right)} \mathcal{D}\left(\boldsymbol{x}_{i}\right)\mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=-1\right)\right)\\
&=\sum_{i=1}^{|D|} \left(e^{-H\left(\boldsymbol{x}_{i}\right)} P\left(f\left(\boldsymbol{x}_{i}\right)=1 \mid \boldsymbol{x}_{i}\right)+e^{H\left(\boldsymbol{x}_{i}\right)} P\left(f\left(\boldsymbol{x}_{i}\right)=-1 \mid \boldsymbol{x}_{i}\right)\right)
\end{aligned} ℓ e x p ( H ∣ D ) = E x ∼ D [ e − f ( x ) H ( x ) ] = x ∈ D ∑ D ( x ) e − f ( x ) H ( x ) = i = 1 ∑ ∣ D ∣ D ( x i ) ( e − H ( x i ) I ( f ( x i ) = 1 ) + e H ( x i ) I ( f ( x i ) = − 1 ) ) = i = 1 ∑ ∣ D ∣ ( e − H ( x i ) D ( x i ) I ( f ( x i ) = 1 ) + e H ( x i ) D ( x i ) I ( f ( x i ) = − 1 ) ) = i = 1 ∑ ∣ D ∣ ( e − H ( x i ) P ( f ( x i ) = 1 ∣ x i ) + e H ( x i ) P ( f ( x i ) = − 1 ∣ x i ) )
其中D ( x i ) I ( f ( x i ) = 1 ) = P ( f ( x i ) = 1 ∣ x i ) \mathcal{D}\left(\boldsymbol{x}_{i}\right)\mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=1\right)=P\left(f\left(\boldsymbol{x}_{i}\right)=1 \mid \boldsymbol{x}_{i}\right) D ( x i ) I ( f ( x i ) = 1 ) = P ( f ( x i ) = 1 ∣ x i ) D ( x i ) \mathcal{D}(x_i) D ( x i ) D D D x i x_i x i D ( x i ) I ( f ( x i ) = 1 ) \mathcal{D}\left(\boldsymbol{x}_{i}\right)\mathbb{I}\left(f\left(\boldsymbol{x}_{i}\right)=1\right) D ( x i ) I ( f ( x i ) = 1 ) D D D f ( x i ) = 1 f(x_i)=1 f ( x i ) = 1 x i x_i x i P ( f ( x i ) = 1 ∣ x i ) P\left(f\left(\boldsymbol{x}_{i}\right)=1 \mid \boldsymbol{x}_{i}\right) P ( f ( x i ) = 1 ∣ x i )
当对H ( x i ) H(x_i) H ( x i ) x i x_i x i
∂ e − H ( x ) ∂ H ( x ) = − e − H ( x ) ∂ e H ( x ) ∂ H ( x ) = e H ( x ) \frac{\partial e^{-H(\boldsymbol{x})}}{\partial H(\boldsymbol{x})}=-e^{-H(\boldsymbol{x})}\qquad \frac{\partial e^{H(\boldsymbol{x})}}{\partial H(\boldsymbol{x})}=e^{H(\boldsymbol{x})} ∂ H ( x ) ∂ e − H ( x ) = − e − H ( x ) ∂ H ( x ) ∂ e H ( x ) = e H ( x )
有
∂ ℓ exp ( H ∣ D ) ∂ H ( x ) = − e − H ( x ) P ( f ( x ) = 1 ∣ x ) + e H ( x ) P ( f ( x ) = − 1 ∣ x ) \frac{\partial \ell_{\exp }(H | \mathcal{D})}{\partial H(\boldsymbol{x})}=-e^{-H(\boldsymbol{x})} P(f(\boldsymbol{x})=1 | \boldsymbol{x})+e^{H(\boldsymbol{x})} P(f(\boldsymbol{x})=-1 | \boldsymbol{x}) ∂ H ( x ) ∂ ℓ e x p ( H ∣ D ) = − e − H ( x ) P ( f ( x ) = 1∣ x ) + e H ( x ) P ( f ( x ) = − 1∣ x )
8.2.4 式(8.7)的推导
令式(8.6)等于零:
− e − H ( x ) P ( f ( x ) = 1 ∣ x ) + e H ( x ) P ( f ( x ) = − 1 ∣ x ) = 0 \quad-e^{-H(\boldsymbol{x})} P(f(\boldsymbol{x})=1 \mid \boldsymbol{x})+e^{H(\boldsymbol{x})} P(f(\boldsymbol{x})=-1 \mid \boldsymbol{x})=0 − e − H ( x ) P ( f ( x ) = 1 ∣ x ) + e H ( x ) P ( f ( x ) = − 1 ∣ x ) = 0
移项:
e H ( x ) P ( f ( x ) = − 1 ∣ x ) = e − H ( x ) P ( f ( x ) = 1 ∣ x ) \quad e^{H(\boldsymbol{x})} P(f(\boldsymbol{x})=-1 \mid \boldsymbol{x})=e^{-H(\boldsymbol{x})} P(f(\boldsymbol{x})=1 \mid \boldsymbol{x}) e H ( x ) P ( f ( x ) = − 1 ∣ x ) = e − H ( x ) P ( f ( x ) = 1 ∣ x )
两边同乘e H ( x ) P ( f ( x ) = − 1 ∣ x ) \frac{e^{H(\boldsymbol{x})}}{P(f(\boldsymbol{x})=-1 \mid \boldsymbol{x})} P ( f ( x ) = − 1 ∣ x ) e H ( x )
e 2 H ( x ) = P ( f ( x ) = 1 ∣ x ) P ( f ( x ) = − 1 ∣ x ) \quad e^{2 H(\boldsymbol{x})}=\frac{P(f(\boldsymbol{x})=1 \mid \boldsymbol{x})}{P(f(\boldsymbol{x})=-1 \mid \boldsymbol{x})} e 2 H ( x ) = P ( f ( x ) = − 1 ∣ x ) P ( f ( x ) = 1 ∣ x )
取 ln ( ⋅ ) \ln (\cdot) ln ( ⋅ )
2 H ( x ) = ln P ( f ( x ) = 1 ∣ x ) P ( f ( x ) = − 1 ∣ x ) \quad 2 H(\boldsymbol{x})=\ln \frac{P(f(\boldsymbol{x})=1 \mid \boldsymbol{x})}{P(f(\boldsymbol{x})=-1 \mid \boldsymbol{x})} 2 H ( x ) = ln P ( f ( x ) = − 1 ∣ x ) P ( f ( x ) = 1 ∣ x )
两边同乘 1 2 \frac{1}{2} 2 1
8.2.5 式(8.8)的推导
sign ( H ( x ) ) = sign ( 1 2 ln P ( f ( x ) = 1 ∣ x ) P ( f ( x ) = − 1 ∣ x ) ) = { 1 , P ( f ( x ) = 1 ∣ x ) > P ( f ( x ) = − 1 ∣ x ) − 1 , P ( f ( x ) = 1 ∣ x ) < P ( f ( x ) = − 1 ∣ x ) = arg max y ∈ { − 1 , 1 } P ( f ( x ) = y ∣ x ) \begin{aligned}
\operatorname{sign}(H(\boldsymbol{x}))&=\operatorname{sign}\left(\frac{1}{2} \ln \frac{P(f(x)=1 | \boldsymbol{x})}{P(f(x)=-1 | \boldsymbol{x})}\right)
\\ & =\left\{\begin{array}{ll}{1,} & {P(f(x)=1 | \boldsymbol{x})>P(f(x)=-1 | \boldsymbol{x})} \\ {-1,} & {P(f(x)=1 | \boldsymbol{x})<P(f(x)=-1 | \boldsymbol{x})}\end{array}\right.
\\ & =\underset{y \in\{-1,1\}}{\arg \max } P(f(x)=y | \boldsymbol{x})
\end{aligned} sign ( H ( x )) = sign ( 2 1 ln P ( f ( x ) = − 1∣ x ) P ( f ( x ) = 1∣ x ) ) = { 1 , − 1 , P ( f ( x ) = 1∣ x ) > P ( f ( x ) = − 1∣ x ) P ( f ( x ) = 1∣ x ) < P ( f ( x ) = − 1∣ x ) = y ∈ { − 1 , 1 } arg max P ( f ( x ) = y ∣ x )
第一行到第二行显然成立,第二行到第三行是利用了arg max \arg\max arg max arg max y ∈ { − 1 , 1 } P ( f ( x ) = y ∣ x ) \underset{y \in\{-1,1\}}{\arg \max } P(f(x)=y | \boldsymbol{x}) y ∈ { − 1 , 1 } arg max P ( f ( x ) = y ∣ x ) P ( f ( x ) = y ∣ x P(f(x)=y | \boldsymbol{x} P ( f ( x ) = y ∣ x y y y
这里解释一下贝叶斯错误率的概念。这来源于"西瓜书"P148的式(7.6)表示的贝叶斯最优分类器,可以发现式(8.8)的最终结果是式(7.6)的二分类特殊形式。
到此为止,本节证明了指数损失函数是分类任务原本0/1损失函数的一致的替代损失函数,而指数损失函数有更好的数学性质,例如它是连续可微函数,因此接下来的式(8.9)至式(8.19)基于指数损失函数推导AdaBoost的理论细节。(替代损失函数参见"西瓜书"P131图6.5)
8.2.6 式(8.9)的推导
ℓ exp ( α t h t ∣ D t ) = E x ∼ D t [ e − f ( x ) α t h t ( x ) ] 1 ◯ = E x ∼ D t [ e − α t I ( f ( x ) = h t ( x ) ) + e α t I ( f ( x ) ≠ h t ( x ) ) ] 2 ◯ = e − α t P x ∼ D t ( f ( x ) = h t ( x ) ) + e α t P x ∼ D t ( f ( x ) ≠ h t ( x ) ) 3 ◯ = e − α t ( 1 − ϵ t ) + e α t ϵ t 4 ◯ \begin{aligned}
\ell_{\exp }\left(\alpha_{t} h_{t} | \mathcal{D}_{t}\right) &=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}\left[e^{-f(\boldsymbol{x}) \alpha_{t} h_{t}(\boldsymbol{x})}\right] &\textcircled{1}\\
&=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}\left[e^{-\alpha_{t}} \mathbb{I}\left(f(\boldsymbol{x})=h_{t}(\boldsymbol{x})\right)+e^{\alpha_{t}} \mathbb{I}\left(f(\boldsymbol{x}) \neq h_{t}(\boldsymbol{x})\right)\right] &\textcircled{2}\\
&=e^{-\alpha_{t}} P_{\boldsymbol{x} \sim \mathcal{D}_{t}}\left(f(\boldsymbol{x})=h_{t}(\boldsymbol{x})\right)+e^{\alpha_{t}} P_{\boldsymbol{x} \sim \mathcal{D}_{t}}\left(f(\boldsymbol{x}) \neq h_{t}(\boldsymbol{x})\right) &\textcircled{3}\\
&=e^{-\alpha_{t}}\left(1-\epsilon_{t}\right)+e^{\alpha_{t}} \epsilon_{t} &\textcircled{4}
\end{aligned} ℓ e x p ( α t h t ∣ D t ) = E x ∼ D t [ e − f ( x ) α t h t ( x ) ] = E x ∼ D t [ e − α t I ( f ( x ) = h t ( x ) ) + e α t I ( f ( x ) = h t ( x ) ) ] = e − α t P x ∼ D t ( f ( x ) = h t ( x ) ) + e α t P x ∼ D t ( f ( x ) = h t ( x ) ) = e − α t ( 1 − ϵ t ) + e α t ϵ t 1 ◯ 2 ◯ 3 ◯ 4 ◯
乍一看本式有些问题, 为什么要最小化ℓ exp ( α t h t ∣ D t ) \ell_{\exp }\left(\alpha_t h_t \mid \mathcal{D}_t\right) ℓ e x p ( α t h t ∣ D t ) h t = L ( D , D t ) h_t=\mathfrak{L}\left(D, \mathcal{D}_t\right) h t = L ( D , D t ) ℓ exp ( h t ∣ D t ) \ell_{\exp }\left(h_t \mid \mathcal{D}_t\right) ℓ e x p ( h t ∣ D t ) t t t ℓ exp ( H t ∣ D ) = ℓ exp ( H t − 1 + α t h t ∣ D ) \ell_{\exp }\left(H_t \mid \mathcal{D}\right)=\ell_{\exp }\left(H_{t-1}+\alpha_t h_t \mid \mathcal{D}\right) ℓ e x p ( H t ∣ D ) = ℓ e x p ( H t − 1 + α t h t ∣ D ) T T T ℓ exp ( H ∣ D ) \ell_{\exp }(H \mid \mathcal{D}) ℓ e x p ( H ∣ D ) ℓ exp ( α t h t ∣ D t ) \ell_{\exp }\left(\alpha_t h_t \mid \mathcal{D}_t\right) ℓ e x p ( α t h t ∣ D t ) ℓ exp ( H t ∣ D ) \ell_{\exp }\left(H_t \mid \mathcal{D}\right) ℓ e x p ( H t ∣ D ) h t = L ( D , D t ) h_t=\mathfrak{L}\left(D, \mathcal{D}_t\right) h t = L ( D , D t ) L ( D , D t ) \mathfrak{L}\left(D, \mathcal{D}_t\right) L ( D , D t ) h t h_t h t
暂且不管以上疑问, 权且按作者思路推导一下:
1 ◯ \textcircled{1} 1 ◯ α t h t ( x ) \alpha_t h_t(\boldsymbol{x}) α t h t ( x ) H ( x ) H(\boldsymbol{x}) H ( x )
2 ◯ \textcircled{2} 2 ◯ h t ( x ) h_t(\boldsymbol{x}) h t ( x ) f ( x ) f(\boldsymbol{x}) f ( x ) − 1 -1 − 1 + 1 +1 + 1 I ( ⋅ ) \mathbb{I}(\cdot) I ( ⋅ )
3 ◯ \textcircled{3} 3 ◯ E x ∼ D t [ ⋅ ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[\cdot] E x ∼ D t [ ⋅ ] e α t e^{\alpha_t} e α t e − α t e^{-\alpha_t} e − α t x \boldsymbol{x} x E x ∼ D t [ \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[ E x ∼ D t [ ] ] ] E x ∼ D t [ I ( f ( x ) = h t ( x ) ) ] \mathbb{E}_{\boldsymbol{x}\sim\mathcal{D}_t}\left[\mathbb{I}\left(f(\boldsymbol{x})=h_t(\boldsymbol{x})\right)\right] E x ∼ D t [ I ( f ( x ) = h t ( x ) ) ] D D D D t \mathcal{D}_t D t f ( x ) f(\boldsymbol{x}) f ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) P x ∼ D t ( f ( x ) = h t ( x ) ) P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(f(\boldsymbol{x})=h_t(\boldsymbol{x})\right) P x ∼ D t ( f ( x ) = h t ( x ) ) ( 1 − ϵ t ) \left(1-\epsilon_t\right) ( 1 − ϵ t ) E x ∼ D t [ I ( f ( x ) ≠ h t ( x ) ) ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}\left[\mathbb{I}\left(f(\boldsymbol{x}) \neq h_t(\boldsymbol{x})\right)\right] E x ∼ D t [ I ( f ( x ) = h t ( x ) ) ] D D D D t \mathcal{D}_t D t f ( x ) f(\boldsymbol{x}) f ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) P x ∼ D t ( f ( x ) ≠ h t ( x ) ) P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(f(\boldsymbol{x}) \neq h_t(\boldsymbol{x})\right) P x ∼ D t ( f ( x ) = h t ( x ) ) ϵ t \epsilon_t ϵ t
4 ◯ \textcircled{4} 4 ◯ P x ∼ D t ( f ( x ) = h t ( x ) ) P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(f(\boldsymbol{x})=h_t(\boldsymbol{x})\right) P x ∼ D t ( f ( x ) = h t ( x ) ) ( 1 − ϵ t ) \left(1-\epsilon_t\right) ( 1 − ϵ t ) P x ∼ D t ( f ( x ) ≠ h t ( x ) ) P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(f(\boldsymbol{x}) \neq h_t(\boldsymbol{x})\right) P x ∼ D t ( f ( x ) = h t ( x ) ) ϵ t \epsilon_t ϵ t
注意本节符号略有混乱, 如前所述式(8.4)的 H ( x ) H(\boldsymbol{x}) H ( x ) H ( x ) H(\boldsymbol{x}) H ( x ) − 1 -1 − 1 + 1 +1 + 1 H ( x ) H(\boldsymbol{x}) H ( x )
8.2.7 式(8.10)的解释
指数损失函数对α t \alpha_t α t α t \alpha_t α t
8.2.8 式(8.11)的推导
令公式(8.10)等于0移项即得到的该式。此时α t \alpha_t α t α t \alpha_t α t
8.2.9 式(8.12)的解释
本式的推导和原始论文[1]的推导略有差异,虽然并不影响后面式(8.18)以及式(8.19)的推导结果。AdaBoostt t t α t \alpha_t α t h t ( x ) h_t(\boldsymbol{x}) h t ( x )
( α t , h t ( x ) ) = arg min α , h ℓ exp ( H t − 1 + α h ∣ D ) \left(\alpha_t, h_t(\boldsymbol{x})\right)=\underset{\alpha, h}{\arg \min } \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ( α t , h t ( x ) ) = α , h arg min ℓ e x p ( H t − 1 + α h ∣ D )
对于该问题, 先对于固定的任意 α > 0 \alpha>0 α > 0 h t ( x ) h_t(\boldsymbol{x}) h t ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t ∘ \alpha_{t^{\circ}} α t ∘
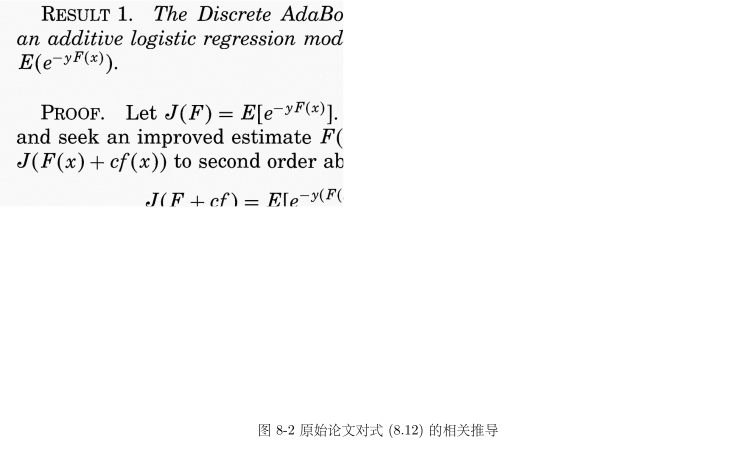
在原始论文的第346页,对式(8.12)的推导如图8-2所示,可以发现原文献中保留了参数 c c c α \alpha α α > 0 \alpha>0 α > 0
如果暂且不管以上的差异,我们按照作者的思路推导的话,将H t ( x ) = H t − 1 ( x ) + h t ( x ) H_{t}(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})+h_{t}(\boldsymbol{x}) H t ( x ) = H t − 1 ( x ) + h t ( x ) h t h_t h t H t − 1 H_{t-1} H t − 1 h t h_t h t α t \alpha_t α t α t \alpha_t α t
8.2.10 式(8.13)的推导
由e x e^x e x 1 + x + x 2 2 + o ( x 2 ) 1+x+\frac{x^2}{2}+o(x^2) 1 + x + 2 x 2 + o ( x 2 )
ℓ exp ( H t − 1 + h t ∣ D ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) e − f ( x ) h t ( x ) ] ≃ E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h t ( x ) + f 2 ( x ) h t 2 ( x ) 2 ) ] \begin{aligned}
\ell_{\exp }\left(H_{t-1}+h_{t} | \mathcal{D}\right) &=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} e^{-f(\boldsymbol{x}) h_{t}(\boldsymbol{x})}\right]
\\ & \simeq \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\left(1-f(\boldsymbol{x}) h_{t}(\boldsymbol{x})+\frac{f^{2}(\boldsymbol{x}) h_{t}^{2}(\boldsymbol{x})}{2}\right)\right]
\end{aligned} ℓ e x p ( H t − 1 + h t ∣ D ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) e − f ( x ) h t ( x ) ] ≃ E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h t ( x ) + 2 f 2 ( x ) h t 2 ( x ) ) ]
因为f ( x ) f(\boldsymbol{x}) f ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) f 2 ( x ) = h t 2 ( x ) = 1 f^2(\boldsymbol{x})=h_t^2(\boldsymbol{x})=1 f 2 ( x ) = h t 2 ( x ) = 1
ℓ exp ( H t − 1 + h t ∣ D ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h t ( x ) + 1 2 ) ] \ell_{\exp }\left(H_{t-1}+h_{t} | \mathcal{D}\right)= \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\left(1-f(\boldsymbol{x}) h_{t}(\boldsymbol{x})+\frac{1}{2}\right)\right] ℓ e x p ( H t − 1 + h t ∣ D ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h t ( x ) + 2 1 ) ]
实际上,此处保留一阶泰勒展开项即可,后面提到的Gradient
8.2.11 式(8.14)的推导
h t ( x ) = arg min h ℓ exp ( H t − 1 + h ∣ D ) 1 ◯ = arg min h E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h ( x ) + 1 2 ) ] 2 ◯ = arg max h E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] 3 ◯ = arg max h E x ∼ D [ e − f ( x ) H t − 1 ( x ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] f ( x ) h ( x ) ] 4 ◯ \begin{aligned}
h_{t}(\boldsymbol{x})&=\underset{h}{\arg \min } \ell_{\exp }\left(H_{t-1}+h | \mathcal{D}\right)&\textcircled{1}\\
&=\underset{h}{\arg \min } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\left(1-f(\boldsymbol{x}) h(\boldsymbol{x})+\frac{1}{2}\right)\right]&\textcircled{2}\\
&=\underset{h}{\arg \max } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right]&\textcircled{3}\\
&=\underset{h}{\arg \max } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\frac{e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]} f(\boldsymbol{x}) h(\boldsymbol{x})\right]&\textcircled{4}
\end{aligned} h t ( x ) = h arg min ℓ e x p ( H t − 1 + h ∣ D ) = h arg min E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h ( x ) + 2 1 ) ] = h arg max E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] = h arg max E x ∼ D [ E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] 1 ◯ 2 ◯ 3 ◯ 4 ◯
理想的h t ( x ) h_t(\boldsymbol{x}) h t ( x ) H t ( x ) H_{t}(\boldsymbol{x}) H t ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x )
2 ◯ \textcircled{2} 2 ◯
3 ◯ \textcircled{3} 3 ◯
E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h ( x ) + 1 2 ) ] = E x ∼ D [ 3 2 e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] = E x ∼ D [ 3 2 e − f ( x ) H t − 1 ( x ) ] − E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] \begin{aligned}
& \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\left(1-f(\boldsymbol{x}) h(\boldsymbol{x})+\frac{1}{2}\right)\right] \\
= & \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\frac{3}{2} e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right] \\
= & \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\frac{3}{2} e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]-\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right]
\end{aligned} = = E x ∼ D [ e − f ( x ) H t − 1 ( x ) ( 1 − f ( x ) h ( x ) + 2 1 ) ] E x ∼ D [ 2 3 e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] E x ∼ D [ 2 3 e − f ( x ) H t − 1 ( x ) ] − E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ]
本式自变量为 h ( x ) h(\boldsymbol{x}) h ( x ) E x ∼ D [ 3 2 e − f ( x ) H t − 1 ( x ) ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\frac{3}{2} e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right] E x ∼ D [ 2 3 e − f ( x ) H t − 1 ( x ) ] h ( x ) h(\boldsymbol{x}) h ( x )
− E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] -\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right] − E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ]
将负号去掉, 原最小化问题变为最大化问题;
4 ◯ \textcircled{4} 4 ◯ E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right] E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] h ( x ) h(\boldsymbol{x}) h ( x ) arg max x ( 1 − x 2 ) \arg \max _x\left(1-x^2\right) arg max x ( 1 − x 2 ) arg max x 2 ( 1 − x 2 ) \arg \max _x 2\left(1-x^2\right) arg max x 2 ( 1 − x 2 ) x = 0 ) \left.x=0\right) x = 0 )
8.2.12 式(8.16)的推导
首先解释下符号E x ∼ D \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}} E x ∼ D D D D D \mathcal{D} D D D D D \mathcal{D} D D D D D D D x x x D ( x ) \mathcal{D}(x) D ( x ) E x ∼ D \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}} E x ∼ D D \mathcal{D} D D D D D \mathcal{D} D
E ( g ( x ) ) = ∑ i = 1 ∣ D ∣ f ( x i ) g ( x i ) \mathbb{E}(g(\boldsymbol{x}))=\sum_{i=1}^{|D|}f(\boldsymbol{x}_i)g(\boldsymbol{x}_i) E ( g ( x )) = i = 1 ∑ ∣ D ∣ f ( x i ) g ( x i )
故可得
E x ∼ D [ e − f ( x ) H ( x ) ] = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H ( x i ) \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H(\boldsymbol{x})}\right]=\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_{i}\right) e^{-f\left(\boldsymbol{x}_{i}\right) H\left(\boldsymbol{x}_{i}\right)} E x ∼ D [ e − f ( x ) H ( x ) ] = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H ( x i )
由式(8.15)可知
D t ( x i ) = D ( x i ) e − f ( x i ) H t − 1 ( x i ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] \mathcal{D}_{t}\left(\boldsymbol{x}_{i}\right)=\mathcal{D}\left(\boldsymbol{x}_{i}\right) \frac{e^{-f\left(\boldsymbol{x}_{i}\right) H_{t-1}\left(\boldsymbol{x}_{i}\right)}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]} D t ( x i ) = D ( x i ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] e − f ( x i ) H t − 1 ( x i )
所以式(8.16)可以表示为
E x ∼ D [ e − f ( x ) H t − 1 ( x ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] f ( x ) h ( x ) ] = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] f ( x i ) h ( x i ) = ∑ i = 1 ∣ D ∣ D t ( x i ) f ( x i ) h ( x i ) = E x ∼ D t [ f ( x ) h ( x ) ] \begin{aligned} & \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\frac{e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]} f(\boldsymbol{x}) h(\boldsymbol{x})\right] \\=& \sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_{i}\right) \frac{e^{-f\left(\boldsymbol{x}_{i}\right) H_{t-1}\left(\boldsymbol{x}_{i}\right)}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x}) }] \right.}f(x_i)h(x_i) \\=& \sum_{i=1}^{|D|} \mathcal{D}_{t}\left(\boldsymbol{x}_{i}\right) f\left(\boldsymbol{x}_{i}\right) h\left(\boldsymbol{x}_{i}\right) \\=& \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}[f(\boldsymbol{x}) h(\boldsymbol{x})] \end{aligned} = = = E x ∼ D [ E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] i = 1 ∑ ∣ D ∣ D ( x i ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] e − f ( x i ) H t − 1 ( x i ) f ( x i ) h ( x i ) i = 1 ∑ ∣ D ∣ D t ( x i ) f ( x i ) h ( x i ) E x ∼ D t [ f ( x ) h ( x )]
8.2.13 式(8.17)的推导
当f ( x ) = h ( x ) f(\boldsymbol{x})=h(\boldsymbol{x}) f ( x ) = h ( x ) I ( f ( x ) ≠ h ( x ) ) = 0 \mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))=0 I ( f ( x ) = h ( x )) = 0 f ( x ) h ( x ) = 1 f(\boldsymbol{x}) h(\boldsymbol{x})=1 f ( x ) h ( x ) = 1 1 − 2 I ( f ( x ) ≠ h ( x ) ) = 1 1-2\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))=1 1 − 2 I ( f ( x ) = h ( x )) = 1
当f ( x ) ≠ h ( x ) f(\boldsymbol{x})\neq h(\boldsymbol{x}) f ( x ) = h ( x ) I ( f ( x ) ≠ h ( x ) ) = 1 \mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))=1 I ( f ( x ) = h ( x )) = 1 f ( x ) h ( x ) = − 1 f(\boldsymbol{x}) h(\boldsymbol{x})=-1 f ( x ) h ( x ) = − 1 1 − 2 I ( f ( x ) ≠ h ( x ) ) = − 1 1-2\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))=-1 1 − 2 I ( f ( x ) = h ( x )) = − 1
综上,左右两式相等。
8.2.14 式(8.18)的推导
本式基于式(8.17)的恒等关系,由式(8.16)推导而来。
E x ∼ D t [ f ( x ) h ( x ) ] = E x ∼ D t [ 1 − 2 I ( f ( x ) ≠ h ( x ) ) ] = E x ∼ D t [ 1 ] − 2 E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] = 1 − 2 E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] \begin{aligned} \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[f(\boldsymbol{x}) h(\boldsymbol{x})] & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[1-2 \mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))] \\ & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[1]-2 \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))] \\ & =1-2 \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))]\end{aligned} E x ∼ D t [ f ( x ) h ( x )] = E x ∼ D t [ 1 − 2 I ( f ( x ) = h ( x ))] = E x ∼ D t [ 1 ] − 2 E x ∼ D t [ I ( f ( x ) = h ( x ))] = 1 − 2 E x ∼ D t [ I ( f ( x ) = h ( x ))]
类似于式(8.14)的第3个和第4个等号,由式(8.16)的结果开始推导:
h t ( x ) = arg max h E x ∼ D t [ f ( x ) h ( x ) ] = arg max h ( 1 − 2 E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] ) = arg max h ( − 2 E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] ) = arg min E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] \begin{aligned}
h_{t}(\boldsymbol{x}) &=\arg \max _{h} \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}[f(\boldsymbol{x}) h(\boldsymbol{x})] \\
&=\arg \max _{h}\left(1-2 \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))]\right) \\
&=\underset{h}{\arg \max }\left(-2 \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))]\right) \\
&=\arg \min \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t}}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))]
\end{aligned} h t ( x ) = arg h max E x ∼ D t [ f ( x ) h ( x )] = arg h max ( 1 − 2 E x ∼ D t [ I ( f ( x ) = h ( x ))] ) = h arg max ( − 2 E x ∼ D t [ I ( f ( x ) = h ( x ))] ) = arg min E x ∼ D t [ I ( f ( x ) = h ( x ))]
此式表示理想的 h t ( x ) h_t(\boldsymbol{x}) h t ( x ) D t \mathcal{D}_t D t h t ( x ) = L ( D , D t ) h_t(\boldsymbol{x})=\mathfrak{L}\left(D, \mathcal{D}_t\right) h t ( x ) = L ( D , D t ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) D t \mathcal{D}_t D t D D D
8.2.15 式(8.19)的推导
D t + 1 ( x ) = D ( x ) e − f ( x ) H t ( x ) E x ∼ D [ e − f ( x ) H t ( x ) ] = D ( x ) e − f ( x ) H t − 1 ( x ) e − f ( x ) α t h t ( x ) E x ∼ D [ e − f ( x ) H t ( x ) ] = D t ( x ) ⋅ e − f ( x ) α t h t ( x ) E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] E x ∼ D [ e − f ( x ) H t ( x ) ] \begin{aligned}
\mathcal{D}_{t+1}(\boldsymbol{x}) &=\frac{\mathcal{D}(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H_{t}(\boldsymbol{x})}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t}(\boldsymbol{x})}\right]} \\
&=\frac{\mathcal{D}(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} e^{-f(\boldsymbol{x}) \alpha_{t} h_{t}(\boldsymbol{x})}}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t}(\boldsymbol{x})}\right]} \\
&=\mathcal{D}_{t}(\boldsymbol{x}) \cdot e^{-f(\boldsymbol{x}) \alpha_{t} h_{t}(\boldsymbol{x})} \frac{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t}(\boldsymbol{x})}\right]}
\end{aligned} D t + 1 ( x ) = E x ∼ D [ e − f ( x ) H t ( x ) ] D ( x ) e − f ( x ) H t ( x ) = E x ∼ D [ e − f ( x ) H t ( x ) ] D ( x ) e − f ( x ) H t − 1 ( x ) e − f ( x ) α t h t ( x ) = D t ( x ) ⋅ e − f ( x ) α t h t ( x ) E x ∼ D [ e − f ( x ) H t ( x ) ] E x ∼ D [ e − f ( x ) H t − 1 ( x ) ]
第 1 个等号是将式(8.15)中的 t t t t + 1 t+1 t + 1 t − 1 t-1 t − 1 t ) t) t )
第 2 个等号是将H t ( x ) = H t − 1 ( x ) + α t h t ( x ) H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})+\alpha_t h_t(\boldsymbol{x}) H t ( x ) = H t − 1 ( x ) + α t h t ( x )
第 3 个等号是乘以E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] \frac{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]}{\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\right]} E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] E x ∼ D [ e − f ( x ) H t − 1 ( x ) ] D t ( x ) \mathcal{D}_t(\boldsymbol{x}) D t ( x ) D t ( x ) \mathcal{D}_t(\boldsymbol{x}) D t ( x ) D t + 1 ( x ) \mathcal{D}_{t+1}(\boldsymbol{x}) D t + 1 ( x ) D t ( x ) \mathcal{D}_t(\boldsymbol{x}) D t ( x ) D t + 1 ( x ) \mathcal{D}_{t+1}(\boldsymbol{x}) D t + 1 ( x ) D t + 1 ( x ) \mathcal{D}_{t+1}(\boldsymbol{x}) D t + 1 ( x ) Z t Z_t Z t
boosting算法是根据调整后的样本再去训练下一个基分类器,这就是"重赋权法"的样本分布的调整公式。
8.2.16 AdaBoost的个人推导
西瓜书中对AdaBoost的推导和原论文[1]上有些地方有差异,综合原论文和一些参考资料,这里给出一版更易于理解的推导,亦可参见我们的视频教程。
AdaBoost 的目标是学得 T T T h t ( x ) h_t(\boldsymbol{x}) h t ( x ) T T T α t \alpha_t α t H ( x ) H(\boldsymbol{x}) H ( x ) ℓ exp ( H ∣ D ) \ell_{\exp }(H \mid \mathcal{D}) ℓ e x p ( H ∣ D ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t ( h t ( x ) = L ( D , D t ) \left(h_t(\boldsymbol{x})=\mathfrak{L}\left(D, \mathcal{D}_t\right)\right. ( h t ( x ) = L ( D , D t ) D t \mathcal{D}_t D t D D D h t h_t h t α t \alpha_t α t
"通常这是一个复杂的优化问题(同时学得 T T T h t ( x ) h_t(\boldsymbol{x}) h t ( x ) T T T α t \alpha_t α t h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t ℓ exp ( H ∣ D ) \ell_{\exp }(H \mid \mathcal{D}) ℓ e x p ( H ∣ D ) (摘自李航 《统计学习方法》[2] 第 144
页,略有改动)
因此, AdaBoost 每轮迭代只需要得到一个基分类器和其投票权重, 设第 t t t h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t H t ( x ) = H t − 1 ( x ) + α t h t ( x ) H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})+\alpha_t h_t(\boldsymbol{x}) H t ( x ) = H t − 1 ( x ) + α t h t ( x ) H 0 ( x ) = 0 H_0(\boldsymbol{x})=0 H 0 ( x ) = 0 h t ( x ) h_t(\boldsymbol{x}) h t ( x ) h t , H t ( x ) h_t, H_t(\boldsymbol{x}) h t , H t ( x ) H t H_t H t t t t 0 / 1 0 / 1 0/1
( α t , h t ) = arg min α , h ℓ exp ( H t − 1 + α h ∣ D ) \left(\alpha_t, h_t\right)=\underset{\alpha, h}{\arg \min } \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ( α t , h t ) = α , h arg min ℓ e x p ( H t − 1 + α h ∣ D )
表示每轮得到的基分类器 h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t H t = H t − 1 + α t h t H_t=H_{t-1}+\alpha_t h_t H t = H t − 1 + α t h t D D D D \mathcal{D} D D 1 \mathcal{D}_1 D 1 ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D )
ℓ exp ( H t − 1 + α h ∣ D ) = E x ∼ D [ e − f ( x ) ( H t − 1 ( x ) + α h ( x ) ) ] = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) ( H t − 1 ( x i ) + α h ( x i ) ) = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α h ( x i ) = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e − α I ( f ( x i ) = h ( x i ) ) + e α I ( f ( x i ) ≠ h ( x i ) ) ) \begin{aligned}
\ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x})\left(H_{t-1}(\boldsymbol{x})+\alpha h(\boldsymbol{x})\right)}\right] \\
& =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right)\left(H_{t-1}\left(\boldsymbol{x}_i\right)+\alpha h\left(\boldsymbol{x}_i\right)\right)} \\
& =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)} e^{-f\left(\boldsymbol{x}_i\right) \alpha h\left(\boldsymbol{x}_i\right)} \\
& =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)}\left(e^{-\alpha} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right)\right)+e^\alpha \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right)
\end{aligned} ℓ e x p ( H t − 1 + α h ∣ D ) = E x ∼ D [ e − f ( x ) ( H t − 1 ( x ) + α h ( x ) ) ] = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) ( H t − 1 ( x i ) + α h ( x i ) ) = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α h ( x i ) = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e − α I ( f ( x i ) = h ( x i ) ) + e α I ( f ( x i ) = h ( x i ) ) )
上式推导中, 由于 f ( x i ) f\left(\boldsymbol{x}_i\right) f ( x i ) h ( x i ) h\left(\boldsymbol{x}_i\right) h ( x i ) − 1 , + 1 -1,+1 − 1 , + 1 f ( x i ) = h ( x i ) f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right) f ( x i ) = h ( x i ) f ( x i ) h ( x i ) = 1 f\left(\boldsymbol{x}_i\right) h\left(\boldsymbol{x}_i\right)=1 f ( x i ) h ( x i ) = 1 f ( x i ) ≠ h ( x i ) f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right) f ( x i ) = h ( x i ) f ( x i ) h ( x i ) = − 1 f\left(\boldsymbol{x}_i\right) h\left(\boldsymbol{x}_i\right)=-1 f ( x i ) h ( x i ) = − 1 f ( x i ) f\left(\boldsymbol{x}_i\right) f ( x i ) h ( x i ) h\left(\boldsymbol{x}_i\right) h ( x i )
I ( f ( x i ) = h ( x i ) ) + I ( f ( x i ) ≠ h ( x i ) ) = 1 \mathbb{I}\left(f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right)\right)+\mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)=1 I ( f ( x i ) = h ( x i ) ) + I ( f ( x i ) = h ( x i ) ) = 1
所以
e − α I ( f ( x i ) = h ( x i ) ) + e α I ( f ( x i ) ≠ h ( x i ) ) = e − α I ( f ( x i ) = h ( x i ) ) + e − α I ( f ( x i ) ≠ h ( x i ) ) − e − α I ( f ( x i ) ≠ h ( x i ) ) + e α I ( f ( x i ) ≠ h ( x i ) ) = e − α ( I ( f ( x i ) = h ( x i ) ) + I ( f ( x i ) ≠ h ( x i ) ) ) + ( e α − e − α ) I ( f ( x i ) ≠ h ( x i ) ) = e − α + ( e α − e − α ) I ( f ( x i ) ≠ h ( x i ) ) \begin{aligned}
& e^{-\alpha} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right)\right)+e^\alpha \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
= & e^{-\alpha} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right)\right)+e^{-\alpha} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)-e^{-\alpha} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)+e^\alpha \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
= & e^{-\alpha}\left(\mathbb{I}\left(f\left(\boldsymbol{x}_i\right)=h\left(\boldsymbol{x}_i\right)\right)+\mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right)+\left(e^\alpha-e^{-\alpha}\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
= & e^{-\alpha}+\left(e^\alpha-e^{-\alpha}\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)
\end{aligned} = = = e − α I ( f ( x i ) = h ( x i ) ) + e α I ( f ( x i ) = h ( x i ) ) e − α I ( f ( x i ) = h ( x i ) ) + e − α I ( f ( x i ) = h ( x i ) ) − e − α I ( f ( x i ) = h ( x i ) ) + e α I ( f ( x i ) = h ( x i ) ) e − α ( I ( f ( x i ) = h ( x i ) ) + I ( f ( x i ) = h ( x i ) ) ) + ( e α − e − α ) I ( f ( x i ) = h ( x i ) ) e − α + ( e α − e − α ) I ( f ( x i ) = h ( x i ) )
将此结果代入ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D ) (注:
以下表达式后面求解权重 α t \alpha_t α t
ℓ exp ( H t − 1 + α h ∣ D ) = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e − α + ( e α − e − α ) I ( f ( x i ) ≠ h ( x i ) ) ) = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − α + ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e α − e − α ) I ( f ( x i ) ≠ h ( x i ) ) = e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) \begin{aligned}
\ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) & =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)}\left(e^{-\alpha}+\left(e^\alpha-e^{-\alpha}\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right) \\
& =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)} e^{-\alpha}+\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)}\left(e^\alpha-e^{-\alpha}\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
& =e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)+\left(e^\alpha-e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)
\end{aligned} ℓ e x p ( H t − 1 + α h ∣ D ) = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e − α + ( e α − e − α ) I ( f ( x i ) = h ( x i ) ) ) = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − α + i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) ( e α − e − α ) I ( f ( x i ) = h ( x i ) ) = e − α i = 1 ∑ ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) i = 1 ∑ ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) )
外面; 第一项e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) h ( x ) h(\boldsymbol{x}) h ( x ) α > 0 \alpha>0 α > 0 ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D ) h ( x ) h(\boldsymbol{x}) h ( x )
h t = arg min h ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) h_t=\underset{h}{\arg \min }\left(e^\alpha-e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) h t = h arg min ( e α − e − α ) i = 1 ∑ ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) )
对于任意 α > 0 \alpha>0 α > 0 e α − e − α > 0 e^\alpha-e^{-\alpha}>0 e α − e − α > 0 h ( x ) h(\boldsymbol{x}) h ( x )
h t = arg min h ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) h_t=\underset{h}{\arg \min } \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) h t = h arg min i = 1 ∑ ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) )
此即式(8.18)另一种表达形式。注意, 为了确保D t ′ ( x ) \mathcal{D}_t^{\prime}(\boldsymbol{x}) D t ′ ( x ) D t ( x ) = D t ′ ( x ) Z t \mathcal{D}_t(\boldsymbol{x})=\frac{\mathcal{D}_t^{\prime}(\boldsymbol{x})}{Z_t} D t ( x ) = Z t D t ′ ( x ) Z t = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) Z_t=\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) Z t = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) h t = L ( D , D t h_t=\mathfrak{L}\left(D, \mathcal{D}_t\right. h t = L ( D , D t t t t ("西瓜书"图 8.3 的第 3
行)
D t + 1 ( x i ) = D ( x i ) e − f ( x i ) H t ( x i ) = D ( x i ) e − f ( x i ) ( H t − 1 ( x i ) + α t h t ( x i ) ) = D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α t h t ( x i ) = D t ( x i ) e − f ( x i ) α t h t ( x i ) \begin{aligned}
\mathcal{D}_{t+1}\left(\boldsymbol{x}_i\right) & =\mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_t\left(\boldsymbol{x}_i\right)} \\
& =\mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right)\left(H_{t-1}\left(\boldsymbol{x}_i\right)+\alpha_t h_t\left(\boldsymbol{x}_i\right)\right)} \\
& =\mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)} e^{-f\left(\boldsymbol{x}_i\right) \alpha_t h_t\left(\boldsymbol{x}_i\right)} \\
& =\mathcal{D}_t\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) \alpha_t h_t\left(\boldsymbol{x}_i\right)}
\end{aligned} D t + 1 ( x i ) = D ( x i ) e − f ( x i ) H t ( x i ) = D ( x i ) e − f ( x i ) ( H t − 1 ( x i ) + α t h t ( x i ) ) = D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α t h t ( x i ) = D t ( x i ) e − f ( x i ) α t h t ( x i )
此即类似式(8.19)的分布权重更新公式。
现在只差权重 α t \alpha_t α t ℓ exp ( H t − 1 + α h t ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h t ∣ D )
∂ ℓ exp ( H t − 1 + α h t ∣ D ) ∂ α = ∂ ( e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) ) ∂ α = − e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α + e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) \begin{aligned}
\frac{\partial \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right)}{\partial \alpha} & =\frac{\partial\left(e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)+\left(e^\alpha-e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right)}{\partial \alpha} \\
& =-e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)+\left(e^\alpha+e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)
\end{aligned} ∂ α ∂ ℓ e x p ( H t − 1 + α h t ∣ D ) = ∂ α ∂ ( e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) ) = − e − α i = 1 ∑ ∣ D ∣ D t ′ ( x i ) + ( e α + e − α ) i = 1 ∑ ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) )
令导数等于零, 得
e − α e α + e − α = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) Z t I ( f ( x i ) ≠ h ( x i ) ) = ∑ i = 1 ∣ D ∣ D t ( x i ) I ( f ( x i ) ≠ h ( x i ) ) = E x ∼ D t [ I ( f ( x i ) ≠ h ( x i ) ) ] = ϵ t \begin{aligned}
\frac{e^{-\alpha}}{e^\alpha+e^{-\alpha}} & =\frac{\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)}{\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)}=\sum_{i=1}^{|D|} \frac{\mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)}{Z_t} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
& =\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}\left[\mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right] \\
& =\epsilon_t
\end{aligned} e α + e − α e − α = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) = i = 1 ∑ ∣ D ∣ Z t D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) = i = 1 ∑ ∣ D ∣ D t ( x i ) I ( f ( x i ) = h ( x i ) ) = E x ∼ D t [ I ( f ( x i ) = h ( x i ) ) ] = ϵ t
对上述等式化简, 得
e − α e α + e − α = 1 e 2 α + 1 ⇒ e 2 α + 1 = 1 ϵ t ⇒ e 2 α = 1 − ϵ t ϵ t ⇒ 2 α = ln ( 1 − ϵ t ϵ t ) ⇒ α t = 1 2 ln ( 1 − ϵ t ϵ t ) \begin{aligned}
\frac{e^{-\alpha}}{e^\alpha+e^{-\alpha}}=\frac{1}{e^{2 \alpha}+1} & \Rightarrow e^{2 \alpha}+1=\frac{1}{\epsilon_t} \Rightarrow e^{2 \alpha}=\frac{1-\epsilon_t}{\epsilon_t} \Rightarrow 2 \alpha=\ln \left(\frac{1-\epsilon_t}{\epsilon_t}\right) \\
& \Rightarrow \alpha_t=\frac{1}{2} \ln \left(\frac{1-\epsilon_t}{\epsilon_t}\right)
\end{aligned} e α + e − α e − α = e 2 α + 1 1 ⇒ e 2 α + 1 = ϵ t 1 ⇒ e 2 α = ϵ t 1 − ϵ t ⇒ 2 α = ln ( ϵ t 1 − ϵ t ) ⇒ α t = 2 1 ln ( ϵ t 1 − ϵ t )
即式(8.11)。 从该式可以发现, 当 ϵ t = 1 \epsilon_t=1 ϵ t = 1 α t → ∞ \alpha_t \rightarrow \infty α t → ∞ h t h_t h t
另外, 由以上指数损失函数ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D )
ℓ exp ( H t − 1 + α h ∣ D ) = ∑ i = 1 ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α h ( x i ) = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) e − f ( x i ) α h ( x i ) \begin{aligned}
\ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) & =\sum_{i=1}^{|D|} \mathcal{D}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) H_{t-1}\left(\boldsymbol{x}_i\right)} e^{-f\left(\boldsymbol{x}_i\right) \alpha h\left(\boldsymbol{x}_i\right)} \\
& =\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) \alpha h\left(\boldsymbol{x}_i\right)}
\end{aligned} ℓ e x p ( H t − 1 + α h ∣ D ) = i = 1 ∑ ∣ D ∣ D ( x i ) e − f ( x i ) H t − 1 ( x i ) e − f ( x i ) α h ( x i ) = i = 1 ∑ ∣ D ∣ D t ′ ( x i ) e − f ( x i ) α h ( x i )
这与指数损失函数ℓ exp ( α t h t ∣ D t ) \ell_{\exp }\left(\alpha_t h_t \mid \mathcal{D}_t\right) ℓ e x p ( α t h t ∣ D t )
ℓ exp ( α t h t ∣ D t ) = E x ∼ D t [ e − f ( x ) α t h t ( x ) ] = ∑ i = 1 ∣ D ∣ D t ( x i ) e − f ( x i ) α t h t ( x t ) \begin{aligned}
\ell_{\exp }\left(\alpha_t h_t \mid \mathcal{D}_t\right) & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}\left[e^{-f(\boldsymbol{x}) \alpha_t h_t(\boldsymbol{x})}\right] \\
& =\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) e^{-f\left(\boldsymbol{x}_i\right) \alpha_t h_t\left(\boldsymbol{x}_t\right)}
\end{aligned} ℓ e x p ( α t h t ∣ D t ) = E x ∼ D t [ e − f ( x ) α t h t ( x ) ] = i = 1 ∑ ∣ D ∣ D t ( x i ) e − f ( x i ) α t h t ( x t )
而 D t ′ ( x ) \mathcal{D}_t^{\prime}(\boldsymbol{x}) D t ′ ( x ) ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D ) ℓ exp ( H t − 1 + α h ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h ∣ D )
到此为止, 就逐一完成了"西瓜书"图8.3中第 3 行的 h t h_t h t α t \alpha_t α t D t \mathcal{D}_t D t
8.2.17 进一步理解权重更新公式
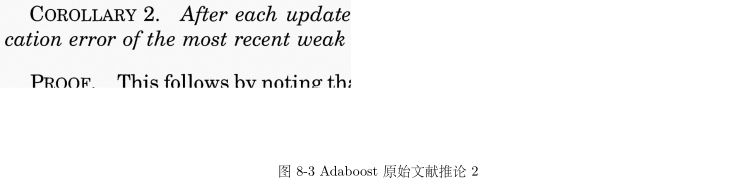
Adaboost原始文献[1]第 12 页(pdf显示第348页)有如下推论,如图8-3所示:
即P x ∼ D t ( h t − 1 ( x ) ≠ f ( x ) ) = 0.5 P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)=0.5 P x ∼ D t ( h t − 1 ( x ) = f ( x ) ) = 0.5 h t − 1 h_{t-1} h t − 1 D D D D t \mathcal{D}_t D t 0.5 0.5 0.5 0.5 0.5 0.5 h t h_t h t
h t = arg min h E x ∼ D t [ I ( f ( x ) ≠ h ( x ) ) ] = arg min h P x ∼ D t ( h ( x ) ≠ f ( x ) ) h_t=\underset{h}{\arg \min } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}[\mathbb{I}(f(\boldsymbol{x}) \neq h(\boldsymbol{x}))]=\underset{h}{\arg \min } P_{\boldsymbol{x} \sim \mathcal{D}_t}(h(\boldsymbol{x}) \neq f(\boldsymbol{x})) h t = h arg min E x ∼ D t [ I ( f ( x ) = h ( x ))] = h arg min P x ∼ D t ( h ( x ) = f ( x ))
即 h t h_t h t D D D D t \mathcal{D}_t D t D D D D t \mathcal{D}_t D t h t h_t h t h t − 1 h_{t-1} h t − 1 h t − 1 h_{t-1} h t − 1 h t h_t h t
对于 h t − 1 h_{t-1} h t − 1 ϵ t − 1 \epsilon_{t-1} ϵ t − 1
ϵ t − 1 = P x ∼ D t − 1 ( h t − 1 ( x ) ≠ f ( x ) ) = E x ∼ D t − 1 [ I ( h t − 1 ( x ) ≠ f ( x ) ) ] = ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) ≠ f ( x ) ) = ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) ≠ f ( x ) ) ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) = f ( x ) ) + ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) ≠ f ( x ) ) \begin{aligned}
\epsilon_{t-1} & =P_{\boldsymbol{x} \sim \mathcal{D}_{t-1}}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_{t-1}}\left[\mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)\right] \\
& =\sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right) \\
& =\frac{\sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)}{\sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}(\boldsymbol{x})=f(\boldsymbol{x})\right)+\sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)}
\end{aligned} ϵ t − 1 = P x ∼ D t − 1 ( h t − 1 ( x ) = f ( x ) ) = E x ∼ D t − 1 [ I ( h t − 1 ( x ) = f ( x ) ) ] = i = 1 ∑ ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) = f ( x ) ) = ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) = f ( x ) ) + ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) = f ( x ) ) ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x ) = f ( x ) )
在第 t t t Z t − 1 Z_{t-1} Z t − 1
D t = D t − 1 Z t − 1 e − f ( x ) α t − 1 h t − 1 ( x ) \mathcal{D}_t=\frac{\mathcal{D}_{t-1}}{Z_{t-1}} e^{-f(\boldsymbol{x}) \alpha_{t-1} h_{t-1}(\boldsymbol{x})} D t = Z t − 1 D t − 1 e − f ( x ) α t − 1 h t − 1 ( x )
其中根据式(8.11), 第 t − 1 t-1 t − 1
α t − 1 = 1 2 ln 1 − ϵ t − 1 ϵ t − 1 = ln 1 − ϵ t − 1 ϵ t − 1 \alpha_{t-1}=\frac{1}{2} \ln \frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}=\ln \sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} α t − 1 = 2 1 ln ϵ t − 1 1 − ϵ t − 1 = ln ϵ t − 1 1 − ϵ t − 1
代入 D t \mathcal{D}_t D t
D t = { D t − 1 Z t − 1 ⋅ ϵ t − 1 1 − ϵ t − 1 , if h t − 1 ( x ) = f ( x ) D t − 1 Z t − 1 ⋅ 1 − ϵ t − 1 ϵ t − 1 , if h t − 1 ( x ) ≠ f ( x ) \mathcal{D}_t= \begin{cases}\frac{\mathcal{D}_{t-1}}{Z_{t-1}} \cdot \sqrt{\frac{\epsilon_{t-1}}{1-\epsilon_{t-1}}} & \text {, if } h_{t-1}(\boldsymbol{x})=f(\boldsymbol{x}) \\ \frac{\mathcal{D}_{t-1}}{Z_{t-1}} \cdot \sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} & \text {, if } h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\end{cases} D t = ⎩ ⎨ ⎧ Z t − 1 D t − 1 ⋅ 1 − ϵ t − 1 ϵ t − 1 Z t − 1 D t − 1 ⋅ ϵ t − 1 1 − ϵ t − 1 , if h t − 1 ( x ) = f ( x ) , if h t − 1 ( x ) = f ( x )
那么 h t − 1 h_{t-1} h t − 1 D D D D t \mathcal{D}_t D t P x ∼ D t ( h t − 1 ( x ) ≠ f ( x ) P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right. P x ∼ D t ( h t − 1 ( x ) = f ( x ) I ( h t − 1 ( x ) = f ( x ) ) + I ( h t − 1 ( x ) ≠ f ( x ) ) = 1 \mathbb{I}\left(h_{t-1}(\boldsymbol{x})=f(\boldsymbol{x})\right)+\mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)=1 I ( h t − 1 ( x ) = f ( x ) ) + I ( h t − 1 ( x ) = f ( x ) ) = 1
P x ∼ D t ( h t − 1 ( x ) ≠ f ( x ) ) = E x ∼ D t [ I ( h t − 1 ( x ) ≠ f ( x ) ) ] = ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) ≠ f ( x i ) ) ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) + ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) ≠ f ( x i ) ) = ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) Z t − 1 ⋅ 1 − ϵ t − 1 ϵ t − 1 I ( h t − 1 ( x i ) ≠ f ( x i ) ) ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) Z t − 1 ⋅ ϵ t − 1 1 − ϵ t − 1 I ( h t − 1 ( x i ) = f ( x i ) ) + ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) Z t − 1 ⋅ 1 − ϵ t − 1 ϵ t − 1 I ( h t − 1 ( x i ) ≠ f ( x i ) ) = 1 − ϵ t − 1 ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) ≠ f ( x i ) ) ϵ t − 1 1 − ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) + 1 − ϵ t − 1 ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) ≠ f ( x i ) ) = 1 − ϵ t − 1 ϵ t − 1 ⋅ ϵ t − 1 ϵ t − 1 1 − ϵ t − 1 ⋅ ( 1 − ϵ t − 1 ) + 1 − ϵ t − 1 ϵ t − 1 ⋅ ϵ t − 1 = 1 2 \begin{aligned}
& P_{\boldsymbol{x} \sim \mathcal{D}_t}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}\left[\mathbb{I}\left(h_{t-1}(\boldsymbol{x}) \neq f(\boldsymbol{x})\right)\right] \\
& =\frac{\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)}{\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right)=f\left(\boldsymbol{x}_i\right)\right)+\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)} \\
& =\frac{\sum_{i=1}^{|D|} \frac{\mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right)}{Z_{t-1}} \cdot \sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)}{\sum_{i=1}^{|D|} \frac{\mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right)}{Z_{t-1}} \cdot \sqrt{\frac{\epsilon_{t-1}}{1-\epsilon_{t-1}}} \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right)=f\left(\boldsymbol{x}_i\right)\right)+\sum_{i=1}^{|D|} \frac{\mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right)}{Z_{t-1}} \cdot \sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)} \\
& =\frac{\sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \cdot \sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)}{\sqrt{\frac{\epsilon_{t-1}}{1-\epsilon_{t-1}}} \cdot \sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right)=f\left(\boldsymbol{x}_i\right)\right)+\sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \cdot \sum_{i=1}^{|D|} \mathcal{D}_{t-1}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(h_{t-1}\left(\boldsymbol{x}_i\right) \neq f\left(\boldsymbol{x}_i\right)\right)} \\
& =\frac{\sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \cdot \epsilon_{t-1}}{\sqrt{\frac{\epsilon_{t-1}}{1-\epsilon_{t-1}}} \cdot\left(1-\epsilon_{t-1}\right)+\sqrt{\frac{1-\epsilon_{t-1}}{\epsilon_{t-1}}} \cdot \epsilon_{t-1}}=\frac{1}{2} \\
&
\end{aligned} P x ∼ D t ( h t − 1 ( x ) = f ( x ) ) = E x ∼ D t [ I ( h t − 1 ( x ) = f ( x ) ) ] = ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) + ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) ∑ i = 1 ∣ D ∣ D t ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) = ∑ i = 1 ∣ D ∣ Z t − 1 D t − 1 ( x i ) ⋅ 1 − ϵ t − 1 ϵ t − 1 I ( h t − 1 ( x i ) = f ( x i ) ) + ∑ i = 1 ∣ D ∣ Z t − 1 D t − 1 ( x i ) ⋅ ϵ t − 1 1 − ϵ t − 1 I ( h t − 1 ( x i ) = f ( x i ) ) ∑ i = 1 ∣ D ∣ Z t − 1 D t − 1 ( x i ) ⋅ ϵ t − 1 1 − ϵ t − 1 I ( h t − 1 ( x i ) = f ( x i ) ) = 1 − ϵ t − 1 ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) + ϵ t − 1 1 − ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) ϵ t − 1 1 − ϵ t − 1 ⋅ ∑ i = 1 ∣ D ∣ D t − 1 ( x i ) I ( h t − 1 ( x i ) = f ( x i ) ) = 1 − ϵ t − 1 ϵ t − 1 ⋅ ( 1 − ϵ t − 1 ) + ϵ t − 1 1 − ϵ t − 1 ⋅ ϵ t − 1 ϵ t − 1 1 − ϵ t − 1 ⋅ ϵ t − 1 = 2 1
8.2.18 能够接受带权样本的基学习算法
在Adaboost算法的推导过程中,我们发现能够接受并利用带权样本的算法才能很好的嵌入到Adaboost的框架中作为基学习器。因此这里举一些能够接受带权样本的基学习算法的例子,分别是SVM和基于随机梯度下降(SGD)的对率回归:
其实原理很简单: 对于 SVM 来说, 针对"西瓜书" P130ℓ 0 / 1 ( y i ( w T x i + b ) − 1 ) \ell_{0 / 1}\left(y_i\left(\boldsymbol{w}^{\mathrm{T}} \boldsymbol{x}_i+b\right)-1\right) ℓ 0/1 ( y i ( w T x i + b ) − 1 ) D ( x i ) = 1 m \mathcal{D}\left(\boldsymbol{x}_i\right)=\frac{1}{m} D ( x i ) = m 1 m m m D D D D t ( x i ) \mathcal{D}_t\left(\boldsymbol{x}_i\right) D t ( x i )
∑ i = 1 m m D t ( x i ) ⋅ ℓ 0 / 1 ( y i ( w T x i + b ) − 1 ) \sum_{i=1}^m m \mathcal{D}_t\left(\boldsymbol{x}_i\right) \cdot \ell_{0 / 1}\left(y_i\left(\boldsymbol{w}^{\mathrm{T}} \boldsymbol{x}_i+b\right)-1\right) i = 1 ∑ m m D t ( x i ) ⋅ ℓ 0/1 ( y i ( w T x i + b ) − 1 )
若将 D ( x i ) = 1 m \mathcal{D}\left(\boldsymbol{x}_i\right)=\frac{1}{m} D ( x i ) = m 1 D t ( x i ) \mathcal{D}_t\left(\boldsymbol{x}_i\right) D t ( x i ) ℓ 0 / 1 ( y i ( w T x i + b ) − 1 ) \ell_{0 / 1}\left(y_i\left(\boldsymbol{w}^{\mathrm{T}} \boldsymbol{x}_i+b\right)-1\right) ℓ 0/1 ( y i ( w T x i + b ) − 1 ) C = α i + μ i C=\alpha_i+\mu_i C = α i + μ i
C ⋅ m D t ( x i ) = α i + μ i C \cdot m \mathcal{D}_t\left(\boldsymbol{x}_i\right)=\alpha_i+\mu_i C ⋅ m D t ( x i ) = α i + μ i
进而由 α i , μ i ≥ 0 \alpha_i, \mu_i \geq 0 α i , μ i ≥ 0 0 ≤ α i ≤ C ⋅ m D t ( x i ) 0 \leq \alpha_i \leq C \cdot m \mathcal{D}_t\left(\boldsymbol{x}_i\right) 0 ≤ α i ≤ C ⋅ m D t ( x i )
对于基于随机梯度下降(SGD)的对率回归, 每次随机选择一个样本进行梯度下降,D ( x i ) = 1 m \mathcal{D}\left(\boldsymbol{x}_i\right)=\frac{1}{m} D ( x i ) = m 1 D t ( x i ) \mathcal{D}_t\left(\boldsymbol{x}_i\right) D t ( x i ) S V M \mathrm{SVM} SVM i i i m D t ( x i ) m \mathcal{D}_t\left(\boldsymbol{x}_i\right) m D t ( x i ) D t ( x i ) \mathcal{D}_t\left(\boldsymbol{x}_i\right) D t ( x i ) x i \boldsymbol{x}_i x i
注意, 这里总的损失中出现了样本个数 m m m 1 m \frac{1}{m} m 1 m m m C C C m m m
当然, 正如"西瓜书" P177 第三段中所说, "对无法接受带权样本的基学习算法,
8.3 Bagging与随机森林
8.3.1 式(8.20)的解释
I ( h t ( x ) = y ) \mathbb{I}\left(h_{t}(\boldsymbol{x})=y\right) I ( h t ( x ) = y ) T \mathrm{T} T y y y y y y − 1 -1 − 1 1 1 1 y y y I ( h t ( x ) = y ) = 1 \mathbb{I}\left(h_{t}(\boldsymbol{x})=y\right)=1 I ( h t ( x ) = y ) = 1 I ( x ∉ D t ) = 1 \mathbb{I}\left(\boldsymbol{x} \notin D_{t}\right)=1 I ( x ∈ / D t ) = 1
8.3.2 式(8.21)的推导
由式(8.20)知,H o o b ( x ) H^{\mathrm{oob}}(\boldsymbol{x}) H oob ( x ) D ∣ D \mid D ∣ D D D T T T D D D 0.632 0.632 0.632 T T T 0.632 T 0.632^T 0.63 2 T T = 5 T=5 T = 5 0.632 T ≈ 0.1 0.632^T \approx 0.1 0.63 2 T ≈ 0.1 T = 10 T=10 T = 10 0.632 T ≈ 0.01 0.632^T \approx 0.01 0.63 2 T ≈ 0.01 T T T D D D
8.3.3 随机森林的解释
在8.3.2节开篇第一句话就解释了随机森林的概念:随机森林是Bagging的一个扩展变体,是以决策树为基学习器构建Bagging集成的基础上,进一步在决策树的训练过程中引入了随机属性选择。
完整版随机森林当然更复杂,这时只须知道两个重点:(1)
8.4 结合策略
8.4.1 式(8.22)的解释
H ( x ) = 1 T ∑ i = 1 T h i ( x ) H(\boldsymbol{x})=\frac{1}{T} \sum_{i=1}^{T} h_{i}(\boldsymbol{x}) H ( x ) = T 1 i = 1 ∑ T h i ( x )
对基分类器的结果进行简单的平均。
8.4.2 式(8.23)的解释
H ( x ) = ∑ i = 1 T w i h i ( x ) H(\boldsymbol{x})=\sum_{i=1}^{T} w_{i} h_{i}(\boldsymbol{x}) H ( x ) = i = 1 ∑ T w i h i ( x )
对基分类器的结果进行加权平均。
8.4.3 硬投票和软投票的解释
"西瓜书"中第183页提到了硬投票(hard voting)和软投票(soft
8.4.4 式(8.24)的解释
H ( x ) = { c j , if ∑ i = 1 T h i j ( x ) > 0.5 ∑ k = 1 N ∑ i = 1 T h i k ( x ) reject, otherwise. H(\boldsymbol{x})=\left\{\begin{array}{ll}
{c_{j},} & {\text { if } \sum_{i=1}^{T} h_{i}^{j}(\boldsymbol{x})>0.5 \sum_{k=1}^{N} \sum_{i=1}^{T} h_{i}^{k}(\boldsymbol{x})} \\
{\text { reject, }} & {\text { otherwise. }}
\end{array}\right. H ( x ) = { c j , reject, if ∑ i = 1 T h i j ( x ) > 0.5 ∑ k = 1 N ∑ i = 1 T h i k ( x ) otherwise.
当某一个类别j j j 1 2 \frac {1}{2} 2 1 j j j
8.4.5 式(8.25)的解释
H ( x ) = c arg max j ∑ i = 1 T h i j ( x ) H(\boldsymbol{x})=c_{\underset{j}{ \arg \max} \sum_{i=1}^{T} h_{i}^{j}(\boldsymbol{x})} H ( x ) = c j a r g m a x ∑ i = 1 T h i j ( x )
相比于其他类别,该类别j j j j j j
8.4.6 式(8.26)的解释
H ( x ) = c arg max j ∑ i = 1 T w i h i j ( x ) H(\boldsymbol{x})=c_{\underset{j}{ \arg \max} \sum_{i=1}^{T} w_i h_{i}^{j}(\boldsymbol{x})} H ( x ) = c j a r g m a x ∑ i = 1 T w i h i j ( x )
相比于其他类别,该类别j j j j j j
书中第183页最后一行提到了元学习器(meta-learner),简单解释一下,因为理解meta的含义有时对于理解论文中的核心思想很有帮助。
元(meta),非常抽象,例如此处的含义,即次级学习器,或者说基于学习器结果的学习器;另外还有元语言,就是描述计算机语言的语言,还有元数学,研究数学的数学等等;
另外,论文中经常出现的还有meta-strategy,即元策略或元方法,比如说你的研究问题是多分类问题,那么你提出了一种方法,例如对输入特征进行变换(或对输出类别做某种变换),然后再基于普通的多分类方法进行预测,这时你的方法可以看成是一种通用的框架,它虽然针对多分类问题开发,但它需要某个具体多分类方法配合才能实现,那么这样的方法是一种更高层级的方法,可以称为是一种meta-strategy。
8.4.8 Stacking算法的解释
该算法其实非常简单,对于数据集,试想你现在有了
本节名为"结合策略",告诉你各种结合方法,但其实最简单的方法就是基于这
"西瓜书"图8.9伪代码第9行中将第个样本进行变换,特征为个基学习器的输出,类别标记仍为原来的
至于说"西瓜书"图8.9中伪代码第1行到第3行使用的数据集与第5行到第10行使用的数据集之间的关系,在"西瓜书"图8.9下方的一段话有详细的讨论,不再赘述。
8.5 多样性
8.5.1 式(8.27)的解释
A ( h i ∣ x ) = ( h i ( x ) − H ( x ) ) 2 A\left(h_{i} | \boldsymbol{x}\right)=\left(h_{i}(\boldsymbol{x})-H(\boldsymbol{x})\right)^{2} A ( h i ∣ x ) = ( h i ( x ) − H ( x ) ) 2
该式表示个体学习器结果与预测结果的差值的平方,即为个体学习器的"分歧"。
8.5.2 式(8.28)的解释
A ˉ ( h ∣ x ) = ∑ i = 1 T w i A ( h i ∣ x ) = ∑ i = 1 T w i ( h i ( x ) − H ( x ) ) 2 \begin{aligned}
\bar{A}(h | \boldsymbol{x}) &=\sum_{i=1}^{T} w_{i} A\left(h_{i} | \boldsymbol{x}\right) \\
&=\sum_{i=1}^{T} w_{i}\left(h_{i}(\boldsymbol{x})-H(\boldsymbol{x})\right)^{2}
\end{aligned} A ˉ ( h ∣ x ) = i = 1 ∑ T w i A ( h i ∣ x ) = i = 1 ∑ T w i ( h i ( x ) − H ( x ) ) 2
该式表示对各个个体学习器的"分歧"加权平均的结果,即集成的"分歧"。
8.5.3 式(8.29)的解释
E ( h i ∣ x ) = ( f ( x ) − h i ( x ) ) 2 E\left(h_{i} | \boldsymbol{x}\right)=\left(f(\boldsymbol{x})-h_{i}(\boldsymbol{x})\right)^{2} E ( h i ∣ x ) = ( f ( x ) − h i ( x ) ) 2
该式表示个体学习器与真实值之间差值的平方,即个体学习器的平方误差。
8.5.4 式(8.30)的解释
E ( H ∣ x ) = ( f ( x ) − H ( x ) ) 2 E(H | \boldsymbol{x})=(f(\boldsymbol{x})-H(\boldsymbol{x}))^{2} E ( H ∣ x ) = ( f ( x ) − H ( x ) ) 2
该式表示集成与真实值之间差值的平方,即集成的平方误差。
8.5.5 式(8.31)的推导
由(8.28)知
A ˉ ( h ∣ x ) = ∑ i = 1 T w i ( h i ( x ) − H ( x ) ) 2 = ∑ i = 1 T w i ( h i ( x ) 2 − 2 h i ( x ) H ( x ) + H ( x ) 2 ) = ∑ i = 1 T w i h i ( x ) 2 − H ( x ) 2 \begin{aligned}
\bar{A}(h | \boldsymbol{x})&=\sum_{i=1}^{T} w_{i}\left(h_{i}(\boldsymbol{x})-H(\boldsymbol{x})\right)^{2}\\
&=\sum_{i=1}^{T} w_{i}(h_i(\boldsymbol{x})^2-2h_i(\boldsymbol{x})H(\boldsymbol{x})+H(\boldsymbol{x})^2)\\
&=\sum_{i=1}^{T} w_{i}h_i(\boldsymbol{x})^2-H(\boldsymbol{x})^2
\end{aligned} A ˉ ( h ∣ x ) = i = 1 ∑ T w i ( h i ( x ) − H ( x ) ) 2 = i = 1 ∑ T w i ( h i ( x ) 2 − 2 h i ( x ) H ( x ) + H ( x ) 2 ) = i = 1 ∑ T w i h i ( x ) 2 − H ( x ) 2
又因为
∑ i = 1 T w i E ( h i ∣ x ) − E ( H ∣ x ) = ∑ i = 1 T w i ( f ( x ) − h i ( x ) ) 2 − ( f ( x ) − H ( x ) ) 2 = ∑ i = 1 T w i h i ( x ) 2 − H ( x ) 2 \begin{aligned}
& \sum_{i=1}^{T} w_{i} E\left(h_{i} | \boldsymbol{x}\right)-E(H | \boldsymbol{x})\\
&=\sum_{i=1}^{T} w_{i}\left(f(\boldsymbol{x})-h_{i}(\boldsymbol{x})\right)^{2}-(f(\boldsymbol{x})-H(\boldsymbol{x}))^{2}\\
&=\sum_{i=1}^{T} w_{i}h_i(\boldsymbol{x})^2-H(\boldsymbol{x})^{2}
\end{aligned} i = 1 ∑ T w i E ( h i ∣ x ) − E ( H ∣ x ) = i = 1 ∑ T w i ( f ( x ) − h i ( x ) ) 2 − ( f ( x ) − H ( x ) ) 2 = i = 1 ∑ T w i h i ( x ) 2 − H ( x ) 2
所以
A ˉ ( h ∣ x ) = ∑ i = 1 T w i E ( h i ∣ x ) − E ( H ∣ x ) \bar{A}(h | \boldsymbol{x}) =\sum_{i=1}^{T} w_{i} E\left(h_{i} | \boldsymbol{x}\right)-E(H | \boldsymbol{x}) A ˉ ( h ∣ x ) = i = 1 ∑ T w i E ( h i ∣ x ) − E ( H ∣ x )
8.5.6 式(8.32)的解释
∑ i = 1 T w i ∫ A ( h i ∣ x ) p ( x ) d x = ∑ i = 1 T w i ∫ E ( h i ∣ x ) p ( x ) d x − ∫ E ( H ∣ x ) p ( x ) d x \sum_{i=1}^{T} w_{i} \int A\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x}=\sum_{i=1}^{T} w_{i} \int E\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x}-\int E(H | \boldsymbol{x}) p(\boldsymbol{x}) d \boldsymbol{x} i = 1 ∑ T w i ∫ A ( h i ∣ x ) p ( x ) d x = i = 1 ∑ T w i ∫ E ( h i ∣ x ) p ( x ) d x − ∫ E ( H ∣ x ) p ( x ) d x
∫ A ( h i ∣ x ) p ( x ) d x \int A\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x} ∫ A ( h i ∣ x ) p ( x ) d x ∑ i = 1 T w i ∫ A ( h i ∣ x ) p ( x ) d x \sum_{i=1}^{T} w_{i} \int A\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x} ∑ i = 1 T w i ∫ A ( h i ∣ x ) p ( x ) d x x \boldsymbol{x} x A ˉ ( h ∣ x ) = E ˉ ( h ∣ x ) − E ( H ∣ x ) \bar{A}(h \mid \boldsymbol{x})=\bar{E}(h \mid \boldsymbol{x})-E(H \mid \boldsymbol{x}) A ˉ ( h ∣ x ) = E ˉ ( h ∣ x ) − E ( H ∣ x ) H ( x ) H(\boldsymbol{x}) H ( x )
将这个结论应用于全样本上, 即为式(8.32)。
例如A i = ∫ A ( h i ∣ x ) p ( x ) d x A_i=\int A\left(h_i \mid \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x} A i = ∫ A ( h i ∣ x ) p ( x ) d x x \boldsymbol{x} x p ( x ) p(\boldsymbol{x}) p ( x ) A i = ∑ x ∈ D A ( h i ∣ x ) p x A_i=\sum_{\boldsymbol{x} \in D} A\left(h_i \mid \boldsymbol{x}\right) p_{\boldsymbol{x}} A i = ∑ x ∈ D A ( h i ∣ x ) p x
8.5.7 式(8.33)的解释
E i = ∫ E ( h i ∣ x ) p ( x ) d x E_{i}=\int E\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x} E i = ∫ E ( h i ∣ x ) p ( x ) d x
表示个体学习器在全样本上的泛化误差。
8.5.8 式(8.34)的解释
A i = ∫ A ( h i ∣ x ) p ( x ) d x A_{i}=\int A\left(h_{i} | \boldsymbol{x}\right) p(\boldsymbol{x}) d \boldsymbol{x} A i = ∫ A ( h i ∣ x ) p ( x ) d x
表示个体学习器在全样本上的分歧。
8.5.9 式(8.35)的解释
E = ∫ E ( H ∣ x ) p ( x ) d x E=\int E(H | \boldsymbol{x}) p(\boldsymbol{x}) d \boldsymbol{x} E = ∫ E ( H ∣ x ) p ( x ) d x
表示集成在全样本上的泛化误差。
8.5.10 式(8.36)的解释
E = E ˉ − A ˉ E=\bar{E}-\bar{A} E = E ˉ − A ˉ
E ˉ \bar{E} E ˉ A ˉ \bar{A} A ˉ
8.5.11 式(8.40)的解释
当 p 1 = p 2 p_1=p_2 p 1 = p 2 κ = 0 \kappa=0 κ = 0 p 1 = 1 p_1=1 p 1 = 1 κ = 1 \kappa=1 κ = 1 p 1 ⩾ p 2 p_1 \geqslant p_2 p 1 ⩾ p 2 κ ⩾ 0 \kappa \geqslant 0 κ ⩾ 0 p 1 < p 2 p_1<p_2 p 1 < p 2 κ < 0 \kappa<0 κ < 0 p 1 , p 2 p_1, p_2 p 1 , p 2
8.5.12 式(8.41)的解释
分子 a + d a+d a + d h i h_i h i h j h_j h j D D D D D D p 1 p_1 p 1 h i h_i h i h j h_j h j a + d = m a+d=m a + d = m h i h_i h i h j h_j h j D D D p 1 = 1 p_1=1 p 1 = 1
8.5.13 式(8.42)的解释
将式(8.42)拆分为如下形式,将会很容易理解其含义:
p 2 = a + b m ⋅ a + c m + c + d m ⋅ b + d m p_2=\frac{a+b}{m} \cdot \frac{a+c}{m}+\frac{c+d}{m} \cdot \frac{b+d}{m} p 2 = m a + b ⋅ m a + c + m c + d ⋅ m b + d
其中 a + b m \frac{a+b}{m} m a + b h i h_i h i + 1 +1 + 1 a + c m \frac{a+c}{m} m a + c h j h_j h j + 1 +1 + 1 a + b m ⋅ a + c m \frac{a+b}{m} \cdot \frac{a+c}{m} m a + b ⋅ m a + c h i h_i h i h j h_j h j + 1 +1 + 1 c + d m \frac{c+d}{m} m c + d h i h_i h i − 1 -1 − 1 b + d m \frac{b+d}{m} m b + d h j h_j h j − 1 -1 − 1 c + d m ⋅ b + d m \frac{c+d}{m} \cdot \frac{b+d}{m} m c + d ⋅ m b + d h i h_i h i h j h_j h j − 1 -1 − 1
注意 a + b m ⋅ a + c m \frac{a+b}{m} \cdot \frac{a+c}{m} m a + b ⋅ m a + c a m \frac{a}{m} m a c + d m ⋅ b + d m \frac{c+d}{m} \cdot \frac{b+d}{m} m c + d ⋅ m b + d d m \frac{d}{m} m d
a + b m ⋅ a + c m = p ( h i = + 1 ) p ( h j = + 1 ) , a m = p ( h i = + 1 , h j = + 1 ) c + d m ⋅ b + d m = p ( h i = − 1 ) p ( h j = − 1 ) , d m = p ( h i = − 1 , h j = − 1 ) \begin{aligned}
& \frac{a+b}{m} \cdot \frac{a+c}{m}=p\left(h_i=+1\right) p\left(h_j=+1\right), \frac{a}{m}=p\left(h_i=+1, h_j=+1\right) \\
& \frac{c+d}{m} \cdot \frac{b+d}{m}=p\left(h_i=-1\right) p\left(h_j=-1\right), \frac{d}{m}=p\left(h_i=-1, h_j=-1\right)
\end{aligned} m a + b ⋅ m a + c = p ( h i = + 1 ) p ( h j = + 1 ) , m a = p ( h i = + 1 , h j = + 1 ) m c + d ⋅ m b + d = p ( h i = − 1 ) p ( h j = − 1 ) , m d = p ( h i = − 1 , h j = − 1 )
即 a + b m ⋅ a + c m \frac{a+b}{m} \cdot \frac{a+c}{m} m a + b ⋅ m a + c c + d m ⋅ b + d m \frac{c+d}{m} \cdot \frac{b+d}{m} m c + d ⋅ m b + d h i h_i h i h j h_j h j h i h_i h i h j h_j h j a m \frac{a}{m} m a d m \frac{d}{m} m d h i h_i h i h j h_j h j
8.5.14 多样性增强的解释
在 8.5.3 节介绍了四种多样性增强的方法, 通俗易懂, 几乎不需要什么注解,
(1)数据样本扰动中提到了 "不稳定基学习器" (例如决策树、神经网络等) 和k k k
(2)"西瓜书"图8.11随机子空间算法, 针对每个基分类器 h t h_t h t ("西瓜书"图 8.11
最后一行) 也要使用相同的部分属性。
(3)输出表示扰动中提到了 "翻转法" (Flipping Output),
8.6 Gradient Boosting/GBDT/XGBoost联系与区别
在集成学习中,梯度提升(Gradient Boosting, GB)、梯度提升树(GB Decision
8.6.1 梯度下降法
(本部分内容参考了孙文瑜教授的最优化方法[4]) f ( x ) f(\boldsymbol{x}) f ( x ) x k \boldsymbol{x}_k x k ∇ f ( x k ) = ∇ f ( x ) ∇ x ∣ x = x k ≠ 0 \nabla f\left(\boldsymbol{x}_k\right)=\left.\frac{\nabla f(\boldsymbol{x})}{\nabla \boldsymbol{x}}\right|_{\boldsymbol{x}=\boldsymbol{x}_k} \neq 0 ∇ f ( x k ) = ∇ x ∇ f ( x ) x = x k = 0 f ( x ) f(\boldsymbol{x}) f ( x ) x k \boldsymbol{x}_k x k
f ( x ) ≈ f ( x k ) + ∇ f ( x k ) T ( x − x k ) f(\boldsymbol{x}) \approx f\left(\boldsymbol{x}_k\right)+\nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}}\left(\boldsymbol{x}-\boldsymbol{x}_k\right) f ( x ) ≈ f ( x k ) + ∇ f ( x k ) T ( x − x k )
记 x − x k = Δ x \boldsymbol{x}-\boldsymbol{x}_k=\Delta \boldsymbol{x} x − x k = Δ x
f ( x k + Δ x ) ≈ f ( x k ) + ∇ f ( x k ) T Δ x f\left(\boldsymbol{x}_k+\Delta \boldsymbol{x}\right) \approx f\left(\boldsymbol{x}_k\right)+\nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \Delta \boldsymbol{x} f ( x k + Δ x ) ≈ f ( x k ) + ∇ f ( x k ) T Δ x
显然, 若∇ f ( x k ) T Δ x < 0 \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \Delta \boldsymbol{x}<0 ∇ f ( x k ) T Δ x < 0 f ( x k + Δ x ) < f ( x k ) f\left(\boldsymbol{x}_k+\Delta \boldsymbol{x}\right)<f\left(\boldsymbol{x}_k\right) f ( x k + Δ x ) < f ( x k ) f ( x k ) f\left(\boldsymbol{x}_k\right) f ( x k ) Δ x \Delta \boldsymbol{x} Δ x f ( x ) f(\boldsymbol{x}) f ( x ) f ( x ) = f ( x k + Δ x ) f(\boldsymbol{x})=f\left(\boldsymbol{x}_k+\Delta \boldsymbol{x}\right) f ( x ) = f ( x k + Δ x ) Δ x \Delta \boldsymbol{x} Δ x ∇ f ( x k ) T Δ x \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \Delta \boldsymbol{x} ∇ f ( x k ) T Δ x ∇ f ( x k ) T Δ x < 0 \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \Delta \boldsymbol{x}<0 ∇ f ( x k ) T Δ x < 0 ∣ f ( x k ) T Δ x ∣ | f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \Delta \boldsymbol{x}| ∣ f ( x k ) T Δ x ∣ Δ x \Delta \boldsymbol{x} Δ x Δ x = α k d k \Delta \boldsymbol{x}=\alpha_k \boldsymbol{d}_k Δ x = α k d k d k \boldsymbol{d}_k d k α k > 0 \alpha_k>0 α k > 0 d k \boldsymbol{d}_k d k x \boldsymbol{x} x α k \alpha_k α k Δ x \Delta \boldsymbol{x} Δ x
( α k , d k ) = arg min α , d ∇ f ( x k ) T α d \left(\alpha_k, \boldsymbol{d}_k\right)=\underset{\alpha, \boldsymbol{d}}{\arg \min } \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \alpha \boldsymbol{d} ( α k , d k ) = α , d arg min ∇ f ( x k ) T α d
将以上优化问题分为两步求解, 即
d k = arg min d ∇ f ( x k ) T d s.t. ∥ d ∥ 2 = 1 α k = arg min α ∇ f ( x k ) T d k α \begin{gathered}
\boldsymbol{d}_k=\underset{\boldsymbol{d}}{\arg \min } \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d} \quad \text { s.t. }\|\boldsymbol{d}\|_2=1 \\
\alpha_k=\underset{\alpha}{\arg \min } \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d}_k \alpha
\end{gathered} d k = d arg min ∇ f ( x k ) T d s.t. ∥ d ∥ 2 = 1 α k = α arg min ∇ f ( x k ) T d k α
以上求解 α k \alpha_k α k ∇ f ( x k ) T d k < 0 \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d}_k<0 ∇ f ( x k ) T d k < 0 α k = + ∞ \alpha_k=+\infty α k = + ∞ α k \alpha_k α k
α k = arg min α f ( x k + α d k ) \alpha_k=\underset{\alpha}{\arg \min } f\left(\boldsymbol{x}_k+\alpha \boldsymbol{d}_k\right) α k = α arg min f ( x k + α d k )
对于凸函数来说, 以上两步可以得到最优解; 但对于非凸函数来说, 联合求解得到d k \boldsymbol{d}_k d k α k \alpha_k α k d k \boldsymbol{d}_k d k α k \alpha_k α k
∣ ∇ f ( x k ) T d k ∣ ≤ ∥ ∇ f ( x k ) ∥ 2 ∥ d k ∥ 2 \left|\nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d}_k\right| \leq\left\|\nabla f\left(\boldsymbol{x}_k\right)\right\|_2\left\|\boldsymbol{d}_k\right\|_2 ∇ f ( x k ) T d k ≤ ∥ ∇ f ( x k ) ∥ 2 ∥ d k ∥ 2
可知, 当且仅当d k = − ∇ f ( x k ) ∥ ∇ f ( x k ) ∥ 2 \boldsymbol{d}_k=-\frac{\nabla f\left(\boldsymbol{x}_k\right)}{\left\|\nabla f\left(\boldsymbol{x}_k\right)\right\|_2} d k = − ∥ ∇ f ( x k ) ∥ 2 ∇ f ( x k ) ∇ f ( x k ) T d k \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d}_k ∇ f ( x k ) T d k − ∇ f ( x k ) T d k -\nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d}_k − ∇ f ( x k ) T d k α k \alpha_k α k f ( x k + α d k ) f\left(\boldsymbol{x}_k+\alpha \boldsymbol{d}_k\right) f ( x k + α d k ) α \alpha α
∂ f ( x k + α d k ) ∂ α = 0 \frac{\partial f\left(\boldsymbol{x}_k+\alpha \boldsymbol{d}_k\right)}{\partial \alpha}=0 ∂ α ∂ f ( x k + α d k ) = 0
例 1: 试求 f ( x ) = x 2 f(x)=x^2 f ( x ) = x 2 x k = 2 x_k=2 x k = 2 d k d_k d k α k \alpha_k α k f ( x ) f(x) f ( x ) x k = 2 x_k=2 x k = 2
f ( x ) = f ( x k ) + f ′ ( x k ) ( x − x k ) = x k 2 + 2 x k ( x − x k ) = x k 2 + 2 x k α d \begin{aligned}
f(x) & =f\left(x_k\right)+f^{\prime}\left(x_k\right)\left(x-x_k\right) \\
& =x_k^2+2 x_k\left(x-x_k\right) \\
& =x_k^2+2 x_k \alpha d
\end{aligned} f ( x ) = f ( x k ) + f ′ ( x k ) ( x − x k ) = x k 2 + 2 x k ( x − x k ) = x k 2 + 2 x k α d
由于此时自变量为一维, 因此只有两个方向可选, 要么正方向,f ′ ( x k ) = 4 f^{\prime}\left(x_k\right)=4 f ′ ( x k ) = 4 d k = − f ′ ( x k ) ∣ f ′ ( x k ) ∣ = − 1 d_k=-\frac{f^{\prime}\left(x_k\right)}{\left|f^{\prime}\left(x_k\right)\right|}=-1 d k = − ∣ f ′ ( x k ) ∣ f ′ ( x k ) = − 1 α k \alpha_k α k x k x_k x k d k d_k d k
f ( x k + α d k ) = f ( 2 − α ) = ( 2 − α ) 2 f\left(x_k+\alpha d_k\right)=f(2-\alpha)=(2-\alpha)^2 f ( x k + α d k ) = f ( 2 − α ) = ( 2 − α ) 2
进而有
∂ f ( x k + α d k ) ∂ α = − 2 ( 2 − α ) \frac{\partial f\left(x_k+\alpha d_k\right)}{\partial \alpha}=-2(2-\alpha) ∂ α ∂ f ( x k + α d k ) = − 2 ( 2 − α )
令导数等于 0 , 得 α k = 2 \alpha_k=2 α k = 2
Δ x = α k d k = − 2 \Delta x=\alpha_k d_k=-2 Δ x = α k d k = − 2
则x k + Δ x = 0 x_k+\Delta x=0 x k + Δ x = 0 f ( x k + Δ x ) = 0 f\left(x_k+\Delta x\right)=0 f ( x k + Δ x ) = 0 f ( x ) = ∥ x ∥ 2 2 = x T x f(\boldsymbol{x})=\|\boldsymbol{x}\|_2^2=\boldsymbol{x}^{\mathrm{T}} \boldsymbol{x} f ( x ) = ∥ x ∥ 2 2 = x T x x k = [ x k 1 , x k 2 ] T = [ 3 , 4 ] T \boldsymbol{x}_k=\left[x_k^1, x_k^2\right]^{\mathrm{T}}=[3,4]^{\mathrm{T}} x k = [ x k 1 , x k 2 ] T = [ 3 , 4 ] T d k \boldsymbol{d}_k d k α k \alpha_k α k f ( x ) f(\boldsymbol{x}) f ( x ) x k = [ x k 1 , x k 2 ] T = [ 3 , 4 ] T \boldsymbol{x}_k=\left[x_k^1, x_k^2\right]^{\mathrm{T}}=[3,4]^{\mathrm{T}} x k = [ x k 1 , x k 2 ] T = [ 3 , 4 ] T
f ( x ) = f ( x k ) + ∇ f ( x k ) T ( x − x k ) = ∥ x ∥ 2 2 + 2 x k T ( x − x k ) = ∥ x ∥ 2 2 + 2 x k T α d \begin{aligned}
f(\boldsymbol{x}) & =f\left(\boldsymbol{x}_k\right)+\nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}}\left(\boldsymbol{x}-\boldsymbol{x}_k\right) \\
& =\|\boldsymbol{x}\|_2^2+2 \boldsymbol{x}_k^{\mathrm{T}}\left(\boldsymbol{x}-\boldsymbol{x}_k\right) \\
& =\|\boldsymbol{x}\|_2^2+2 \boldsymbol{x}_k^{\mathrm{T}} \alpha \boldsymbol{d}
\end{aligned} f ( x ) = f ( x k ) + ∇ f ( x k ) T ( x − x k ) = ∥ x ∥ 2 2 + 2 x k T ( x − x k ) = ∥ x ∥ 2 2 + 2 x k T α d
此时∇ f ( x k ) = [ 6 , 8 ] T \nabla f\left(\boldsymbol{x}_k\right)=[6,8]^{\mathrm{T}} ∇ f ( x k ) = [ 6 , 8 ] T d k = − ∇ f ( x k ) ∥ ∇ f ( x k ) ∥ 2 = [ − 0.6 , − 0.8 ] T \boldsymbol{d}_k=-\frac{\nabla f\left(\boldsymbol{x}_k\right)}{\left\|\nabla f\left(\boldsymbol{x}_k\right)\right\|_2}=[-0.6,-0.8]^{\mathrm{T}} d k = − ∥ ∇ f ( x k ) ∥ 2 ∇ f ( x k ) = [ − 0.6 , − 0.8 ] T α k \alpha_k α k x k \boldsymbol{x}_k x k d k \boldsymbol{d}_k d k
f ( x k + α d k ) = ( 3 − 0.6 α ) 2 + ( 4 − 0.8 α ) 2 = α 2 − 10 α + 25 = ( α − 5 ) 2 \begin{aligned}
f\left(\boldsymbol{x}_k+\alpha \boldsymbol{d}_k\right) & =(3-0.6 \alpha)^2+(4-0.8 \alpha)^2 \\
& =\alpha^2-10 \alpha+25 \\
& =(\alpha-5)^2
\end{aligned} f ( x k + α d k ) = ( 3 − 0.6 α ) 2 + ( 4 − 0.8 α ) 2 = α 2 − 10 α + 25 = ( α − 5 ) 2
因此可得 α k = 5 \alpha_k=5 α k = 5 α \alpha α
Δ x = α k d k = [ − 3 , − 4 ] T \Delta \boldsymbol{x}=\alpha_k \boldsymbol{d}_k=[-3,-4]^{\mathrm{T}} Δ x = α k d k = [ − 3 , − 4 ] T
则 x k + Δ x = [ 0 , 0 ] T \boldsymbol{x}_k+\Delta \boldsymbol{x}=[0,0]^{\mathrm{T}} x k + Δ x = [ 0 , 0 ] T f ( x k + Δ x ) = 0 f\left(\boldsymbol{x}_k+\Delta \boldsymbol{x}\right)=0 f ( x k + Δ x ) = 0 d k \boldsymbol{d}_k d k
d k = arg min d ∇ f ( x k ) T d s.t. ∥ d ∥ 2 = C \boldsymbol{d}_k=\underset{\boldsymbol{d}}{\arg \min } \nabla f\left(\boldsymbol{x}_k\right)^{\mathrm{T}} \boldsymbol{d} \text { s.t. }\|\boldsymbol{d}\|_2=C d k = d arg min ∇ f ( x k ) T d s.t. ∥ d ∥ 2 = C
其中 C C C ∥ d k ∥ 2 = 1 \left\|\boldsymbol{d}_k\right\|_2=1 ∥ d k ∥ 2 = 1 α k \alpha_k α k α k \alpha_k α k
α k = arg min α f ( x k + α d k ) \alpha_k=\underset{\alpha}{\arg \min } f\left(\boldsymbol{x}_k+\alpha \boldsymbol{d}_k\right) α k = α arg min f ( x k + α d k )
实际应用中, 很多时候不会去求最优的 α k \alpha_k α k
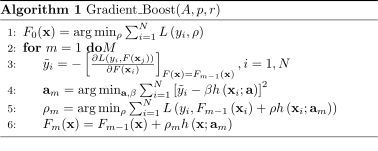
8.6.2 从梯度下降的角度解释AdaBoost
AdaBoost 第 t t t
ℓ exp ( H t ∣ D ) = E x ∼ D [ e − f ( x ) H t ( x ) ] = ∑ x ∈ D D ( x ) e − f ( x ) H t ( x ) \ell_{\exp }\left(H_t \mid \mathcal{D}\right)=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_t(\boldsymbol{x})}\right]=\sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H_t(\boldsymbol{x})} ℓ e x p ( H t ∣ D ) = E x ∼ D [ e − f ( x ) H t ( x ) ] = x ∈ D ∑ D ( x ) e − f ( x ) H t ( x )
对 ℓ exp ( H t ∣ D ) \ell_{\exp }\left(H_t \mid \mathcal{D}\right) ℓ e x p ( H t ∣ D ) H t − 1 H_{t-1} H t − 1
ℓ exp ( H t ∣ D ) ≈ ∑ x ∈ D D ( x ) ( e − f ( x ) H t − 1 ( x ) − f ( x ) e − f ( x ) H t − 1 ( x ) ( H t ( x ) − H t − 1 ( x ) ) ) = ∑ x ∈ D D ( x ) ( e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x ) ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x ) ] \begin{aligned}
\ell_{\exp }\left(H_t \mid \mathcal{D}\right) & \approx \sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x})\left(e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-f(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}\left(H_t(\boldsymbol{x})-H_{t-1}(\boldsymbol{x})\right)\right) \\
& =\sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x})\left(e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) \alpha_t h_t(\boldsymbol{x})\right) \\
& =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) \alpha_t h_t(\boldsymbol{x})\right]
\end{aligned} ℓ e x p ( H t ∣ D ) ≈ x ∈ D ∑ D ( x ) ( e − f ( x ) H t − 1 ( x ) − f ( x ) e − f ( x ) H t − 1 ( x ) ( H t ( x ) − H t − 1 ( x ) ) ) = x ∈ D ∑ D ( x ) ( e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x ) ) = E x ∼ D [ e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x ) ]
其中 H t = H t − 1 + α t h t H_t=H_{t-1}+\alpha_t h_t H t = H t − 1 + α t h t α t , h t \alpha_t, h_t α t , h t t t t H t ( x ) H_t(\boldsymbol{x}) H t ( x ) H t − 1 H_{t-1} H t − 1
∂ e − f ( x ) H t ( x ) ∂ H t ( x ) ∣ H t ( x ) = H t − 1 ( x ) = − f ( x ) e − f ( x ) H t − 1 ( x ) \left.\frac{\partial e^{-f(\boldsymbol{x}) H_t(\boldsymbol{x})}}{\partial H_t(\boldsymbol{x})}\right|_{H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})}=-f(\boldsymbol{x}) e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} ∂ H t ( x ) ∂ e − f ( x ) H t ( x ) H t ( x ) = H t − 1 ( x ) = − f ( x ) e − f ( x ) H t − 1 ( x )
如果看不习惯上述泰勒展开过程, 可令变量 z = H t ( x ) z=H_t(\boldsymbol{x}) z = H t ( x ) g ( z ) = e − f ( x ) z g(z)=e^{-f(\boldsymbol{x}) z} g ( z ) = e − f ( x ) z g ( z ) g(z) g ( z ) z 0 = H t − 1 ( x ) z_0=H_{t-1}(\boldsymbol{x}) z 0 = H t − 1 ( x )
g ( z ) ≈ g ( z 0 ) + g ′ ( z 0 ) ( z − z 0 ) = g ( z 0 ) − f ( x ) e − f ( x ) z 0 ( z − z 0 ) = e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) ( H t ( x ) − H t − 1 ( x ) ) = e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x ) \begin{aligned}
g(z) & \approx g\left(z_0\right)+g^{\prime}\left(z_0\right)\left(z-z_0\right) \\
& =g\left(z_0\right)-f(\boldsymbol{x}) e^{-f(\boldsymbol{x}) z_0}\left(z-z_0\right) \\
& =e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x})\left(H_t(\boldsymbol{x})-H_{t-1}(\boldsymbol{x})\right) \\
& =e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})}-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) \alpha_t h_t(\boldsymbol{x})
\end{aligned} g ( z ) ≈ g ( z 0 ) + g ′ ( z 0 ) ( z − z 0 ) = g ( z 0 ) − f ( x ) e − f ( x ) z 0 ( z − z 0 ) = e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) ( H t ( x ) − H t − 1 ( x ) ) = e − f ( x ) H t − 1 ( x ) − e − f ( x ) H t − 1 ( x ) f ( x ) α t h t ( x )
注意此处 h t ( x ) ∈ { − 1 , + 1 } h_t(\boldsymbol{x}) \in\{-1,+1\} h t ( x ) ∈ { − 1 , + 1 } ∥ d t ∥ = 1 \left\|\boldsymbol{d}^t\right\|=1 d t = 1 d t \boldsymbol{d}^t d t h t h_t h t α t \alpha_t α t
h t = arg min h ∑ x ∈ D D ( x ) ( − e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ) s.t. h ( x ) ∈ { − 1 , + 1 } h_t=\underset{h}{\arg \min } \sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x})\left(-e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right) \quad \text { s.t. } h(\boldsymbol{x}) \in\{-1,+1\} h t = h arg min x ∈ D ∑ D ( x ) ( − e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ) s.t. h ( x ) ∈ { − 1 , + 1 }
将负号去掉, 最小化变为最大化问题
h t = arg max h ∑ x ∈ D D ( x ) ( e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ) = arg max h E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] s.t. h ( x ) ∈ { − 1 , + 1 } \begin{aligned}
h_t & =\underset{h}{\arg \max } \sum_{\boldsymbol{x} \in D} \mathcal{D}(\boldsymbol{x})\left(e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right) \\
& =\underset{h}{\arg \max } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[e^{-f(\boldsymbol{x}) H_{t-1}(\boldsymbol{x})} f(\boldsymbol{x}) h(\boldsymbol{x})\right] \quad \text { s.t. } h(\boldsymbol{x}) \in\{-1,+1\}
\end{aligned} h t = h arg max x ∈ D ∑ D ( x ) ( e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ) = h arg max E x ∼ D [ e − f ( x ) H t − 1 ( x ) f ( x ) h ( x ) ] s.t. h ( x ) ∈ { − 1 , + 1 }
这就是式(8.14)的第 3 个等号的结果,h ( x ) h(\boldsymbol{x}) h ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t ℓ exp ( H t − 1 + α h t ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h t ∣ D )
α k = arg min α ℓ exp ( H t − 1 + α h t ∣ D ) \alpha_k=\underset{\alpha}{\arg \min } \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right) α k = α arg min ℓ e x p ( H t − 1 + α h t ∣ D )
对指数损失函数ℓ exp ( H t − 1 + α h t ∣ D ) \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right) ℓ e x p ( H t − 1 + α h t ∣ D )
∂ ℓ exp ( H t − 1 + α h t ∣ D ) ∂ α = ∂ ( e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) ) ∂ α = − e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α + e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) \begin{aligned}
\frac{\partial \ell_{\exp }\left(H_{t-1}+\alpha h_t \mid \mathcal{D}\right)}{\partial \alpha} & =\frac{\partial\left(e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)+\left(e^\alpha-e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right)}{\partial \alpha} \\
& =-e^{-\alpha} \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)+\left(e^\alpha+e^{-\alpha}\right) \sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)
\end{aligned} ∂ α ∂ ℓ e x p ( H t − 1 + α h t ∣ D ) = ∂ α ∂ ( e − α ∑ i = 1 ∣ D ∣ D t ′ ( x i ) + ( e α − e − α ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) ) = − e − α i = 1 ∑ ∣ D ∣ D t ′ ( x i ) + ( e α + e − α ) i = 1 ∑ ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) )
令导数等于零, 得
e − α e α + e − α = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) ≠ h ( x i ) ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) Z t I ( f ( x i ) ≠ h ( x i ) ) = ∑ i = 1 ∣ D ∣ D t ( x i ) I ( f ( x i ) ≠ h ( x i ) ) = E x ∼ D t [ I ( f ( x i ) ≠ h ( x i ) ) ] = ϵ t \begin{aligned}
\frac{e^{-\alpha}}{e^\alpha+e^{-\alpha}} & =\frac{\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)}{\sum_{i=1}^{|D|} \mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)}=\sum_{i=1}^{|D|} \frac{\mathcal{D}_t^{\prime}\left(\boldsymbol{x}_i\right)}{Z_t} \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right) \\
& =\sum_{i=1}^{|D|} \mathcal{D}_t\left(\boldsymbol{x}_i\right) \mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)=\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}_t}\left[\mathbb{I}\left(f\left(\boldsymbol{x}_i\right) \neq h\left(\boldsymbol{x}_i\right)\right)\right] \\
& =\epsilon_t
\end{aligned} e α + e − α e − α = ∑ i = 1 ∣ D ∣ D t ′ ( x i ) ∑ i = 1 ∣ D ∣ D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) = i = 1 ∑ ∣ D ∣ Z t D t ′ ( x i ) I ( f ( x i ) = h ( x i ) ) = i = 1 ∑ ∣ D ∣ D t ( x i ) I ( f ( x i ) = h ( x i ) ) = E x ∼ D t [ I ( f ( x i ) = h ( x i ) ) ] = ϵ t
对上述等式化简, 得
e − α e α + e − α = 1 e 2 α + 1 ⇒ e 2 α + 1 = 1 ϵ t ⇒ e 2 α = 1 − ϵ t ϵ t ⇒ 2 α = ln ( 1 − ϵ t ϵ t ) ⇒ α t = 1 2 ln ( 1 − ϵ t ϵ t ) \begin{aligned}
\frac{e^{-\alpha}}{e^\alpha+e^{-\alpha}}=\frac{1}{e^{2 \alpha}+1} & \Rightarrow e^{2 \alpha}+1=\frac{1}{\epsilon_t} \Rightarrow e^{2 \alpha}=\frac{1-\epsilon_t}{\epsilon_t} \Rightarrow 2 \alpha=\ln \left(\frac{1-\epsilon_t}{\epsilon_t}\right) \\
& \Rightarrow \alpha_t=\frac{1}{2} \ln \left(\frac{1-\epsilon_t}{\epsilon_t}\right)
\end{aligned} e α + e − α e − α = e 2 α + 1 1 ⇒ e 2 α + 1 = ϵ t 1 ⇒ e 2 α = ϵ t 1 − ϵ t ⇒ 2 α = ln ( ϵ t 1 − ϵ t ) ⇒ α t = 2 1 ln ( ϵ t 1 − ϵ t )
即式(8.11)。 通过以上推导可以发现: AdaBoost(约束条件
h t ( x ) ∈ { − 1 , + 1 } h_t(\boldsymbol{x}) \in\{-1,+1\} h t ( x ) ∈ { − 1 , + 1 }
8.6.3 梯度提升(Gradient Boosting)
将 AdaBoost 的问题一般化, 即不限定损失函数为指数损失函数,
ℓ ( H t ∣ D ) = E x ∼ D [ err ( H t ( x ) , f ( x ) ) ] = E x ∼ D [ err ( H t − 1 ( x ) + α t h t ( x ) , f ( x ) ) ] \begin{aligned}
\ell\left(H_t \mid \mathcal{D}\right) & =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)\right] \\
& =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_{t-1}(\boldsymbol{x})+\alpha_t h_t(\boldsymbol{x}), f(\boldsymbol{x})\right)\right]
\end{aligned} ℓ ( H t ∣ D ) = E x ∼ D [ err ( H t ( x ) , f ( x ) ) ] = E x ∼ D [ err ( H t − 1 ( x ) + α t h t ( x ) , f ( x ) ) ]
问题时, f ( x ) ∈ R f(\boldsymbol{x}) \in \mathbb{R} f ( x ) ∈ R err ( H t ( x ) , f ( x ) ) = ( H t ( x ) − f ( x ) ) 2 \operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)=\left(H_t(\boldsymbol{x})-f(\boldsymbol{x})\right)^2 err ( H t ( x ) , f ( x ) ) = ( H t ( x ) − f ( x ) ) 2 T T T
H ( x ) = ∑ t = 1 T α t h t ( x ) H(\boldsymbol{x})=\sum_{t=1}^T \alpha_t h_t(\boldsymbol{x}) H ( x ) = t = 1 ∑ T α t h t ( x )
类似于t t t α t , h t ( x ) \alpha_t, h_t(\boldsymbol{x}) α t , h t ( x ) H t − 1 ( x ) H_{t-1}(\boldsymbol{x}) H t − 1 ( x )
ℓ ( H t ∣ D ) ≈ E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) + ∂ err ( H t ( x ) , f ( x ) ) ∂ H t ( x ) ∣ H t ( x ) = H t − 1 ( x ) ( H t ( x ) − H t − 1 ( x ) ) ] = E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) + ∂ err ( H t ( x ) , f ( x ) ) ∂ H t ( x ) ∣ H t ( x ) = H t − 1 ( x ) α t h t ( x ) ] = E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) ] + E x ∼ D [ ∂ err ( H t ( x ) , f ( x ) ) ∂ H t ( x ) ∣ H t ( x ) = H t − 1 ( x ) α t h t ( x ) ] \begin{aligned}
\ell\left(H_t \mid \mathcal{D}\right) & \approx \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_{t-1}(\boldsymbol{x}), f(\boldsymbol{x})\right)+\left.\frac{\partial \operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)}{\partial H_t(\boldsymbol{x})}\right|_{H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})}\left(H_t(\boldsymbol{x})-H_{t-1}(\boldsymbol{x})\right)\right] \\
& =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_{t-1}(\boldsymbol{x}), f(\boldsymbol{x})\right)+\left.\frac{\partial \operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)}{\partial H_t(\boldsymbol{x})}\right|_{H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})} \alpha_t h_t(\boldsymbol{x})\right] \\
& =\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_{t-1}(\boldsymbol{x}), f(\boldsymbol{x})\right)\right]+\mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\left.\frac{\partial \operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)}{\partial H_t(\boldsymbol{x})}\right|_{H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})} \alpha_t h_t(\boldsymbol{x})\right]
\end{aligned} ℓ ( H t ∣ D ) ≈ E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) + ∂ H t ( x ) ∂ err ( H t ( x ) , f ( x ) ) H t ( x ) = H t − 1 ( x ) ( H t ( x ) − H t − 1 ( x ) ) ] = E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) + ∂ H t ( x ) ∂ err ( H t ( x ) , f ( x ) ) H t ( x ) = H t − 1 ( x ) α t h t ( x ) ] = E x ∼ D [ err ( H t − 1 ( x ) , f ( x ) ) ] + E x ∼ D [ ∂ H t ( x ) ∂ err ( H t ( x ) , f ( x ) ) H t ( x ) = H t − 1 ( x ) α t h t ( x ) ]
注意, 在上式展开中的变量为 H t ( x ) H_t(\boldsymbol{x}) H t ( x ) H t ( x ) = H t − 1 ( x ) + α t h t ( x ) H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})+\alpha_t h_t(\boldsymbol{x}) H t ( x ) = H t − 1 ( x ) + α t h t ( x ) x = x k + α k d k ) \left.\boldsymbol{x}=\boldsymbol{x}_k+\alpha_k \boldsymbol{d}_k\right) x = x k + α k d k ) ℓ ( H t − 1 ∣ D ) \ell\left(H_{t-1} \mid \mathcal{D}\right) ℓ ( H t − 1 ∣ D ) ℓ ( H t ∣ D ) \ell\left(H_t \mid \mathcal{D}\right) ℓ ( H t ∣ D ) α t \alpha_t α t h t ( x ) h_t(\boldsymbol{x}) h t ( x )
h t ( x ) = arg min h E x ∼ D [ ∂ err ( H t ( x ) , f ( x ) ) ∂ H t ( x ) ∣ H t ( x ) = H t − 1 ( x ) h ( x ) ] s.t. constraints for h ( x ) h_t(\boldsymbol{x})=\underset{h}{\arg \min } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\left.\frac{\partial \operatorname{err}\left(H_t(\boldsymbol{x}), f(\boldsymbol{x})\right)}{\partial H_t(\boldsymbol{x})}\right|_{H_t(\boldsymbol{x})=H_{t-1}(\boldsymbol{x})} h(\boldsymbol{x})\right] \quad \text { s.t. constraints for } h(\boldsymbol{x}) h t ( x ) = h arg min E x ∼ D [ ∂ H t ( x ) ∂ err ( H t ( x ) , f ( x ) ) H t ( x ) = H t − 1 ( x ) h ( x ) ] s.t. constraints for h ( x )
解得 h t ( x ) h_t(\boldsymbol{x}) h t ( x ) α t \alpha_t α t
α t = arg min α E x ∼ D [ err ( H t − 1 ( x ) + α h t ( x ) , f ( x ) ) ] \alpha_t=\underset{\alpha}{\arg \min } \mathbb{E}_{\boldsymbol{x} \sim \mathcal{D}}\left[\operatorname{err}\left(H_{t-1}(\boldsymbol{x})+\alpha h_t(\boldsymbol{x}), f(\boldsymbol{x})\right)\right] α t = α arg min E x ∼ D [ err ( H t − 1 ( x ) + α h t ( x ) , f ( x ) ) ]
以上就是梯度提升(Gradient Boosting)的理论框架,T T T
Gradient Boosting 算法的官方版本参见[5]第 5-6 页,其中算法伪代码部分如下
感觉该伪代码针对的还是在任意损失函数L ( y i , F ( x i ) ) L\left(y_i, F\left(\boldsymbol{x}_i\right)\right) L ( y i , F ( x i ) ) β h ( x i , a ) \beta h\left(\boldsymbol{x}_i, \boldsymbol{a}\right) β h ( x i , a ) F ( x ) = F m − 1 ( x ) F(\boldsymbol{x})=F_{m-1}(\boldsymbol{x}) F ( x ) = F m − 1 ( x ) a m \boldsymbol{a}_m a m ρ m \rho_m ρ m 3.2 3.2 3.2
简单理解如下: 第 4 步要解的h ( x i , a ) h\left(\boldsymbol{x}_i, \boldsymbol{a}\right) h ( x i , a ) d \boldsymbol{d} d ∥ d ∥ 2 = 1 \|\boldsymbol{d}\|_2=1 ∥ d ∥ 2 = 1 α \alpha α d k = − f ′ ( x k ) = − 4 d_k=-f^{\prime}\left(x_k\right)=-4 d k = − f ′ ( x k ) = − 4 α k = 0.5 \alpha_k=0.5 α k = 0.5 Δ x = α k d k = − 2 ) \left.\Delta x=\alpha_k d_k=-2\right) Δ x = α k d k = − 2 ) h ( x i , a ) h\left(\boldsymbol{x}_i, \boldsymbol{a}\right) h ( x i , a ) ∥ d ∥ 2 = 1 \|\boldsymbol{d}\|_2=1 ∥ d ∥ 2 = 1
那为什么不是直接令 h ( x i , a ) h\left(\boldsymbol{x}_i, \boldsymbol{a}\right) h ( x i , a ) h h h x i \boldsymbol{x}_i x i h h h y ~ i \tilde{y}_i y ~ i
李航《统计学习方法》[2] 第 8.4.3 节中的算法 8.4 8.4 8.4 ρ m \rho_m ρ m h ( x i , a ) h\left(\boldsymbol{x}_i, \boldsymbol{a}\right) h ( x i , a ) ρ m \rho_m ρ m ρ m ) \left.\rho_m\right) ρ m ) ρ m \rho_m ρ m
8.6.4 梯度提升树(GBDT)
本部分无实质GBDT内容,仅为梳理GBDT的概念,具体可参考给出的资源链接。
对于GBDT,一般资料是按Gradient
8.6.5 XGBoost
本部分无实质XGBoost内容,仅为梳理XGBoost的概念,具体可参考给出的资源链接。
首先,XGBoost 是eXtreme Gradient Boosting的简称。
参考文献
[1] Jerome Friedman, Trevor Hastie, and Robert Tibshirani. Additive logistic regression: a statistical view
[2] 李航. 统计学习方法. 清华大学出版社, 2012.
[3] Zhi-Hua Zhou and Ji Feng. Deep forest: Towards an alternative to deep neural networks. In IJCAI,
[4] 朱德通孙文瑜, 徐成贤. 最优化方法. 最优化方法, 2010.
[5] Jerome H Friedman. Greedy function approximation: a gradient boosting machine. Annals of statistics,
[6] Tianqi Chen and Carlos Guestrin. Xgboost: A scalable tree boosting system. In Proceedings of the