5 / 28
Pytorch 线性回归实战
通过前面的学习我们已经了解了pytorch中一些常用命令的使用,以及自动求梯度的基本原理,这节课我们一起来小试身手,结合前面所学的知识做出第一个简单的demo。我们将使用pytorch来构建一个简单的线性回归实战案例,同时也是熟悉下训练模型的完整过程,为后面训练更复杂模型打下基础。
1. 什么是线性回归模型?
简单来说,就是假定因变量关于自变量呈线性关系,即满足
那么对于明显的呈线性条带状分布的数据,我们认为这是线性关系的数据参杂了一定噪声之后呈现出的情形,便可以尝试使用线性回归模型对这批数据进行建模。
此时我们想用线性函数,根据已有数据拟合分布曲线,之后便可以通过 来得到 的预测值。
2.梯度下降算法简介
梯度下降算法是一种通过迭代找到目标函数的极小值的方法,属于最优化算法中的一种。这里我们不去深究它的数学原理
梯度下降法如何更新参数?简单来说,就是算出参数的梯度值,然后沿负梯度方向前进一小段来更新参数,如下图所示

至于为什么,某点的梯度方向是这个点局部邻域函数值上升最快的方向,那么这个点的负梯度方向,便是让loss函数减小的一个不错选择。每一步向当前点负梯度方向下降一点,不断迭代,便能找到一个函数的局部极小值。
3. 线性回归实战
下面进入代码实战环节,让我们来小试身手
- 首先我们导入基本项目库
import torch
import numpy as np
import matplotlib.pyplot as plt- 导入相关数据
这里我们使用提前预设好的人造数据,
x_train = np.array([[3.3], [4.4], [5.5], [6.71], [6.93], [4.168],
[9.779], [6.182], [7.59], [2.167], [7.042],
[10.791], [5.313], [7.997], [3.1]], dtype=np.float32)
y_train = np.array([[1.7], [2.76], [2.09], [3.19], [1.694], [1.573],
[3.366], [2.596], [2.53], [1.221], [2.827],
[3.465], [1.65], [2.904], [1.3]], dtype=np.float32)
#转换为 Tensor
x_train = torch.from_numpy(x_train)
y_train = torch.from_numpy(y_train)
我们绘制一下预设的人工数据
# plot src data
plt.plot(x_train.data.numpy(), y_train.data.numpy(), 'bo')
plt.show()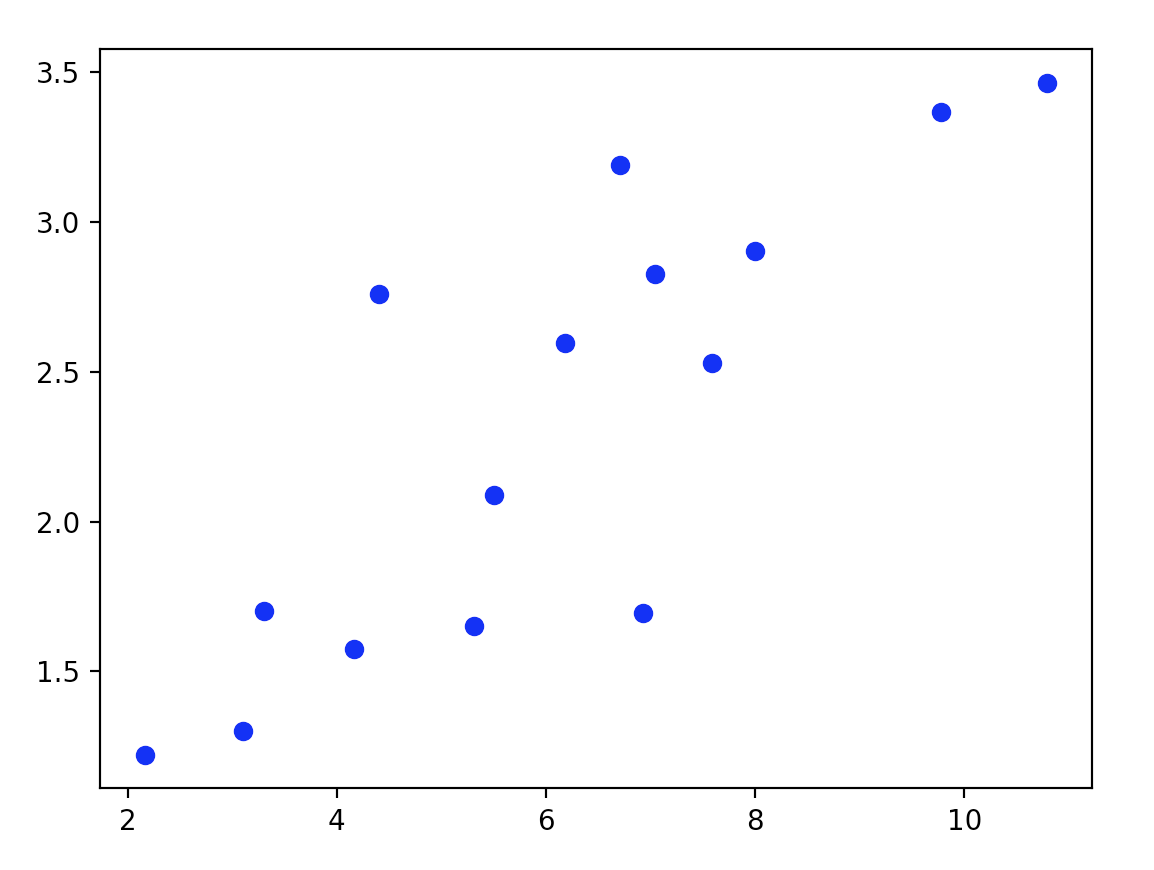
可以看到y和x之间大致符合线性关系,因此我们使用线性回归来拟合y和x的关系是合理的。
- 构建模型
于是我们定义出我们的线性模型
# define the linear model
# y = w * x + b
w = torch.tensor([-1.], requires_grad=True)
b = torch.tensor([0.], requires_grad=True)
def linear_model(x):
    return x * w + b
目前,线性回归模型的参数w和b我是随意初始化的,我们来绘制出当前参数下的预测结果
# plot estimate result before train
y_ = linear_model(x_train)
plt.plot(x_train.data.numpy(), y_train.data.numpy(), 'bo', label='real')
plt.plot(x_train.data.numpy(), y_.data.numpy(), 'ro', label='estimated')
plt.legend()
plt.show()
可以看到,未经训练的模型预测的完全不对
- 定义损失函数
因此我们需要定义出损失函数,来告诉pytorch如何优化我们的模型。
对于线性回归来说,我们定义预测结果与标准结果之间差异的平方作为损失函数,这也就是我们经常听到的最小二乘法。
def get_loss(y_, y):
return torch.mean((y_ - y_train) ** 2)- 利用梯度下降法进行训练迭代
# train 10 iteration
lr = 1e-2
for e in range(10):
    y_ = linear_model(x_train)

    # compute loss
    loss = get_loss(y_, y_train)
    loss.backward()

    # 手动更新参数
    w.data = w.data - lr * w.grad.data
    b.data = b.data - lr * b.grad.data
    print('epoch: {}, loss: {}'.format(e, loss))

    # reset the grad to zero
    w.grad.zero_()
    b.grad.zero_()
可以看到,训练结果如下
loss不断在下降,说明模型预测的精度在不断上升
epoch: 0, loss: 79.35061645507812
epoch: 1, loss: 1.6737390756607056
epoch: 2, loss: 0.23599520325660706
epoch: 3, loss: 0.20918604731559753
epoch: 4, loss: 0.20848968625068665
epoch: 5, loss: 0.2082776129245758
epoch: 6, loss: 0.20807550847530365
epoch: 7, loss: 0.2078746259212494
epoch: 8, loss: 0.2076748162508011
epoch: 9, loss: 0.2074759602546692
我们再次绘制出预测结果
# plot estimate result after train
y_ = linear_model(x_train)
plt.plot(x_train.data.numpy(), y_train.data.numpy(), 'bo', label='real')
plt.plot(x_train.data.numpy(), y_.data.numpy(), 'ro', label='estimated')
plt.legend()
plt.show()
可以看到,模型正确的学到的y与x之间的规律。
到此,我们完成了本教程的第一个动手小实验,继续加油!