招聘网站职位信息爬取
需求
1.用户输入想要爬取的职位,起始条目,结束条目
2.将爬取结果保存为csv文件
实现
    from  urllib import request,parse
    import csv
    import json

    class zhilianSpider(object):
        def __init__(self,job,start,end):
            self.job=parse.quote(job)#链接中的字符串需要转换,否则报错
            self.start=int(start)
            self.end=int(end)
            self.data=[]
        def run(self):
            #创建请求、发送请求,解析
            url = 'https://fe-api.zhaopin.com/c/i/sou?start=%d&pageSize=%d&cityId=538&workExperience=-1&education=-1&companyType=-1&employmentType=-1&jobWelfareTag=-1&kw=%s&kt=3&_v=0.48405690&x-zp-page-request-id=22e67c28152f47a1a424b6f5bf58e535-1558511284814-104138'%(self.start,self.start+self.end,self.job)
            req = self.make_req(url)
            res = request.urlopen(req)
            print('开始爬取……')
            self.parse(res)
            #写入数据到csv中
            headers = ['工作名', '收入', '公司名', '规模', '最近更新时间','工作经验','职位链接']
            with open('job.csv','w',encoding='utf-8') as f:
                f_csv = csv.writer(f)
                f_csv.writerow(headers)
                f_csv.writerows(self.data)
            print('爬取结束')

        def make_req(self,url):
            headers={
                'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3676.400 QQBrowser/10.4.3505.400'
            }
            req=request.Request(headers=headers,url=url)
            return req
        def parse(self,res):
            res=json.loads(res.read().decode())
            results=res['data']['results']
            for item in results:
                lt=[]
                lt.append(item['jobName'])
                lt.append(item['salary'])
                lt.append(item['company']['name'])
                lt.append(item['company']['size']['name'])
                lt.append(item['updateDate'])
                lt.append(item['workingExp']['name'])
                lt.append(item['positionURL'])
                lt=tuple(lt)
                self.data.append(lt)
    def main():
        job=input('请输入要爬取的职位:')
        start=input('请输入起始条:')
        end = input('请输入末尾条:')
        zhilian=zhilianSpider(job,start,end)
        zhilian.run()

    if __name__=='__main__':
        main()
结果:
    请输入要爬取的职位:python开发
    请输入起始条:0
    请输入末尾条:180
    开始爬取……
    爬取结束

    Process finished with exit code 0
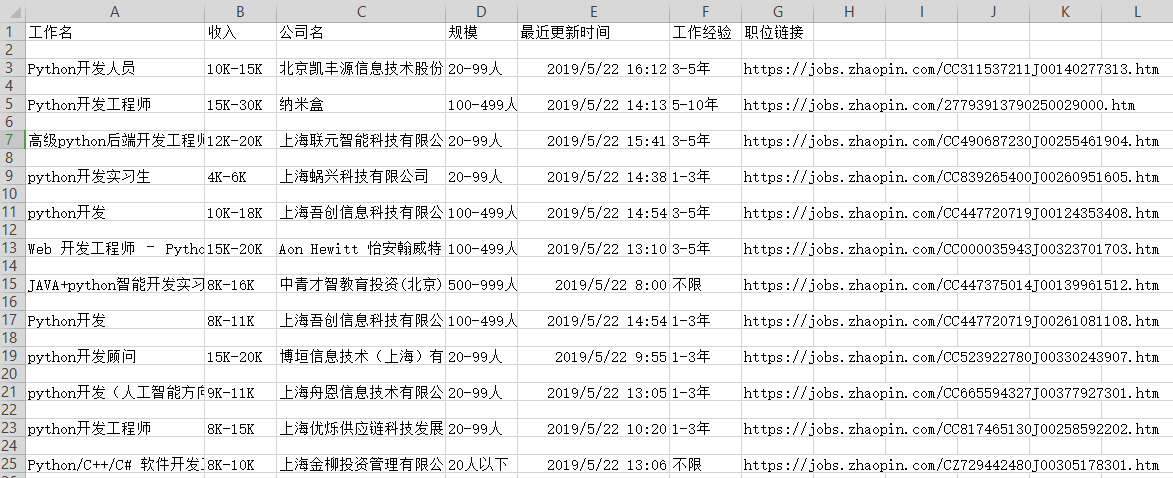
csv文件内容:
还没有评论,来说两句吧